Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT‑5.3 Codex Spark 對比 GPT‑5.3 Codex:全面分析 GPT‑5.3 Codex Spark 對比 GPT‑5.3 Codex:全面分析 - CometAPI
technology / CometAPI 研究
GPT‑5.3 Codex Spark 對比 GPT‑5.3 Codex:全面分析 2026 年 2 月,OpenAI 發布了「Codex」家族中兩個密切相關——但在策略上不同——的成員:GPT-5.3-Codex(高能力的代理式程式編碼模型)與 GPT-5.3-Codex-Spark(更小、超低延遲、為互動式編碼最佳化的變體)。兩者共同體現了 OpenAI 在軟體工程工作流程中同時滿足「深度思考」與「快速執行」的雙軌策略:一個模型推升程式編碼智能與工具驅動的代理行為的上限,另一個模型則優先面向開發者的 UI 的即時互動性。
2026 年 2 月,OpenAI 發布了「Codex」家族中兩個密切相關——但在策略上不同——的成員:GPT-5.3-Codex(高能力的代理式程式編碼模型)與 GPT-5.3-Codex-Spark(更小、超低延遲、為互動式編碼最佳化的變體)。兩者共同體現了 OpenAI 在軟體工程工作流程中同時滿足「深度思考」與「快速執行」的雙軌策略:一個模型推升程式編碼智能與工具驅動的代理行為的上限,另一個模型則優先面向開發者的 UI 的即時互動性。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)2026 年 2 月,OpenAI 推出了兩個密切相關但策略上不同的「Codex」家族成員:GPT-5.3-Codex (高能力的代理式程式設計模型)與 GPT-5.3-Codex-Spark (較小、超低延遲、為互動式編程優化的變體)。兩者共同體現了 OpenAI 在軟體工程工作流程中同時滿足「深度思考」與「快速行動」的雙軌策略:一個模型提升程式設計智能與工具驅動的代理行為上限,另一個模型則優先提供面向開發者 UI 的即時互動性。
CometAPI 現已整合 GPT-5.3 Codex ,可透過 API 使用。CometAPI 的折扣與服務理念會讓你驚喜。
什麼是 GPT-5.3-Codex 與 GPT-5.3-Codex-Spark?
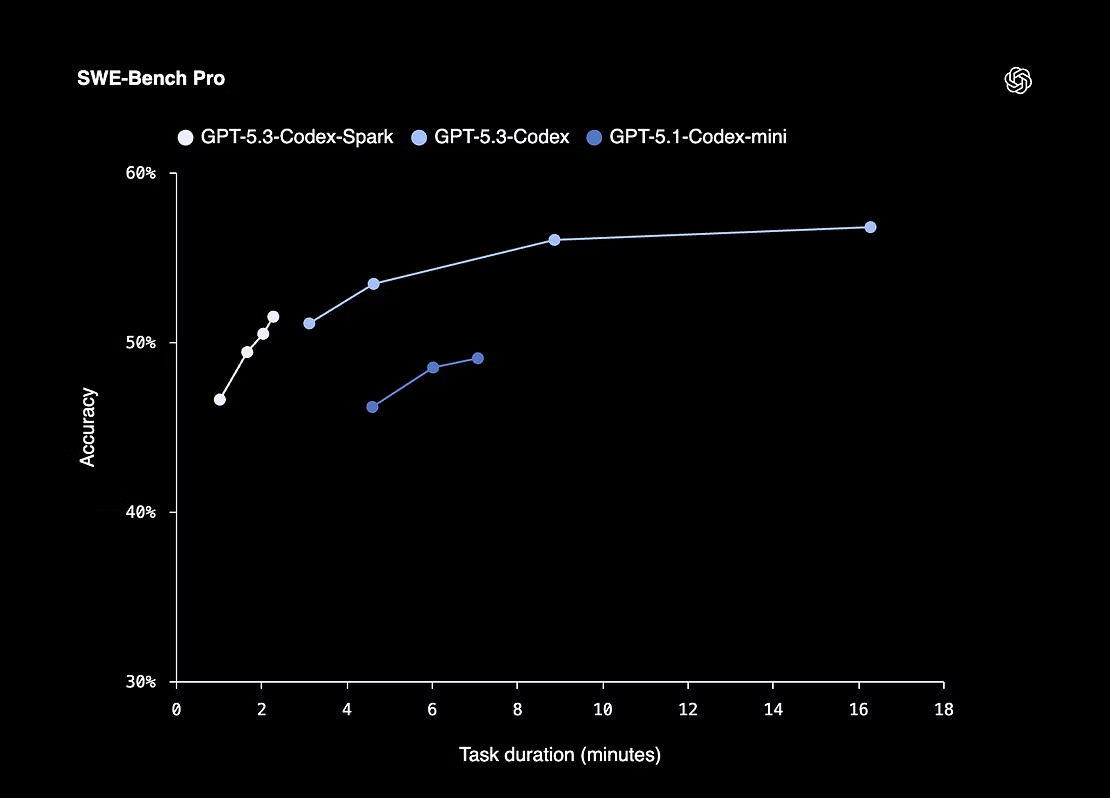
GPT-5.3-Codex 是 OpenAI 最新的「前沿」程式代理。它結合進階的程式能力與一般性推理,明確設計用於長週期、代理式任務,包括研究、使用工具、執行終端命令、跨大量 token 迭代,並管理多步驟的軟體專案。OpenAI 報告顯示其在多語言工程基準(如 SWE-Bench Pro、Terminal-Bench 2.0)上達到最先進的結果,並指出 GPT-5.3-Codex 可用於除錯、部署,甚至協助其自身的開發流程。
GPT-5.3-Codex-Spark 是一個較小、延遲最佳化的變體,用於互動式、即時的程式體驗。Spark 與 Cerebras 的晶圓級硬體協同開發,初始版本可達到每秒超過 1,000 tokens 的吞吐量,以及 128k token 的上下文視窗。它定位為伴隨模型:在行內編輯、樣板生成、快速重構與短步任務上極快——但在推理深度上刻意比標準 Codex 輕一些。
為何要有兩個模型? 這樣的分工反映務實的產品取捨:團隊同時需要(a)能在巨大問題空間中規劃與推理的深度、強能力代理,以及(b)能讓開發者維持心流的近乎即時協作夥伴。證據顯示它們應在混合工作流程中搭配使用,而非互為直接替代。
GPT‑5.3 Codex Spark vs Codex:架構與部署
各模型使用何種硬體?
GPT-5.3-Codex(標準版) :主要在 NVIDIA GB200 NVL72 GPU 及其推理堆疊上共同設計、訓練與提供服務,以支援深度推理與超大型參數規模。此基礎設施優先考量模型容量,而非毫秒級以下延遲。GPT-5.3-Codex-Spark :運行於 Cerebras Wafer-Scale Engine(WSE-3)硬體。Cerebras 的架構以極高晶片內頻寬與低延遲換取不同的容量配置:Spark 變體在物理上較小/經剪枝,以符合晶圓 SRAM 要求,同時提供更高的 token 吞吐量。
模型大小與參數化有何不同? Spark 透過剪枝/蒸餾與較小的參數規模來達成速度,使模型能在 WSE-3 上高效載入與運行。這種設計帶來預期的效能取捨:更高吞吐量,但每個 token 的推理深度較低。
上下文視窗與 token 處理如何?
GPT-5.3-Codex ——在開發者入口的 GPT-5.3-Codex 條目中標示 400,000 token 的上下文視窗。這使標準版模型在長期專案上表現出色,可跨千行、多檔案進行推理。GPT-5.3-Codex-Spark ——研究預覽版以 128k token 上下文視窗啟動;雖大但小於標準 Codex。相對日常 IDE 程式片段已非常充裕,但稍小的視窗加上較小的計算資源,意味著在深度、多檔案的程式合成上有一定限制。
GPT‑5.3 Codex Spark vs Codex:程式設計基準與延遲
GPT-5.3-Codex(標準版) :OpenAI 在發佈中公布的基準數據:Terminal-Bench 2.0 得分 77.3% 、SWE-Bench Pro 56.8% 、OSWorld 64.7% 、GDPval 勝出/平手 70.9% ,以及附錄中突顯的其他任務成績。這些數據使 GPT-5.3-Codex 成為多語言、代理式軟體工程任務的新領導者。GPT-5.3-Codex-Spark :OpenAI 強調 >1000 tokens/sec 的吞吐量與出色的任務完成速度,同時獨立分析與社群基準(早期採用者)報告,在複雜任務上的終端推理準確度較完整模型顯著降低。一份獨立分析估計 Spark 的 Terminal-Bench 得分約為 ~58.4% (相較標準版的 77.3%),顯示速度與複雜終端任務正確性的務實取捨。 **解讀:**對於短且範圍清晰的任務——例如小幅編輯、單元測試生成、正則或語法修復——Spark 的低延遲使人機迴圈更順暢,提升開發者產出。若是系統架構設計、除錯複雜整合錯誤、或代理式多步工作流程,標準版 GPT-5.3-Codex 的較高推理準確度在實務上更優。
為何 GPT‑5.3 Codex Spark 感覺如此更快?
這純粹是硬體層面的技巧嗎? 部分是。Spark 所用的 Cerebras WSE-3 透過將大型資料緩衝維持在晶片內並提供巨大的記憶體頻寬,消除了大量記憶體搬移延遲。但僅有硬體仍不足——OpenAI 創建了能映射至晶圓 SRAM 與運算特性的蒸餾/剪枝變體。兩者結合(更小的模型+晶圓級低延遲)造就了近乎即時的行為。
剪枝/蒸餾的代價是什麼? 蒸餾會降低參數數量或模型深度,並可能移除部分多步推理能力。實務上表現為:
在需要連鎖推理的複雜終端任務上表現較弱;
對於長或高度關聯的程式變更,細微邏輯或安全性錯誤的機率更高;
更少的內部「我在思考什麼」token(即在未明確要求時較少的思維鏈推理)。
話雖如此,Spark 在定點編輯與高頻寬召回方面表現優異——這類協助能讓開發者持續打字、不被中斷。
對產品團隊與開發者意味著什麼?
何時應呼叫 Spark 與標準 Codex?
呼叫 Spark 的情境:行內即時補全、互動式重構、CI 快速檢查、單元測試腳手架、語法修復、或不應打斷使用者心流的即時程式建議。Spark 的亞秒級生成讓 UI 顯得流暢。呼叫標準版 GPT-5.3-Codex 的情境:架構設計、複雜錯誤分流、跨檔案推理、長時間運行的代理、資安/強化檢查,或需要首輪正確性以降低高成本驗證的操作。
建議的混合工作流程
將 Spark 作為「戰術」子代理 ,用於短編輯並維持開發者心流(映射為 IDE 的鍵盤捷徑或行內按鈕)。
將 GPT-5.3-Codex 作為「戰略」規劃者 :用於 PR 生成、重構提案、需要深度上下文的重構計畫,或執行完整的安全檢查。
實作 「混合模式」 :自動將短、語法/風格提示路由至 Spark,並將多步討論或請求升級至標準 Codex。OpenAI 正在探索混合路由,但你可在客戶端即刻實作。
提示撰寫與運營最佳實務
在 Spark 以小而精的提示起手 ,遇到完整重構或需要高正確性時升級至 Codex。此混合模式提供最佳 UX(Spark 起草,Codex 驗證與定稿)。為 UI 互動使用串流 :展示 Spark 的漸進式 token,以營造「即時」感;避免阻塞編輯器的長時間同步呼叫。儀表化驗證測試 :凡影響邏輯或安全的變更,要求單元測試,並偏好由 Codex 執行或生成這些測試。自動化測試—驗證循環:Spark 提議變更、Codex 驗證/定稿。調整推理投入 :許多 Codex 端點提供 reasoning 或 effort 調節(例如 low/medium/high/xhigh)——在棘手、高影響任務上提高投入。快取與工作階段管理 :對以 Spark 驅動的 UI,高效快取先前上下文 token,僅傳送差異以最小化每次請求延遲與 token 使用量。安全優先 :在高風險領域(網安、生物等)遵循供應商系統卡/治理指引——當模型在特定領域達到高能力時,Codex 的系統卡明確記錄了額外的防護與準備步驟。 常見有兩種模式:(A)對 Codex-Spark 進行互動式串流呼叫以獲得行內補全,(B)向 GPT-5.3-Codex 發送更代理式、投入更高的長時間重構/代理任務請求。
A) 範例 — 使用 Codex-Spark 進行串流式行內補全(Python) # Pseudocode / illustrative example# Install: pip install openai (or use official SDK)import openaiopenai.api_key = "YOUR_API_KEY"# Use a hypothetical streaming endpoint that favors low latency.# Model name is illustrative: "gpt-5.3-codex-spark"with openai.ChatCompletion.stream( model="gpt-5.3-codex-spark", messages=[ {"role": "system", "content": "You are a fast, precise coding assistant."}, {"role": "user", "content": "In file app.py, refactor this function to be async and add type hints:\n\n<paste code here>"} ], max_tokens=256, stream=True) as stream: for event in stream: if event.type == "output.delta": print(event.delta, end="") # print incremental completions for instant UI elif event.type == "response.completed": print("\n[done]")
為何採用此模式? 串流+較小的 max_tokens 能讓編輯器中的迭代更俐落。當你需要亞秒級、漸進式補全時,使用 Spark。
B) 範例 — 使用 GPT-5.3-Codex 執行代理式、長時間任務(Python) # Pseudocode for a multi-step agent request: run tests, find failing module, write fix, create PRimport openaiopenai.api_key = "YOUR_API_KEY"response = openai.ChatCompletion.create( model="gpt-5.3-codex", messages=[ {"role":"system", "content":"You are an engineering agent. You can run tests and edit files given repo access."}, {"role":"user", "content":"Take the repository at /workspace/myapp, run the test suite, and if any tests fail, create a minimal fix and return a patch plus a test that demonstrates the bug."} ], max_tokens=2000, reasoning="xhigh", # Codex supports effort settings: low/medium/high/xhigh tools=["shell","git"], # illustrative: agent tools for real actions stream=False)# The response may include a multi-step plan, diffs, and tests.print(response.choices[0].message.content)
為何採用此模式? Codex 的推理模式(low→xhigh)讓你能以延遲換取更謹慎的多階段規劃;它專為高風險、長期任務設計,能在多步中協調工具並保留狀態。
結論:哪個模型「勝出」? 沒有單一勝者——每個模型都瞄準軟體工程生命週期的互補部分。當重視正確性、長期推理與工具協作時,GPT-5.3-Codex 是更佳選擇。當維持開發者心流、將延遲降至最低為第一要務時,GPT-5.3-Codex-Spark 更為合適。對多數組織而言,正確策略不是二選一,而是整合:讓 Codex 做建築師,讓 Spark 做石匠。早期採用者已回報,當兩者以健全驗證佈線進工具鏈後,生產力獲得提升。