
先回答
GPT-6 Astra 是 OpenAI 面向困難端到端工作的全新旗艦模型。OpenAI 於 2026 年 9 月 3 日 發佈 GPT-6 Astra,定位於複雜推理、電腦操作、程式開發、研究、科學工作與專業成品創作。該 API 模型具備 1.05M-token 的上下文視窗與 128K 最大輸出,接受文字與圖片輸入,並支援從低到最大等級的推理力度。標準 API 定價自每百萬 token $10(輸入)/$50(輸出) 起。最重要的實務變化並非在所有通用智能基準上的整齊跳升:Astra 的最大增益出現在代理式執行、電腦操作、長上下文檢索、程式工作流、科學領域與資安。
這點之所以重要,是因為較早的 CometAPI 文章 GPT-6 Is Coming Soon — What Will It Look Like? 帶有必然的推測成分。既然 Astra 已公開,本文將聚焦已確認的模型行為、基準測試取捨、API 經濟性,以及在哪些情境中它實際上比更便宜的前沿替代方案更合適。
什麼是 GPT-6 Astra?
GPT-6 Astra 是 OpenAI 旗艦 GPT-5.6 Sol 的後繼者。OpenAI 將 Astra 描述為其面向最難端到端工作的最強模型,重點在於需要模型推理、使用工具、與軟體互動、修訂中間產物,並將任務從初始需求推進到完成成果的工作流程。這個定位很關鍵:Astra 並非僅是更大的聊天模型。它被設計成代理中的推理引擎,能跨瀏覽器、終端機、文件、試算表、開發環境與企業軟體運作。
發佈文章重點呈現了在電腦操作、瀏覽、軟體工程、資安、科學與專業工作上的最先進結果。它在 FrontierMath Tier 4、ARC-AGI-3 與 ExploitBench 上分別報告了97.6% / 99.9% / 100%。這些抬頭分數相當醒目,但不應解讀為「Astra 在所有基準上全面勝出」。在 OpenAI 自家比較表所用的 Artificial Analysis Intelligence Index 中,Astra 得分 61.2,而 Claude Fable 5.1 得分 65.7。因此本次發佈更應被理解為在執行力與代理式工作上的躍升,而非在所有智能衡量上整齊橫掃。
與 GPT-5.6 Sol 相比有何變化?
電腦操作成為一等能力
Astra 最明顯的世代躍升是電腦操作。在 OSWorld 2.0 上,OpenAI 報告 Astra 為 72.6%,而 GPT-5.6 Sol 為 65.7%。在相同的延遲模擬下,Astra 約 40 分鐘完成任務,而 Sol 約需 75 分鐘,縮短約 47%。結合更新的 Codex 測 harness,OpenAI 指出在 Mind2Web 上完成速度提升 1.9 倍。實務重點不僅是 Astra 能看見螢幕;它能在多步驟的軟體任務中更長時間保持一致,並減少代價高昂的繞路。
專業成品產出更有章法
OpenAI 明確針對以可用成品為終點的專業工作流程訓練了 Astra。發佈資料描述其在文件、試算表、簡報、資料分析、設計工作與模板遵循上的更強表現。Astra 也更擅長在任務進行中需求改變時保持方向,因此導向訊息較不會覆蓋原始目標。這對於長時間運行的企業代理特別有用,因為新的指示常在工作流程啟動後才陸續到來。
長時段會話保留更多有用工作上下文
對於長時間的程式會話,Astra 引入了 Codex 在主動上下文填滿後仍可保留與提取筆記的新方法。先前的做法高度依賴壓縮,可能遺漏為何某個修復嘗試失敗或哪些限制條件已被驗證。OpenAI 表示 Astra 能跨上下文視窗保留筆記,在大型重構與偵錯期間提升連續性。
推理力度現可延伸至最大
開發者可選擇 low、medium、high、xhigh 或 max 推理力度。這讓品質—成本曲線比將 Astra 視為單一固定操作點更寬廣。官方模型指引建議選擇能滿足評測目標的最低力度,因為模型最佳的經濟性往往來自 token 效率,而非永遠以最大推理運行。
GPT-6 Astra 基準測試表現
OpenAI 發布了涵蓋電腦操作、專業工作、程式開發、學術推理、健康、資安、長上下文與對齊的廣泛比較。閱讀該表最有用的方式是區分「一般智能」與「完成使用工具工作之能力」。在 OpenAI 的表格中,Astra 在 Artificial Analysis Intelligence Index 上僅略高於 Sol,但在多項代理與操作型基準上大幅領先。
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | What the delta suggests |
|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | 端到端商務工作流程的大幅提升 |
| OSWorld 2.0 | 72.6% | 65.7% | 更強的電腦互動與任務完成能力 |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 基於終端機的代理式程式開發大幅提升 |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | 使用程式/工具的科學工作流程取得重大進步 |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 更強的前沿數學推理 |
| ExploitBench | 100.0% | 78.5% | 關鍵級的資安能力 |
| SRE-Bench, one attempt | 88.0% | 55.9% | 明顯更強的逆向工程 / SRE 工作 |
| MRCR v2, 512K-1M | 96.3% | 73.8% | 非常長上下文檢索能力提升 |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 一般智能相較 Sol 基本持平 |
這個模式異常清晰。當基準需要與工具或環境持續互動時,Astra 的優勢最大。AutomationBench 從 18.1% 升至 41.4%,Terminal-Bench Science 從 22.4% 升至 64.6%,而在 512K–1M 區間的長上下文 MRCR 從 73.8% 升至 96.3%。相較之下,Artificial Analysis Intelligence Index 只是從 60.9 升至 61.2。這也是為何用「Astra 貴 2.5 倍但只稍微更聰明」來描述,會失焦於產品的真正價值主張。
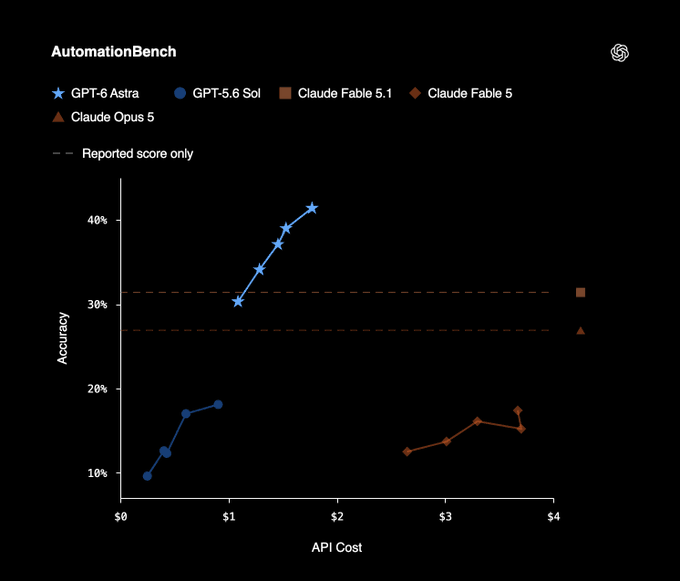
來源: OpenAI AutomationBench chart (原圖,未重繪)
獨立基準:GPT-6 Astra 是否為世代躍進?
獨立測試提供重要的現實校驗。Artificial Analysis 報告其 Intelligence Index 分數為 61,等同於 GPT-5.6 Sol 在最大力度時的表現。同時,Astra 在 Coding Agent Index 上有明顯提升,且在代理式程式開發中大幅減少 token 使用量。Artificial Analysis 測得在其 Codex 測 harness 中,相較 GPT-5.6 Sol 的最大力度,Astra 的 token 使用量約減少三倍,讓 Astra 以大致相同的每任務成本獲得更高分數。
在一般智能上,經濟性看起來較不利。Astra 在 Intelligence Index 的最大力度下,輸出 token 約比 Sol 少 10%,但 2.5 倍的每 token 價格漲幅蓋過該效率增益;Artificial Analysis 估算在最大力度下,Astra 的每任務成本約高出 75%。它也報告在 AA-Omniscience 上的幻覺率從 92% 降至 51%,同時準確率提升四個百分點。
有用的結論取決於工作負載:當代理必須行動、迭代、使用工具並完成複雜工作時,GPT-6 Astra 的世代感最強。對於一般推理或高量文字生成,溢價往往更難回收。
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
務實的模型選擇比較應涵蓋能力、多模態、上下文、代理式執行與價格。下列模型並非可互換:Astra 針對艱難的端到端執行最佳化,Claude Fable 5.1 在部分通用智能衡量上領先,而 Gemini 3.8 Flash 以更低的 token 價格提供更廣的原生輸入模態。
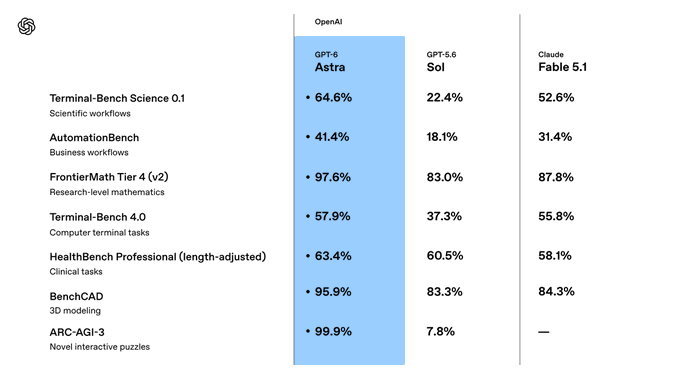
| Metric | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Context window | 1.05M | 1.05M | 1M | 1.048M |
| Max output | 128K | 128K | 128K | 65.5K |
| Input modalities | Text, image | Text, image | Text, image/PDF | Text, image, audio, video, PDF |
| AA Intelligence Index | 61.2 | 60.9 | 65.7 | 58.7 |
| AutomationBench | 41.4% | 18.1% | 31.4% | — |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 19.1% |
| DeepSWE 1.1 | 74.1% | 72.7% | 67.4% | 73.8% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | — |
| HLE with tools | 57.2% | — | 65.0% | — |
| HealthBench Professional | 63.4% | 60.5% | 58.1% | 52.1% |
| Official standard input price | $10/M | $4/M | $10/M | $0.75/M |
| Official standard output price | $50/M | $20/M | $50/M | $3.75/M |
何時應選 GPT-6 Astra
當任務之所以昂貴,是因為人類必須挽救失敗的代理執行時,可選擇 Astra:長週期程式修改、瀏覽器/桌面自動化、跨工具的深度研究、技術成品製作,或複雜的科學與營運工作流程。當更少重試、更少人工校正與更低輸出 token 用量的重要性高於單純的每 token 價格時,其溢價最容易正當化。
何時應選 Claude Fable 5.1
Claude Fable 5.1 仍是嚴肅的前沿競爭者。在 OpenAI 自家的發佈表格中,它在 Artificial Analysis Intelligence Index 得分 65.7,高於 Astra 的 61.2,且在啟用工具的 Humanity’s Last Exam 上得分 65.0,高於 Astra 的 57.2。這意味著不應將 Astra 宣傳為普遍的智能贏家。若你的評測集更像是長篇推理而非電腦操作執行,Claude Fable 5.1 可能仍是更強的選擇。
何時應選 Gemini 3.8 Flash
Gemini 3.8 Flash 瞄準前沿的不同點位。它支援文字、圖片、音訊、影片與 PDF 輸入,具約 100 萬 token 上下文視窗,且官方入門定價遠低於 Astra。對於高量多模態擷取、影音理解、例行代理,或在 $10/$50 token 經濟性難以成立的工作負載,Gemini 3.8 Flash 往往是更經濟的生產選擇。
為何 GPT-6 Astra 的資安評級很重要
Astra 是 OpenAI 首個廣泛部署且達到公司關鍵級資安能力門檻的模型。OpenAI 表示,在給定合適工具與存取權限時,該模型能識別先前未知的安全缺陷,並針對強化系統制定利用策略。在發佈評估中,Astra 在 ExploitBench 得分 100%,在 ExploitGym 為 42.4%,在 SRE-Bench 單次嘗試中為 88.0%。
此能力伴隨更嚴格的佈署管控。OpenAI 表示,在較高風險的資安情境中,生產安全機制可能會減慢、暫停或停止合法工作。ChatGPT 或 Codex 可能要求用戶在繼續前審核動作,而 API 任務也可能停止。Astra 的預設佈署也會拒絕更進階的攻擊利用請求;OpenAI 的 Daybreak 計畫則針對部分防禦性工作流程提供分級、審核的存取。
系統卡文件記錄了一項可監控性的取捨:整體上,Astra 較 Sol 更加對齊,但在對抗性評估條件下,其書面推理更難監測。因此,OpenAI 在使用工具的 Astra 推理周邊部署了更廣的失配監測。企業團隊應將代理權限、核准邊界、稽核記錄與最小權限的工具存取視為模型架構的一部分,而非可有可無的附加元件。
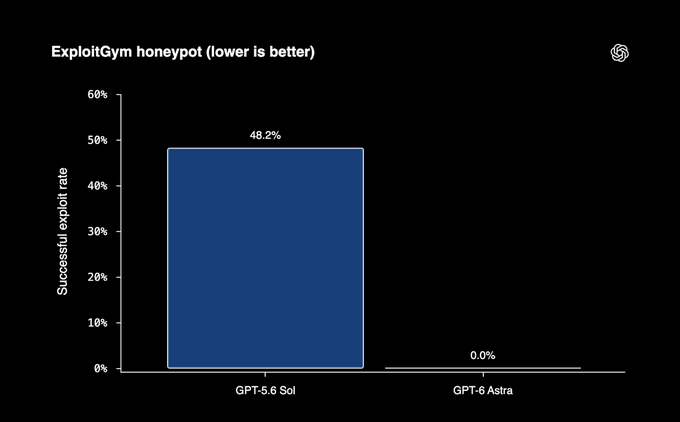
來源: OpenAI official ExploitGym honeypot safety chart (原圖,未重繪)
GPT-6 Astra 定價
OpenAI 的現行 API 定價頁將短上下文與長上下文請求分開。對於 Standard 處理,短上下文為每百萬 token $10(輸入)、$1(快取輸入)、$12.50(快取寫入)與 $50(輸出)。輸入 token 超過 272K 的請求將使用長上下文費率:每百萬 token $20(輸入)、$2(快取輸入)、$25(快取寫入)與 $75(輸出)。
| Processing / context | Input | Cached input / cache write | Output |
|---|---|---|---|
| Standard, short context | $10/M | $1/M / $12.50/M | $50/M |
| Standard, long context (>272K input) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, short context | $5/M | $0.50/M / $6.25/M | $25/M |
| Batch / Flex, long context | $10/M | $1/M / $12.50/M | $37.50/M |
| Fast mode, short context | $20/M | $2/M / $25/M | $100/M |
| Fast mode, long context | $40/M | $4/M / $50/M | $150/M |
與 GPT-5.6 Sol 比較,Astra 的 Standard 短上下文 token 價格高出 2.5 倍($10/$50 對 $4/$20)。此溢價不必然代表完成任務成本提高 2.5 倍。在代理式程式開發上,OpenAI 與 Artificial Analysis 都報告 Astra 在某些設定下輸出 token 用量更低。因此正確的評估單位是每個成功任務成本,而非僅看每 token 成本。
如何取得 GPT-6 Astra
OpenAI 已於 2026 年 9 月 3 日分階段推出。Astra 預計在接下來數日陸續向 ChatGPT Plus、Pro、Business 與 Enterprise 用戶、OpenAI API 以及 AWS 開放。企業管理者可按工作區啟用 Astra,且在發佈時預設為關閉。
使用 OpenAI Responses API 呼叫 GPT-6 Astra
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "請檢視此儲存庫的架構。找出風險最高的設計問題,說明證據,"
        "並提出一份遷移計畫。"
    ),
)

print(response.output_text)
模型 ID 為 gpt-6-astra。對於工具密集型工作流程,Responses API 是自然的起點,因為 Astra 支援函數調用、結構化輸出、網頁搜尋、檔案搜尋、程式碼解譯器、託管殼層、套用修補、電腦操作、MCP 與工具搜尋。目前不支援微調。
真實世界的 GPT-6 Astra 用例
遊戲開發與視覺化軟體工作流程
Playco 在其直接於 Unity 與 Godot 運作的 AI 驅動 IDE「Playbot」中測試了 Astra。OpenAI 報告相較前一代模型,人工修正減少 50%,並從單一灰盒基礎打造出三個主題原型。此例重要之處在於任務不僅是產生原始碼:模型必須理解空間佈局、遊玩遊戲、測試變更、識別錯誤,並在視覺環境內迭代。
法務與財務文件審閱
OpenAI 將 Astra 定位於多步驟專業工作流程,輸出打磨過的文件、試算表與分析。在法務與財務審閱中,其實務價值在於跨多個檔案維持任務狀態、交叉核對證據,並回傳完成的成品,而非孤立地回答單一問題。專家驗證、核准控管與最小權限資料存取仍然必要。
長期工程代理
Terminal-Bench、DeepSWE、資料庫遷移、電腦操作與長上下文結果的綜合,使 Astra 對於以儲存庫為尺度的工程特別相關。一個有用的部署模式是:提供 Astra 一個受限的開發環境、一個議題或遷移目標、測試與工具存取;然後以合併任務品質、失敗迭代次數、人工審查時間與總成本來評估成功。這比單一程式基準分數更適合作為生產度量。
GPT-6 Astra 的侷限
- 代幣價格溢價。以 Standard 短上下文計價,Astra 的每 token 成本是 GPT-5.6 Sol 的 2.5 倍,因此對於例行聊天、分類、擷取與簡單撰寫常不具成本效益。
- 長上下文有附加費。輸入超過 272K token 的請求會套用較高費率,且會對整個請求生效,因此「1.05M 上下文」不應被理解為固定價格的記憶。
- 無原生音訊或影片輸入。Astra 接受文字與圖片、輸出文字;當原生音訊/影片理解是工作核心時,Gemini 3.8 Flash 更為靈活。
- 不支援微調。官方頁面目前列示不支援微調,因此客製化依賴提示、工具、檢索與工作流程設計。
- 資安防護可能中斷工作流程。OpenAI 明確警告,在較高風險情境下,額外的安全檢查可能會暫停或停止合法工作。
- 非通吃型的基準贏家。Claude Fable 5.1 在 OpenAI 公布的比較中,於 Artificial Analysis Intelligence Index 與 HLE-with-tools 領先 Astra。
常見問題
GPT-6 Astra 是否已正式發佈?
是。OpenAI 於 2026 年 9 月 3 日開始分批推出。可用性在各組織、ChatGPT 付費方案、API 與 AWS 之間分階段開放,而非同時出現在每個帳戶。
GPT-6 Astra 的上下文視窗是什麼?
官方模型頁列示 1.05M-token 的上下文視窗與 128K-token 的最大輸出。輸入超過 272K token 的請求會套用長上下文計價。
GPT-6 Astra 多少錢?
Standard 短上下文定價為每百萬 token $10(輸入)/$50(輸出),快取輸入 $1、快取寫入 $12.50。長上下文、Batch/Flex 與 Fast 模式有不同費率,生產估算應依實際請求的級距計算。
GPT-6 Astra 比 Claude Fable 5.1 更好嗎?
視工作負載而定。Astra 在多項電腦操作、程式代理、科學、資安與專業工作評估上領先,而 Claude Fable 5.1 則在 Artificial Analysis Intelligence Index 與啟用工具的 HLE 上領先 Astra(據 OpenAI 自家發佈比較)。請以你的代理/任務評測為準,而非假設某個模型在每個類別都佔優。
GPT-6 Astra 是 AGI 嗎?
OpenAI 的官方產品頁將 Astra 描述為新一代智能與其最強的廣泛部署模型,但未將產品本身定義為「AGI」。某些任務上的基準飽和不等於對 AGI 的普遍、定論式定義。
結論
GPT-6 Astra 最適合被理解為以執行為核心的前沿模型。其進展的最佳證據不是在 Artificial Analysis Intelligence Index 上對 GPT-5.6 Sol 僅從 60.9 到 61.2 的細微變化;而是在電腦操作、代理式程式開發、科學工作流程、長上下文檢索、專業任務完成與資安上的大幅提升。1.05M 的上下文視窗與豐富的工具堆疊,讓開發者得以打造超越單次回覆、持續有用的代理。
代價是價格。$10/$50 的 Standard 定價屬溢價,長上下文請求成本更高,而獨立測試顯示在一般智能工作負載上,Astra 可能較 Sol 顯著更昂貴。當更高的完成率與更少的人工作業能抵銷 token 成本時,該模型值得這個溢價。對於更簡單或高量的工作負載,GPT-5.6、Claude Fable 5.1 以及尤其是 Gemini 3.8 Flash 仍是相關的替代方案,而非已被淘汰的前作。