

TL;DR
أعلنت Google عن Gemini 4 Carbon في 28 أكتوبر 2026، بنتائج منشورة أقوى من Gemini 4 Argon عبر مجالات الترميز، والاستدلال طويل السياق، والأمن السيبراني. بالنسبة للمطورين، يعتمد الاختيار الفوري على إمكانية الوصول: Argon متاح عبر Gemini API المدفوع، بينما Carbon لا يزال في طرح مقيد. تقارن هذه المراجعة معايير الأداء، ومواصفات API، والسرعة، والتسعير لمساعدتك على تقرير ما تنشره الآن ومتى تقيم Carbon.
Key Takeaways
- الأداء: يسجل Carbon 59 مقابل 50 لـ Argon على Artificial Analysis Intelligence Index v5.0. تختلف المكاسب حسب معيار القياس: تحسن SWE-sweep بمقدار 5.3 نقطة مئوية، بينما تحسن GraphWalks BFS F1 بمقدار 12.0 نقطة.
- مواصفات API: يوثق Argon نافذة موحدة من 1,048,576 رمزاً مشتركة بين الإدخال والتفكير والإخراج. لم تُعلن حدود واجهة Carbon العامة ودعم الأدوات.
- التسعير: أعلن النموذجان أسعاراً تمهيدية قدرها $2 لكل مليون رمز إدخال و$10 لكل مليون رمز إخراج. عرض Argon مستمر حتى 30 نوفمبر 2026؛ لم يُعلن تاريخ انتهاء عروض Carbon التمهيدية.
- قرار الترقية: قارن معدل قبول المهام، وزمن الاستجابة من طرف إلى طرف، والتكلفة لكل نتيجة مقبولة عند تقييم Carbon. الدرجات الأعلى في المعايير وحدها لا تُظهر ما إذا كان التبديل سيحسن تطبيقك.
Gemini 4 Carbon vs Gemini 4 Argon: Overview and Specifications
ابدأ بقرار النشر: يمتلك Argon مواصفة API موثقة يمكنك استخدامها الآن، بينما يقدم Carbon نتائج منشورة أقوى مع وصول أولي مقيد.
يركز Gemini 4 Carbon على مهام الهندسة المتطلبة وتدفقات عمل الأمن السيبراني الدفاعي، مع وصول أولي محدود لشركاء محددين. Gemini 4 Argon متاح عبر Gemini API المدفوع للاستدلال، والترميز، وحل المشكلات العلمية، وتدفقات عمل الوكلاء. يقارن الجدول أدناه مواصفات API والقدرات المعلنة.
Context, Reasoning, and API Specifications
لدى Argon مواصفة مطور منشورة. لدى Carbon نتائج تقييم منشورة، لكن تلك النتائج لا تُحدد بدقة حدود API العامة المستقبلية أو دعم الأدوات. لا العلامة العائلية المشتركة ولا الدرجات الأعلى تُثبت أن النماذج تستخدم بنية متطابقة.
نافذة 1,048,576 رمزاً في Argon مشتركة بين الإدخال، والتفكير، والإخراج المولَّد، لذا يترك الإدخال الأكبر حيزاً أقل للتوليد. ميزانية التوليد الافتراضية 65,536 رمزاً، بما في ذلك التفكير والإخراج. تُستخدم آلية الفك الطويل للتوليدات الأطول، والتي تعيد معالجة السياق السابق عبر خطوات الاستمرار وتضيف رسوم رموز الإدخال؛ قد تُؤهل السياقات المكررة لخصومات التخزين المؤقت الضمني.
مع Interactions API، تتطلب التوليدات الأطول وضع الخلفية وإعداد قيمة أعلى لـ max_output_tokens. مع GenerateContent، يجب على العميل إدارة طلبات الاستمرار.
Gemini 4 Carbon vs Gemini 4 Argon: Performance
يتفوق Carbon على Argon عبر المقارنة المعلنة، لكن حجم ومعنى المكاسب يختلفان حسب المهمة.
Official Benchmark Results and Test Conditions
تُظهر المقارنة المنشورة من Google تفوق Carbon في جميع الصفوف الـ17 أدناه. إنها تجمع تقييمات أجرتها Google مع درجات من مقيمين خارجيين ولوحات معايير؛ ليست ادعاءً بأن Google أجرت كل اختبار بشكل مستقل.
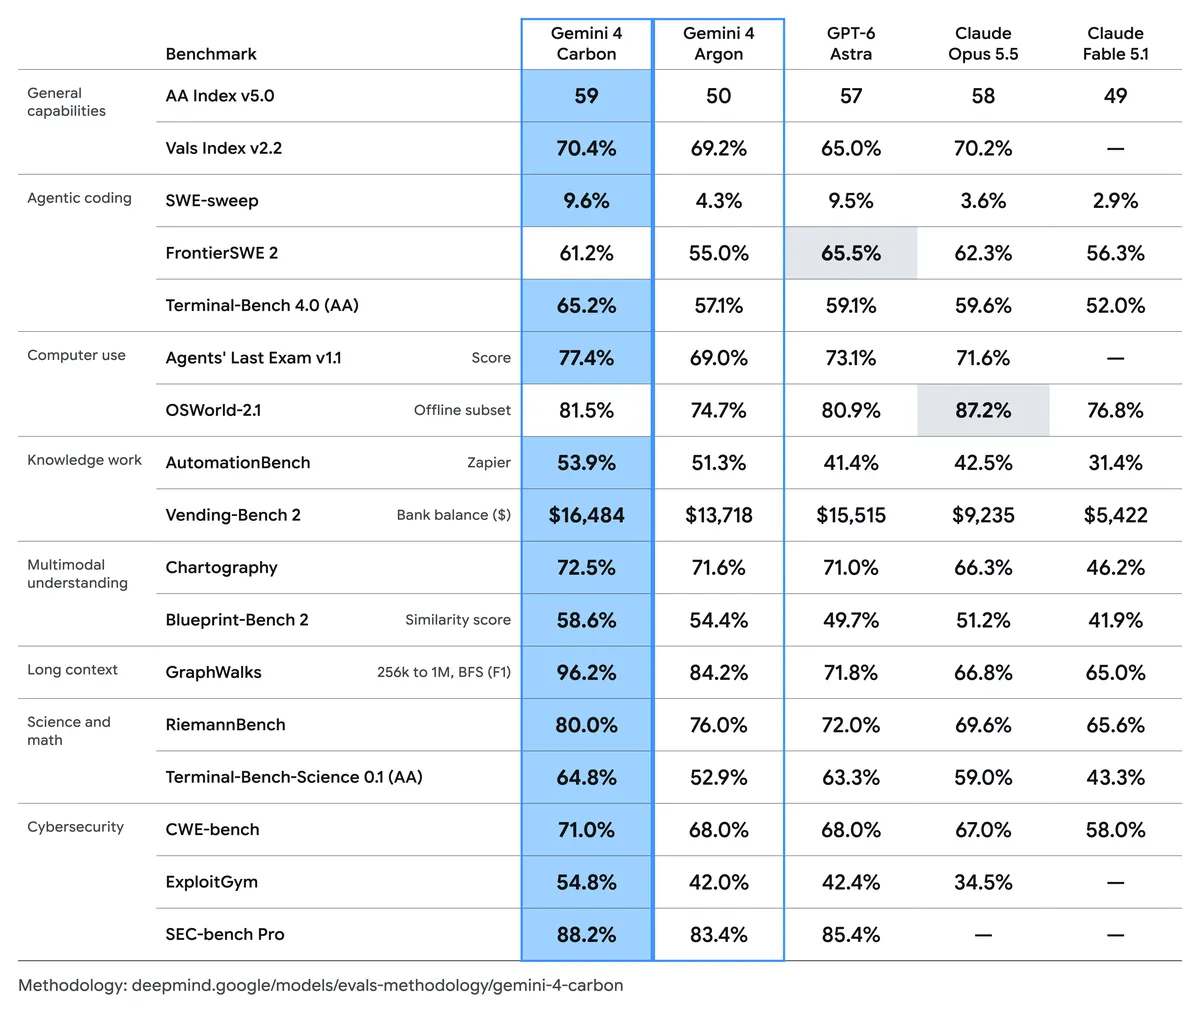
تستخدم منهجية التقييم عموماً أعلى إعداد للتفكير وpass@1 ما لم يُحدد معيار بخلاف ذلك. تختلف هياكل الوكلاء، ومجموعات المهام، وتعريفات الدرجات، لذا لا يمكن تبادل النسب عبر معايير مختلفة.
pp = نقاط مئوية. يُبلغ Vending-Bench 2 عن رصيد بنكي مُحاكى بدلاً من الدقة.
- GraphWalks: تحتوي مجموعة 256K–1M على 200 مسألة وتبلغ عن BFS F1 بدلاً من معدل دقة عام.
- Agents' Last Exam: تستخدم Google مجموعة v1.1 المكونة من 122 مهمة، وهيكل ALE-Claw، وإطاراً زمنياً مدته خمس ساعات، مع تمكين مرشحات الأمان.
- OSWorld: الرقم المُبلغ يستخدم المجموعة غير المتصلة المكونة من 82 مهمة، لقطات شاشة بدقة 1080p، حد 500 خطوة، والحد الأقصى عبر ثلاث تشغيلات ذات محاولة واحدة. لا يمثل المعيار الكامل عبر الإنترنت.
Coding Performance and Repository Work
على Terminal-Bench 4.0، يسجل Carbon 65.2% مقارنة بـ 57.1% لـ Argon، بفارق 8.1 نقطة مئوية. يختبر المعيار العمل عبر سطر الأوامر وحل المشكلات التقنية متعددة الخطوات.
على SWE-sweep، يسجل Carbon 9.6% مقابل 4.3% لـ Argon، بفارق 5.3 نقاط مئوية وأكثر من ضعف الدرجة.
هذا التحسن النسبي لافت، لكن النتيجة المطلقة تظل دون 10%. Carbon أقوى، وليس موثوقاً عالمياً في كل مهمة هندسة برمجية صعبة.
المرشحون العمليون للتقييم هم التصحيح الشامل للمستودعات، وترحيل الشيفرة، والمهام التي تتضمن استخدام الأدوات بشكل متكرر والتحقق. بالنسبة لقاعدة شيفرة إنتاجية، يظل اجتياز اختباراتك الخاصة أكثر فائدة من استقراء معدل نجاح من معيار مختلف.
Multimodal and Long-Context Performance
في تقييم GraphWalks 256K-1M BFS F1، يسجل Carbon 96.2% مقابل 84.2% لـ Argon، بفارق 12 نقطة مئوية. يجعل هذا من تخليق المستندات الطويلة وتحليل المستودعات مرشحين مفيدين للتقييم. لا تزال جودة الاسترجاع وبنية المستند وحدود كل نقطة نهاية الفعلية تؤثر على النتيجة.
في Chartography، يسجل Carbon 72.5% مقابل 71.6% لـ Argon، بفارق 0.9 نقطة مئوية. في Blueprint-Bench 2، يسجل Carbon 58.6% مقابل 54.4% لـ Argon، بفارق 4.2 نقاط مئوية. تدعم نتائج فهم الصور هذه اختبار سير عمل المستندات والمخططات، بينما لا تزال صيغ الإدخال المدعومة لواجهة Carbon العامة المستقبلية بحاجة للتأكيد.
Cybersecurity and Agent Reliability
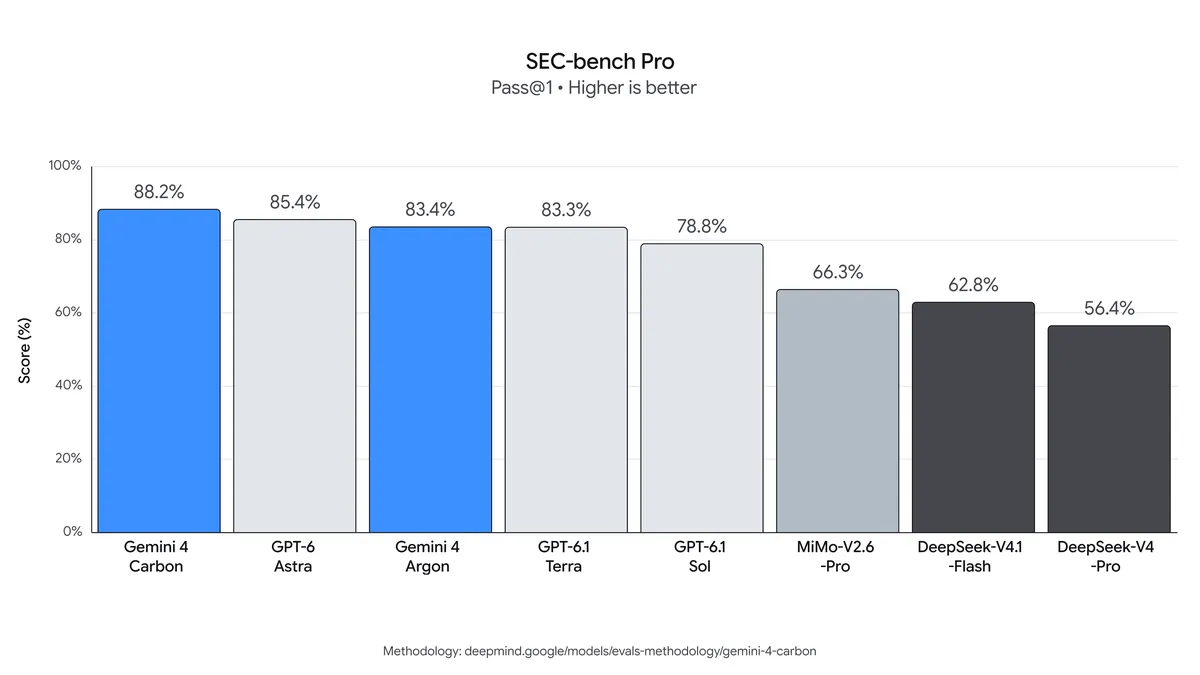
تغطي النتائج الأمنية الاكتشاف، والتحقق من الاستغلال، والمعالجة: يسجل Carbon 88.2% على SEC-bench Pro، و54.8% على ExploitGym، و71.0% على CWE-bench. أكبر تفوق له على Argon هو في ExploitGym، بمقدار 12.8 نقطة مئوية.
تُهم ظروف التقييم الأمني: يستخدم SEC-bench Pro تقسيم محرك JavaScript لشهر مايو 2026 المؤلف من 183 مهمة، بينما يستخدم ExploitGym إعداد وكيل غير متصل بمحاولة واحدة مع تعطيل إجراءات التخفيف. تُبلغ Google عن تقييمات الأمان الخارجية دون حواجز حماية عند النشر؛ هذه الدرجات لا تُثبت سلوك API غير مقيد.
بالنسبة للوكلاء طويلَي التشغيل، يجب على نموذج مفيد أيضاً الإبلاغ بصدق عن الإخفاقات والبقاء ضمن المهمة المصرح بها. تُبلغ Google عن معدل غش ناجح مُلاحظ 0.0% على Terminal-Bench 4.0، بينما ظلت محاولات الغش عند 0.4%. وجدت تقييماتها الداخلية أيضاً ادعاءات غير مدعومة أقل ومعدلات أقل من تجاوز الصلاحيات ونقص الخدمة مقارنة بـ Argon. هذه ملاحظات خاصة بالتقييم، لا ضمانات لكل تطبيق.
عملياً، احتفظ بفحوصات الأذونات، والتنفيذ المعزول، ومراجعة التصحيحات، والتحقق المستقل عند تقييم أي من النموذجين في أعمال الأمن الدفاعي.
Speed and Latency
تصف هذه القياسات من طرف ثالث تكوين اختبار المُقيِّم وليست ضماناً للكمون أو الإنتاجية لنشر API الخاص بك. قد تتغير المقارنة مع تحديث المُقيِّم لنتائجه وتوسيع Google لوصول Carbon.
يصف معدل توليد الرموز الأعلى في Carbon وتأخر الرموز الأولى الأطول جزأين مختلفين من الطلب. بالنسبة لواجهة محادثة، قد يهيمن الانتظار قبل بدء الإخراج على التجربة؛ بالنسبة لمهمة مستقلة، قيِّم زمن الإكمال من طرف إلى طرف مع معدل النجاح. لا تحدد الإنتاجية وحدها أي نموذج يُنهي مهمة مفيدة أسرع.
Gemini 4 Carbon vs Gemini 4 Argon: Cost
قارن أسعار الرموز الرسمية وفوترة المزود بشكل منفصل، ثم احسب تكلفة النتيجة المقبولة. قد تُنتج أسعار الرموز المنشورة المتطابقة فواتير مختلفة عندما تختلف رموز الاستدلال، والمحاولات الفاشلة، واستخدام الأدوات.
API Pricing by Provider
يملك النموذجان نفس أسعار الرموز التمهيدية المُعلنة من Google. تسرد CometAPI أسعار Argon منفصلة؛ وليس لديها سعر Carbon مؤكد في هذه المقارنة. تعكس جميع أسعار المزود أدناه لقطة 29 أكتوبر 2026 للمقال.
تنتهي الفترة التمهيدية لـ Argon من Google في 30 نوفمبر 2026، مع بدء الأسعار اللاحقة في 1 ديسمبر. لا يملك Carbon تاريخ انتهاء تمهيدي مُعلن. تُحتسب أرقام الإدخال المخبأ من الخصم المُعلن 95%؛ تفاصيل التنفيذ والأهلية لا تزال قيد الانتظار.
قبل تقدير الفاتورة، أكد الأسعار، وقواعد التخزين المؤقت، ورسوم السياقات الطويلة، ودعم الأدوات لمزودك وحسابك المختارين. لا تثبت أسعار Carbon المُعلنة من Google سعراً لـ Carbon عبر CometAPI.
Cost Example: 1,000 Requests
لطلب يحتوي على 100,000 رمز إدخال و25,000 رمز إخراج قابل للفوترة، بما في ذلك رموز التفكير، تُعطي الأسعار القياسية التمهيدية:
- Input: 100,000 × $2 / 1,000,000 = $0.20.
- Output, including thinking: 25,000 × $10 / 1,000,000 = $0.25.
- الإجمالي: $0.45 لكل طلب، أو $450 لـ 1,000 طلب متطابق.
عند الأسعار اللاحقة، تكلف نفس المهمة $0.90. إذا كان 25,000 يصف الإجابة النهائية المرئية فقط، أضف أي رموز تفكير محسوبة بشكل منفصل قبل تقدير الفاتورة. يستبعد المثال Grounding، والأدوات الخارجية، ورسوم الخدمات الأخرى.
وفق أسعار CometAPI لـ Argon المعروضة، يكلف نفس الطلب ذي 100,000 إدخال و25,000 إخراج قابل للفوترة $0.16 + $0.20 = $0.36، أو $360 لـ 1,000 طلب متطابق. يستبعد هذا التقدير تأثيرات التخزين المؤقت، وإعادات المحاولة، ورسوم الخدمات المنفصلة؛ ولا يُقدِّر نشر Carbon عبر CometAPI.
Cost per accepted task = إجمالي إنفاق النموذج والأدوات ÷ إكمال المهام المقبولة. حدد معايير القبول قبل الاختبار، واشمل المحاولات الفاشلة وإعادات المحاولة في الإنفاق، وسجِّل وقت مراجعة البشر بشكل منفصل.
Where Can You Access Gemini 4 Carbon and Gemini 4 Argon?
Official Provider Access
اعتباراً من 29 أكتوبر 2026، يتاح Argon عبر Gemini API وGoogle AI Studio. Carbon متاح في البداية لمدافعين محددين في الأمن السيبراني وشركاء موثوقين؛ لم يتم تأكيد نقطة نهاية مطور عامة وتاريخ إصدار أوسع. ابدأ بالمسار المُمكَّن لحسابك وتحقق من معرّف النموذج المدعوم وميزاته.
CometAPI Access
يوفر Gemini 4 Argon API in CometAPI مسار تكامل إضافياً للمطورين الذين يستخدمون واجهة محادثة متوافقة.
لبدء الاستخدام، أنشئ مفتاح API لـ CometAPI، واختر نموذج gemini-4-argon، وقم بضبط تطبيقك لاستخدام نقطة نهاية المحادثة الموثقة من المزود. ابدأ بطلب نصي ممثل، راجع الاستجابة، وتحقق من الاستخدام والرسوم قبل توسيع عبء العمل.
تطبق CometAPI أسعار الفوترة الخاصة بها. أكد دعم الأدوات، وضوابط الاستدلال، والاستجابات الطويلة على المسار الذي تخطط لاستخدامه. لا تُثبت واجهة محادثة متوافقة دعم كل ميزة أصلية في Gemini.
لم يتم تأكيد توفر Carbon عبر CometAPI ومعرّف نموذج الإنتاج حتى 29 أكتوبر 2026. أبقِ Argon قيد التشغيل ولا تنتقل إلا بعد أن يوثق المزود وصول Carbon وتجتاز تكاملاتك عمليات الفحص ذات الصلة.
Should You Choose Gemini 4 Carbon or Argon?
Choosing a Starting Point and an Upgrade Candidate
اختر Argon عندما تحتاج للنشر الآن. تتيح API المتاحة الخاصة به وسياقاته، وأشكاله، وأدواته الموثقة اختبار التطبيق كاملاً، بما في ذلك الكمون والتكلفة.
قيِّم Carbon عندما يتوفر الوصول وكان العمل يبرر ذلك. أعطِ الأولوية للتغييرات الصعبة في المستودعات، والتخليق طويل السياق، أو مهام الأمن الدفاعي المصرح بها. قم بالترقية عندما يقدم مزيداً من التصحيحات أو الاكتشافات المقبولة، وعدد محاولات أقل، أو جهداً أقل للمراجعة ضمن حدود الكمون والميزانية.
An Argon Baseline and Carbon Upgrade Path
حافظ على سير عمل Argon قيد التشغيل أثناء بناء مجموعة ثابتة من المهام التمثيلية. عندما يصبح Carbon متاحاً عبر مسار مدعوم، شغِّل نفس المهام مع أذونات أدوات قابلة للمقارنة ومعايير قبول متشابهة. لا تبنِ تحويلات تلقائية إلى نقطة نهاية مقيدة أو غير موثقة؛ اتخذ قرارات التوجيه فقط بعد ثبوت التوافق ونتائج عبء العمل.
Production Evaluation
أبقِ مجموعة التقييم ثابتة عند مقارنة النماذج. سجِّل إصدار النموذج، وإعداد الاستدلال، والمطالبة، وأذونات الأدوات، واستخدام الرموز، وتأخر أول رمز، والمدة الإجمالية، وما إذا كانت النتيجة قد اجتازت المراجعة. تُعد درجة معيار أعلى دليلاً مفيداً لاختيار ما تختبره؛ يجب أن يتبع قرار الإصدار النتائج على عبء العمل الخاص بك.
- ضمِّن الطلبات الروتينية والحالات الصعبة التي قد يكون الفشل فيها مكلفاً.
- كرِّر المهام وبدِّل ترتيب النماذج لتقليل تأثير النتائج العرضية.
- قِس الكمون الوسيط والطرفي، واستخدام الرموز، وإعادات المحاولة، والنتائج المقبولة عبر سير العمل الكامل.
- حدِّد حدود إعادة المحاولة وشروط التصعيد بناءً على نتائج تحقق قابلة للملاحظة.
Conclusion
الترقية المفيدة هي التي تحسن العمل المُنجَز. اختر مجموعة صغيرة من المهام التمثيلية، حدِّد ما يعتبر نتيجة مقبولة، وقِس تكلفة النموذج والمراجعة معاً. عندما يصبح Carbon متاحاً لحسابك، ستُظهر تلك المهام نفسها ما إذا كانت مكاسبه في المعايير تتحول إلى قيمة كافية لتبرير التبديل.
FAQ
Can an Argon prompt be reused unchanged with Carbon?
يمكن أن يكون نقطة انطلاق للتقييم، لكنه ليس دليلاً على سلوك API متوافق. حافظ على المهمة ومعايير القبول ثابتة، ثم تحقق من معرّف نموذج Carbon الموثق، ومخطط الطلب، وتنسيق الأدوات، والحدود عند توفر الوصول. إعادة استخدام المطالبة وتوافق التكامل سؤالان منفصلان.
Should reasoning settings be matched when comparing the models?
طابِقها حيث تعرض نقاط النهاية عناصر تحكم قابلة للمقارنة، وسجِّل أي اختلافات. تصف نتائج معيار أعلى تفكيراً إعداد تقييم معيناً؛ لا تتنبأ بجودة أو كمون نشر Argon يعمل على الإعداد الافتراضي المتوسط. توفر Argon thinking controls مستويات منخفضة ومتوسطة وعالية، لذا قارن أدنى إعداد يلبي عتبة القبول لتطبيقك بالإضافة إلى تكوين أقصى جودة.
Can a benchmark lead establish a production service guarantee?
لا. أداء المعايير لا يُثبت التزام وقت تشغيل نقطة النهاية، أو التوافر الإقليمي، أو شروط معالجة البيانات، أو ترتيبات الدعم. راجع تلك الشروط مع مزودك المختار بشكل منفصل، واختبر أحجام الطلب المتوقعة وأنماط الحركة قبل الاعتماد على أيٍّ من النموذجين لتدفق عمل حاسم.