ابدأ بـ GPT-6.1 Terra للمهام عالية الحجم والقابلة للتحقق والحساسة للتكلفة. قيّم GPT-6.1 Sol للترميز المعقّد، واستخدام الأدوات متعددة الخطوات، وسير العمل التي تكون فيها الإخفاقات مكلفة. الافتراضي العملي هو استخدام Terra أولاً ثم التصعيد إلى Sol عندما تفشل الاختبارات أو فحوصات التحقق المحددة مسبقًا.
النقاط الأساسية
تسعير الرموز القياسي: على OpenAI Standard، تبلغ تكلفة Terra $1 لكل مليون رمز إدخال و$5 لكل مليون رمز إخراج؛ بينما تبلغ تكلفة Sol $2 و$10 على التوالي.
أداء خاص بالمهمة: عند أقصى جهد للاستدلال، يتفوق Terra بفارق ضئيل في Agents’ Last Exam v1 وTerminal-Bench-Science 0.1، بينما يتفوق Sol في Terminal-Bench 4.0 وOSWorld 2.1.
سعة سياق مشتركة: كلا النموذجين يقدّم نافذة سياق بسعة 1.05 مليون رمز ويقبلان إدخالات نصية وصورية.
عناصر تحكم مختلفة في الاستدلال: يدعم Terra تعطيل الاستدلال باستخدام ؛ بينما يتطلب Sol مستوى استدلال لا يقل عن .
تمت المراجعة للوضوح ودقة المصدر ومصطلحات API الحالية.
none
low
التكلفة التشغيلية مهمة: قارن الإنفاق لكل مهمة مكتملة بنجاح، بما في ذلك المحاولات المتكررة واستدعاءات الأدوات، وتتبع تكاليف مراجعة البشر بشكل منفصل.
GPT-6.1 Terra مقابل GPT-6.1 Sol: نظرة عامة والمواصفات
تُلخص النظرة العامة أدناه المفاضلات. تشرح الأقسام التفصيلية الأدلة، وافتراضات الفوترة، والحدود وراء كل اختيار.
عامل القرار
GPT-6.1 Terra
GPT-6.1 Sol
عبء العمل المبدئي
أعمال مرئية روتينية ووكلاء قابلون للتكرار
ترميز معقّد واستدلال مهني مستمر
السياق والوسائط
نفس سعة السياق الإجمالية؛ إدخال نصوص وصور
نفس سعة السياق الإجمالية؛ إدخال نصوص وصور
التحكم في الاستدلال
يتضمن خيار إيقاف الاستدلال
يتطلب على الأقل مستوى استدلال low
نمط الأداء المنشور
أداء منخفض التكلفة في مهام الوكلاء المتكررة
أقوى في عدة اختبارات ترميز صعبة وأتمتة سطح المكتب
الوصول عبر API
OpenAI وCometAPI
OpenAI وCometAPI
GPT-6.1 Terra: سير عمل مرئي ووكيلي فعّال
قدمت OpenAI GPT-6.1 Terra في 26 أكتوبر 2026. يجمع بين الاستدلال المرئي، واستخدام الحاسوب، وتوليد النصوص للأعمال المهنية الروتينية. تُعد معدلات الرموز الأقل نقطة انطلاق مفيدة عندما تكون المهام متكررة والنتائج قابلة للتحقق.
GPT-6.1 Sol: ترميز معقد واستدلال مهني
أُطلق GPT-6.1 Sol في 29 سبتمبر 2026. يستهدف أعمال الترميز والمهن الم demanding. قيّمه عندما تجعل المستودعات غير المألوفة، أو سلسلة طويلة من الإجراءات المتعاقبة، أو التصحيحات المكلفة، من القيمة إضافة قدرة استدلالية أعلى.
السياق، الاستدلال، ومواصفات API
المواصفة
GPT-6.1 Terra
GPT-6.1 Sol
تاريخ الإصدار الرسمي
26 أكتوبر 2026
29 سبتمبر 2026
معرّف نموذج API
gpt-6.1-terra
gpt-6.1-sol
نافذة السياق
1,050,000 رمز
1,050,000 رمز
تاريخ قطع المعرفة
1 يونيو 2026
30 أبريل 2026
الإدخال / الإخراج
نصوص وصور / نص
نصوص وصور / نص
مستوى الاستدلال
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
مستوى الاستدلال الافتراضي
medium
medium
ميزات API: يدعم كلا النموذجين Structured Outputs والبث (streaming) وBatch API. يستخدم استدعاء الأدوات Responses API، ولا يُدعم الضبط الدقيق (fine-tuning). تحقق من أن المزوّد ونقطة النهاية المختارين يقدمان الميزات التي يحتاجها تطبيقك.
يسمح كلا النموذجين بما يصل إلى 128,000 رمز إخراج ضمن نافذة سياق 1,050,000 رمز. إن حجز كامل بدل الإخراج يترك 922,000 رمزًا لباقي التبادل، بما في ذلك إدخالك وتعليمات النظام وسجل الأدوات. هذا حساب تخطيطي، وليس حد إدخال ثابتًا منفصلًا.
إفصاح حول البنية: لا توفر مواصفات النموذج العامة المرتبطة تفاصيل داخلية كافية عن البنية لإجراء مقارنة موثوقة. لا ينبغي اعتبار سعة السياق وإعدادات الاستدلال دليلاً على عدد المعاملات أو البنية.
عناصر التحكم في الاستدلال: يُعد إعداد Terra بقيمة none مفيدًا للتحويلات البسيطة والاستخراج. للمقارنة الأولى، استخدم نفس إعداد الاستدلال المدعوم على كلا النموذجين، ثم قم بضبط كل نموذج وفقًا للجودة والزمنية التي يتطلبها سير عملك.
كلا النموذجين لديهما سعة سياق منشورة نفسها، لكن ذلك لا يعني دقة استرجاع أو جودة استدلال طويلة السياق متطابقة. لذا ينبغي أن تتناول عملية اختيار النموذج جودة الاستدلال وكفاءة سير العمل والتكلفة والأداء الخاص بالمهمة في الاسترجاع.
GPT-6.1 Terra مقابل GPT-6.1 Sol: الأداء
تعرض النتائج المبلغ عنها صورة مختلطة: يتفوق Terra بفارق ضئيل في بعض تقييمات الوكلاء وترميز العلوم، بينما يسجل Sol درجات أعلى في ترميز الطرفية العام، وأتمتة سطح المكتب، والرؤية. تفصل المقارنات أدناه بين نتائج إطلاق OpenAI والتقييمات المستقلة وتشرح ما يمكن لكل منها—وما لا يمكن—أن يخبرك به عن أداء الإنتاج.
نتائج المعايير الرسمية وظروف الاختبار
تأتي النتائج التالية من تقييمات إطلاق Terra لدى OpenAI. يظهر Terra عند جهدي استدلال متوسط وأقصى؛ بينما يظهر Sol عند أقصى جهد. تقارن العمود الأخير التهيئات عند أقصى جهد فقط.
يستخدم OSWorld التقييم غير المتصل 2.1. يستخدم اختبار الواقعية مطالبات داخلية من OpenAI مصممة لإحداث أخطاء. هذه نتائج مبلّغ عنها من البائع لإعدادات تقييم محددة، وليست قياسات لحمل العمل الإنتاجي لديك.
معيار القياس
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
المقارنة عند أقصى جهد
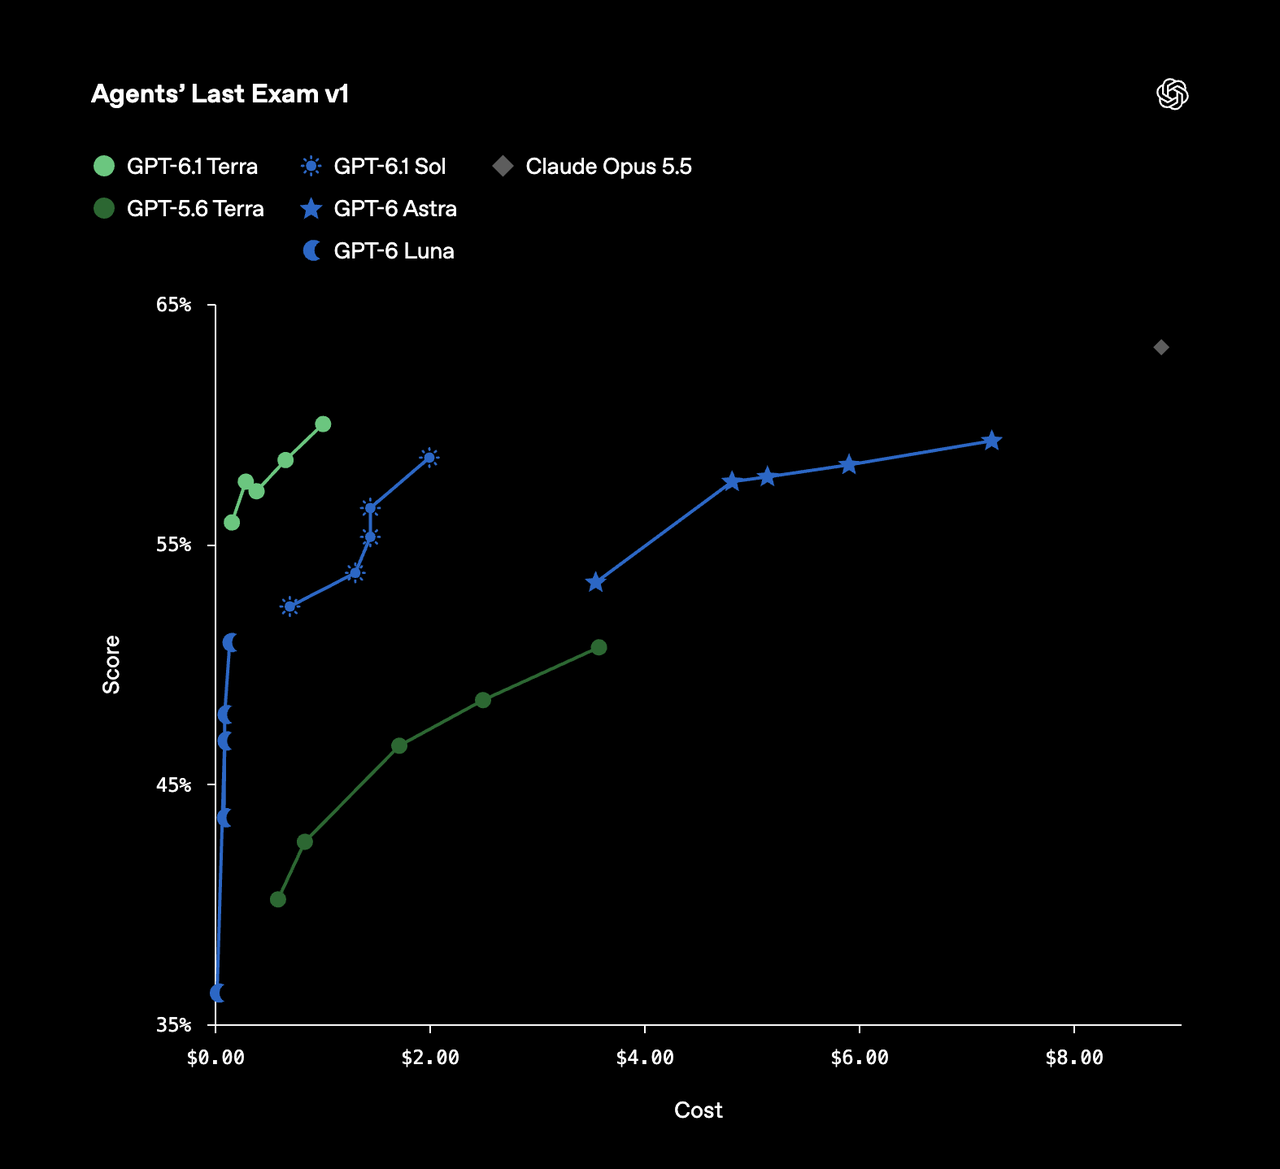
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 نقطة مئوية
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 نقطة مئوية
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 نقطة مئوية
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 نقطة مئوية
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 نقطة مئوية
معدل الخطأ الواقعي على المطالبات الصعبة
10.10%
4.30%
4.40%
Terra أقل بـ 0.1 نقطة مئوية
جميع الدرجات عبارة عن نسب مئوية؛ تُعبّر الفروق بنقاط مئوية (pp). يكون الأقل أفضل فقط بالنسبة لمعدل الخطأ الواقعي. إن فرق 0.1 نقطة بمفرده لا يثبت ميزة موثوقية ذات دلالة.
بالنسبة لهندسة البرمجيات، تشير أسبقية Sol في Terminal-Bench وتفوّق Terra الطفيف في Terminal-Bench-Science إلى أن النتائج تعتمد على نوع مهمة الترميز. بالنسبة لسير العمل التطبيقي، يدعم تفوق Sol في OSWorld تقييمه لأتمتة سطح المكتب، فيما يجعل أداء Terra في Agents’ Last Exam منه مرشحًا لمهام الوكلاء المهنية. لا يثبت أي من النمطين فائزًا عامًا.
يمكن أن تؤثر هياكل الوكلاء، والوصول إلى الأدوات، وتكوين البيئة على هذه النتائج. استخدم الأرقام لتحديد المرشحين للاختبار، ثم تحقّق منها مقابل تغييرات المستودع وسير العمل التطبيقي التي تحتاج حقًا إلى إنجازها.
يرسم مخطط OpenAI لـ Agents’ Last Exam v1 الدرجات مقابل تكاليف المهام المقدرة عبر تهيئات النموذج. يضيف منظور كفاءة التكلفة إلى جدول الدرجات أعلاه؛ التكاليف المرسومة خاصة بإعداد التقييم.
تقييمات الذكاء والترميز المستقلة
يضع تقييم Artificial Analysis بتاريخ 26 أكتوبر Terra بأربع نقاط دون Sol على مؤشر الذكاء الخاص به عند أقصى جهد استدلال. يمنح Coding Agent Index v2.0 قيمة 48 لـ Terra و54 لـ Sol. هذه تقييمات منفصلة بأساليبها ومقاييسها؛ لا ينبغي جمعها عدديًا مع نتائج معايير OpenAI.
يشير التحليل نفسه إلى أن إعدادات الاستدلال المنخفضة والمتوسطة لـ Terra فعّالة بشكل خاص من حيث التكلفة على تقييم الذكاء. يدعم هذا اختبار التهيئات العملية إلى جانب إعدادات أقصى جهد. تبقى تكاليف التقييم خاصة بإعداد الاختبار ولا ينبغي اعتبارها تقديرات لإنفاق تطبيقك.
السرعة والزمنية: إتمام المهمة مقابل معدل توليد الرموز
تفيد OpenAI بأن Terra يكمل مهام Agents’ Last Exam المقيمة أسرع بأكثر من ثلاث مرات من Sol. هذا قياس شامل لإتمام المهمة يشمل الاستدلال وتفاعلات البرمجيات. لا يعني معدل إنتاج رموز إخراج أعلى بثلاث مرات أو تحقق نفس التسريع لكل طلب API.
بالنسبة للتطبيقات التفاعلية، ميّز بين الزمن حتى أول رمز، الذي يقيس زمن الانتظار قبل بدء الإخراج، وبين رموز الإخراج في الثانية، الذي يقيس مدى سرعة استمرار الإجابة. بالنسبة للوكلاء، أولِ الأولوية لزمن الإتمام الشامل، بما في ذلك استدعاءات الأدوات، والمحاولات المتكررة، والاسترداد.
قارن كلا النموذجين باستخدام نفس المطالبات، والأدوات، وإعداد الاستدلال المدعوم، ومعايير القبول. سجّل الزمنية جنبًا إلى جنب مع نجاح المهمة: للاستجابة الأسرع قيمة محدودة إذا كانت تتطلب مزيدًا من التصحيح أو تفشل في إتمام سير العمل.
أداء الرؤية والسياق الطويل: ما الذي تثبته النتائج
إن تفوق Sol بمقدار 0.8 نقطة مئوية على MMMU-Pro عند أقصى جهد هو نتيجة رؤية واحدة مُبلغ عنها، وليس ضمانًا لأداء أفضل في كل سير عمل بصري. اختبر الملصقات الصغيرة، والمسوح الرديئة، والمخططات الكثيفة، والتنسيقات غير المألوفة باستخدام مدخلات تمثيلية.
لا تحدد التقييمات أعلاه أي النموذجين أفضل في الاسترجاع طويل السياق أو الاستدلال. رغم أن كليهما لديه نفس سعة السياق المنشورة، فإن السعة وحدها لا تُظهر دقة الاسترجاع أو الذاكرة عبر الجلسات. اختبر قدرة كل نموذج على تحديد الأدلة ذات الصلة في مستنداتك واستخدامها، وحافظ على حالة التطبيق صراحة عبر الطلبات.
GPT-6.1 Terra مقابل GPT-6.1 Sol: التكلفة
أسعار الرموز هي نقطة البداية للمقارنة بين التكاليف. تؤثر المحاولات المتكررة، ورموز الاستدلال، واستدعاءات الأدوات، ومراجعة البشر أيضًا على ما تنفقه لإتمام مهمة بنجاح.
المعدلات التالية بالدولار الأمريكي لكل مليون رمز وتسعيرها.
المزوّد وفئة الرموز
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — إدخال
$1.00
$2.00
OpenAI Standard — إدخال مخبأ
$0.05
$0.10
OpenAI Standard — إخراج
$5.00
$10.00
OpenAI Standard — كتابة كاش 30 دقيقة
$1.25
$2.50
OpenAI Standard — كتابة كاش 12 ساعة
$2.50
$5.00
CometAPI — إدخال عادي
$0.80
$1.60
CometAPI — إخراج عادي
$4.00
$8.00
تسعير OpenAI API
تبلغ معدلات Terra المدرجة على Standard نصف معدلات Sol عبر هذه الفئات. تعتمد الرسوم الفعلية على تهيئة الطلب: طلبات السياق الطويل، طبقات المعالجة، المعالجة الإقليمية، واستخدام الأدوات قد يكون لها شروط مختلفة. تحقق من وثائق تسعير OpenAI المعمول بها قبل تقدير تكاليف الإنتاج.
تسعير CometAPI
CometAPI مسار وصول تابع لطرف ثالث بأسعاره وتوافر ميزاته الخاصة. تُعرض معدلات الإدخال والإخراج العادية المدرجة بشكل منفصل أدناه.
بهذه المعدلات، تكون أسعار الإدخال والإخراج العادية لدى CometAPI أقل بنسبة 20% من معدلات OpenAI Standard أعلاه. أكّد الأسعار الحالية، ورسوم السياق الطويل، ودعم التخزين المؤقت، وتوافر الأدوات لحسابك قبل النشر.
مثال تكلفة لـ 1,000 طلب
افترض أن تطبيقًا يجري 1,000 طلب، كلٌ منها يستخدم 2,000 رمز إدخال غير مخبأ و500 رمز إخراج قابلة للفوترة. ينتج عن ذلك إجمالي 2 مليون رمز إدخال و500,000 رمز إخراج.
بالنسبة إلى 1,000 طلب، كلٌ منها يستخدم 2,000 رمز إدخال غير مخبأ و500 رمز إخراج قابلة للفوترة، فإن التكاليف التقديرية هي:
Terra عبر OpenAI: $2.00 للإدخال و$2.50 للإخراج، بإجمالي $4.50.
Sol عبر OpenAI: $4.00 للإدخال و$5.00 للإخراج، بإجمالي $9.00.
Terra عبر CometAPI: $1.60 للإدخال و$2.00 للإخراج، بإجمالي $3.60.
Sol عبر CometAPI: $3.20 للإدخال و$4.00 للإخراج، بإجمالي $7.20.
تستخدم هذه الحسابات المعدلات العادية المدرجة أعلاه، دون خصم Batch API. وهي تستثني كتابات الكاش، ورسوم الأدوات المنفصلة، والمحاولات المتكررة. يجب تضمين أي رموز استدلال مفوترة كإخراج ضمن إجمالي الإخراج.
التكلفة الفعلية لكل مهمة ناجحة
في هذا المقال، تُعد المهمة ناجحة إذا اجتازت جودة محددة مسبقًا، والمخطط عند الاقتضاء، وفحوصات الإتمام دون تصحيح بشري إضافي.
لا تؤدي أسعار الرموز المنخفضة دائمًا إلى تكاليف تشغيلية أقل. قد تتقلص وفورات Terra إذا احتاج إلى مزيد من المحاولات، أو رموز استدلال، أو تدخل بشري. قد تكون معدلات Sol الأعلى مبررة إذا أكمل مزيدًا من المهام بنجاح من المحاولة الأولى.
التكلفة الفعلية للنموذج والأدوات لكل مهمة ناجحة = إجمالي إنفاق النموذج والأدوات عبر جميع المحاولات ÷ عدد المهام الناجحة.
تتبّع تكاليف مراجعة البشر والتصحيح بشكل منفصل. اختر النموذج الذي يلبّي هدف الجودة لديك بأقل تكلفة مجتمعة، بدلًا من مقارنة أسعار الرموز فقط.
أي نموذج ينبغي أن تختار: GPT-6.1 Terra أم GPT-6.1 Sol؟
اختر بناءً على تعقيد المهمة، وجودة الإخراج القابلة للتحقق، وتكلفة الإتمام الإجمالية. يُعد Terra نقطة انطلاق مفيدة لسير العمل الروتيني؛ بينما يستحق Sol التقييم عندما يجعل الاستدلال الصعب أو الإخفاقات المكلفة الإنفاق الإضافي ذا قيمة.
متى تختار GPT-6.1 Terra
ابدأ بـ Terra لاستخراج عالي الحجم، وصياغة المستندات، ومطابقة الكتالوجات، وسير العمل التطبيقية المتوقعة. تُعد هذه المهام مرشحة جيدة عندما يمكن التحقق من النتائج مقابل المستندات المصدر، أو الحقول المطلوبة، أو قواعد التحقق الآلي.
اختر Terra عندما يلبّي دقة وأهداف الإتمام ضمن حدود المحاولات والتصحيح البشري المسموح بها. تقدّم معدلات الرموز الأقل فائدة محدودة إذا قضت عليها الإخفاقات المتكررة.
متى تختار GPT-6.1 Sol
قيّم Sol لتصحيح الأخطاء الصعب، وتغييرات المستودعات التي تشمل العديد من التبعيات، وسير عمل سطح المكتب ذات السلاسل الطويلة من الإجراءات المتعاقبة.
اختر Sol عندما تُظهر الاختبارات أنه ينتج تصحيحات مقبولة أكثر، ويجتاز اختبارات أكثر، أو يتطلب تصحيحًا يدويًا أقل. تُبرر تكلفة الرموز الأعلى عندما تقلل تلك التحسينات التكلفة الإجمالية لإتمام العمل.
متى تستخدم Terra أولًا ثم تصعّد إلى Sol
يمكن لسير عمل هجين استخدام Terra للمحاولة الأولى ثم التصعيد إلى Sol عندما تفشل فحوصات محددة مسبقًا. أسّس التصعيد على النتائج المرصودة بدلًا من الثقة في ثقة النموذج وحدها.
على سبيل المثال، يمكن لسير عمل توليد الشفرة أن:
يطلب من Terra إنتاج التغيير المطلوب.
يشغّل الاختبارات وفحوصات التحقق ذات الصلة.
يصعّد إلى Sol إذا فشل التغيير تلك الفحوصات أو تجاوز قدرة Terra المثبتة.
يرسل الحالات غير المحلولة للمراجعة البشرية بمجرد استنفاد ميزانية المحاولات.
عند التصعيد، حافظ على الطلب الأصلي، والسياق ذو الصلة، والمخرجات الفاشلة، ونتائج التحقق. سجّل استخدام كلا النموذجين حتى تشمل مقارنة التكلفة سير العمل كاملًا.
قائمة فحص تقييم الإنتاج
قبل اختيار نموذج افتراضي أو نشر سير عمل التصعيد:
استخدم مهام تمثيلية: تشمل الطلبات الروتينية والحالات التي يكون فيها الفشل مكلفًا.
حافظ على المقارنات مضبوطة: استخدم تعليمات، وأدلة، وأدوات، ومعايير قبول قابلة للمقارنة. سجّل معرفات النماذج، ونقاط النهاية، وإعدادات الاستدلال، وتواريخ الاختبار.
قياس النتائج المقبولة: تحقّق من الدقة، وصلاحية المخطط عند الاقتضاء، ونتائج الاختبار، والإتمام دون تصحيح يدوي.
قياس الزمن والإنفاق: تتبّع زمنية الوسيط والذيل، والرموز المفوترة، واستدعاءات الأدوات، والمحاولات المتكررة، وجهد المراجعة البشرية.
كرّر المقارنة: شغّل المهام عدة مرات وبدّل ترتيب النماذج لتقليل تأثير النتائج العرضية.
عرّف حدود التشغيل: اضبط ميزانيات المحاولات، ومحفزات التصعيد، ومتطلبات الموافقة البشرية قبل النشر.
قارن سير العمل الكامل: ضمن المحاولات غير الناجحة وتكاليف التصعيد عند حساب الإنفاق لكل مهمة ناجحة.
أين يمكنك الوصول إلى GPT-6.1 Terra وGPT-6.1 Sol؟
وصول المزوّد الرسمي
يتوفر كلا النموذجين عبر OpenAI API. لطلبات النصوص، يدعم Chat Completions؛ ويتطلب استدعاء الأدوات Responses API. أكّد المعلمات المدعومة للنموذج، وحدود حسابك، والأدوات المتاحة على المسار الذي تنوي استخدامه.
الوصول عبر CometAPI
لاستخدام أيّ من النموذجين عبر CometAPI، اتبع quickstart guide لإعداد SDK المتوافق مع OpenAI. وفّر مفتاح CometAPI بأمان عبر متغير البيئة COMETAPI_KEY واضبط عنوان الأساس إلى https://api.cometapi.com/v1. اختر gpt-6.1-terra أو gpt-6.1-sol كمعرّف النموذج، وأكّد أن المسار ممكّن لحسابك.
للمقارنة الأولى، امنح كلا النموذجين نفس المهام التمثيلية واستخدم مستوى استدلال medium. حافظ على التعليمات ومعايير القبول متسقة، كرّر كل مهمة، وبدّل ترتيب النماذج. قارن النتائج الناجحة، والوقت المنقضي، والرموز المفوترة، والمحاولات المتكررة بدلًا من الحكم على أي منهما من استجابة واحدة.
الخلاصة
ابدأ بـ GPT-6.1 Terra لسير العمل المتكرر والقابل للتحقق حيث تهم أسعار الرموز الأقل وسرعة إتمام المهام. قيّم GPT-6.1 Sol عندما تجعل مهام الترميز الصعبة، واستخدام الأدوات متعددة الخطوات، أو الإخفاقات المكلفة، من الفائدة امتلاك قدرة استدلال أعلى. يجب أن يستند الاختيار النهائي إلى تكلفة المهمة المقبولة ضمن مجموعة تقييم تمثيلية، لا على السعر أو معيار واحد فقط.
بالنسبة للعديد من التطبيقات، تتمثل الخطوة العملية التالية في تجربة صغيرة تمثيلية مع شروط نجاح واضحة ومسار تصعيد محدود. دع النتيجة المقاسة تحدد النموذج، بدلًا من الاعتماد على السعر أو معيار واحد فقط.
GPT-6.1 Terra مقابل GPT-6.1 Sol: الاختبارات المعيارية، التسعير، وأيّهما تختار - CometAPI