
الخلاصة
Kimi K3.1 Pro هو ترقية Moonshot AI بتاريخ 24 أكتوبر 2026 لنموذج Kimi K3. يقدّم تدريبًا لاحقًا إضافيًا يُحسّن الترميز الذاتي، والبحث المالي، وسير العمل الممتد في استخدام الأدوات، مع الحفاظ على سعة سياق تقارب مليون رمز.
تُظهر التقييمات المستقلة أداءً أقوى إجمالًا، كما تنخفض أسعار الرموز الرسمية القياسية للإدخال/الإخراج بمقدار الثلث. لا يزال الترقية بحاجة إلى اختبار أعباء العمل: إذ يمكن للاستدلال الأعمق زيادة زمن إنجاز المهمة والإنفاق الكلي، بينما يحتفظ K3 بأفضلية بسيطة في AA-LCR وتتوفر أوزانه حاليًا للاستضافة الذاتية.
أبرز النقاط
- المكاسب الأوضح في التنفيذ العُمَلائي (agentic). تُبلغ Artificial Analysis عن درجات Terminal-Bench 4.0 تقارب ~67% لـ K3.1 Pro مقابل ~13% لـ K3؛ وترتفع درجات Moonshot الداخلية في Financial Research من 58.8 إلى 70.4.
- انخفاض أسعار الرموز لا يضمن انخفاض تكلفة المهمة. تنخفض الأسعار القياسية الرسمية للإدخال/الإخراج من 3$ / 15$ إلى 2$ / 10$ لكل مليون رمز، لكن الاستدلال الإضافي، واستدعاءات الأدوات، والمحاولات المعادة قد تُبدد الوفورات.
- نافذة السياق تبقى كما هي. كلا النموذجين يدعمان حتى 1,048,576 رمزًا. يظل K3 متقدمًا قليلًا في تقييم AA-LCR v1.1 المذكور، لذا اختبر دقة السياق الطويل على مستنداتك الخاصة.
- توفر الأوزان يمكن أن يحدد الاختيار. حتى 24 أكتوبر 2026، أوزان K3 متاحة؛ ومن المقرر إصدار أوزان K3.1 Pro بحلول 4 نوفمبر. على الفرق التي تحتاج استضافة ذاتية فورية مراعاة هذا الفارق.
Kimi K3.1 Pro مقابل Kimi K3: نظرة عامة ومواصفات
يبني Kimi K3.1 Pro على K3 عبر تدريب لاحق إضافي، مع تحسينات مركزة على الترميز، والبحث المالي، وسير عمل العملاء الممتد. يحتفظ كلاهما بسياق يقارب مليون رمز. الفروق الرئيسة هي أداء المهام، وتسعير الرموز، وخيارات التقديم، وتوفر الأوزان.
| المواصفة | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| المطور | Moonshot AI | Moonshot AI |
| تاريخ الإصدار | 24 أكتوبر 2026 | 16 يوليو 2026 |
| البنية | مشتق من K3 (MoE) مع تدريب لاحق إضافي | MoE مع KDA وAttnRes |
| حجم النموذج | فئة 3T و104B معاملات مفعّلة | إجمالي 2.8T و104B معاملات مفعّلة |
| نافذة السياق | حتى 1,048,576 رمزًا | حتى 1,048,576 رمزًا |
| سعر الإدخال/الإخراج القياسي عبر API | 2$ / 10$ لكل مليون رمز | 3$ / 15$ لكل مليون رمز |
| نسخة Highspeed | متاحة | لا توجد نسخة K3 Highspeed منفصلة مُدرجة |
| توفر الأوزان | مخطط للإصدار بحلول 4 نوفمبر 2026 | متاحة بموجب ترخيص Kimi K3 |
يعكس توفر الأوزان المعلومات المتاحة حتى 24 أكتوبر 2026. الأسعار عبر API بالدولار الأمريكي للإدخال والإخراج العاديين، ولا تشمل رسوم كتابة الكاش، الضرائب، والرسوم الأخرى.
البنية والتدريب اللاحق
قدّم K3 بنية تضم 2.8 تريليون معلمة تجمع بين Kimi Delta Attention وAttention Residuals وStable LatentMoE. ويُفعِّل نحو 104 مليارات معلمة لكل رمز.
تصف Moonshot نموذج K3.1 Pro بأنه نسخة مدرّبة لاحقًا من K3 باستخدام حوسبة تدريب لاحق أكبر بكثير. يركّز التحديث على تطبيق قدرات النموذج عبر مهام متعددة الخطوات، بما في ذلك استخدام الأدوات، وتصحيح الأخطاء، والتحقق من النتائج. لا تعلن هذه الإضافة عن بنية أساسية مُسمّاة بشكل منفصل.
القدرات المشتركة ومتطلبات الـ API
يدعم كلا النموذجين مُدخلات متعددة الوسائط، واستدعاء الأدوات، والمخرجات المُهيكلة، والتخزين المؤقت للسياق. تعتمد صيغ الصور والفيديو على مسار الـ API المُختار. يستدلان دائمًا ويدعمان مستويات جهد الاستدلال low وhigh وmax، مع كون max الإعداد الافتراضي.
بالنسبة للمحادثات متعددة الأدوار واستدعاءات الأدوات، يجب أن تحافظ التكاملات على رسائل المساعد كاملة، بما في ذلك محتوى الاستدلال واستدعاءات الأدوات، كما يتطلب الـ API. ينبغي أيضًا التحقق من حدود السياق الفعلية وتوفر الميزات لدى المزوّد، والمنتج، وخطة الاشتراك المختارين.
Kimi K3.1 Pro مقابل Kimi K3: الأداء
تأتي الأدلة من اختبارات Moonshot الداخلية والمقارنات المُعلنة، إلى جانب تقييمات مستقلة من جهات خارجية.
يجب تفسير هذه النتائج بشكل منفصل نظرًا لاختلاف أطر الاختبار ومجموعات الاختبار وإعدادات الاستدلال ومعايير القياس.
تُبلغ تقييمات إطلاق Artificial Analysis عن زيادة بمقدار 11 نقطة في مؤشر الذكاء المركّب، مع تحسينات كبيرة خصوصًا في الترميز عبر الطرفية وسير العمل العُمَلائي.
| مرجع مستقل (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | الفرق |
|---|---|---|---|
| مؤشر الذكاء | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 نقطة مئوية |
| AutomationBench-AA | 58% | 73% | +15 نقطة مئوية |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 نقاط مئوية |
| معدل الهلوسة في AA-Omniscience | 53% | 44% | −9 نقاط مئوية |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 نقاط مئوية |
هذه نتائج تقييمات مستقلة. تُستخدم القيم المدورة حيث يُبلغ المُقيّم عن درجات مدورة. انخفاض معدلات الهلوسة أفضل.
أكبر تحسن يظهر في الترميز عبر الطرفية. يؤدّي K3.1 Pro أداءً أفضل بكثير في المهام التي تتطلب تنفيذ الأوامر، والتفاعل مع البيئة، وتصحيح الأخطاء، والتحقق المتكرر.
يُظهر AutomationBench-AA أيضًا مكسبًا ملحوظًا، ما يشير إلى تنفيذ أقوى في سير عمل البرمجيات كخدمة.
تركز مراجع إصدار Moonshot على الترميز، والعلوم، وإعادة البناء ثلاثي الأبعاد، والتمويل، وأعمال المعرفة، والوكلاء المستقلين.
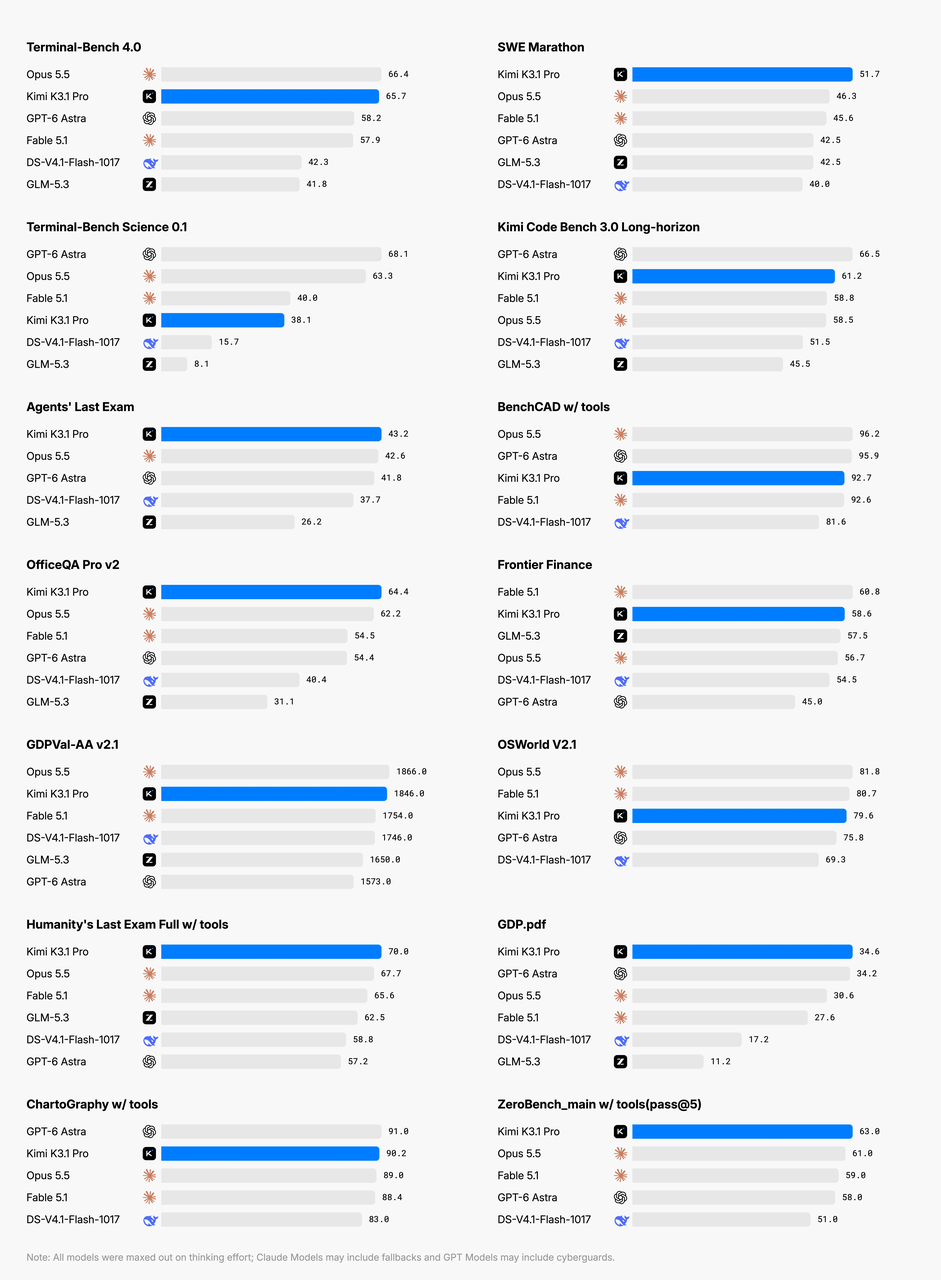
تشمل المقارنات المختارة Claude Opus 5.5 وGPT-6 Astra. قارن كل نتيجة ضمن مرجعها المُسمّى وتكوينها المُعلن.
| مرجع (Moonshot AI) | Kimi K3.1 Pro | النموذج الآخر | درجة نموذج المقارنة |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
يقترب K3.1 Pro أو يتجاوز عدة نماذج مملوكة رائدة في مهام مختارة. لكنه لا يتفوق في كل فئة.
على سبيل المثال، يظل خلف Claude Opus 5.5 في مقارنات BenchCAD وOSWorld المُبلّغ عنها من البائع، وتُظهر المخططات الرسمية ضعفًا أكبر في Terminal-Bench Science.
تختلف إعدادات التقييم: تستخدم Artificial Analysis حزمة mini-swe-agent لـ Terminal-Bench 4.0، بينما تستخدم Moonshot Claude Code. قارن الدرجات ضمن نفس إعداد الاختبار؛ إذ يمكن لأطر التنفيذ وجهد الاستدلال وحدود زمن التشغيل التأثير في النتائج.
الترميز والهندسة البرمجية
بالنسبة للترميز الذاتي المعقد، يُعد K3.1 Pro الخيار الأقوى عمومًا.
ترتفع نتائج Kimi Code Bench 3.0 لمسافات طويلة من 55.95% لـ K3 إلى 61.2% لـ K3.1 Pro، بزيادة تقارب 5.25 نقاط مئوية.
كما تُظهر نتائج Terminal-Bench المستقلة مكسبًا كبيرًا. تقيس هذه الاختبارات التنفيذ متعدد الخطوات: فهم المستودع، وتغيير الملفات، وتشغيل الأوامر، وتشخيص الأخطاء، والتحقق من النتيجة.
يُعد K3.1 Pro مرشحًا أقوى للتطوير متعدد الملفات، والعمل الذاتي عبر الطرفية، وتصحيح الأخطاء الممتد. بالنسبة لتوليد الشيفرة البسيط، قارن النموذجين على مهامك؛ يظل K3 الخيار الفوري عندما تُطلب استضافة ذاتية.
أحد الفوارق المهمة أن درجات مراجع الترميز تعتمد بشدة على إطار الوكيل. تؤثر الأدوات، والمطالبات، وحدود التشغيل، وبيئات الاختبار في النتيجة.
للتطوير البرمجي الإنتاجي، يظل التقييم الأفضل مقارنة متطابقة على مستودعاتك الخاصة.
البحث المالي وعمليات الأعمال
يوفر النمذجة المالية بعضًا من أوضح المقارنات المباشرة بين النموذجين.
اختبرت Moonshot كلاً من K3 وK3.1 Pro على تقييمات داخلية تغطي بناء الجداول الممتدة، وجودة البحث، وعمليات الأعمال المُحاكاة.
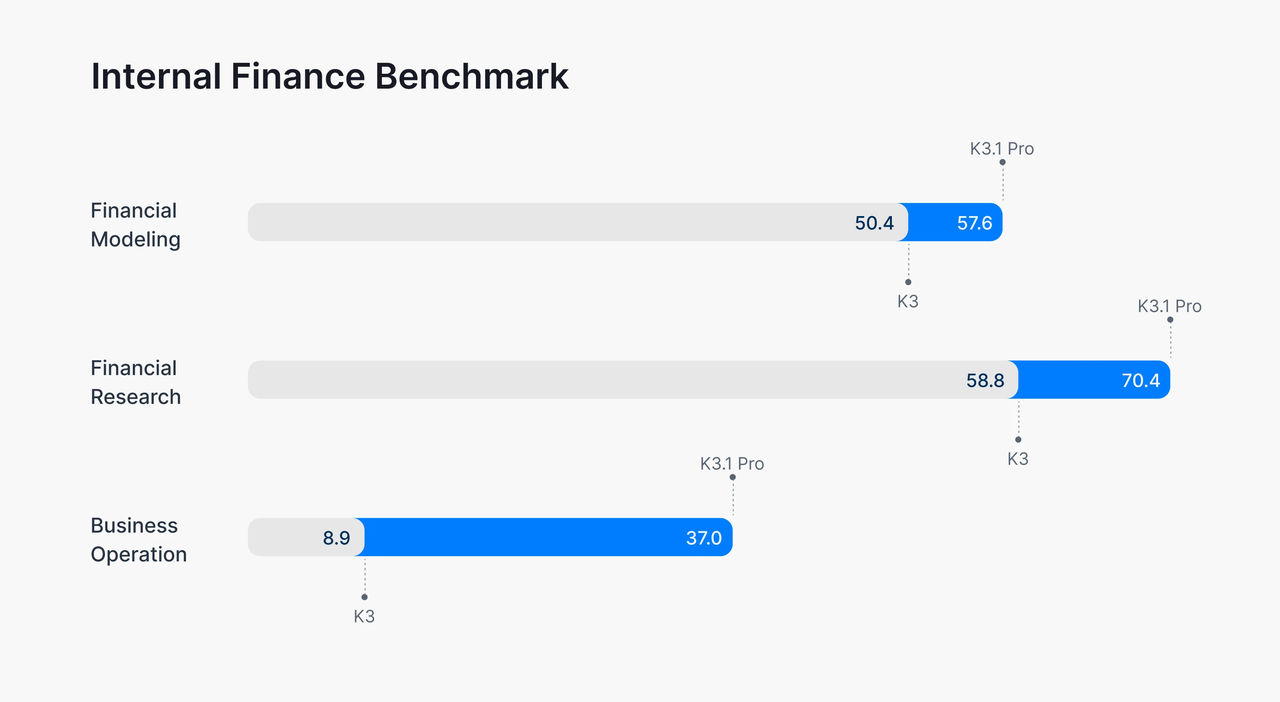
تغطي نتائج التمويل الداخلية لدى Moonshot النمذجة المالية، والبحث، وعمليات الأعمال المُحاكاة. هذه الدرجات المبلغ عنها من البائع ليست مقاييس لعوائد الاستثمار. لا ينبغي افتراض أن إعدادات كل مهمة مماثلة لمراجع غير ذات صلة.
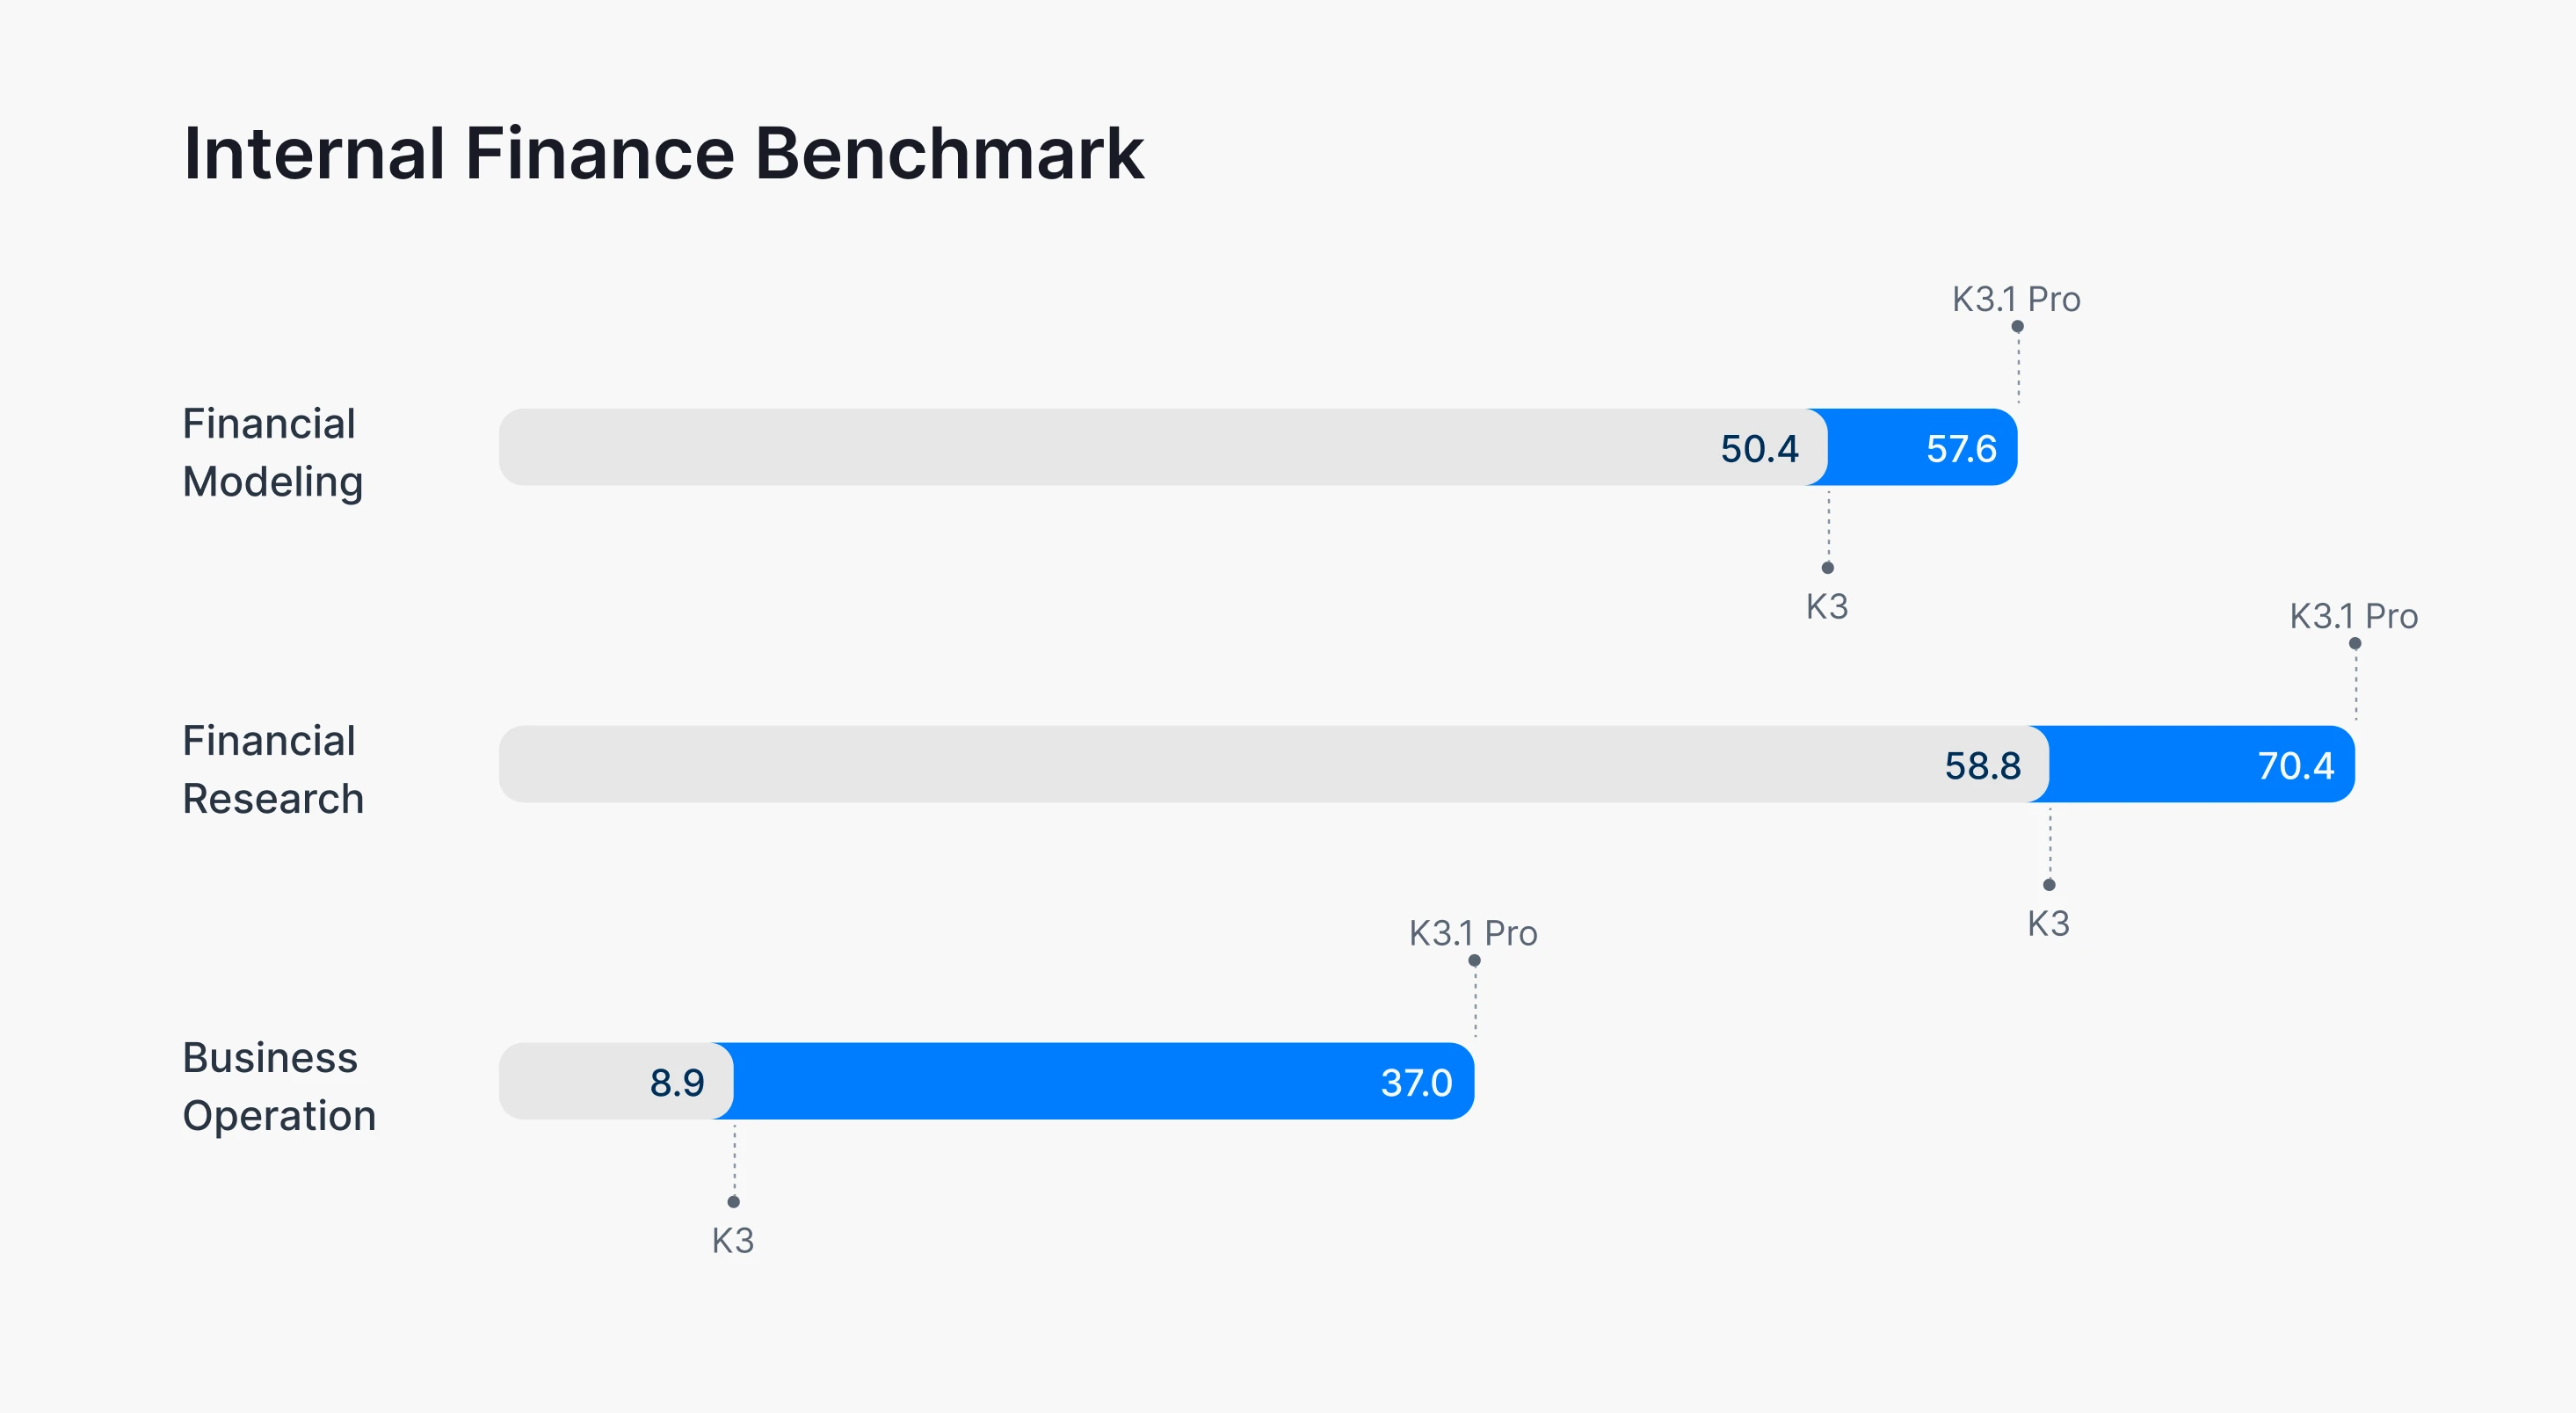
في اختبارات Moonshot الداخلية، ترتفع Financial Modeling من 50.4 إلى 57.6، بزيادة 7.2 نقطة، وترتفع Financial Research من 58.8 إلى 70.4، بزيادة 11.6 نقطة. ترتفع Business Operation من 8.9 إلى 37.0، أي نحو 4.2 مرات درجة K3.
يقيم هذا المرجع الإدارة بعيدة المدى وصنع القرار في بيئة أعمال مُحاكاة. لذا يرتبط أكثر بالتخطيط العُمَلائي مقارنة بالإجابة المالية البسيطة.
تقيس Financial Research القدرة على إنتاج بحث قائم على الأدلة مع احترام متطلبات المصادر وحدود المعلومات. تركز Financial Modeling على العلاقات الرياضية ومنطق الجداول الممتدة وجودة المصنف.
يشير النمط إلى أن K3.1 Pro قيّم بشكل خاص عندما تتطلب المهام المالية استدلالًا مستمرًا، والتحقق، ومخرجات مُنظّمة.
بالنسبة للمستثمرين والمحللين ومستخدمي الأعمال، الفائدة العملية هي احتمال التعامل الأفضل مع سير عمل متعددة المستندات. لا ينبغي استخدام أي من النموذجين كسلطة لا تُمحَّص لاتخاذ قرارات مالية.
الاستدلال طويل السياق والموثوقية الواقعية
مع ذلك، تُظهر نتائج AA-LCR الخاصة بالسياق الطويل تقدّمًا طفيفًا لـ K3. وهو تذكير مفيد بأن نموذجًا أحدث يمكن أن يتحسن كثيرًا إجمالًا دون الفوز بكل مهمة متخصصة.
تُظهر التقييمات المُبلغ عنها أخطاء واقعية أقل على مجموعات الاختبار الخاصة بها.
في Kimi Hallu Bench Hard مع أدوات، تُبلغ Moonshot أن معدل الخطأ على مستوى الادعاء انخفض من 23.4% لـ K3 إلى 8.3% لـ K3.1 Pro.
يمثل ذلك خفضًا نسبيًا بنحو 65% على اختبار إجهاد صعب عمدًا من Moonshot، وليس تقديرًا لمعدلات الخطأ اليومية. على نحو منفصل، تُبلغ Artificial Analysis عن انخفاض في معدل هلوسة AA-Omniscience من 53% إلى 44%. يستخدم التقييمان أساليب مختلفة، لذا لا تكون النسب قابلة للمقارنة مباشرة.
العبرة العملية أن K3.1 Pro يبدو أكثر موثوقية في المهام المُقيمة، لكن التحسينات الواقعية لا تُلغي الحاجة إلى الاسترجاع، والاستشهادات، والتحقق من الحسابات، والمراجعة البشرية في سير العمل ذات العواقب.
تحليل البيانات: أدلة من تقييم Plotly
قيّمت Plotly النسخة القياسية من K3.1 Pro عبر OpenRouter باستخدام اختبار خاص مكون من 43 سؤالًا على مستودع بيانات طاقة رياح صناعي. لم تختبر Highspeed. تُوضح النتائج المقايضة بين جودة الإجابة ووقت الإتمام والتكلفة في سير عمل تحليلي قائم على SQL.
| مقياس تحليلات البيانات لدى Plotly | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| الإجابات الصحيحة | 35/43 | 42/43 |
| الدقة | 81.4% | 97.7% |
| الأنماط الخفية المُكتشفة | 0/5 | 5/5 |
| مشكلات جودة البيانات المُحددة | 1/3 | 3/3 |
| التكلفة الإجمالية للتقييم | 5.01$ | 13.47$ |
| الزمن الوسيط لكل سؤال | 43 ثانية | 2.5 دقيقة |
في هذا التقييم، أجاب K3.1 Pro على عدد أكبر من الأسئلة بشكل صحيح وحدّد مزيدًا من الأنماط الخفية ومشكلات جودة البيانات، لكنه تكبد تكلفة أعلى وزمن إتمام وسيط أطول.
الرسوم المُبلغ عنها هي تكاليف تقييم مُلاحظة، وليست تقديرات محسوبة من أسعار API القياسية لدى Moonshot. ولا يُثبت الإعداد المنشور أن جميع إعدادات المزوّد كانت متطابقة بين تشغيلَي النموذجين، لذا لا يمكن عزو الفروق إلى النموذج وحده.
تدعم هذه النتائج تقييم K3.1 Pro للمهام التحليلية حيث قد تُبرر النتائج الإضافية مزيدًا من الوقت والإنفاق. ولا تُثبت نفس الدقة أو ميزة التكلفة ذاتها.
هل Kimi K3.1 Pro أسرع من Kimi K3؟
ميّز بين معدل إنتاج رموز الإخراج وزمن إنجاز المهمة من الطرف إلى الطرف.
تُبلغ Artificial Analysis عن 73.5 رمز إخراج في الثانية لـ K3.1 Pro، مقارنة بـ 38.5 لـ K3 عند أقصى جهد استدلال، باستخدام API الخاص بـ Kimi. هذه قياسات لتوليد الرموز، تم التحقق منها في 24 أكتوبر 2026؛ كما يعتمد زمن المهمة الإجمالي على طول الاستدلال وتنفيذ الأدوات.
لكن توليد الرموز بسرعة أعلى لا يضمن إتمام المهمة أسرع.
تقدم Moonshot أيضًا K3.1 Pro Highspeed، والمُعلن أنه يوفر إخراجًا أسرع بنحو مرتين إلى ثلاث مرات من النسخة القياسية. هذا تحسن في سرعة التقديم، وليس ترقية ذكاء مؤكدة منفصلة.
يمتلك K3.1 Pro معدل إنتاج أعلى لرموز الإخراج، لكنه لا يُتم المهام بالضرورة بسرعة أكبر. ميّز بين سرعة توليد الرموز والوقت المطلوب للاستدلال، واستدعاء الأدوات، وإنهاء المهمة.
سرعة الإخراج مقابل زمن إتمام المهمة
تُبلغ Artificial Analysis عن سرعات إخراج تبلغ 73.5 رمزًا في الثانية لـ K3.1 Pro و38.5 لـ K3 عند أقصى جهد استدلال، باستخدام API الخاص بـ Kimi. تم التحقق من هذه القياسات في 24 أكتوبر 2026 وتصف معدل توليد الرموز، لا زمن المهمة من الطرف إلى الطرف.
قد يُولّد نموذج الرموز أسرع بينما يستغرق وقتًا أطول إجمالًا إذا أنتج رموز استدلال أكثر أو نفّذ استدعاءات أدوات إضافية. في تقييم Plotly المذكور أعلاه، كان الزمن الوسيط لإتمام K3.1 Pro 2.5 دقيقة لكل سؤال، مقابل 43 ثانية لـ K3، مع دقة أعلى.
للتطبيقات التفاعلية، قِس زمن الوصول إلى أول رمز وزمن إتمام المهمة الإجمالي على مسار المزوّد الفعلي. معدل الإنتاج وحده لا يكفي للتنبؤ بسرعة الاستجابة.
النظر في K3.1 Pro Highspeed
تُعلن Moonshot أن K3.1 Pro Highspeed يوفر سرعة إخراج أكبر بنحو مرتين إلى ثلاث مرات مقارنة بالنسخة القياسية من K3.1 Pro. هذا الادعاء يتعلق بسرعة التقديم؛ ولا ينبغي تفسيره باعتباره خفضًا بمقدار مرتين إلى ثلاث في زمن إتمام المهمة.
انظر في Highspeed للترميز التفاعلي أو المساعدين حيث ينتظر المستخدمون الردود. قارِن زمن النهاية للنهاية، ونجاح المهمة، والتكلفة المفوترة الإجمالية مقابل نقطة النهاية القياسية قبل اختياره. أسعار رموز الإدخال والإخراج العادية أعلى في Highspeed، بينما يظل سعر الإدخال المخزَّن مؤقتًا نفسه.
Kimi K3.1 Pro مقابل Kimi K3: التكلفة
أسعار API الرسمية وCometAPI
تنخفض أسعار الإدخال، والإخراج، وضربات الكاش القياسية لـ K3.1 Pro بمقدار الثلث مقارنة بـ K3. أسعار CometAPI المدرجة أقل بنسبة إضافية تبلغ 20% عن الأسعار الرسمية المقابلة.
| النموذج | الإدخال الرسمي / 1M | الإخراج الرسمي / 1M | الإدخال الرسمي من الكاش / 1M | إدخال CometAPI / 1M | إخراج CometAPI / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | 2.00$ | 10.00$ | 0.20$ | 1.60$ | 8.00$ |
| Kimi K3 | 3.00$ | 15.00$ | 0.30$ | 2.40$ | 12.00$ |
| Kimi K3.1 Pro Highspeed | 4.00$ | 20.00$ | 0.20$ | راجع السعر الحالي | راجع السعر الحالي |
بالدولار الأمريكي لكل مليون رمز؛ تم التحقق من الأسعار في 24 أكتوبر 2026. تُظهر أعمدة الإدخال أسعار الإدخال العادي غير المخزن مؤقتًا. الضرائب والرسوم المفوترة بشكل منفصل مستبعدة.
تسعير Kimi الرسمي (https://www.kimi.ai/resources/kimi-k3-1-pro-pricing) يسرد أيضًا رسوم كتابة الكاش: 2$/4$ لكل مليون رمز لـ Pro القياسي مع احتفاظ لمدة 5 دقائق/1 ساعة، و4$/8$ لنسخة Highspeed. ضربات الكاش، وكتابات الكاش، والإدخال العادي فئات مفوترة منفصلة ومُستبعدة متبادلة.
يُعد المساران الرسمي Kimi وCometAPI مزودَين منفصلين. أكد الأسعار الحالية ودعم الكاش لمسارك المختار، بما في ذلك توفر Highspeed. قارِن تكلفة المهمة المفوترة الإجمالية بالإضافة إلى أسعار الرموز.
مثال تكلفة لعدد رموز ثابت
انظر في عبء عمل يستهلك 100,000 رمز إدخال غير مُخزّن مؤقتًا و20,000 رمز إخراج.
لهذا العبء الثابت، تبلغ تكلفة الـ API الرسمية 0.60$ مع K3 و0.40$ مع K3.1 Pro. وبالأسعار المدرجة لدى CometAPI، تبلغ التكلفة لنفس عدد الرموز 0.48$ و0.32$ على التوالي. تتضمن هذه المجاميع الرموز المُعلنة للإدخال والإخراج فقط.
لكن هذا مقارنة لعدد رموز ثابت. يمكن أن تستهلك سير العمل العُمَلائي المعقدة كميات مختلفة من رموز الاستدلال واستدعاءات الأدوات باختلاف النموذج.
تتبخر وفورات الرموز
لتكن I هو عدد رموز الإدخال غير المخزنة مؤقتًا المتطابقة، وO عدد رموز إخراج Kimi K3 المفوترة، وP عدد رموز إخراج Kimi K3.1 Pro المفوترة، جميعها مقيسة بالملايين. عند الأسعار الرسمية القياسية في جدول التسعير، تكون الرسوم 3I + 15O و2I + 10P بالدولار. تتساوى عندما P = 1.5O + 0.1I.
للطلبات كثيفة الإخراج، يمكن لـ K3.1 Pro استخدام ما يقرب من 50% رموز إخراج مفوترة أكثر قبل فقدان ميزة السعر. يفترض هذا الحساب أسعارًا ثابتة ويستبعد التخزين المؤقت، ورسوم الأدوات، والاستخدامات المفوترة الأخرى بشكل منفصل. استخدم فئات الرموز المفوترة الفعلية بدلًا من طول الإجابة المرئي.
التكلفة لكل مهمة مُنجزة بنجاح
احسب التكلفة لكل مهمة ناجحة باعتبار التكلفة المفوترة الإجمالية لجميع محاولات التقييم مقسومة على عدد المهام الفريدة التي تفي بمعيار قبول مُحدد مسبقًا. ضمّن الرسوم الناشئة عن المحاولات غير الناجحة، والمحاولات المعادة، ومهلات الانقضاء عندما يقوم المزوّد بفوترتها؛ إذ إن قسمة تكلفة التشغيلات الناجحة فقط على عددها قد يُقلّل تقدير التكلفة لكل نجاح.
أبقِ مجموعة المهام، ومعايير القبول، وحدود إعادة المحاولة، وسياسة المهلة ثابتة بين Kimi K3 وK3.1 Pro. أبلغ عن معدل النجاح إلى جانب التكلفة لكل نجاح حتى لا يجعل إسقاط المهام الصعبة النموذجَ يبدو اقتصاديًا بشكل مصطنع. إذا لم تنجح أي مهمة، فالتكلفة لكل نجاح غير معرّفة، وليست صفرًا.
Kimi K3.1 Pro مقابل Kimi K3: المقارنة والاختيار
بالنسبة لمعظم أعباء العمل العُمَلائية المُستضافة، يُعد K3.1 Pro نقطة بدء أقوى. ومع ذلك، ينبغي أن يعكس القرار تعقيد المهمة ومتطلبات النشر.
| حالة الاستخدام | النموذج الموصى به | السبب |
|---|---|---|
| الترميز الذاتي | Kimi K3.1 Pro | قيّم تغييرات متعددة الملفات، والعمل عبر الطرفية، وتصحيح الأخطاء، ونتائج الاختبارات النهائية. |
| البحث المالي متعدد المستندات | Kimi K3.1 Pro | تحسّن في مراجع البحث وعمليات الأعمال |
| التحليل البياني المعقد | Kimi K3.1 Pro | اكتشاف أفضل للمشكلات واختبار جودة البيانات |
| الإنشاء ثلاثي الأبعاد وسير عمل CAD | Kimi K3.1 Pro | قدرات قوية متخصصة بمساعدة الأدوات |
| مهام النص البسيطة | قارن بينهما | قارن مهام النص الروتينية والترميز البسيط على كلا النموذجين؛ فالاستدلال الإضافي قد يزيد الكمون دون تحسين نتيجة مقبولة. |
| دقة الاسترجاع في سياقات طويلة | قارن بينهما | يتقدم K3 قليلًا في AA-LCR |
| الاستضافة الذاتية الفورية | Kimi K3 | الأوزان قابلة للتنزيل بالفعل |
| وكلاء تفاعليون عاليُو القدرات | K3.1 Pro Highspeed | تقديم أسرع، رهين بالتحقق من التكلفة |
| سير عمل إنتاجية حسّاسة للتكلفة | قارن بينهما | انخفاض أسعار الرموز قد لا يعني انخفاض تكلفة المهمة |
الأتمتة المُستضافة وسير العمل المهني
بالنسبة لوكلاء الترميز المُستضافين وسير العمل التحليلي، قيّم K3.1 Pro على الأجزاء الصعبة من الوظيفة الفعلية: تغييرات متعددة الملفات، جمع الأدلة، التحقق من الحسابات، والتعافي بعد فشل استدعاء أداة. فضّل الانخفاضات المقيسة في المهام الفاشلة أو العمل التصحيحي على الدرجة العامة الأعلى وحدها.
بالنسبة لتطبيقات K3 الراسخة، احتفظ بالمسار الحالي كأساس مقارنة. قد تلبّي المهام الروتينية عتبة القبول بالفعل، بينما قد تتصرف مهام السياق الطويل المتخصصة بشكل مختلف عن المراجع الإجمالية. أعطِ الأولوية لشرائح عبء العمل حيث يكون للترقية فائدة قابلة للقياس.
الاستضافة الذاتية وقيود النشر
حتى 24 أكتوبر 2026، أوزان K3 كاملة متاحة للنشر وفقًا لترخيص النموذج ومتطلبات العتاد. لم تُنشر أوزان K3.1 Pro كاملة بعد.
تخطط Moonshot لإصدار أوزان K3.1 Pro بحلول 4 نوفمبر 2026. هذا خطّة إصدار مُعلنة، وليست نقطة تحقق متاحة؛ أكِّد الأوزان المنشورة والشروط المُطبّقة قبل جدولة الاستضافة الذاتية.
معايير التقييم الإنتاجي
قارن K3 وK3.1 Pro على مهام ممثلة باستخدام نفس المطالبات، والأدوات، ومعايير القبول، وحدود إعادة المحاولة، ومهل الانقضاء. سجّل إعدادات المزوّد والاستدلال، واحتفظ برسائل المساعد كاملة كما يتطلب الـ API.
قِس نجاح المهمة، والكمون، واستخدام الرموز، والتكلفة لكل مهمة ناجحة، بما في ذلك الإخفاقات والمحاولات المُعادة المفوترة. راجع الحالات التي ينجح فيها K3 ويفشل K3.1 Pro. للتقييم البشري، أخفِ تسميات النماذج وبدّل ترتيب المخرجات عشوائيًا.
إذا لبّى K3.1 Pro حدود الجودة والكمون والتكلفة لديك، فطرحه تدريجيًا مع K3 كخيار احتياطي مُختبَر.
الهجرة المُتحكّم بها وآليات الرجوع
نهج عملي هو البدء بنسبة صغيرة من حركة الإنتاج على K3.1 Pro.
أبقِ K3 متاحًا كخيار رجوع أثناء التحقق. قارِن جودة المهمة، والكمون، ومعدلات الإخفاق، والإنفاق قبل زيادة استخدام K3.1 Pro.
انتبه بشكل خاص إلى مخططات استدعاء الأدوات، وحقول الرسائل المتعلقة بالاستدلال، والمدخلات متعددة الوسائط، وتحليل المخرجات. توافق الـ API لا يضمن سلوكًا متطابقًا للتطبيق تلقائيًا.
مكاسب المراجع والتراجعات
إذا أجاب كلا النموذجين على الأسئلة الـ 43 نفسها وسجلا 35 و42، فقد يكون K3.1 Pro قد صحّح سبعة إخفاقات لـ K3 دون تراجعات، أو ثمانية إخفاقات مع فقدان إجابة صحيحة سابقة واحدة. الدرجة الإجمالية وحدها لا تميّز بين هذه النتائج.
افحص الإجابات المقترنة وصنّفها: كلاهما صحيح، K3 فقط صحيح، K3.1 Pro فقط صحيح، أو كلاهما غير صحيح. راجع نجاحات K3 فقط مقابل مهامك الأعلى تأثيرًا قبل الهجرة. تصف نتيجة 42/43 مجموعة الاختبار تلك؛ ولا تضمن معدل نجاح 97.7% على عبء عمل مختلف.
التقييم الأعمى لمخرجات النماذج
أخفِ تسميات النموذج وبدّل ترتيب عرض المخرجات للمراجعين عشوائيًا. حدد قواعد القبول قبل المراجعة: بالنسبة للشيفرة، استخدم اختبارات قابلة للتنفيذ وفحوص الانحدار؛ وللبحث، تحقق من دعم المصادر والحسابات واكتمال المُخرَج المطلوب. سجّل الصحة قبل النظر في العرض أو أسلوب الكتابة.
اكشف عن هوية النموذج والكمون والتكلفة المفوترة فقط بعد تسجيل تقييم الجودة. هذا يفصل جودة المخرجات عن التوقعات بشأن النموذج الأحدث. حسم خلافات المراجعين وفق الاختبارات أو المادة المصدر نفسها، واحتفظ بالقرارات حتى يمكن تقييم تغيير نموذج أو مطالبة لاحقًا باتساق.
أين يمكنك الوصول إلى Kimi K3.1 Pro وKimi K3؟
الوصول عبر المزوّد الرسمي
استخدم Kimi K3 API أو Kimi K3.1 Pro API الموثق من Moonshot للتكامل المباشر مع المزوّد. تحقق من مُعرِّف النموذج لمسار النهاية المحدد، وحقول الطلب المدعومة، وحدود الحساب. الوصول العام إلى الـ API وتوفر أوزان النموذج القابلة للتنزيل هما خيارا نشر منفصلان.
الوصول عبر CometAPI
يمكن للمطورين الوصول إلى Kimi K3.1 Pro API وKimi K3 API عبر واجهة CometAPI الموحدة ومقارنة المسارين ضمن عبء التطبيق نفسه.
هذا يجعل ترحيل K3 إلى K3.1 Pro مباشرًا نسبيًا، خاصة للتطبيقات التي تستخدم بالفعل واجهة دردشة متوافقة مع OpenAI.
لاستخدام CometAPI، أنشئ حسابًا ومفتاح API، ثم اضبط تطبيقك مع نقطة النهاية ومُعرّف النموذج وفق وثائق التكامل. اختر kimi-k3 لـ K3، وkimi-k3.1-pro لـ K3.1 Pro القياسي، أو kimi-k3.1-pro-highspeed لمسار Highspeed حيثما كان مدعومًا. ابدأ بطلب صغير، ثم قارِن عبء العمل نفسه عبر النماذج مع التحقق من النتائج المُعادة، والكمون، والاستخدام المفوتر.
الخلاصة
يُعد Kimi K3.1 Pro المرشح الأقوى للترميز الذاتي المتطلب، والبحث المالي، وسير عمل العملاء الممتد وفق التقييمات المدرجة هنا. يظل Kimi K3 ذا صلة للاستضافة الذاتية الفورية ولأعباء العمل التي تلبّي فيها دقته الحالية أو ملف الكمون المتاح المتطلبات بالفعل.
اختر بناءً على مهام ممثلة ومسار المزوّد الفعلي. قارِن النتائج الناجحة، والكمون، والإنفاق الإجمالي، ثم انقل تدريجيًا. أسعار الرموز المنخفضة ودرجات المراجع الأعلى مفيدة كنقطة بداية، لكنها لا تُحدد أفضل ضبط لكل تطبيق.