Step 5 Preview هو نموذج الذكاء الاصطناعي旗舰 من StepFun مخصص لهندسة البرمجيات، والبحث المالي، وسير عمل العوامل المعقدة. يجمع بين أداء مهام تنافسي واستدلال منخفض التكلفة، رغم أن نتائجه تتباين عبر المعايير. يمكن للمطورين الوصول إليه عبر واجهة API مُستضافة أو نشر أوزانه المفتوحة، تبعًا للميزانية والبنية التحتية ومتطلبات الأداء.
النقاط الرئيسية
البنية: يستخدم Step 5 Preview بنية خليط الخبراء المتناثرة (Sparse MoE) بعدد إجمالي 600B من المعلمات و27B فعّالة لكل رمز، بما يوازن بين سعة النموذج وكفاءة الاستدلال.
السياق ودعم الوسائط المتعددة: يدعم النموذج نافذة سياق تصل إلى 1M رمزًا، ومدخلات نصوص وصور وفيديو، وحتى 64K من رموز الإخراج عبر واجهة API المُستضافة.
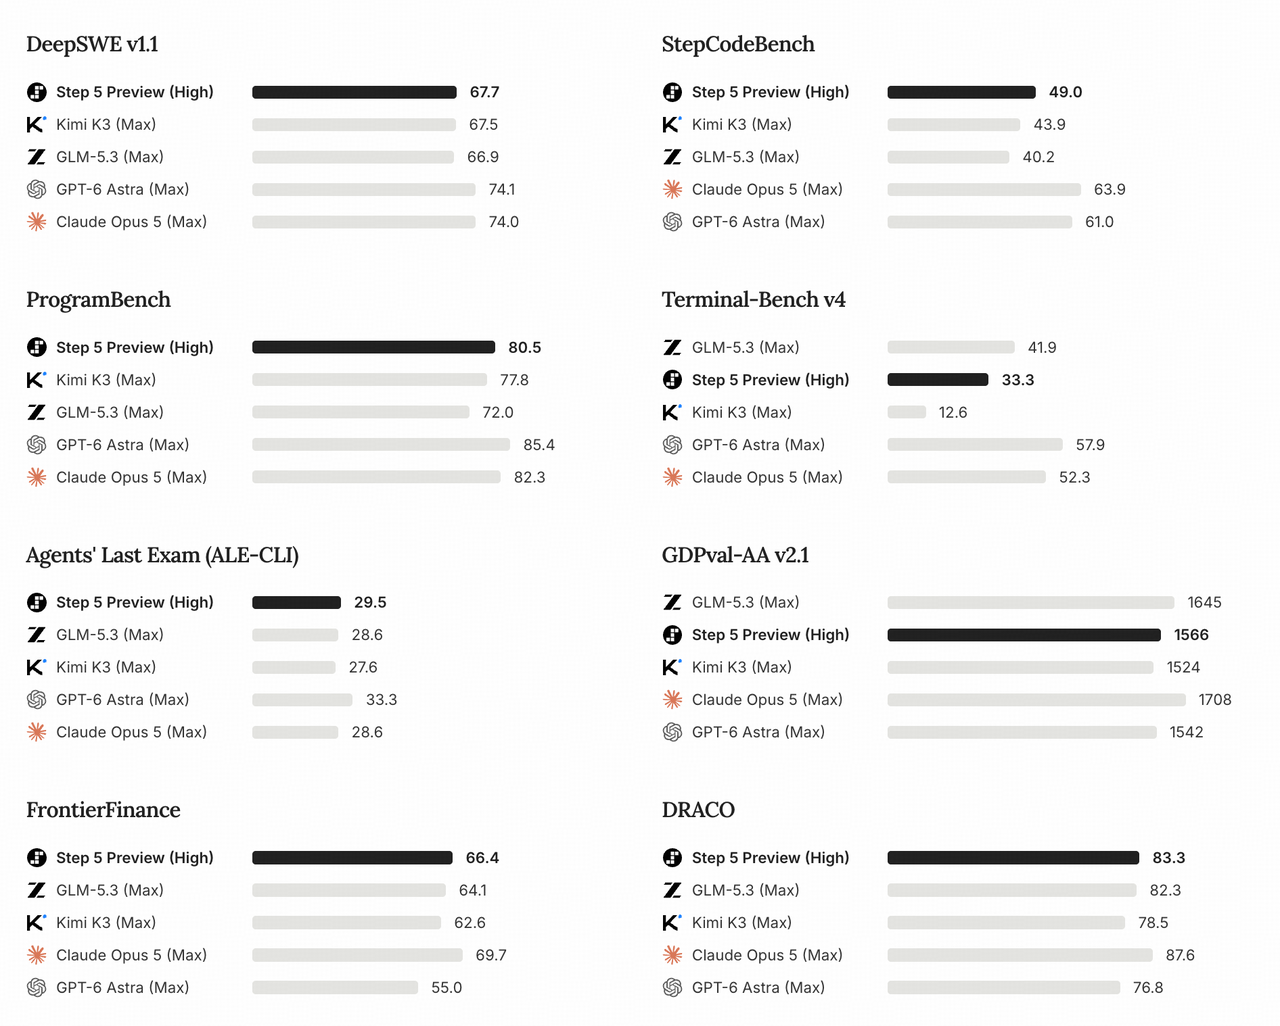
أداء المعايير: يحقق Step 5 Preview نسبة 67.7% على DeepSWE v1.1 و66.4% على FrontierFinance، لكنه يتأخر عن عدة منافسين على Terminal-Bench v4.
تسعير الـ API: تتقاضى StepFun مبلغ $1.00 للمدخلات غير المخبأة، و$0.10 للمدخلات المخبأة، و$2.70 للإخراج لكل مليون رمز.
تمت المراجعة للوضوح ودقة المصدر ومصطلحات API الحالية.
مرونة النشر: يمكن للمطورين الوصول إلى Step 5 Preview عبر واجهة API المُستضافة من StepFun أو استضافة أوزانه المنشورة ذاتيًا باستخدام أطر متوافقة مثل vLLM وSGLang وTransformers.
ما هو Step 5 Preview؟
Step 5 Preview هو نموذج استدلال متعدد الوسائط كبير طوّرته StepFun (阶跃星辰). يستهدف أعباء العمل التي تتطلب استدلالًا ممتدًا، وتنفيذ الأدوات بشكل متكرر، والتحليل عبر مجموعات كبيرة من المعلومات. توفر StepFun وصولًا عبر واجهة API مُستضافة وتنشر أوزان النموذج القابلة للتنزيل.
على عكس المساعدات العامة المحسّنة أساسًا للاستجابات الحوارية، يؤكد Step 5 Preview على التنفيذ الوكيلي: القدرة على التخطيط، واستخدام الأدوات، وفحص النتائج الوسيطة، وتصحيح الأخطاء، والمتابعة نحو هدف معقد.
المواصفات الرئيسية
توثّق بطاقة النموذج الرسمية بنيته المتناثرة، وعدد المعلمات، وتكوينات النشر. تحدد مواصفات واجهة API المُستضافة منفصلة المدخلات المدعومة، وحدود التوليد، وميزات الخدمة. هذه طبقات مختلفة من عقد النشر.
المواصفة (بطاقة النموذج وواجهة API كما في الروابط أعلاه)
Step 5 Preview
المطوّر
StepFun
معرّف النموذج
step-5-preview
فئة النموذج
نموذج استدلال متعدد الوسائط وتنفيذ وكيلي
البنية
Sparse Mixture-of-Experts
إجمالي المعلمات
Approximately 600B
المعلمات الفعّالة لكل رمز
Approximately 27B
نسبة المعلمات الفعّالة
Approximately 4.5%
نافذة السياق
Up to 1M tokens
المدخلات المدعومة
نصوص، صور، وفيديو عبر واجهة API المُستضافة
أقصى إخراج عبر واجهة API
64k tokens
المخرج الأساسي
نص
أوضاع الاستدلال
منخفض، متوسط، مرتفع؛ reasoning_effort على Chat Completions
استدعاء الأدوات
مدعوم
مخرجات منظمة
JSON Mode وJSON Schema على واجهة API المُستضافة
تخزين المطالبات المؤقت
مدعوم
حالة واجهة API المُستضافة
متاحة اعتبارًا من 19 أكتوبر 2026
إتاحة الأوزان
توثّق واجهة API المُستضافة حدًا أقصى لإخراج 64k رمزًا، بينما تسرد بطاقة النموذج قدرة توليد تسلسل تصل إلى 1M رمز. لا يعني الأخير أن نقطة النهاية المُستضافة تقبل إكمالًا بطول 1M رمز. في أمثلة vLLM ذاتية الاستضافة، تغطي ميزانية تسلسل 1M الرموز الإدخال والإخراج معًا؛ يمكن أن تقلّل ذاكرة مخزن KV المتاحة والتزامن من السعة القابلة للاستخدام.
كيف تعمل بنية MoE ذات 600B/27B
يُفعِّل المحوّل الكثيف التقليدي معظم معلماته أثناء الاستدلال. بدلًا من ذلك، يستخدم Step 5 Preview توجيهًا متناثرًا لاختيار الخبراء المناسبين. مع حوالي 27B معلمة فعّالة من أصل 600B، يشارك نحو 4.5% من إجمالي عدد المعلمات في حساب الرمز النموذجي.
يساعد هذا الاختلاف على تفسير استراتيجية كفاءة التكلفة للنموذج. ومع ذلك، فإن 27B فعّالة لا تعني بصمة نشر قدرها 27B. يجب仍 تخزين أوزان جميع الخبراء والوصول إليها، ما يجعل سعة ذاكرة GPU، وتوازي الخبراء، وعرض نطاق الربط البيني اعتبارات أساسية.
المدخلات المدعومة وحدود الإخراج
تقبل واجهة API المُستضافة النصوص والصور والفيديو، مع نافذة سياق تصل إلى 1M رمزًا وبحد أقصى 64k من رموز الإخراج. تدعم هذه المدخلات مهامًا مثل تحليل المستودعات، وبحوث الوثائق المالية، والتفسير البصري. بالنسبة للاستضافة الذاتية، يعتمد طول التسلسل القابل للاستخدام على تكوين وقت التشغيل، والذاكرة المتاحة، والتزامن.
قد تختلف قدرات الوسائط المتعددة وميزات واجهة API بين التكوينات المُستضافة والذاتية.
كيف يؤدي Step 5 Preview على المعايير؟
ما يلي نتائج أبلغت عنها StepFun. يستخدم Step 5 Preview إعداد الاستدلال High؛ بينما تستخدم نماذج المقارنة Max. مطابقة تسميات الإعدادات لا تُثبت تكافؤ الحوسبة، وهذه الدرجات المنشورة لا تقيس الكمون التطبيقي أو تكلفة كل مهمة ناجحة.
يلخص الرسم البياني الرسمي النتائج المنشورة من الناشر. تستخرج الجداول أدناه درجات البرمجة، والاستدلال، والمالية ذات الصلة بهذا التحليل.
أداء البرمجة والتنفيذ الوكيلي
المعيار
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
الدرجات هي نسب مئوية، وكلما ارتفع الرقم كان الأداء أفضل على كل معيار. يستخدم DeepSWE v1.1 حزام SWE-agent مع temperature=1.0 وtop_p=0.95؛ يبلغ StepCodeBench عن avg@4، بينما يبلغ ProgramBench عن pass rate. يقيس كل معيار مهمة مختلفة ضمن إعداد تقييمه الخاص، لذا فالنسب ليست مقاييس دقة قابلة للمقارنة المباشرة. لا تُثبت المقارنة المنشورة تطابق العتاد أو ميزانيات التنفيذ عبر النماذج.
على DeepSWE v1.1، يحرز Step 5 Preview نسبة 67.7%، متجاوزًا بفارق بسيط Kimi K3 وGLM-5.3. يشير ذلك إلى أداء تنافسي لوكلاء البرمجة العاملين مع المستودعات ومهام هندسة البرمجيات الآلية.
يوفر ProgramBench إشارة إيجابية أخرى. يصل Step 5 Preview إلى 80.5%، مقارنةً بـ 77.8% لـ Kimi K3 و72.0% لـ GLM-5.3.
ومع ذلك، يكشف Terminal-Bench v4 عن قيد معنوي: نتيجة Step 5 Preview البالغة 33.3% تتأخر عن GLM-5.3 عند 41.9%، بينما يصل GPT-6 Astra إلى 57.9%. الدلالة أن Step 5 Preview تنافسي في هندسة البرمجيات الموجهة للمستودعات، لكن ميزته النسبية لا تمتد بشكل موحّد إلى التنفيذ عبر الطرفية وإزالة الأخطاء المعقدة.
أداء الاستدلال والمعرفة
المعيار
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
يحرز Step 5 Preview نسبة 93.5% على GPQA Diamond، مساويًا Kimi K3 ومتأخرًا عن GPT-6 Astra عند 96.1%. على AA-LCR v1.1، تأتي نتيجته 88.3% أقل بقليل من Kimi K3 عند 88.7% وأعلى من GPT-6 Astra عند 80.7%. كما يتأخر عن Kimi K3 وGPT-6 Astra على Humanity’s Last Exam وCritPt. تشير النتائج إلى معرفة واستدلال طويل السياق تنافسيين، مع نقاط قوة نسبية تختلف حسب المهمة.
أداء البحث المالي والتقييم
يُعد البحث المالي أحد أبرز مجالات تطبيق Step 5 Preview. صُمم النموذج لدمج الاستدلال الكمي، واسترجاع الأدلة، والتحليل المنظّم. هذه القدرات ذات صلة خاصة بالتقييم، وتفسير الوثائق المالية، وبحوث الاستثمار.
قدمت StepFun معيار FinStepBench لتقييم البحث المالي عبر مراحل متعددة، من جمع المعلومات إلى إنتاج استنتاجات قابلة للدفاع.
المعيار
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
تشير الدرجات الأعلى إلى أداء أفضل على المعيار. بما أن FinStepBench طُوّر بواسطة StepFun، فإن التحقق المستقل مهم بشكل خاص.
يحقق Step 5 Preview نسبة 66.4% على FrontierFinance، متجاوزًا Kimi K3 وGLM-5.3 وGPT-6 Astra تحت الإعدادات المُبلغ عنها. ومع ذلك، يبقى Claude Opus 5 في المقدمة بنسبة 69.7%.
تُعد نتيجة FinStepBench DeepResearch لافتة. يصل Step 5 Preview إلى 55.8%، مقارنةً بـ 48.9% لـ Kimi K3 و53.3% لـ GLM-5.3. يشير ذلك إلى أن النموذج قد يكون مناسبًا جيدًا لسير عمل البحث المالي الذي يتطلب الاسترجاع، والتركيب، والتحليل الممتد.
تحمل نتيجة CorporateValuation قصة أكثر تفصيلًا. عند 60.6%، يتأخر Step 5 Preview عن GPT-6 Astra البالغ 77.3% بفارق كبير. لذلك، لا ينبغي اعتباره متفوقًا عالميًا في التحليل المالي. ترتيبه النسبي أقوى في DeepResearch منه في CorporateValuation، ما يدعم تقييمًا خاصًا بالمهمة بدل ادعاء تفوق مالي واسع.
في تطبيقات الإنتاج، لا تزال المخرجات المالية تتطلب حسابات مُتحققًا منها بشكل مستقل، وافتراضات موثّقة، وأدلة داعمة قابلة للتتبع.
Step 5 Preview مقارنةً بنماذج أخرى
ينافس Step 5 Preview بدائل مُستضافة وخدمات حدودية خاصة. تساعد نتائج المعايير على تحديد النماذج المرشحة؛ كما تحدد واجهة API، ودعم المدخلات، والتحكم في النشر، وكلفة العمل الفعلية النموذج المناسب للتطبيق الإنتاجي.
يوفر Step 5 Preview نقطة تفتيش MoE 600B/27B موثّقة وخيار الاستضافة الذاتية. بالنسبة للبدائل، تختلف إتاحة الأوزان، وعدد المعلمات، وحدود السياق، والمدخلات المقبولة حسب النموذج ونقطة النهاية. يمكن أن تساعد المعايير المنشورة في بناء قائمة مختصرة؛ بينما تكشف مهام البرمجة والبحث التمثيلية كيف يتصرف كل خدمة عمليًا.
Step 5 Preview مقابل Kimi K3
يؤدي Step 5 Preview بشكل أفضل قليلًا على DeepSWE v1.1 وProgramBench وFrontierFinance. يظل Kimi K3 تنافسيًا في الاستدلال وبعض تقييمات تقنية أخرى. الفارق العملي أقل حول ميزة ذكاء حاسمة وأكثر حول التكلفة، وشروط الخدمة، والموثوقية الخاصة بالمهمة المتاحة للمطورين.
Step 5 Preview مقابل GLM-5.3
يتفوق Step 5 Preview على GLM-5.3 في عدة تقييمات مالية وتطوير برمجيات. ومع ذلك، تشير نتيجة GLM-5.3 الأقوى على Terminal-Bench v4 إلى ميزة في المهام المُبلغ عنها الموجهة للطرفية. بالنسبة لوكلاء البرمجة، قارن تعديلات المستودعات الناجحة، وأخطاء استدعاء الأدوات، ووقت التنفيذ، وصحة التصحيحات بدل الاعتماد على درجة إجمالية واحدة.
Step 5 Preview مقابل GPT-6 Astra وClaude Opus 5
تؤدي النماذج الحدودية الخاصة عمومًا بشكل أفضل على أصعب معايير هندسة البرمجيات. الجاذبية الأساسية لـ Step 5 Preview أنه يقترب من قدرة تنافسية في أعباء عمل محددة بينما يوفر خيار أوزان مفتوحة للنشر وتسعير واجهة API أكثر إتاحة.
اختر نموذجًا متميزًا عندما تكون تكلفة الفشل عالية ويبرر دقة المهمة الإضافية المصروفات. ضع Step 5 Preview في الاعتبار عندما تكون السعر، والتحكم في النشر، والتنفيذ المتكرر للوكلاء أكثر أهمية.
كم تبلغ تكلفة واجهة Step 5 Preview؟
تعتمد قيمة Step 5 Preview على قدرة المهمة وتكلفة التشغيل. قد تتضمن سير عمل العوامل عشرات الاستدعاءات، واسترجاعًا متكررًا للوثائق، ومحاولات متكررة، لذا فإن انخفاض سعر الرموز يساعد فقط عندما يكمل النموذج المهمة بشكل موثوق. تكلفة كل مهمة مكتملة بنجاح مقياس مفيد مكمّل للأسعار أدناه.
توفر الـ API وتسعير الرموز
تقارن لقطة 19 أكتوبر 2026 أسعار واجهة StepFun الأصلية بمعدلات CometAPI المرتبطة في قسم مقارنة النماذج. جميع الأسعار بالدولار الأمريكي لكل مليون رمز. لدى الخدمات شروط فوترة، وتخزين مؤقت، ونقاط نهاية مختلفة؛ "غير مُدرجة" تعني أن مصدر هذه المقالة لا يوفر معدلًا للمدخلات المُخبأة.
النموذج
قناة الخدمة
معرّف النموذج
مدخلات غير مخبأة / 1M رمز
مدخلات مخبأة / 1M رمز
إخراج / 1M رمز
Step 5 Preview
StepFun native API
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Not listed
$12.00
GLM-5.3
CometAPI
glm-5.3
$1.12
Not listed
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (short-context tier)
Not listed
$40.00 (short-context tier)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Not listed
$20.00
تنطبق طبقة السياق القصير لـ GPT-6 Astra حتى 272,000 رمز؛ المعدلات المذكورة للسياق الطويل هي $16 للإدخال و$60 للإخراج لكل مليون رمز. تستثني الأسعار المدرجة الأدوات، والمحاولات، والبنية التحتية. لا تثبت هذه المقارنة إتاحة Step 5 Preview عبر CometAPI؛ يستخدم المثال أدناه نقطة نهاية StepFun الأصلية.
سعر الإدخال عند ضربة التخزين المؤقت أقل بنسبة 90% من السعر غير المخبأ. يتضمن سعر المدخلات غير المخبأة كتابة محتوى جديد إلى التخزين المؤقت، بينما يشمل احتساب الإخراج كلًا من رموز الاستدلال والإجابة النهائية. لا يحصل النص المُكرر على السعر المنخفض إلا عندما تبلغ الخدمة عن ضربة تخزين مؤقت مؤهلة؛ طول الإجابة المرئي وحده يقلّل من احتساب الإخراج.
أمثلة حساب التكلفة
عبء عمل API
مدخلات غير مخبأة
مدخلات مخبأة
إخراج
التكلفة التقديرية
طلب تحليلي قصير
10K
0
5K
$0.0235
سير عمل برمجي متوسط
100K
0
20K
$0.154
طلب وكيل متكرر
10K
90K
20K
$0.073
تحليل وثيقة كبيرة
500K
0
30K
$0.581
سير عمل سياق طويل مخبّأ
100K
400K
50K
$0.275
صيغة التكلفة: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000، حيث تمثل Tu/Tc/To رموز الإدخال غير المخبأة، والإدخال المخبأ، والإخراج القابل للاحتساب، على التوالي، وPu/Pc/Po هي أسعارها لكل مليون رمز.
اعتبر طلبين من StepFun لهما نفس 100,000 رمز إدخال و20,000 رمز إخراج قابل للاحتساب:
ضربة تخزين مؤقت مفقودة: جميع 100,000 من رموز الإدخال غير مخبأة. التكلفة = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154.
يوفر مثال ضربة التخزين المؤقت توفيرًا قدره $0.081، أي حوالي 52.6%، مع نفس أحجام الإدخال والإخراج. يعتمد التوفير على ضربة تخزين مؤقت مؤهلة تُبلغ عنها الخدمة. كلا المثالين يستثنيان الأدوات الخارجية، والمحاولات، وتكاليف البنية التحتية.
لا تحدد أسعار الرموز وحدها النموذج الأفضل قيمة. قد يكون الوكيل الذي يتطلب عدة محاولات أغلى من نموذج أعلى سعرًا ينجح من المحاولة الأولى. للحصول على مقارنة تكلفة موثوقة، استخدم تكلفة كل مهمة مكتملة بنجاح جنبًا إلى جنب مع تسعير الرموز.
هل Step 5 Preview مفتوح المصدر، وهل يمكن تشغيله محليًا؟
تنشر StepFun الأوزان القابلة للتنزيل عبر مستودعاتها الرسمية على Hugging Face، مع متغيرات FP8 وBF16 وNVFP4 متاحة اعتبارًا من 19 أكتوبر 2026. يتيح الوصول إلى الأوزان النشر الذاتي، لكنه لا يجعل النموذج مكافئًا لنموذج كثيف صغير من حيث متطلبات الذاكرة.
تتضمن الملفات المتاحة نقطة تفتيش Step 5 Preview، وإصدار BF16، وإصدار NVFP4.
المصطلحات مهمة: يوفر Step 5 Preview أوزانًا مفتوحة تحت StepFun Model License 1.0. يتضمن الترخيص نسبًا خاصة بالنموذج وشروط ترخيص تجاري. قيّم هذه الشروط لخطتك للاستخدام والتوزيع قبل النشر.
FP8 مع vLLM: أربع × NVIDIA B300 أو ثمان × NVIDIA H200، تخدم واجهة API متوافقة مع OpenAI.
BF16 مع vLLM: ثمان × NVIDIA B300 أو ست عشرة × NVIDIA H200، تخدم واجهة API متوافقة مع OpenAI.
FP8 مع SGLang: أربع × NVIDIA B300، تخدم واجهة API متوافقة مع OpenAI؛ FP8 مع Transformers: ثمان × NVIDIA H200 للتوليد دون اتصال.
هذه تكوينات مرجعية، وليست ضمانات دنيا لكل نقطة تفتيش، أو وقت تشغيل، أو طول سياق، أو إعداد تزامن. يقلّل التفعيل المتناثر من الحوسبة، لكن تخزين أوزان الخبراء وذاكرة مخزن KV يظلان اعتبارات رئيسية.
يقدّم نموذج 600B تحديات تتجاوز سعة الذاكرة، بما في ذلك الاتصال متعدد وحدات GPU، وتوافق الأطر، وتحميل نقاط التفتيش، وإنتاجية السياق الطويل. بالنسبة للفرق التي لا تمتلك عناقيد GPU كبيرة، تعد واجهة API المُستضافة عادةً نقطة بدء أكثر عملية.
كيف يمكن للمطورين استخدام واجهة Step 5 Preview؟
تدعم StepFun واجهة Chat Completions المتوافقة مع OpenAI. اضبط المتغير البيئي STEPFUN_API_KEY قبل تشغيل مثال Python التالي؛ يحدد max_tokens حد إخراج الطلب المُولّد. استخدم مفتاح الـ API وشروط الفوترة للنظام الإقليمي المختار: يحتفظ هذا المثال بنقطة النهاية api.stepfun.ai، بينما تأتي الأسعار بالدولار أعلاه من منصة StepFun الدولية.
مثال Python: إرسال طلب نصي محدود إلى واجهة StepFun وطباعة الإجابة المُعادة.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "حلّل مخاطر البنية عند ترحيل تطبيق أحادي الكتلة إلى خدمات مصغّرة."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
قبل الاستخدام الإنتاجي، أكّد المعلمات المقبولة وحدود التوليد لنقطة نهاية StepFun المختارة. يمكن أن يؤثر جهد الاستدلال، وتخزين المطالبات المؤقت، ومخططات الأدوات، وميزانيات الإخراج جميعًا في الموثوقية، والكمون، والفاتورة النهائية.
Step 5 Preview في سير عمل الوكلاء
قراءة وثائق المستودع والملفات ذات الصلة.
تحديد التغيير المطلوب واقتراح خطة.
تعديل الشيفرة المحددة وتنفيذ الاختبارات عبر أدوات خارجية.
فحص الإخفاقات ومراجعة التنفيذ.
إنتاج شرح نهائي للتغييرات المُتحقق منها.
يولّد النموذج الاستدلال وطلبات الأدوات؛ ويوفر التطبيق الوصول الفعلي للملفات، وبيئات التنفيذ، والأذونات، وفحوص السلامة. قدرة النموذج وحدها لا تضمن تنفيذًا ذاتيًا.
واجهات نماذج بديلة في CometAPI
توفر CometAPI الوصول إلى النماذج البديلة المرتبطة أعلاه عبر خدمة تكامل مشتركة. اختر نقطة النهاية الموثّقة لكل نموذج وتنسيق الطلب، ثم قارن معدلات النجاح، واستخدام الرموز، والمحاولات، والكمون من طرف إلى طرف على نفس عبء العمل.
يستخدم المثال أعلاه نقطة نهاية StepFun الأصلية. يتطلب التحويل إلى بوابة وسيطة التأكد من إتاحة Step 5 Preview ومعرّف النموذج، ونقطة النهاية، وشروط الفوترة الموثّقة للبوابة.
متى ينبغي اختيار Step 5 Preview؟
اختره للبرمجة على المستودعات والبحث القائم على الوثائق عندما تؤكد الاختبارات التمثيلية نتائج موثوقة. يجعله سياقه الطويل ودرجات البرمجة والمالية المنشورة مرشحًا، بينما تُظهر نتائج Terminal-Bench v4 وCorporateValuation سبب أهمية الاختبارات الخاصة بأعباء العمل.
اختر واجهة API المُستضافة عندما تريد البدء دون تشغيل عنقود GPU كبير. قارن تكلفة كل مهمة مقبولة، ومعدلات ضربة التخزين المؤقت، والمحاولات، والكمون؛ نافذة سياق كبيرة لا تضمن استجابات سريعة أو تكلفة كلية أقل.
اختر الاستضافة الذاتية عندما يبرر التحكم في النشر عبء العتاد والعمليات. خصّص ميزانية لتخزين أوزان الخبراء كاملة، ومخزن KV، والاتصال متعدد وحدات GPU، ومتطلبات الترخيص. لأعمال مالية أو هندسية مؤثرة، أشمل فحوص المصدر، وكشف الأخطاء، والمراجعة البشرية.
الأسئلة الشائعة
كيف تختار جهد الاستدلال في Step 5 Preview؟
ابدأ بمجموعة صغيرة من المهام التمثيلية وقارن منخفض، متوسط، مرتفع باستخدام نفس معايير القبول. سجّل الصحة، والإخراج القابل للاحتساب، والكمون، وإخفاقات الأدوات. استخدم أدنى إعداد يلبي عتبة الجودة باستمرار؛ لا تتنبأ درجات High المنشورة بسلوك إعدادات منخفض أو متوسط. اتبع دليل تهيئة الاستدلال واضبط reasoning_effort صراحةً على Chat Completions عند مقارنة التكوينات.
لماذا قد يتوقف طلب Step 5 Preview قبل 64k من رموز الإخراج؟
الحد الأقصى الموثّق سقف، وليس طولًا مستهدفًا. قد يتوقف الطلب مبكرًا لأنه بلغ ميزانية max_tokens الخاصة به، أو عاد إلى توقف طبيعي، أو أنتج استدعاء أداة يجب على التطبيق التعامل معه. افحص سبب الإنهاء المُعاد وأي طلبات أدوات قبل إعادة المحاولة تلقائيًا. لا تشير إجابة أقصر مكتملة إلى فشل نافذة السياق.
كيف تختبر مدخلات الفيديو في Step 5 Preview؟
ابدأ بمقطع قصير تمثيلي وسؤال يمكنك التحقق من إجابته. تقبل مواصفة واجهة API المُستضافة لمدخلات الفيديو فيديو عبر URL أو Base64 أو مرجع stepfile؛ وتشمل التنسيقات الموثّقة MP4 وQuickTime وMatroska. لمدخلات URL، تحدد الوثائق ملفات MP4 فردية أقل من 128 MB وتوصي بأقل من خمس دقائق. أكّد حدود التنسيق والحجم قبل الدُفعات، واختبر أسئلة زمنية بالإضافة إلى التعرف على الإطارات الفردية.
أي المقاييس تكشف التكلفة الحقيقية لوكيل Step 5 Preview؟
قِس المهام المقبولة، وإجمالي رموز الإدخال والإخراج عبر جميع الأدوار، وضربات التخزين المؤقت، والمحاولات، ورسوم الأدوات الخارجية، والوقت المنقضي. اقسم إجمالي تكلفة التشغيل على المهام المكتملة بنجاح، مع الإبقاء على معيار النجاح ثابتًا عبر النماذج. يلتقط هذا الأثر الاقتصادي لاستدعاء أرخص يتطلب محاولات أكثر، أو تشغيل أعلى جهد يقلّل الإخفاقات لاحقًا.
الخلاصة
يستحق Step 5 Preview التقييم عندما يحتاج التطبيق إلى معالجة سياق طويل، واستخدام أدوات متكرر، أو التحكم في نشر النموذج. تجعل النتائج المنشورة من StepFun منه مرشحًا للبرمجة على المستودعات والبحث المالي، بينما تُظهر Terminal-Bench v4 وCorporateValuation مجالات تتفوق فيها البدائل المدرجة. قارن النماذج باستخدام معايير قبول ثابتة، وتكلفة كل مهمة مقبولة، والكمون من طرف إلى طرف. للنشر الذاتي، أشمل تكاليف البنية التحتية ومتطلبات الترخيص في القرار.