
Svar først. Claude Opus 6 er ikke officielt annonceret eller udgivet. Der findes i øjeblikket intet bekræftet model-ID, ingen lanceringsdato, intet API-endpoint, ingen pris, intet kontekstvindue og ingen benchmark-score for Claude Opus 6. Udviklere bør betragte claude-opus-6 som en ubekræftet pladsholder og ikke som en produktionsklar model. Indtil Anthropic annoncerer en efterfølger, er Claude Opus 5 det passende udgangspunkt for at evaluere den næste Opus-generation.
Hvad er Claude Opus 6?
Claude Opus 6 bør forstås som en markedsbetegnelse for et muligt fremtidigt medlem af Anthropics Opus-familie, ikke som et bekræftet produkt. Den officielle Claude-modelkatalog oplister Claude Opus 5 som den aktuelle Opus-model og anbefaler den til kompleks agentisk kodning og enterprise-arbejde. Der findes i øjeblikket ingen officiel side, der dokumenterer et produkt med navnet Claude Opus 6.
Denne skelnen er vigtig, fordi Opus-navnet beskriver et produkttier i stedet for en offentlig arkitekturplan. Anthropic oplyser ikke parameterantal for sine proprietære Claude-modeller, og en ny generation indebærer ikke automatisk et større kontekstvindue, lavere pris eller en specifik benchmark-forbedring. Den mest forsvarlige måde at diskutere Opus 6 på er at adskille den bekræftede Claude Opus 5 baseline fra rimelige slutninger om produktretning og fra detaljer, der fortsat er helt ukendte.
Har Anthropic annonceret Claude Opus 6?
Nej. Anthropic har ikke offentliggjort en annoncering, et API-model-ID, et systemkort, en pristabel eller en tilgængelighedsside for Claude Opus 6. Den nuværende officielle dokumentation oplister Claude Opus 5, Claude Sonnet 5, Claude Fable 5 og Claude Haiku 4.5 blandt de senest beskrevne modeller. Et fravær af annoncering kan ikke bevise, hvad Anthropic vil kalde sin næste model, så præcise påstande om Opus 6 bør behandles som udokumenterede.
Et ansvarligt forhåndsoverblik kan stadig være nyttigt. Opus 5-udgivelsen viser, hvad Anthropic værdsætter i øjeblikket: lang-horisont-agentik, omhyggelig verifikation, indsatsops skalering ved testtid, professionel outputkvalitet, computerbrug og omkostning per succesfuld opgave. Disse prioriteter er et stærkere grundlag for analyse end sociale medie-rygter eller opdigtede specifikationsark.
Claude Opus 6 udgivelsesdato
Anthropic har ikke angivet en udgivelsesdato eller lanceringsvindue for Claude Opus 6. Tidspunktet for tidligere Opus-udgivelser er ikke en pålidelig plan, da modelnavne, udgivelsesfrekvens og platformudrulning kan ændre sig. Datoen bør forblive ubekræftet, indtil Anthropic offentliggør en annoncering eller opdaterer det officielle modelkatalog.
Forventede specifikationer for Claude Opus 6
Den sikreste specifikationstabel starter med det, der er kendt om Opus 5, og lader Opus 6-felter stå som ukendte. Udtryk som sandsynlig eller forventet angiver slutninger, ikke bekræftelser.
| Specifikation | Claude Opus 5 bekræftet baseline | Claude Opus 6 status |
|---|---|---|
| Udgivelsesstatus | Tilgængelig | Ikke officielt annonceret |
| Officielt model-ID | claude-opus-5 | Ikke tilgængeligt |
| Input-modaliteter | Tekst og billeder | Ukendt |
| Output-modalitet | Tekst | Ukendt |
| Kontekstvindue | 1 million tokens | Ukendt |
| Maks. synkront output | 128K tokens | Ukendt |
| Adaptiv tænkning | Aktiveret som standard | Sandsynligvis fortsætter, ubekræftet |
| Indsatskontroller | Low, medium, high, xhigh, max | Ukendt |
| Officiel listepris | $5/M input; $25/M output | Ukendt |
| Fast mode | Cirka 2,5x hastighed til 2x pris | Ukendt |
| Parameterantal | Ikke oplyst | Ukendt |
Kilde: Anthropic model overview og Opus 5-dokumentation. Opus 6-værdier er bevidst ikke opdigtet.
Bekræftede beviser, rimelige forventninger og ukendte forhold for Claude Opus 6. Forventninger er slutninger fra den offentliggjorte Opus 5-udviklingsretning.
Disse Opus 5-resultater giver en referencebaseline for at evaluere en fremtidig Opus-generation. En meningsfuld efterfølger bør vurderes ikke kun på benchmark-forbedringer, men også på pålidelighed, latenstid, værktøjseffektivitet og omkostning per succesfuld opgave.
Hvilke funktioner kunne Claude Opus 6 introducere?
Mere pålidelige lang-horisont-agenter
Opus 5 er designet til arbejde, der udfolder sig over mange trin, værktøjer og verifikationscyklusser. En fremtidig Opus-model ville være mest værdifuld, hvis den kan bevare mål længere, komme sig efter mislykkede værktøjsopkald, undgå at gentage fuldført arbejde og vide, hvornår et resultat er klar til at blive afleveret. Den meningsfulde metric er ikke, hvor længe modellen kan fortsætte med at generere; det er, hvor ofte agenten når et korrekt, anvendeligt resultat med begrænset menneskelig indgriben.
Stærkere agentisk kodning
Den tydeligste Opus-udviklingsretning er software engineering i repositorieskala. Den næste generation kunne forbedre navigering i kodebaser, refaktorering på tværs af filer, root cause-fejlfinding, testkørsel, browserbaseret verifikation og evnen til at revidere en implementering efter at have observeret reelle fejl. Den skal også reducere unødvendige ændringer og producere renere diffs, fordi pålidelighed betyder mere end kodevolumen i produktionsarbejdsgange.
Bedre indsatsops skalering
Claude Opus 5 understøtter allerede low, medium, high, xhigh og max indsats. Anthropic siger, at modellen konverterer yderligere indsats til bedre resultater mere pålideligt end tidligere Opus-modeller. Opus 6 kunne gøre kurven mere effektiv: stærkere svar ved lav indsats til rutinearbejde, mere pålidelige gevinster i topenden og bedre automatisk allokering af ræsonneringstokens til vanskelige delproblemer.
Stærkere professionelt og videnskabeligt arbejde
Opus 5 rapporterer fremskridt inden for finansiel analyse, juridisk gennemgang, enterprise-automatisering, videnskabelig ræsonnering og polerede artefakter. En fremtidig Opus-udgivelse kunne udbygge disse styrker ved oftere at tjekke beregninger, afstemme modstridende beviser, håndtere større strukturerede filer og generere mere redigerbare præsentationer, regneark, rapporter og visuelle forklaringer.
Sikkerhed, der skalerer med kapabilitet
En mere autonom model øger også omkostningen ved en forkert handling. Opus 6 ville have brug for stærkere værn ved værktøjsbrug med høj påvirkning, klarere bekræftelsesgrænser, bedre modstand mod prompt injection og mere pålidelig eskalering, når beviserne er utilstrækkelige. Målet bør være nyttig defensiv og videnskabelig assistance uden at omsætte generelle ræsonneringsgevinster til ukontrolleret højriskoeksekvering.
Claude Opus 5 benchmark-baseline
Der findes ingen autentiske benchmark-scorer for Claude Opus 6. Tallene nedenfor er offentlige resultater for Opus 5, som en fremtidig Opus-generation skal matche eller overgå. De dækker kodning, abstrakt ræsonnering, forretningsautomatisering, videnskabeligt arbejde, computerbrug og alignment i stedet for at basere sig på én samlet rangliste.
| Område | Evaluering | Claude Opus 5 offentlig baseline | Hvad den måler |
|---|---|---|---|
| Agentisk kodning | Frontier-Bench v0.1 | >2x Opus 4.8 til lavere omkostning per opgave | Ende-til-ende softwarearbejde |
| Kodningsværdi | CursorBench 3.2 | Inden for 0,5% af Fable 5 peak til cirka halv pris | Kvalitet pr. opgaveomkostning |
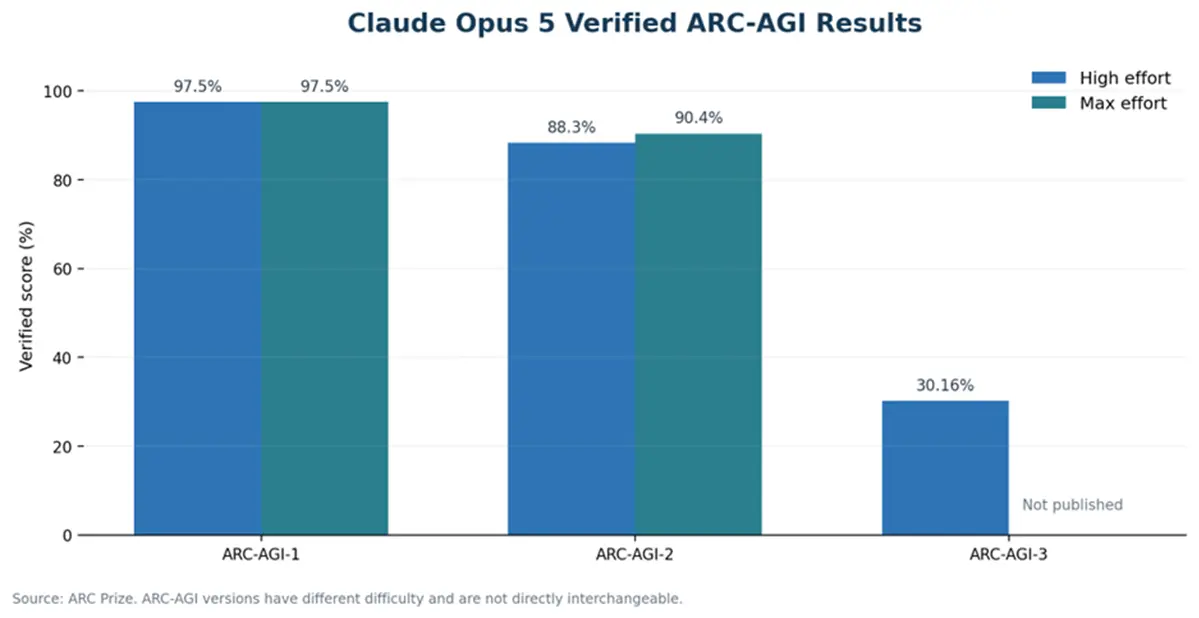
| Ny ræsonnering | ARC-AGI-3 Public Demo | 30.16% ved High indsats | Tilpasning til ukendte regler |
| Abstrakt ræsonnering | ARC-AGI-2 Semi-Private | 90.4% ved Max indsats | Hård generalisering |
| Automatisering | AutomationBench | Cirka 1,5x den næstbedste pass-rate til sammenlignelig pris | Fuldførelse af forretningsopgaver |
| Computerbrug | OSWorld 2.0 | Over Fable 5’s bedste resultat til lidt over en tredjedel af prisen | GUI- og applikationskontrol |
| Videnskab | Organisk kemi intern eval | +10,2 procentpoint vs Opus 4.8 | Molekylær strukturinferens |
| Videnskab | Protein-funktion intern eval | +7,7 procentpoint vs Opus 4.8 | Sekvens-til-funktion-ræsonnering |
| Alignment | Automatisk adfærdsaudit | 2.3 samlet score for misaligned adfærd | Lavere skadelig eller vildledende adfærd |
Kilder: Anthropics lanceringsnoter for evaluering og ARC Prize verificerede resultater. Interne og tredjepartsevalueringer kan bruge forskellige rammer.
Claude Opus 5 verificerede ARC-AGI-resultater ved High og Max indsats. Kilde: ARC Prize. Benchmark-versionerne har forskellig sværhedsgrad og bør ikke betragtes som én kontinuerlig skala.
ARC-resultaterne viser også, hvorfor et Opus 6-forhåndsoverblik bør undgå opdigtede procenter. Opus 5 når 97.5% på ARC-AGI-1 og 90.4% på ARC-AGI-2 Semi-Private ved Max indsats, mens det væsentligt sværere ARC-AGI-3 Public Demo forbliver på 30.16% ved High indsats. En troværdig påstand om næste generation ville kræve både bedre scorer og gennemsigtige evalueringsbetingelser.
Claude Opus 6 vs aktuelle frontier-modeller
Opus 6 er ikke annonceret; sammenligningen nedenfor vurderer mulig positionering frem for at udnævne en vinder. Den bruger Opus 5 som baseline i samme familie, GPT-5.6 Sol som en flagskibskonkurrent for kodning og computerbrug, og Gemini 3.7 Flash som en billigere multimodal agentmodel med stærk kodningsydelse.
| Metric | Claude Opus 6 | Claude Opus 5 | GPT-5.6 Sol | Gemini 3.7 Flash |
|---|---|---|---|---|
| Status | Ubekræftet | Tilgængelig | Tilgængelig | Tilgængelig |
| Rolle | Mulig næste Opus-generation | Omhyggelig agentik og enterprise-arbejde | Frontier-ræsonnering og multi-agent-eksekvering | Effektiv multimodal arbejdshest |
| Kontekst | Ukendt | 1M tokens | 1M-klasse arbejdsgange | 1,048,576 tokens |
| Input | Ukendt | Tekst, billede | Tekst, billede | Tekst, billede, video, lyd, PDF |
| Tænkning | Ukendt | Fem indsatsniveauer | Effort, max og multi-agent ultra | Low, medium, high tænkning |
| Kodningsfokus | Forventes at forbedre | Lang-horisont kodning og verifikation | Kodning, terminal, computerbrug | Kodning og lang-horisont-agenter til Flash-økonomi |
| Officiel pris | Ukendt | $5/M input; $25/M output | $5/M input; $30/M output | $0.75/M input; $3.75/M output (introduktion) |
| Styrke | Kan ikke bedømmes | Dømmekraft og omhyggelig eksekvering | Bredde, effektivitet, parallelle agenter | Hastighed, multimodal bredde og lav enhedsomkostning |
Kilder: udbydernes dokumentation for GPT-5.6 og Gemini 3.7 Flash. Opus 6-celler forbliver ubekræftede.
Sammenligningsresultat
Der kan ikke udnævnes en samlet vinder, mens Opus 6 er uannonceret. Sammenligningen viser i stedet tre optimeringsmål: omhyggelig eksekvering fra Opus 5, bred kodning og effektivitet i parallelle agenter fra GPT-5.6 Sol samt stærk kodning plus multimodal bredde til Flash-økonomi fra Gemini 3.7 Flash. En fremtidig Opus-model skal forbedre pålideligheden af accepterede opgaver uden at miste latenstid eller omkostninger.
Hvad vil Claude Opus 6 koste?
Der er ikke annonceret nogen pris for Opus 6. Anthropics offentliggjorte priser fastsætter standard-API’en for Claude Opus 5 til $5 per million input-tokens og $25 per million output-tokens; Fast mode koster henholdsvis $10 og $50. Disse tal definerer en prognosebaseline, ikke et Opus 6-tilbud.
Scenarie 1: Mere performance til samme standardpris
Anthropic holdt den aktuelle Opus-udgivelse på forgængerens listepris samtidig med forbedret kapabilitet. En plausibel Opus 6-strategi ville derfor bevare standardtaksterne $5/$25 og levere mere performance per token. Brugerne ville modtage en kapabilitetsopgradering til samme pris, selvom faktiske besparelser stadig ville afhænge af outputlængde og brug af ræsonnering.
Scenarie 2: Lavere omkostning per succesfuld opgave
Selv med uændrede tokenpriser kan bedre nøjagtighed ved første forsøg, færre gentagelser og kortere agentløkker reducere omkostningen ved et accepteret resultat. Dette operationelle mål er mere nyttigt end listepris alene, fordi det inkluderer mislykkede forsøg og menneskelig rettetid.
Scenarie 3: Standard-, ræsonnerings- og fast-mode-tier
Anthropic kunne bevare en standardtakst til rutinearbejde og samtidig opkræve mere for høj-indsats-ræsonnering eller lav-latenstid fast mode. Den nuværende struktur adskiller allerede standardpriserne $5/$25 fra $10/$50 for Fast mode; en efterfølger kunne bevare den opdeling eller introducere finere indsatsbaseret routing. Dette forbliver spekulativt, indtil en officiel pristabel foreligger.
Hvordan forbereder man sig på Claude Opus 6
Der findes ikke et verificeret Claude Opus 6-endpoint, og udviklere bør ikke placere claude-opus-6 i produktionskode. Mens man venter på en officiel udgivelse, kan teams evaluere nuværende Opus-adfærd ved at bruge Claude Opus 5 via CometAPI. Modellen understøtter det native Anthropic Messages-mønster og en OpenAI-kompatibel integrationssti, hvilket gør det muligt at etablere evalueringssæt, før en fremtidig model bliver tilgængelig.
En praktisk forberedelsesplan er at registrere succesrate, omkostning per succesfuld opgave, antal værktøjsopkald, latenstid, retry-rate og menneskelig rettetid på Opus 5. Når Anthropic på et tidspunkt annoncerer en efterfølger, kan samme evalueringsramme teste, om den nye model leverer en reel operationel forbedring.
Prøv Claude Opus 5 via CometAPI mens du venter
Opret en CometAPI-nøgle, gem den i miljøvariablen COMETAPI_KEY, og brug det aktuelle model-ID claude-opus-5. Eksemplerne nedenfor bruger med vilje ikke et fiktivt Opus 6-ID.
Bash (cURL)
curl https://api.cometapi.com/v1/messages \ -H "Authorization: Bearer $COMETAPI_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "claude-opus-5", "max_tokens": 1024, "messages": [ {"role": "user", "content": "Review this implementation plan and identify hidden risks."} ] }'
Python
import os import anthropic client = anthropic.Anthropic( api_key=os.environ["COMETAPI_KEY"], base_url="https://api.cometapi.com", ) message = client.messages.create( model="claude-opus-5", max_tokens=1024, messages=[ { "role": "user", "content": "Review this implementation plan and identify hidden risks.", } ], ) print(message.content[0].text)
JavaScript (Node.js)
import Anthropic from "@anthropic-ai/sdk"; const client = new Anthropic({ apiKey: process.env.COMETAPI_KEY, baseURL: "https://api.cometapi.com", }); const message = await client.messages.create({ model: "claude-opus-5", max_tokens: 1024, messages: [ { role: "user", content: "Review this implementation plan and identify hidden risks.", }, ], }); console.log(message.content[0].text);
Til produktionsbrug, se CometAPI API-dokumentation for understøttede parametre, fejlhåndtering, streaming og endpoint-detaljer. Antag ikke, at en fremtidig Opus-model vil bruge identiske standarder eller acceptere alle Opus 5-parametre uden migrationstest.
Hvad vi ikke ved endnu
| Ukendt område | Hvad man med ansvar kan sige |
|---|---|
| Officielt navn | Anthropic bruger måske ikke betegnelsen Claude Opus 6. |
| Udgivelsesplan | Intet bekræftet lanceringsvindue er offentliggjort. |
| Model-ID | Der findes intet dokumenteret claude-opus-6-identifikator. |
| Kontekst- og outputgrænser | Et større vindue eller outputgrænse kan ikke antages. |
| Modaliteter | Indbygget lyd, video eller rigere output er ukendt. |
| Ræsonneringskontroller | Indsatsniveauer og tænkeadfærd kan ændre sig. |
| Priser | Priser for input, output, caching, batch og fast mode er ukendte. |
| Benchmarks | Der findes ingen autentiske Opus 6-scorer eller systemkort. |
| Tilgængelighed | Detaljer om Claude, Claude Code, cloud og API-udrulning er ukendte. |
Redaktionel regel: opdater kun denne tabel efter at Anthropic offentliggør primær dokumentation.
Ofte stillede spørgsmål
Er Claude Opus 6 tilgængelig?
Nej. Anthropic har ikke annonceret eller dokumenteret en model ved navn Claude Opus 6. Claude Opus 5 er den aktuelle Opus-model beskrevet i det officielle katalog.
Hvad er Claude Opus 6 model-ID’et?
Der findes intet officielt model-ID. Udviklere bør ikke gå ud fra, at claude-opus-6 er gyldigt. Det nuværende dokumenterede identifikator er claude-opus-5.
Vil Claude Opus 6 have et større kontekstvindue?
Det er ukendt. Opus 5 tilbyder allerede et kontekstvindue på 1M tokens, men Anthropic kan prioritere pålidelighed, latenstid eller omkostningseffektivitet frem for at øge den nominelle grænse.
Vil Claude Opus 6 være bedre end GPT-5.6 Sol?
Der findes intet bevis for en vinder. GPT-5.6 Sol er en tilgængelig model med offentliggjorte resultater, mens Opus 6 er uannonceret. En fremtidig sammenligning bør bruge samme ramme, indsatsniveau, værktøjer og forudsætninger for omkostninger.
Kan udviklere forberede sig før udgivelse?
Ja. Byg gentagelige evalueringer på Opus 5, spor omkostning per fuldført opgave, isolér model-ID’er i konfigurationen, og undgå at hardkode adfærd, der kan ændre sig mellem generationer.
Afsluttende bemærkninger
Claude Opus 6 er fortsat en plausibel, men uannonceret efterfølger. Dets praktiske værdi bør bedømmes ud fra en lille mængde operationelle resultater: accepteret-opgave-rate, ende-til-ende-omkostning, latenstid og menneskelig rettetid, snarere end en gentaget liste af forventede funktioner.
Hvis Anthropic udgiver en efterfølger, så kør den samme arbejdsmængde gennem CometAPI.