Tekniske specifikationer for GLM-5.3-Flash
| Specifikation | GLM-5.3-Flash |
|---|---|
| Udbyder | Z.ai (Zhipu AI) |
| Modelfamilie | GLM-5 |
| Modeltype | Nativt multimodal Mixture-of-Experts-model |
| Samlede parametre | 320B |
| Aktive parametre | 18B |
| Arkitektur | Hybrid sparsom + lineær opmærksomhed |
| Kontekstvindue | 1,048,576 tokens (1M) |
| Maksimalt output | 131,072 tokens |
| Input-modaliteter | Tekst, billeder, video |
| Output-modalitet | Tekst |
| Ræsonnering | Understøttet |
| Vision | Understøttet |
| Funktionskald | Understøttet |
| Brug af værktøjer | Understøttet |
| Websøgning | Understøttes via understøttede API-integrationer |
| Åbne vægte | Ja |
| Licens | MIT |
| Udgivelse | August 26, 2026 |
Z.ai beskriver GLM-5.3-Flash som den første nativt multimodale model i GLM-5-familien. Den indeholder i alt 320B parametre, men aktiverer kun 18B parametre pr. inferenstrin. Modellen introducerer en hybridarkitektur, der kombinerer sparsom og lineær opmærksomhed, og bruger mHC for at forbedre skaleringseffektiviteten.
Hvad er GLM-5.3-Flash?
GLM-5.3-Flash er Z.ai’s effektivitetsorienterede medlem af GLM-5-generationen, designet til at kombinere grænsefront-ræsonnering og agentbaserede kodningsevner med væsentligt lavere inferensomkostninger.
Dens vigtigste skelnen fra en konventionel "Flash"-model er, at Flash ikke betyder en lille model. GLM-5.3-Flash indeholder i alt 320B parametre, men dens MoE-arkitektur aktiverer kun 18B parametre pr. token. Dette gør det muligt for Z.ai at sigte mod meget lavere inferensberegning, samtidig med at en stor parameterpulje bevares for modelkapacitet.
Det er også den første GLM-5-model med nativ multimodal kapacitet. Modellen understøtter visuelle input ud over tekst og er positioneret til kodning, browserinteraktion, dokumentforståelse, visuel kodning og agentbaserede arbejdsgange.
Z.ai siger, at GLM-5.3-Flash blev trænet fra en ny base model i stedet for blot at være en komprimeret version af GLM-5.2. Dens træning bruger et 30-billioner-token multimodalt prætræningskorpus, mens arkitekturen blev redesignet med fokus på kapabilitet og inferenseffektivitet.
Hovedfunktioner i GLM-5.3-Flash
- 320B MoE med 18B aktive parametre: GLM-5.3-Flash kombinerer en meget stor samlet parameterkapacitet med et relativt lille aktivt parameteraftryk, hvilket gør modellen væsentligt mere effektiv at betjene end en tæt 320B-model.
- Nativ multimodal forståelse: I modsætning til tidligere GLM-5-modeller behandler GLM-5.3-Flash nativt visuelle input. Dens modelkort giver eksempler på billedforståelse og identificerer modellen som multimodal.
- 1M-token kontekst: Modellen er designet til langt-kontekst-applikationer, der involverer store repositories, omfattende dokumenter, lange agentforløb og komplekse flertrins-arbejdsgange. Cloudflare og Vercel angiver begge et kontekstvindue på 1,048,576 tokens.
- Hybrid sparsom + lineær opmærksomhed: GLM-5.3-Flash er den første GLM-model, der kombinerer sparsom opmærksomhed og lineær opmærksomhed. Z.ai siger, at denne arkitektur reducerer omkostningerne ved langt-kontekst-betjening, mens præcis langt-kontekst-kapacitet bevares.
- Agentbaseret kodning og værktøjsbrug: Modellen er optimeret til software engineering, terminalopgaver, browserinteraktion og værktøjsdrevne arbejdsgange. Dens rapporterede Terminal-Bench 2.1-score er 84.3.
- Open-weight-implementering: De MIT-licenserede vægte kan implementeres med Transformers, vLLM, SGLang, TokenSpeed og KTransformers, hvilket giver udviklere muligheder for self-hosting og inferensoptimering.
Benchmark-ydelse for GLM-5.3-Flash
GLM-5.3-Flash har en særlig stærk profil på kodnings- og agentbaserede benchmarks.
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Bemærkninger |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | Terminal / agentbaseret kodning |
| DeepSWE v1.1 | 63.4 | 46.2 | Software engineering |
| AutomationBench | 48.8 | 26.2 | Computerbrugs-automation |
| Toolathlon-Verified | 78.4 | 59.9 | Værktøjsbrugskapacitet |
| NL2Repo-Bench | 56.3 | 48.9 | Naturligt sprog til repository-kodning |
| Agent's Last Exam | 26.3 | 20.4 | Agentbaseret ræsonnering |
| Humanity's Last Exam | 55.3 | — | Med værktøjer |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | Produktivitet / vidensarbejde |
| OfficeQA-Pro | 62.4 | — | Multimodal produktivitet |
| CharXiv RQ | 89.4 | — | Multimodal ræsonnering |
Den officielle evalueringssektion på Hugging Face angiver 84.3 på Terminal-Bench 2.1, 63.4 på DeepSWE og 55.3 på HLE. Z.ai’s lanceringsmateriale rapporterer yderligere resultater, herunder AutomationBench, Toolathlon, NL2Repo og GDPval.
Independent Artificial Analysis giver i øjeblikket GLM-5.3-Flash et Intelligensindeks på 57, hvilket placerer den som nr. 3 blandt 108 modeller i deres aktuelle sammenligningssæt.
Disse tal bør stadig fortolkes med benchmark-specifikke forbehold: flere resultater er leverandør-rapporterede, evalueringsrammer varierer, og benchmark-scorer bør ikke behandles som en universel rangering af modelkvalitet.
GLM-5.3-Flash vs GLM-5.3 vs GLM-5.2
| Funktion | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| Modelgeneration | GLM-5 | GLM-5 | GLM-5 |
| Positionering | Effektiv multimodal / agentisk model | High-end generel ræsonneringsmodel | Forrige generations generelle model |
| Nativ vision | Ja | Nej | Modelafhængig |
| Samlede parametre | 320B | Større flagskibskonfiguration | Storskala model |
| Aktive parametre | 18B | — | — |
| Kontekst | 1M | 200K-klasse implementering | 200K-klasse implementering |
| Hybrid sparsom/lineær opmærksomhed | Ja | Nej | Nej |
| Agentbaseret kodning | Fremragende | Fremragende | Stærk |
| Åbne vægte | Ja | Afhænger af implementering | Afhænger af implementering |
| Hovedfordel | Kapabilitet pr. enhed inferenscompute | Maksimal GLM-5-ræsonneringskapacitet | Moden og lavere omkostnings GLM-generation |
Den væsentlige forskel er, at GLM-5.3-Flash ikke blot er GLM-5.3 i mindre størrelse. Z.ai siger, at den starter fra en ny trænet basemodel og introducerer en redesignet hybrid opmærksomhedsarkitektur, mHC og multimodal prætræning.
GLM-5.3-Flash vs DeepSeek V4 Flash — sammenligningsresumé
| Dimension | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | Fordel |
|---|---|---|---|
| Udgivelsesdato | August 26, 2026 | Preview April 2026; major checkpoint (0731) July 31, 2026 | — |
| Samlede / aktive parametre | 320B / 18B | 284B / 13B | GLM en smule større |
| Kontekstvindue | 1M tokens | 1M tokens | Uafgjort |
| Maks. output | ~131K tokens | Op til 384K tokens | DeepSeek |
| Modaliteter | Nativt multimodal (tekst + billede + videoinput) | Primært tekst (eksperimentelle visionsvarianter tilgængelige) | GLM |
| Arkitekturhøjdepunkter | Hybrid sparsom + lineær opmærksomhed (~3× lavere attention-compute, ~4.4× mindre KV-cache vs. fuld GLM-5.3) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | Begge har styrker |
| Licens | MIT (vægte på Hugging Face) | MIT (vægte tilgængelige) | Uafgjort |
| Standard API-priser ($ / 1M tokens) | Input $0.15 / Output $0.50 (cachet input ~$0.03) | Typisk interval $0.14–$0.44 input / $0.28–$1.32 output (spids-/lavbelastning varierer) | GLM billigere |
| Introduktionstilbudspriser | ~$0.075 input / $0.25 output (tidsbegrænset, ~tidlig sep. 2026) | Intet tilsvarende tilbud | GLM |
| AA Intelligensindeks | 57 (leverandør-rapporteret) | ~50 (uafhængig måling) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | Begrænsede uafhængige data endnu | ~79% (stærke uafhængige resultater) | DeepSeek |
| Nøglestyrker | Lavere pris, nativ multimodal, fører på flere agent-/kodningsscorer, effektiv lang kontekst | Mere moden uafhængig validering, fremragende kodnings-/agenttrack record, meget effektiv langt-kontekst-design, stærkt økosystem | — |
| Nøglesvagheder | Nyere udgivelse (nogle scorer stadig leverandør-rapporterede); gennemsnitlig hastighed | Svagere multimodal støtte; højere effektiv pris på mange ruter | — |
| Bedst til | Generel brug, multimodale workloads, omkostningsfølsomme projekter, balancerede agentkapabiliteter | Rene kodningsagenter, langt-kontekst tekstræsonnering, scenarier der kræver dokumenterede uafhængige benchmarks | — |
Én-sætning-resumé:
Per slutningen af august 2026 fører GLM-5.3-Flash i øjeblikket på pris, multimodal kapabilitet og flere overlappende benchmarks og tilbyder bedre samlet værdi. DeepSeek V4 Flash forbliver et meget pålideligt valg til kodningsfokuserede agenter takket være stærkere uafhængig validering og langt-kontekst-effektivitet. Test begge på dine specifikke workloads, før du beslutter.
Anvendelsestilfælde for GLM-5.3-Flash
1. Agentbaseret software engineering
GLM-5.3-Flash er særlig velegnet til kodningsagenter, der skal inspicere repositories, ændre flere filer, udføre terminalkommandoer, køre tests og iterere på implementering.
Dens Terminal-Bench 2.1-score på 84.3 og DeepSWE-resultat på 63.4 demonstrerer, at software engineering er et af dens stærkeste anvendelsesområder.
2. Visuel kodning
Fordi GLM-5.3-Flash er nativt multimodal, kan udviklere give skærmbilleder, diagrammer og andre visuelle input sammen med kodningsinstruktioner. Dette er nyttigt til UI-implementering, visuel fejlfinding og design-til-kode-arbejdsgange.
3. Lang-kontekst dokumentanalyse
Det 1M-token kontekstvindue gør modellen egnet til store sæt af teknisk dokumentation, repositories, lange rapporter og flertrins agenthistorikker.
4. Browser- og computerbrugsagenter
Modellens værktøjsbrug og multimodale kapaciteter gør den velegnet til arbejdsgange, der involverer browsere, grafiske grænseflader og eksterne værktøjer.
5. Enterprise vidensarbejde
GLM-5.3-Flash kan behandle store mængder struktureret og ustruktureret information, mens den bruger værktøjer til at udføre flertrinsopgaver, hvilket gør den egnet til dokumentanalyse, forskningsassistance og workflow-automatisering.
6. Self-hosted AI-infrastruktur
MIT-licensen og offentligt tilgængelige vægte gør GLM-5.3-Flash attraktiv for organisationer, der kræver kontrol over implementering, databehandling og inferensinfrastruktur.
GLM-5.3-Flash API-parametre
| Parameter | Beskrivelse |
|---|---|
| model | Udbyderspecifik modelidentifikator |
| messages | Struktureret samtaleinput |
| prompt | Enkelt prompt-input på understøttede API'er |
| max_tokens / max_completion_tokens | Output-token-grænse |
| temperature | Styrer samplingtilfældighed |
| tools | Værktøjs-/funktionsdefinitioner |
| stream | Aktiverer streamingoutput |
| reasoning | Styrer ræsonneringsindsats på understøttede gateways |
| Image content | Understøttet |
| Function calling | Understøttet |
| Context | Op til 1M tokens |
Vercel AI Gateway dokumenterer i øjeblikket et maksimum på 131,000 output-tokens, hvor ræsonneringstokens tæller mod outputgrænsen.
Sådan bruger du GLM-5.3-Flash API i CometAPI
Trin 1: Få API-adgang
Log ind på cometAPI. Hvis du endnu ikke er bruger, skal du registrere dig først. Log ind på din CometAPI-konsol. Hent adgangslegitimations API-nøglen til interfacet. Klik på “Add Token” ved API token i personcentret, hent token-nøglen: sk-xxxxx og indsend.
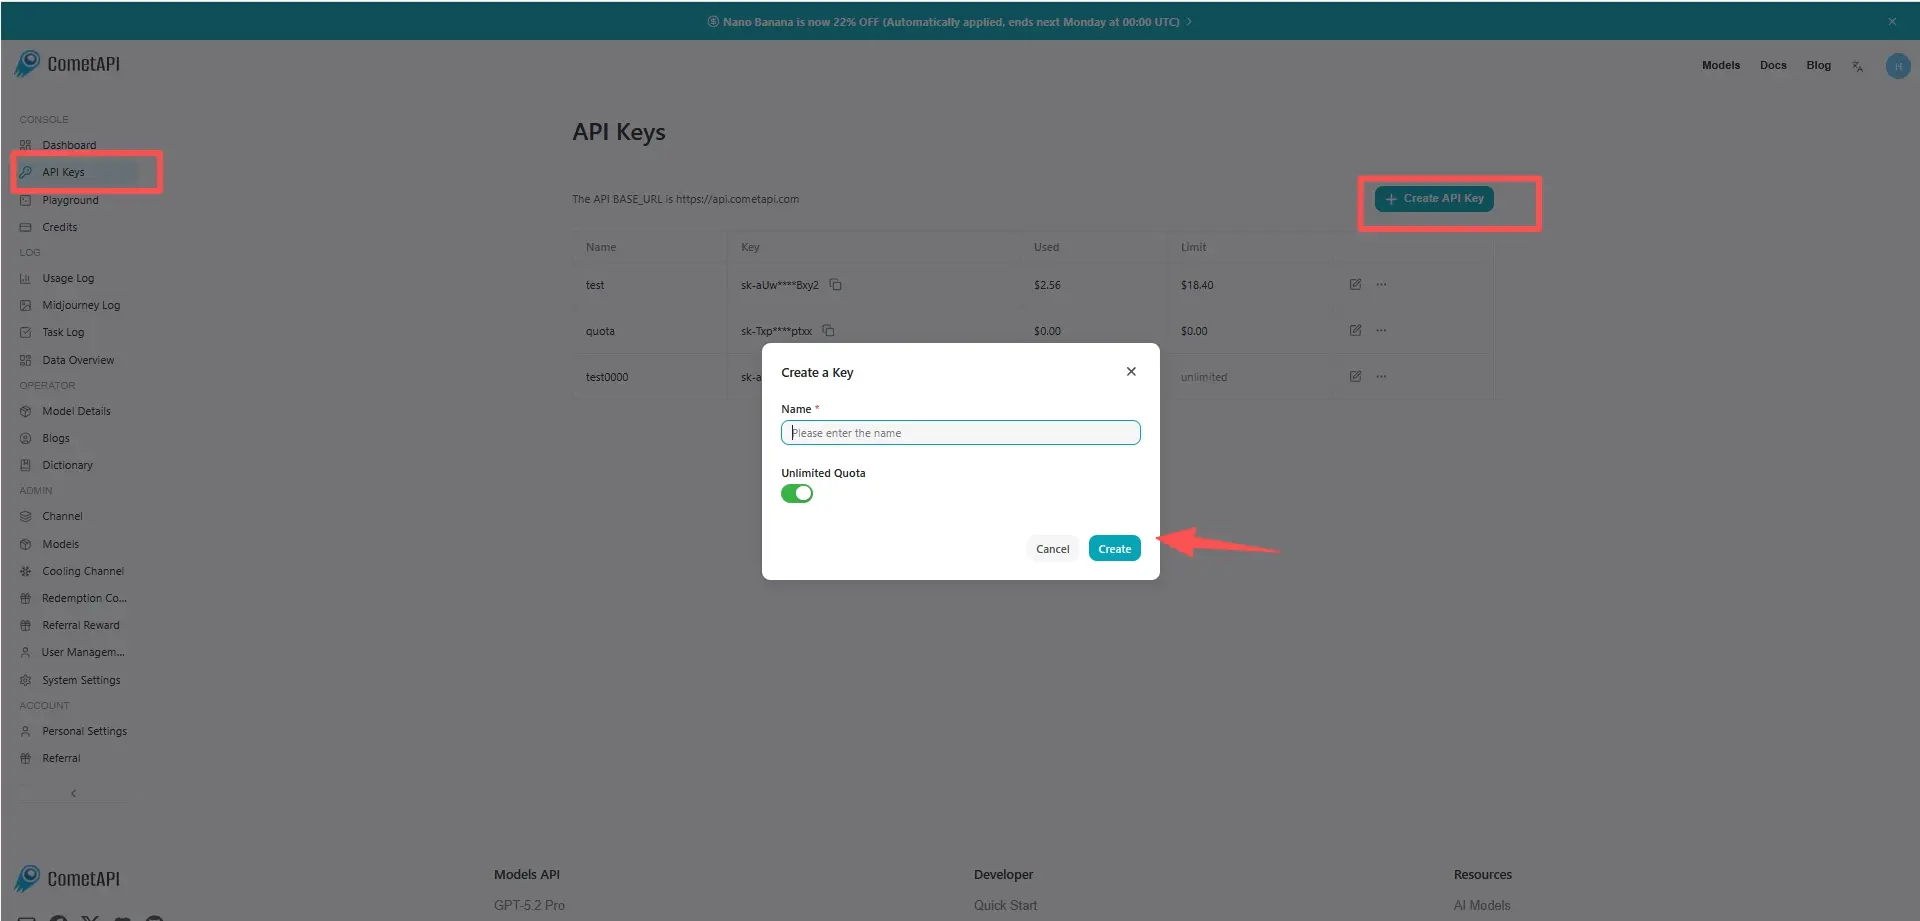
Trin 2: Send forespørgsler til GLM-5.3-Flash API
Vælg “GLM-5.3-Flash”-endpunktet for at sende API-forespørgslen og angiv request body. Forespørgselsmetoden og request body fås fra vores websteds API-dokumentation. Vores websted giver også Apifox-test for din bekvemmelighed. Erstat <YOUR_API_KEY> med din faktiske CometAPI-nøgle fra din konto.
Indsæt dit spørgsmål eller din anmodning i content-feltet — det er dette, modellen vil svare på. Behandl API-svaret for at få det genererede svar.
Trin 3: Behandl svar
API'en returnerer strukturerede kandidat-svar, inklusive genereret tekst, citater, sikkerhedsmetadata og valgfri værktøjsoutputs. For multimodale forespørgsler kan beskedindholdet struktureres med tekst- og billedeinput, når det valgte CometAPI-endpoint eksponerer modellens vision-kapabilitet.
Det præcise CometAPI-endpoint, understøttede parametre og aktuel tilgængelighed bør tages fra den live CometAPI API-dokumentation i stedet for at blive udledt fra Z.ai’s native API.
For CometAPI bør integrationen bruge model-ID'et, der vises på det live CometAPI-modeleendpunkt, i stedet for automatisk at kopiere udbyderspecifikke ID'er fra Z.ai, Cloudflare eller Vercel.
Begrænsninger ved GLM-5.3-Flash
- Stor modelfodaftryk: Selvom kun 18B parametre er aktive, indeholder den frigivne model cirka 321B parametre, hvilket gør self-hosting væsentligt mere krævende end implementering af en konventionel 7B–70B model.
- Inferenshastighed er ikke nødvendigvis “flash” i absolutte termer: Artificial Analysis måler i øjeblikket omtrent 50 output-tokens/sekund i deres sammenligningsmiljø, hvilket placerer modellen et godt stykke under de hurtigste små modeller.
- Meget lang kontekst øger infrastrukturkrav: Et 1M-token kontekstvindue er nyttigt, men kan øge hukommelses- og betjeningskompleksitet.
- Benchmark-ydelse varierer efter opgave: GLM-5.3-Flash er især stærk i agentbaseret kodning og værktøjsbrugsbenchmarks, men ingen enkelt benchmark etablerer universel overlegenhed over for frontlinje, proprietære modeller.
- Multimodalt output er begrænset: Modellens nativt multimodale kapacitet er primært input-siden; dens standardoutput er tekst frem for genererede billeder eller video.