
TL;DR: Vælg DeepSeek-V4-Flash til hurtig, lav-latens tekstautomatisering; vælg GLM-5.3-Flash for multimodale kapabiliteter, overlegen agent-benchmarking og meget effektiv long-context privat serverhosting. Begge modeller tilbyder open weights under the MIT License**** og er udgivet under den permissive MIT License.
DeepSeek-V4-Flash**** er et bedre valg, hvis du vil have et ultrahurtigt, høj-throughput tekst-only API til traditionelle kode-sløjfer og massiv batchbehandling. Den scorer 50 på Artificial Analysis Intelligence Index, genererer op til 122+ tokens/sec via sin integrerede DSpark spekulative decoding-motor og tilbyder off-peak API-priser helt ned til $0.22/$0.66 pr. million input/output tokens.
GLM-5.3-Flash er det mere alsidige valg, når der kræves native multimodalitet, visual-in-the-loop-programmering og højeffektiv selvadministreret skalering. Den scorer 57 på Artificial Analysis Intelligence Index, udnytter en hybrid lineær-og-sparsom attention-mekanisme (KDA + NoPE Sparse MLA) til at reducere KV Cache-hukommelse med 4.44× ved 1M kontekst og tilbyder native visuel ræsonnering. Dens API er prissat meget konkurrencedygtigt til $0.15/$0.50 pr. million input/output tokens (kampagnerater ned til $0.075/$0.25).
Nøglepunkter
- DeepSeek-V4-Flash gik fra sin første preview på DeepSeek API News Announcement til den officielle udgivelse på Hugging Face, hvor den inkorporerede Token-wise Compression, DeepSeek Sparse Attention (DSA) og DSpark spekulativ decoding for at øge genereringshastighederne.
- GLM-5.3-Flash blev udgivet den August 26, 2026, efter at have opnået stor popularitet under sin anonyme testfase på OpenRouter under kodenavnet "Ox Alpha."
- GLM-5.3-Flash fører den samlede Artificial Analysis Intelligence Index med 57 point sammenlignet med 50 point for DeepSeek-V4-Flash-0731, hvilket afspejler stærkere overordnet kapabilitet i kompleks ræsonnering og agentopgaver.
- Begge arkitekturer er Mixture-of-Experts (MoE) modeller med ekstremt slanke compute-fodaftryk under inference: DeepSeek aktiverer 13B ud af 284B samlede parametre pr. token, mens GLM aktiverer 18B ud af 320B.
- Begge modeller er fuldt open weights og distribueret under MIT License, hvilket giver maksimal frihed til enterprise-kommercialisering, tilpasset finjustering og on-premise-udrulning.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Hurtig sammenligning
| Specifikation | DeepSeek-V4-Flash-0731 | GLM-5.3-Flash |
|---|---|---|
| Udvikler | DeepSeek-ai | Z.ai (Zhipu AI) |
| Udgivelsesdato | July 31, 2026 | August 26, 2026 |
| Model-ID | deepseek-v4-flash | glm-5.3-flash |
| Hugging Face Repository | deepseek-ai/DeepSeek-V4-Flash | zai-org/GLM-5.3-Flash |
| Arkitektur | MoE; DSA + Token-wise Compression | MoE; KDA + NoPE Sparse MLA + mHC |
| Samlede parametre | 284B (304B med DSpark-modul) | 320B |
| Aktive parametre | 13B pr. token | 18B pr. token |
| Kontekstvindue | 1,000,000 tokens | 1,048,576 / ca. 1M tokens |
| Input/output | Text → Text | Text + Image + Video + File → Text |
| Ræsonnering | Konfigurerbar (Thinking / Non-Thinking) | Tre niveauer (Low / High / Max) |
| Funktion-/værktøjsbrug | JSON Schema / Tool Calls | ToolCalls, constraints, dynamisk værktøjsindlæsning |
| Open weights | Ja (MIT License) | Ja (MIT License) |
| AA Intelligence Index | 50 | 57 |
| Officiel pris (1M tokens) | Spids: $0.44 / $1.32 <br> Uden for spids: $0.22 / $0.66 | Liste: $0.15 / $0.50 <br> Promo: $0.075 / $0.25 |
| Bedst egnet | Høj-throughput-agenter, hurtig tekstgenerering | Visuel programmering, tilpassede on-prem-udrulninger |
Hvad er DeepSeek-V4-Flash?
DeepSeek-V4-Flash er en letvægts, hyperhurtig MoE-model, konstrueret til at understøtte autonome udvikleragenter og massive tekstbehandlings-pipelines. Oprindeligt forhåndsvist på DeepSeek API News Announcement, modtog modellen en større post-træningsopgradering i sin officielle udgivelse som DeepSeek-V4-Flash-0731 på Hugging Face.
Modellen er optimeret til ren tekstgennemstrømning, struktureret API-kald og hurtig udførelse af programkode. Den minimerer både latenstid og token-til-token inference-omkostninger og sigter mod multi-turn softwareudviklingssløjfer, hvor hastighed og udførelsesomkostninger er afgørende.
Hvad er ændret fra previewet?
Den officielle 0731-version inkluderer en valgfri, samtrænet spekulativ drafting-model, der bringer det samlede lokale parameterantal op på 304B. Ved hosting kører dette spekulative decoding-framework (DSpark) side om side med den aktive 13B-vej for at accelerere genereringshastigheder til 122.7 tokens per sekund.
Derudover blev tilpasningsprocessen omfattende retrænet med reinforcement learning (RL) i sandkasse-baserede eksekveringsmiljøer, hvilket gav væsentligt højere pålidelighed i multi-trins terminalarbejde, shell-scripting og struktureret værktøjsbrug.
DeepSeek-V4-Flash specifikationer
| Egenskab | DeepSeek-V4-Flash-0731 |
|---|---|
| Kontekst | 1,000,000 tokens |
| Modaliteter | Tekstinput; tekstoutput (standardmodel) |
| Ræsonnering | Understøtter Non-thinking og Thinking modes |
| Native API-kapabiliteter | JSON Output, Tool Calls, Responses API |
| Knowledge cutoff | Undisclosed |
| Standardpriser (pr. MTok) | Spids: $0.44 Input / $0.014 Cached / $1.32 Output <br> Uden for spids: $0.22 Input / $0.007 Cached / $0.66 Output |
Hvad er GLM-5.3-Flash?
GLM-5.3-Flash er Z.ai's flagskib inden for open-weights multimodale MoE-modeller. Officielt introduceret på Z.ai Blog den August 26, 2026, er modellen designet til at udføre meget komplekse agent-eksekveringer, automatiseret webnavigation og visuel dokumentræsonnering til standard "Flash"-prisniveauer. Vægtene er offentligt tilgængelige på Hugging Face.
Modellen er prætrænet på et massivt 30-billioners token multimodalt datasæt, hvilket gør visuelle inputs til en native modalitet snarere end en eftertanke. Den sigter mod software engineering, robotic process automation og multimodal databaseforespørgsel.
Hybrid attention, mHC og sparsom MoE-skalering
GLM-5.3-Flash adskiller sig gennem tre arkitektoniske søjler:
- Hybrid Attention: Som beskrevet på Z.ai Blog, kombinerer modellen Kimi Delta Attention (KDA) med NoPE Sparse MLA (Multi-head Latent Attention med No Positional Encoding). Dette hybrid-attentionlag komprimerer projektionerne af keys og values, skærer KV Cache-lagring med 4.44× og reducerer attention-beregninger med 3.01× under 1M-kontekst-evalueringer.
- Stable LatentMoE: Med 896 samlede eksperter og præcis 16 aktiveret per token undgår modellen ekspert-routing-kollaps og forbliver stabil under lange, multi-trins inference-forløb.
- Manifold-Constrained Hyper-Connections (mHC): Denne teknik stabiliserer dybe gradients på tværs af dens 45-lags struktur og optimerer hardwareydelse ved drift på distribuerede GPU-klynger eller lokale AI-chips.
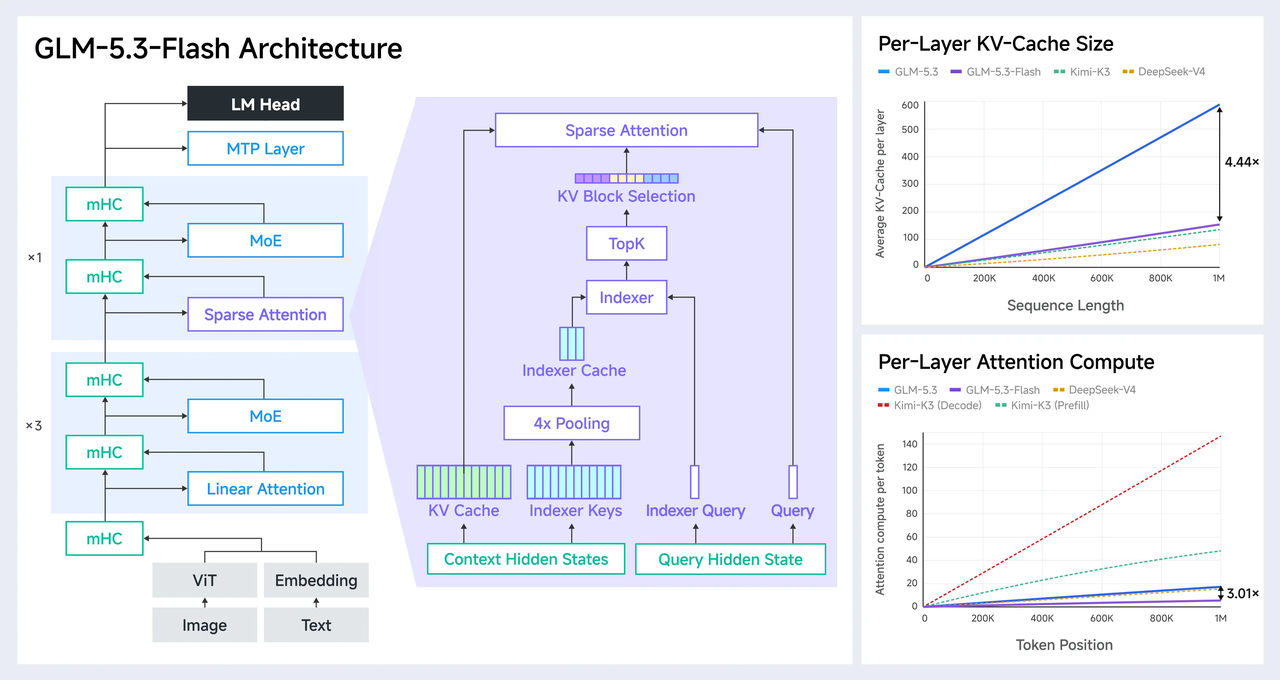
GLM-5.3-Flash: Architecture for Extreme Efficacy Sourcing: z.ai
GLM-5.3-Flash specifikationer
| Egenskab | GLM-5.3-Flash |
|---|---|
| Samlede / aktive parametre | 320B / 18B |
| Arkitektur | MoE med hybrid sparsom og lineær attention |
| Eksperter | 896 i alt; 16 aktiveret per token |
| Kontekst | 1,048,576 tokens (~1M) |
| Vision | Native multimodal (Text, Image, Video, Doc File) |
| Ræsonnering | Understøtter Low, High, Max thinking modes |
| Værktøjer | ToolCalls, constraints, dynamisk værktøjsindlæsning |
| Open weights | Tilgængelig på Hugging Face (MIT License) |
| Officiel pris (pr. MTok) | Liste: $0.15 Input / $0.03 Cached / $0.50 Output <br> Promo (slutter 9. sep): $0.075 Input / $0.015 Cached / $0.25 Output |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Funktionssammenligning
Arkitektur og parametereffektivitet
DeepSeek-V4-Flash opererer en 284B samlet parameterarkitektur (13B aktive) med en samtrænet spekulativ drafting-model (der øger lokale deployments til 304B). GLM-5.3-Flash bruger 320B samlede parametre (18B aktive) på tværs af et meget sparsomt 45-lags layout. Begge modeller aktiverer meget få parametre pr. token, hvilket gør dem i stand til at levere høje hastigheder typiske for meget mindre modeller, samtidig med at de bevarer den rige vidensrepræsentation fra en massiv model.
Attention-mekanisme og hukommelsesoptimering
DeepSeek-V4-Flash anvender DeepSeek Sparse Attention (DSA) og Token-wise Compression. Den analyserer dynamisk sekvensstrukturer og komprimerer redundante tokens (f.eks. skabelonkode-strukturer eller gentagende systemheaders) under behandling af lange prompts.
GLM-5.3-Flash kombinerer lineær KDA med latent projektion (NoPE Sparse MLA). Dette fjerner eksplicitte positional encodings fra key/value-kompressionsblokken og reducerer hukommelsesfodaftrykket af den fysiske KV-cache til kun 22.5% af traditionelle layouts. Dette gør det muligt for hukommelsesbegrænsede klynger at understøtte betydeligt højere samtidighed under long-context workloads.
Modalitet og multimodal dybde
DeepSeek-V4-Flash-0731 er en tekst-only model. Den excellerer i at parse tekniske filer, JSON-skemaer og strukturel markdown. Til visuelle parsing-opgaver skal udviklere bruge en separat multimodal eksperimentel model (deepseek-v4-flash-vision-exp).
GLM-5.3-Flash er natively multimodal. Den accepterer højopløselige billeder, videoer og komplekse kontordokumentfiler (PDF'er, PPTX'er, regneark) direkte. Denne native multimodalitet understøtter "visual-in-the-loop" softwareudvikling, hvor modellen kan inspicere et gengivet UI-layout, opdage justeringsproblemer og iterativt rette sin egen kode uden manuel udviklerintervention.
Licensering og åbenhed
Begge modeller er udgivet under den meget permissive MIT License. Dette giver enterprise-udviklere fuld frihed til at modificere, distribuere, sublicensere og kommercielt udrulle modelvægtene lokalt, i en privat VPC eller i luftgapede on-premise cloud-infrastrukturer.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Benchmark-sammenligning
Når de evalueres på de samme datasæt under identiske test-harnesses, præsterer begge modeller konkurrencedygtigt på software engineering og agent-automatiseringsopgaver.
Kodning og agent-ydelse
| Benchmark | GLM-5.3-Flash (Z.ai) | DeepSeek-V4-Flash-0731 |
|---|---|---|
| Artificial Analysis Index v4.1.1 | 57 | 50 |
| Terminal Bench 2.1 (Acc) | 84.3 | 82.7 |
| DeepSWE v1.1 (GitHub Issues) | 63.4 | 54.4 |
| Toolathlon (Verified / Pass@1) | 78.4 | 70.3 |
| NL2Repo (Acc) | 56.3 | 54.2 |
| Automation Bench (Acc) | 48.8 | 25.1 |
| GDPval-AA v2 (Agent Elo) | 1773 | 1554 |
GLM-5.3-Flash bevarer et forspring på de fleste agentiske og software engineering benchmarks og scorer 63.4% på DeepSWE v1.1 og 84.3 på Terminal Bench 2.1. Dens 18B aktive parameter-vej og multi-turn post-træningsalignment hjælper den med at håndtere kompleks repository-tracking og operativsysteminteraktioner.
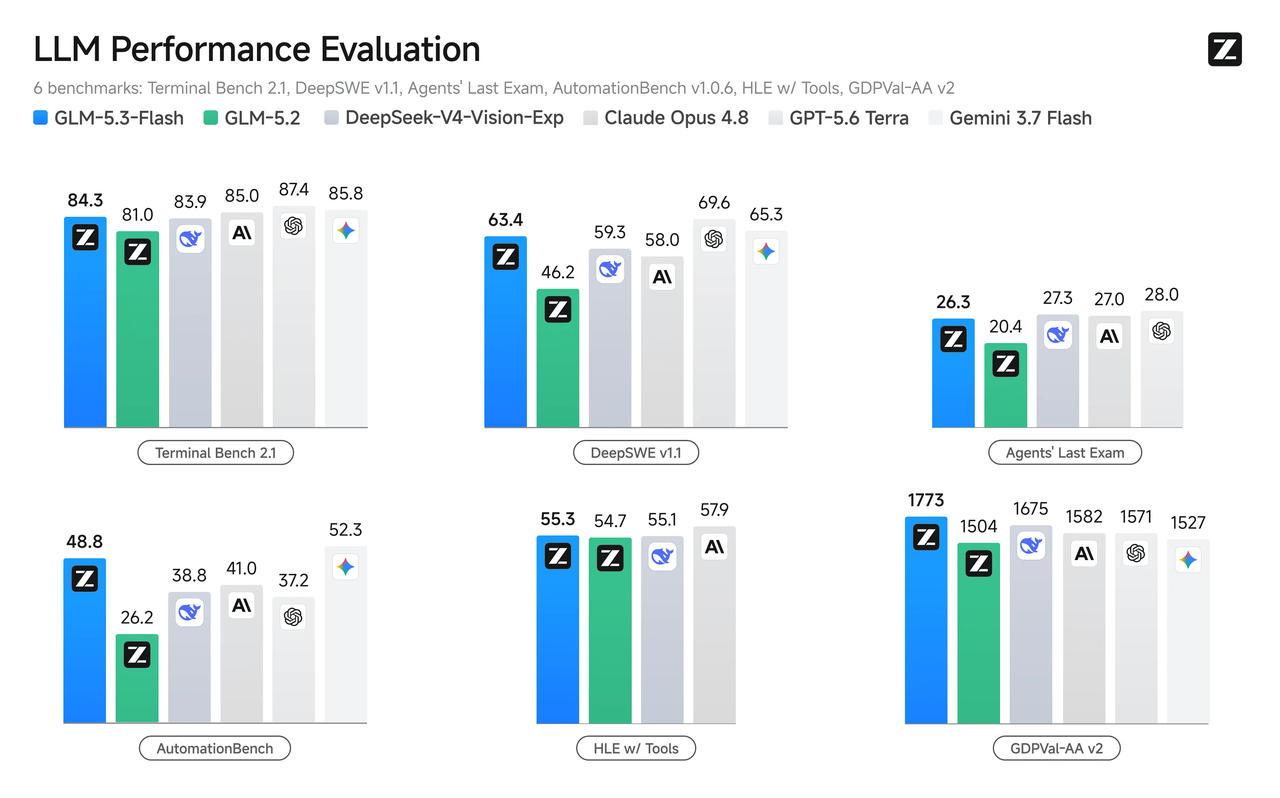
GLM-5.3-Flash Benchmark: scoring 84.3 on Terminal Bench 2.1 Sourcing: z.ai
DeepSeek-V4-Flash-0731 er også yderst kompetent, scorer 82.7 på Terminal Bench 2.1 og 70.3 på Toolathlon. Den leverer pålidelig performance på deterministiske API-strukturer og strikse funktionskald.
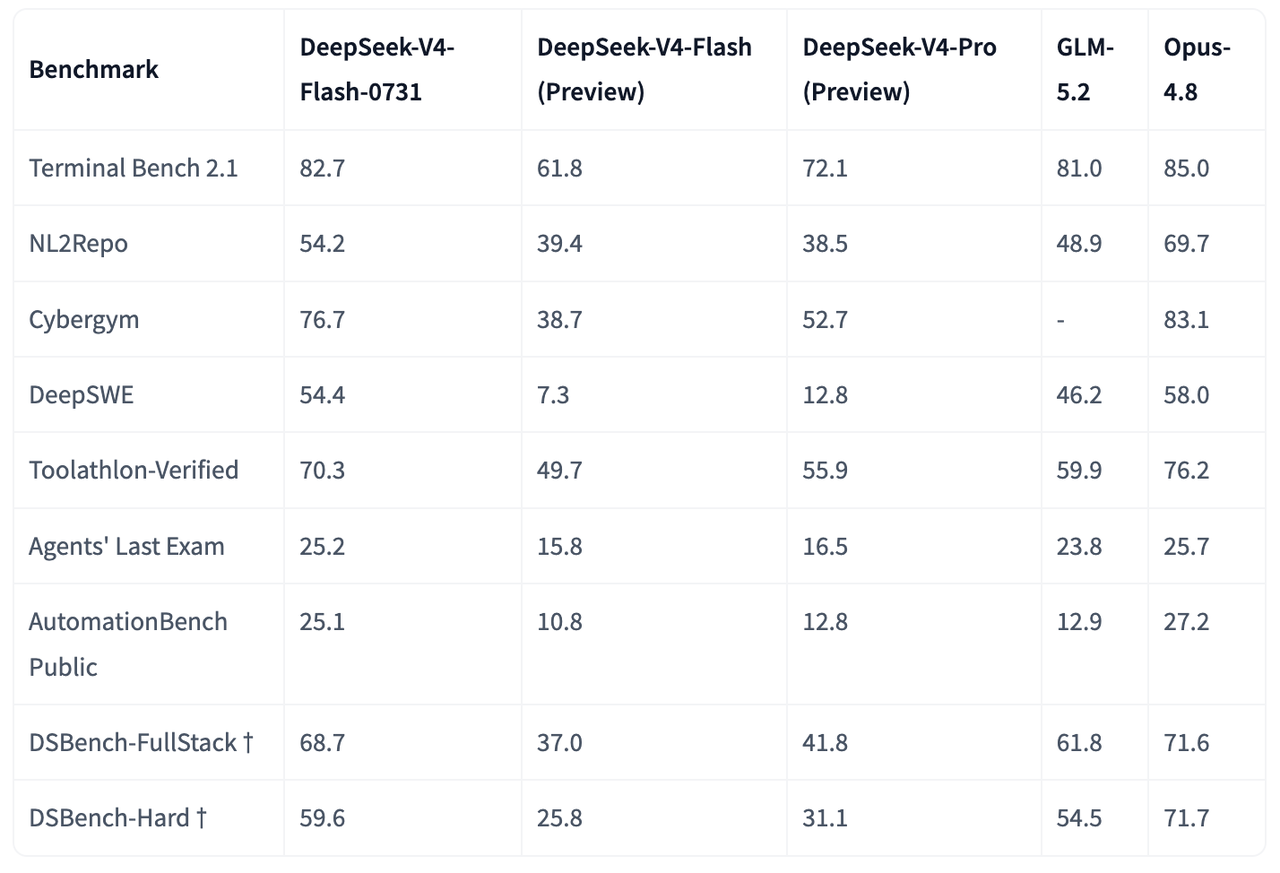
DeepSeek-V4-Flash Benchmark 0731: scoring 82.7 on Terminal Bench 2.1 Sourcing: Hugging Face
Multimodal og visuel ræsonnering
GLM-5.3-Flash's native multimodale træning giver den en tydelig fordel på visuelle ræsonneringsopgaver:
- OfficeQA Pro: 62.4 (GLM-5.3-Flash) vs 57.9 (DeepSeek-V4-Vision eksperimentel gren). GLM demonstrerer overlegen native parsing af indlejrede billeder, strukturerede PDF-tabeller og præsentationer.
- Chartography with Tools: 78.0 (GLM-5.3-Flash). Modellen demonstrerer fremragende evne til at indtage system-flowcharts, wireframe-diagrammer og fakturaskanninger og oversætte dem direkte til eksekverbar systemlogik.
Hastighed og latenstid
- Genereringshastighed: DeepSeek-V4-Flash-0731 er hurtigere og opnår en gennemsnitlig outputhastighed på 122.7 tokens/sec på standard enterprise-cloud-endpoints, assisteret af dens spekulative decoding-framework.
- Time to First Token (TTFT): GLM-5.3-Flash har en lavere TTFT på 1.21 sekunder, sammenlignet med over 3.0 sekunder for DeepSeek-V4-Flash, hvilket får den til at føles mere responsiv i realtids, brugerrettede chatapplikationer.
DeepSeek-V4-Flash vs GLM-5.3-Flash: API-priser
Begge modeller tilbyder ekstremt omkostningseffektive prismodeller og er dermed stærkt konkurrencedygtige i forhold til traditionelle tætte arkitekturer.
Officielle API-listepriser (pr. 1 million tokens)
| Prislag | DeepSeek-V4-Flash-0731 (Spids) | DeepSeek-V4-Flash-0731 (Uden for spids) | GLM-5.3-Flash (Standard) | GLM-5.3-Flash (Promo - til 9. sep) |
|---|---|---|---|---|
| Inputpris (Cache-miss) | $0.44 | $0.22 | $0.15 | $0.075 |
| Inputpris (Cache-hit) | $0.014 | $0.007 | $0.03 | $0.015 |
| Outputpris | $1.32 | $0.66 | $0.50 | $0.25 |
Uden for spidsbelastning er DeepSeek-V4-Flash-0731 meget økonomisk, med inputomkostninger på $0.22/MTok og output på $0.66/MTok, samt en cachet inputomkostning på $0.007/MTok.
GLM-5.3-Flash tilbyder konkurrencedygtige standard flade priser ($0.15 input / $0.50 output) uden spidsbelastningstillæg. Dens kampagnerate (tilgængelig til 9. september 2026) sænker input- og outputpriserne til henholdsvis $0.075 og $0.25, hvilket gør den til et fremragende valg til storskala migrationer og bulkbehandling.
Styrker og svagheder
DeepSeek-V4-Flash-0731
- Styrker:
- Ekseptionel genereringshastighed: Genererer op til 122.7 tokens per sekund via sin samtrænede spekulative drafting-model (DSpark).
- Økonomi uden for spidsbelastning: Tilbyder en usædvanligt lav indgangspris på $0.22 input og $0.66 output pr. million tokens uden for spids.
- Stærk CPU-kvantiseringsstøtte: Besidder en moden GGUF-integrationsvej, hvilket gør den højt optimeret til CPU-baserede lokale runtime-miljøer og begrænsninger i personlig systemhukommelse.
- Trade-offs:
- Prisvolatilitet i spidsbelastning: API-priser fordobles i spidsperioder (0.44/1.32 pr. MTok).
- Kun tekst i kernevægte: Standardvægte understøtter ikke nativ visuel ræsonnering, billeder eller video.
- TTFT-overhead: Udviser en længere målt Time to First Token (TTFT) sammenlignet med GLM.
GLM-5.3-Flash
- Styrker:
- Topklasse intelligens: Opnår en meget konkurrencedygtig 57 på Artificial Analysis Index.
- Native vision-in-the-loop: Integrerer billed- og videohåndtering direkte i sin post-træningsalignment, hvilket muliggør visuel evaluering af front-end webkode.
- Ekseptionel cache-reduktion: Hybrid lineær KDA og NoPE MLA-lag reducerer hukommelsesforbrug med 4.44×, hvilket låser op for højere lokal samtidighed.
- Flade long-context-priser: Standardpriser forbliver flade op til 1M tokens med en branchens laveste cache-hit-rate ($0.03 standard, $0.015 promo).
- Trade-offs:
- Langsommere token-output: Rå genereringshastigheder er langsommere end DeepSeeks dedikerede spekulative decoding-motor.
- Hardwarekrav: Hosting af den fulde 320B parameter MoE-struktur lokalt kræver et multi-node GPU-miljø trods høj sparsitet.
| Model | Styrker | Trade-offs |
|---|---|---|
| DeepSeek-V4-Flash | Hurtig generering (122.7 tok/s i Artificial Analysis”); meget lave priser uden for spids; moden tekstkvantisering; højt optimeret til CPU-baseret lokal GGUF. | Prisvariation i spidsperioder; tekst-only basemodel (ingen native vision); langsommere TTFT. |
| GLM-5.3-Flash | 57 point på AA Intelligence; native multimodal parsing; 4.44× KV cache-kompression; flad prissætning; hurtig TTFT (1.21s); MIT license. | En smule langsommere rå token-genereringshastighed end DeepSeek; lokale multi-node-udrulninger er hardwaretunge. |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Hvilken bør du vælge?
| Use case | Anbefalet | Hvorfor |
|---|---|---|
| Standard frontier API | GLM-5.3-Flash | Scorer højere på intelligence-indekset (57) og dominerer multi-step agent-benchmarks. |
| Langvarig tekstagent | DeepSeek-V4-Flash | Lynhurtig genereringshastighed (122+ tok/s) gør den meget effektiv til massiv tekst-/kodegenerering. |
| Visuel kodning/UI-workflows | GLM-5.3-Flash | Native multimodal design understøtter visual-in-the-loop debugging og UI-renderingsanalyse. |
| Privat/selvadministreret VPC | GLM-5.3-Flash | MIT-licenseret med KDA + NoPE MLA-kompression, der reducerer hardware-VRAM-krav med 4.44×. |
| Lokal CPU-only kørsel | DeepSeek-V4-Flash | Stærkere lokal GGUF-kvantiseringsstøtte (92GB unified memory for ekstreme 1-bit eller 3-bit kørsler). |
| Lavere peak output-omkostning | GLM-5.3-Flash | Standard outputpris på $0.50/MTok forbliver flad og er billigere end DeepSeeks $1.32 peak output rate. |
| Tung Prompt Caching | DeepSeek-V4-Flash | Uden for spidsbelastning koster cache-hits usædvanligt lave $0.007 pr. million tokens. |
Hvorfor bruge Cometapi til at tilgå DeepSeek-V4-Flash og GLM-5.3-Flash
Begge modeller er fuldt integreret i CometAPI. Udviklere kan accessDeepSeek-V4-Flash, and support for Chat Completions / Responses-style access and GLM-5.3-Flash model page exposes GLM-5.3-Flash through the unified CometAPI endpoint. Det gør A/B-test lettere, fordi du kan skifte model-ID'er, mens du bevarer autentificering og det meste af applikationsinfrastrukturen uændret.
Konklusion
Introduktionen af DeepSeek-V4-Flash-0731 og GLM-5.3-Flash har transformeret økonomien i long-context, sparsomme MoE-modeludrulninger. Begge arkitekturer leverer høj intelligens til ekstremt lave prisniveauer.
DeepSeek-V4-Flash-0731 er en højt optimeret tekst- og kode-motor, der excellerer i rå genereringsgennemstrømning, spekulativ decoding og lokal CPU-baseret kvantisering. GLM-5.3-Flash repræsenterer et stort skridt fremad for multimodale og agentbaserede workflows og kombinerer lav-latens visuel ræsonnering med en hybrid attention-mekanisme, der gør on-premise-hosting meget effektiv.
FAQs
Hvad var GLM-5.3-Flashs anonyme testnavn?
Før den officielle lancering blev GLM-5.3-Flash testet anonymt på OpenRouter og OpenCode under kodenavnet "Ox Alpha," hvor den hurtigt blev en populær model blandt udviklere.
Kan jeg køre disse modeller lokalt på en standard personlig computer?
Ja, begge modeller er open-weights og tilgængelige på Hugging Face. Men på grund af deres parameterstørrelser kræver lokal hosting betydelig unified memory:
- DeepSeek-V4-Flash-0731: Ekstrem 1-bit kvantisering kræver ~92GB RAM; en 3-bit kørsel anbefales kraftigt og kræver mellem 110–135GB RAM.
- GLM-5.3-Flash: Ekstrem 1-bit kvantisering kræver ~100GB RAM, mens 3-bit kørsler præsterer bedst med 128GB–150GB unified system memory.
Understøtter DeepSeek-V4-Flash visuel eller video-behandling?
Nej, standard DeepSeek-V4-Flash-0731 er en tekst-only model. Til visuelle opgaver skal du bruge deres separate multimodale eksperimentelle model (deepseek-v4-flash-vision-exp).
Hvordan fungerer "visual-in-the-loop" programmering på GLM-5.3-Flash?
Fordi modellen har native visuel og billedforståelse, kan den skrive frontend-kode, gennemgå det gengivne visuelle output, opdage layout- eller stylingfejl og omskrive koden for at rette disse fejl uden at et menneske skal beskrive layoutproblemerne i tekst.
Hvordan sparer Prompt Caching penge med disse modeller?
Hvis du sender den samme store kontekst (som en kodebase eller en dokument-samling) i flere API-kald, kan begge modeller cache denne prompt. Ved efterfølgende kald fakturerer de kun til "cache-hit"-raten, som falder til $0.007/MTok for DeepSeek-V4-Flash (uden for spids) og $0.015/MTok for GLM-5.3-Flash (promo), hvilket reducerer API-omkostningerne betydeligt.