
SVAR FØRSTGemini 4 er ikke officielt annonceret, og Google har ikke offentliggjort et modelkort, en API-identifikator, en prisliste eller en benchmarkrapport for den. Googles aktuelle modelkatalog er fortsat centreret omkring Gemini 3.x. Den mest forsvarlige vurdering er derfor ikke en liste over opfundne specifikationer, men en evidensbaseret vurdering af, hvad Googles næste generation skal forbedre: pålidelige langhorisont-agenter, adaptiv ræsonnering, stærkere computerbrug, mere samlet multimodalitet og bedre effektiv udnyttelse af meget store kontekster.
Hvad er Gemini 4?
Gemini 4 er arbejdsnavnet, der bruges i denne artikel for en mulig næste større generation af Googles Gemini-modeller. Google har ikke annonceret den, så betegnelsen refererer endnu ikke til en verificeret model, modelfamilie, API-identifikator eller udgivelsesplan. Her er Gemini 4 en evidensbaseret prognose bygget ud fra det officielle Gemini-modelkatalog og kapabiliteterne i Gemini 3.7 Flash.
Har Google officielt annonceret Gemini 4?
Ingen officiel Gemini 4-meddelelse kan findes i Googles udviklermodelkatalog eller i Google DeepMinds nuværende Gemini-udvalg. Det officielle Gemini API-katalog oplister stabile og preview Gemini 3-modeller, mens Google DeepMind stadig identificerer Gemini 3.5 Pro som “coming soon”. Det gør det usikkert at beskrive Gemini 4 som en bekræftet lancering på kort sigt.
Der findes heller ikke et offentligt Gemini 4-modelkort, API-model-ID, kontekstgrænse, prisliste, sikkerhedsrapport eller benchmarktabel. Gemini 4 bør behandles som et arbejdsnavn for en mulig næste generation, indtil Google offentliggør primær dokumentation. Det endelige navn og rækkefølgen af mellemliggende Gemini 3.x-udgivelser kan stadig ændre sig.
Tabel 1. Offentlig statuskontrol baseret på Googles officielle modelkatalog.
| Punkt | Offentlig status |
|---|---|
| Officiel Gemini 4-meddelelse | Ikke tilgængelig |
| Gemini 4-modelkort | Ikke tilgængelig |
| API model-ID | Ikke tilgængelig |
| Kontekstvindue | Ikke oplyst |
| Pris | Ikke oplyst |
| Benchmark scorer | Ikke oplyst |
| Nuværende officielle familie | Gemini 3.x |
| Næste annoncerede Pro-model | Gemini 3.5 Pro “coming soon” |
Hvad forventes Gemini 4 at være?
Gemini 4 er mere sandsynligvis en familie af systemer end en enkelt monolitisk model. Googles nuværende portefølje adskiller flagskibs-ræsonnering, høj-throughput inferens, dyb ræsonnering, realtidsinteraktion og mediegenerering i forskellige modeller. Familien omfatter Gemini 3.1 Pro til kompleks ræsonnering og agentiske arbejdsgange, Gemini 3.7 Flash til effektiv agentisk arbejde i skala og en specialiseret Deep Think-tilstand til videnskab, matematik og engineering.
Det mønster antyder, at en fremtidig generation kunne bevare Pro-, Flash- og effektivitetsorienterede lag, mens de koordineres via produktniveau-routing. Den største ændring er måske ikke rå modelskala. Det kan være et mere integreret system, der vælger det rette ræsonneringsbudget, påkalder værktøjer, håndterer flere modaliteter og opretholder tilstand på tværs af længere arbejdsgange.
Forventede Gemini 4-specifikationer
Det sikreste specifikationsbaseline er Googles nuværende Gemini 3.7 Flash-model. Dens officielle API-dokumentation oplister en inputgrænse på 1,048,576 tokens, en outputgrænse på 65,536 tokens, multimodale input, der spænder over tekst, billeder, video, lyd og PDF’er, samt tekstoutput.
En ansvarlig prognose bør bruge disse kapabiliteter som baseline og ikke opfinde en uunderstøttet 2M-, 5M- eller 10M-kontekst. Fordi Gemini 3.7 Flash allerede understøtter et 1M-token-kontekstvindue og 64K output, behøver Gemini 4 ikke et større “headline”-kontekstvindue for at repræsentere en meningsfuld opgradering. Effektiv recall, dybderæsonnering og værktøjs-/tilstandshåndtering vil være vigtigere.
Tabel 2. Bekræftet baseline fra Googles Gemini 3.7 Flash-dokumentation;
Gemini 4-værdier er analytiske forventninger, ikke officielle specifikationer.
| Specifikation | Gemini 3.7 Flash-baseline | Forventning for Gemini 4 | Sikkerhed |
|---|---|---|---|
| Inputkontekst | 1,048,576 tokens | Mindst 1M, med bedre effektiv recall | Høj |
| Maksimalt output | 65,536 tokens | Mindst 64K | Medium |
| Inputmodaliteter | Tekst, billede, video, lyd, PDF | Samme eller bredere indbygget støtte | Høj |
| Outputmodaliteter | Tekst | Potentielt rigere indbygget medieoutput | Medium |
| Ræsonnering | Tilpasningsbare tænkeniveauer | Mere adaptiv allokering af ræsonnering | Høj |
| Værktøjsbrug | Funktioner, søgning, kode, filer, URL-kontekst | Mere pålidelig multi-værktøjseksekvering | Høj |
| Computerbrug | Computerbrug i preview | Bredere produktionsstøtte | Medium |
| Modelfamilie | Flash-lag i Gemini 3-familien | Lignende lagdelt familie | Høj |
| API-ID | gemini-3.7-flash | Ukendt | Bekræftet ukendt |
| Pris | Offentliggjort; se aktuelle priser | Ukendt | Bekræftet ukendt |
Hvad kan være nyt i Gemini 4?
Mere pålidelige langhorisont-agenter
Google indrammer nu Gemini omkring handling såvel som intelligens. Dets nuværende kapabilitetsoverblik fremhæver langhorisont-opgaver, flertrins problemløsning, agentisk kodning og avancerede værktøjer. Næste generation vil i højere grad blive bedømt på, om den kan fuldføre en plan uden at miste tilstand, misbruge tilladelser eller gentagne gange kalde det forkerte værktøj, end på om den kan skrive en plan.
For produktionsagenter vil meningsfulde fremskridt omfatte holdbar opgavetilstand, recovery efter værktøjsfejl, bedre delegering til underagenter, eksplicitte godkendelsesporte og et revisionsspor, der forklarer, hvad systemet ændrede. Dette er systemniveau-pålidelighedsproblemer, så et Gemini 4-produkt kan kombinere modelforbedringer med stærkere orkestrering og memory-infrastruktur.
Stærkere ræsonnering og adaptiv tænkning
Google beskriver Gemini 3.7 Flash som tilføjende algoritmiske forbedringer til dets ræsonneringsfundament og tilpasselige tænkeindstillinger, der balancerer kvalitet, omkostning og latens. Gemini 4 kunne udvide den tilgang med adaptiv inferens: overfladisk ræsonnering til rutineforespørgsler, større ræsonneringsbudgetter til svære opgaver og verifikation før konsekvensrige handlinger.
Den vigtige distinktion er mellem synlige indstillinger og den faktiske allokering. En bruger kan stadig se simple hastigheds- eller tænke-kontroller, mens systemet dynamisk ruter svære delopgaver til dybere ræsonnering eller specialiserede eksperter. Ingen specifik arkitektur, parameterantal eller mixture-of-experts-design er bekræftet.
Bedre indbygget multimodal intelligens
Gemini behandler allerede tekst, billeder, lyd, video og PDF’er i et fælles workflow. Dog producerer Gemini 3.7 Flash stadig tekstoutput, mens billed-, lyd- og videogenerering håndteres af specialiserede modeller. En fremtidig generation kunne gøre koordineringen mellem disse komponenter mere sømløs, selv hvis Google fortsætter med at eksponere separate endpoints.
Nyttige forbedringer ville omfatte stærkere tidslig ræsonnering over lange videoer, bedre diagram- og interfaceforståelse, mere præcis rumlig ræsonnering og evnen til at bevare fakta og identiteter, når en opgave flytter mellem tekst, vision, lyd og genererede medier. Indbygget medieoutput forbliver en plausibel retning, ikke en bekræftet Gemini 4-funktion.
Forbedret computerbrug og værktøjseksekvering
Gemini 3.7 Flash-værktøjssættet omfatter funktionskald, kodeeksekvering, søgningsforankring, filsøgning, Maps-forankring, URL-kontekst, strukturerede outputs og preview-computerbrug. Bredden er allerede stærk; pålidelighed er det sværere næste skridt.
Gemini 4 vil skulle have bedre genkendelse af interface-tilstand, sikrere håndtering af handlinger med høj påvirkning, mere robust recovery når en side ændrer sig, og strammere koordinering mellem API-værktøjer og grafiske interfaces. Benchmarks for computerbrug antyder, at dette fortsat er et åbent konkurrencefelt snarere end en løst kapabilitet.
Mere effektiv langkontekst-ræsonnering
Et større kontekstvindue er kun nyttigt, når modellen kan hente det rette bevis og bevare relationer på tværs af hele arbejdssættet. Googles 128K MRCR-resultat forbedrede sig fra 91,8% på Gemini 3.6 Flash til 97,0% på Gemini 3.7 Flash. Det er et stærkt resultat, men det demonstrerer ikke samme retrieval-kvalitet nær det fulde 1M-token-loft, så effektiv recall forbliver et mere meningsfuldt mål for Gemini 4 end et større “headline”-vindue alene.
De mest værdifulde gevinster ville vise sig i repositorie-skala afhængighedssporing, konfliktdetektion på tværs af dokumenter, lokalisering af begivenheder i lange videoer og koordinering af midlertidig kontekst med persistent agent-memory. Bedre caching og tokeneffektivitet vil også reducere omkostningerne ved at holde store arbejdssæt aktive.
En bredere Pro-, Flash- og specialistfamilie
Googles katalog adskiller allerede flagskibs-ræsonnering, throughput, realtidsinteraktion, billedgenerering, lyd, video og robotik. Gemini 4 kan derfor komme som en etapeopdelt familie i stedet for en simultan lancering. Pro vil sandsynligvis prioritere nøjagtighed og svær ræsonnering, Flash vil optimere produktionsthroughput, og specialistmodeller vil håndtere realtid eller medietunge arbejdsbyrder.
Denne familieapproach muliggør også dynamisk routing. Applikationer kan sende de fleste forespørgsler til en hurtig model og kun eskalere de svære dele til en dyrere ræsonneringsmodel. Produkteksperimentet kan være lige så vigtigt som navnet på et enkelt checkpoint.
Bedre effektivitet, latens og driftsøkonomi
Gemini 3.7 Flash demonstrerer Googles indsats for at bringe agentiske kapabiliteter til lavere omkostninger og høj-throughput-implementeringer. Gemini 4 skal forbedre kapabilitet per dollar og kapabilitet per sekund, ikke kun top-benchmark-scorer. Sandsynlige prioriteter omfatter tokeneffektivitet, prompt-caching, hurtigere værktøjssløjfer, batch-inferens, prioriteret inferens og bedre udnyttelse af Googles infrastruktur.
Ingen Gemini 4-pris bør forudsiges før en officiel prisside foreligger. Priser kan også variere efter inputlængde, outputtokens, caching, modalitet, batchtilstand og serviceniveau, så et enkelt anslået tal ville skabe falsk præcision.
Hvilke benchmarks vil være vigtige for Gemini 4?
Gemini 4 har ingen offentliggjorte benchmarkresultater. Den mest nyttige analyse er derfor at etablere den nuværende barre. Googles Gemini 3.7 Flash-performance-tabel viser brede forbedringer over Gemini 3.6 Flash i kodning, agentisk eksekvering, enterprise-arbejdsgange, computerbrug, lang kontekst og multimodale opgaver, samtidig med at den afslører, hvor endnu en generation kan forbedre sig.
Tabel 3. Officielle scorer fra Google DeepMinds Gemini 3.7 Flash-performance-tabel.
| Benchmark | Gemini 4 | Gemini 3.7 Flash | Gemini 3.6 Flash | Ændring |
|---|---|---|---|---|
| FrontierCode 1.1 Main | Ikke publiceret | 43,6% | 34,4% | +9,2 point |
| DeepSWE v1.1 | Ikke publiceret | 65,3% | 48,6% | +16,7 point |
| Code Arena | Ikke publiceret | 1588 Elo | 1538 Elo | +50 Elo |
| Terminal-Bench 2.1 | Ikke publiceret | 85,8% | 78,0% | +7,8 point |
| AutomationBench | Ikke publiceret | 30,4% | 17,0% | +13,4 point |
| GDP.pdf | Ikke publiceret | 34,0% | 22,0% | +12,0 point |
| LVBench | Ikke publiceret | 85,4% | 84,2% | +1,2 point |
| MRCR v2 ved 128K | Ikke publiceret | 97,0% | 91,8% | +5,2 point |
| OSWorld 2.0 | Ikke publiceret | 47,9% | 33,8% | +14,1 point |
| Agent's Last Exam | Ikke publiceret | 26,3% | 24,2% | +2,1 point |
Hvad de aktuelle resultater viser
- Ræsonnering og søgning forbedredes markant. ARC-AGI-2 steg med 46,0 point og BrowseComp med 26,7 point under Googles rapporterede indstillinger.
- Agent-arbejdsgange rykkede også frem. MCP Atlas steg 15,1 point og Terminal-Bench 2.0 steg 11,6 point.
- Multimodal fremgang var ujævn. MMMU-Pro faldt med 0,5 point, så en ny generation har stadig plads til at forbedre visuel ræsonnering.
- Meget-lang-kontekst-kvalitet forbliver svær. Det rapporterede 1M-token MRCR-resultat forbedrede sig ikke mellem de to modeller.
Gemini 4 vs Gemini 3.7 Flash
Den tydeligste sammenligning er ikke en spekulativ scoretabel, men en liste over tærskler. Gemini 4 bør overgå Gemini 3.7 Flash i svær ræsonnering og samtidig bevare dets 1M-kontekststøtte, multimodal inputbredde og Flash-niveau effektivitet. Det bør også forvandle det nuværende værktøjssæt til mere pålidelig end-to-end eksekvering.
• Ræsonnering: forbedre HLE, ARC-AGI-2, GPQA og kalibrering uden at kræve maksimal compute til hver opgave.
• Kodning: øge både repositorie-niveau problem-/issue-løsning og terminaleksekvering, ikke kun kodegenereringskvaliteten.
• Agenter: øge opgavefuldførelsesrater på tværs af MCP, browsing, computerbrug og langvarige arbejdsgange.
• Multimodalitet: forbedre diagram-, video-, interface-, rumlig og krydsmodal ræsonnering.
• Kontekst: levere materielt bedre retrieval og syntese ved den øvre ende af kontekstvinduet.
• Effektivitet: reducere omkostning og latens ved dyb ræsonnering via routing, caching og adaptiv inferens.
Gemini 4 vs Gemini 3.7 Flash vs Claude Sonnet 5 vs GPT-5.6
Googles nuværende Gemini-overblik inkluderer en tværmodel-tabel for software engineering, lang kontekst, videoforståelse, ekspert-ræsonnering og agentiske opgaver. Disse leverandørrapporterede sammenligninger bruger specifikke harnesses og indstillinger, så de bør læses som et konkurrencemæssigt øjebliksbillede frem for en universel rangering.
Nuværende benchmark-barre fra Google DeepMinds Gemini-performance-tabel.
| Dimension | Gemini 4 | Gemini 3.7 Flash | Claude Sonnet 5 | GPT-5.6 Terra |
|---|---|---|---|---|
| FrontierCode 1.1 | Ikke publiceret | 43,6% | 42,7% | 41,3% |
| Terminal-Bench 2.1 | Ikke publiceret | 85,8% | 80,4% | 87,4% |
| LVBench | Ikke publiceret | 85,4% | 68,5% | 78,9% |
| MRCR v2, 128K | Ikke publiceret | 97,0% | 81,5% | 93,5% |
| HLE-Verified | Ikke publiceret | 53,6% | 31,0% | 51,1% |
| OSWorld 2.0 | Ikke publiceret | 47,9% | - | 50,2% |
| Agent's Last Exam | Ikke publiceret | 26,3% | 33,3% | 28,0% |
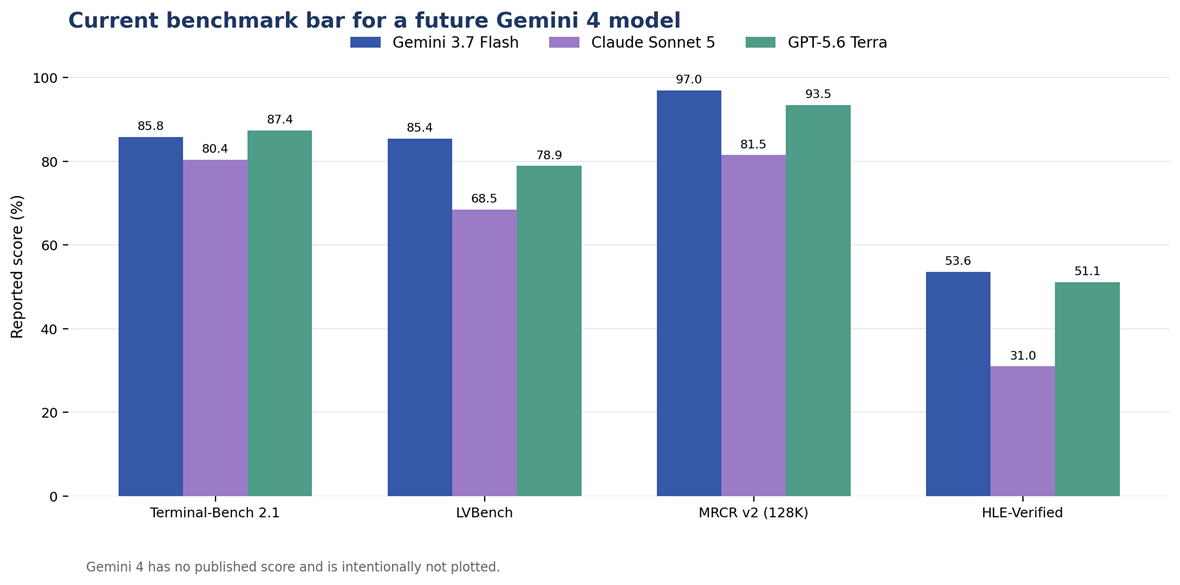
Data fra Google DeepMind's Gemini-overblik.
Multidimensionelle sammenligningsresultater
Kodning. Gemini 3.7 Flash fører det angivne FrontierCode-resultat, mens GPT-5.6 Terra fører Terminal-Bench 2.1. Gemini 4 vil skulle kombinere både høj-kvalitets kodegenerering og pålidelig terminaleksekvering for at opnå en klar kodningsfordel.
Lang kontekst. Gemini 3.7 Flash fører 128K MRCR-sammenligningen. Det sværere spørgsmål er, om Gemini 4 kan bevare den fordel nær det fulde kontekstloft, hvor Gemini 3.1 Pros rapporterede resultat forbliver meget lavere.
Videoforståelse. Gemini 3.7 Flash har den højeste angivne LVBench-score, hvilket bekræfter multimodal videoræsonnering som en Google-styrke, som Gemini 4 bør udbygge.
Computerbrug. GPT-5.6 Terra fører OSWorld 2.0 i den offentliggjorte tabel. Gemini 4 skal derfor forbedre skærmtilstandsgenkendelse, valg af handling og recovery efter uventede interfaceændringer.
Desktop-agenter. Claude Sonnet 5 fører Agent’s Last Exam i den rapporterede sammenligning. Dette fremhæver forskellen mellem at have værktøjs-API’er og at fuldføre lukkede desktop-opgaver pålideligt.
Samlet resultat. Det nuværende marked har ingen enkelt vinder på tværs af alle dimensioner. Gemini 4’s mest forsvarlige differentieringsvej er at kombinere Googles styrker i lang kontekst og video med stærkere computerbrug, terminaleksekvering og langhorisont-pålidelighed.
Hvad kunne Gemini 4 være bedst til?
Kodningsagenter i repositorie-skala
En stærkere Gemini-generation kunne inspicere store repositorier, spore afhængigheder, køre tests, redigere flere filer og verificere rettelser via terminalværktøjer. Den mest værdifulde forbedring ville være færre delvise løsninger og en klarere protokol over, hvad der blev ændret og hvorfor.
Enterprise-forskning og vidensarbejde
Gemini 4 kunne kombinere lange dokumenter, regneark, PDF’er, private enterprise-data og forankret websøgning i arbejdsgange, der producerer beslutninger frem for resuméer. Enterprise-adoption vil afhænge af tilladelser, citater, datagrænser og reproducerbar værktøjseksekvering lige så meget som rå ræsonneringskvalitet.
Multimodale operationer
Potentielle anvendelser inkluderer videoreview, interface-test, dokumentintelligens, diagramanalyse, kundesupport-triagering og felttjenestearbejdsflows, der blander billeder, lyd, video, tekst og strukturerede data. Googles Search-, Maps-, Workspace-, Cloud- og enhedsøkosystem kunne gøre disse workflows til en væsentlig differentieringsfaktor.
Videnskab og engineering
Den nuværende Deep Think-retning antyder fortsat fokus på matematik, fysik, materialer, biologi og engineering. En fremtidig model kunne hjælpe forskere med at udforske hypoteser, skrive og køre kode, analysere eksperimentelle data og gennemgå litteratur, forudsat at outputs forbliver sporbare og underlagt ekspertvalidering.
Realtidsassistenter og computerkontrol
Varianter med lavere latens kunne drive stemme-først-assistenter, der observerer en skærm, tolker dokumenter, navigerer i applikationer og koordinerer værktøjer under en live-samtale. Sikkerhedskontroller vil være essentielle, når assistenten kan sende beskeder, ændre filer, godkende køb eller ændre forretningssystemer.
Hvornår kunne Gemini 4 blive lanceret?
Der er ikke nok officielle beviser til at tildele Gemini 4 et pålideligt udgivelsesvindue. Google udvider stadig Gemini 3-familien, og dens nuværende offentlige lineup inkluderer yderligere 3.x-arbejde. En Gemini 4-meddelelse bør derfor behandles som en mulighed for en fremtidig generation frem for en bekræftet lancering på kort sigt.
Det stærkeste lanceringssignal vil ikke være et rygte eller et isoleret modelnavn. Det vil være fremkomsten af en officiel Google-meddelelse, et modelkort, en Gemini API-post, en prisside og reproducerbar benchmarkdokumentation. Indtil disse elementer findes, bør udgivelsesdato-forudsigelser forblive eksplicit spekulative.
Hvordan udviklere kan forberede sig på Gemini 4
Udviklere behøver ikke at vente på en fremtidig model for at forberede sig. En praktisk tilgang er at adskille modelnavn fra applikationslogik, definere kapabilitetstests, logge værktøjskald og opretholde fallbacks. Nuværende workflows kan prototypers med Gemini 3.7 Flash til høj-throughput agentiske opgaver eller Gemini 3.1 Pro til sværere ræsonnering.
Det følgende Python-eksempel bruger den OpenAI-kompatible chat-completions-grænseflade via CometAPI. Det bruger bevidst et aktuelt model-ID. Placer ikke en fiktiv gemini-4-identifikator i produktionskode.
Hvad kan du bruge, mens du venter på Gemini 4
Du kan allerede bruge Gemini 3.7 Flash til høj-throughput agentisk kodning, multimodal analyse og vidensarbejde, mens Gemini 3.1 Pro fortsat er nyttig til sværere ræsonnering og kreative opgaver. Claude Sonnet 5 og GPT-5.6 Terra giver yderligere sammenligningspunkter, når leverandørdiversitet, fallback-dækning eller benchmark-drevet routing er vigtigt. Hold modelnavnet uden for applikationslogikken, definér kapabilitetstests, log værktøjskald og oprethold fallbacks, så en fremtidig Gemini-model kan evalueres uden at omskrive integrationen.
Det følgende Python-eksempel bruger den OpenAI-kompatible chat-completions-grænseflade via CometAPI. Det bruger bevidst et aktuelt model-ID. Placer ikke en fiktiv gemini-4-identifikator i produktionskode.
Python
from openai import OpenAI client = OpenAI( api_key="YOUR_COMETAPI_KEY", base_url="https://api.cometapi.com/v1", ) response = client.chat.completions.create( model="gemini-3.7-flash", messages=[ { "role": "user", "content": "Analyze this task and return a structured execution plan." } ], ) print(response.choices[0].message.content)
Før du kører forespørgslen, skal du oprette en CometAPI API-nøgle og gemme den sikkert i stedet for at hardcode den. Gennemgå API-dokumentationen for understøttede endpoints og parametre. Når en fremtidig Gemini-model modtager en officiel identifikator, bør et veludformet abstraheringslag tillade applikationen at teste og tage den i brug uden at omskrive hele integrationen.
Afsluttende bemærkninger
Gemini 4 er endnu ikke et bekræftet produkt med offentliggjorte specifikationer. Det, der kan evalueres, er retningen. Googles nuværende Gemini-familie kombinerer flagskibs-ræsonnering, effektiv agentisk inferens, dyb videnskabelig tænkning, multimodale input, store kontekstvinduer og bred værktøjsstøtte. En ægte næste generation skal forvandle disse komponenter til et mere pålideligt og samlet system.
Benchmark-udfordringen er lige så klar. Gemini viser allerede styrke i langkontekst-retrieval, videoforståelse, søgning og flere ræsonneringsopgaver, men computerbrug, desktop-agenter, meget-lang-kontekst-recall og konsekvent pålidelig eksekvering forbliver konkurrencedygtige områder. Gemini 4 vil være vigtig, hvis den forbedrer disse reelle workflow-resultater, ikke blot fordi versionsnummeret ændrer sig.
Indtil Google offentliggør primær dokumentation, bør udviklere behandle præcise Gemini 4-specifikationer, priser, scorer og udgivelsesdatoer som ukendte. CometAPI-brugere kan fortsætte med at teste nuværende Gemini-modeller og opbygge leverandørneutrale evalueringspipelines, så enhver fremtidig model adopteres på evidens frem for hype.