
GPT-6 Astra og Claude Fable 5.1 dukkede op med kun to dages mellemrum: Astra blev lanceret den 3. september, mens Fable 5.1 blev lanceret den 1. september. Trods den tætte timing viser de vigtigste forskelle sig i benchmark-profil, værktøjseksekvering og cache-økonomi.
Lighederne stopper, når arbejdet starter. OpenAIs lanceringsevalueringer placerer Astra foran på flere test af kodning, videnskab, computerbrug og professionelt arbejde, mens Anthropics offentliggjorte benchmarks viser, at Fable 5.1 fører på Humanity’s Last Exam. Fable 5.1 har også en lavere officiel cache-læsepris, som mærkbart kan ændre økonomien for langvarige agenter.
Det nyttige spørgsmål er derfor ikke blot, hvilken model der har den højeste benchmarkscore. Det praktiske spørgsmål er hvilken model der fuldfører din arbejdsbelastning mere pålideligt og økonomisk.
Kort svar: Astra er det stærkere standardvalg til eksekveringstunge agenter, kodning, computerbrug og værktøjsdrevne videnskabelige arbejdsgange. Fable 5.1 er især overbevisende til bred, vanskelig ræsonnering, langvarigt asynkront arbejde og applikationer, der gentagne gange genbruger meget store cachede kontekster.
GPT-6 Astra vs Claude Fable 5.1 i et overblik
| Specifikation | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Udvikler | OpenAI | Anthropic |
| Udgivelsesdato | 3. sep. 2026 | 1. sep. 2026 |
| API-model-ID | gpt-6-astra | claude-fable-5-1 |
| Kontekstvindue | 1.050.000 tokens | 1.000.000 tokens |
| Maksimal output | 128.000 tokens | 128.000 tokens |
| Inputmodaliteter | Tekst, billeder | Tekst, billeder |
| Outputmodalitet | Tekst | Tekst |
| Vidensgrænse | 30. apr. 2026 | jun. 2026 |
| Ræsonnering | low / medium / high / xhigh / max | Adaptive, always on |
| Standardindsats | — | high |
| Officiel input/output | $10 / $50 pr. MTok | $10 / $50 pr. MTok |
| Officiel cache-læsning | $1 / MTok | $0.25 / MTok |
| Langkontekstpriser | Højere takst over 272K input | Standardtakst på tværs af 1M kontekst |
| Primær positionering | End-to-end eksekvering, kodning, computerbrug | Krævende ræsonnering, langhorizon-agenter |
Oplysninger og priser verificeret den 7. september 2026. Udbyderspecifikationer og priser kan ændre sig efter publicering.
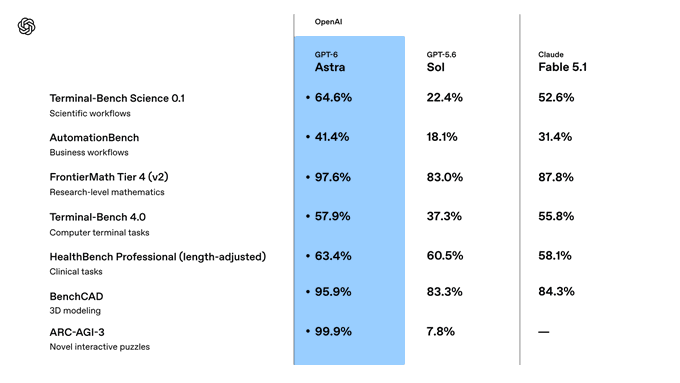
Kilde: OpenAI officiel benchmark
Hvad er GPT-6 Astra?
OpenAI introducerede GPT-6 Astra den 3. september 2026 som sin mest kapable model til vanskelig, end-to-end professionelt arbejde. I stedet for at fokusere på isoleret spørgsmål-svar er Astra designet til at fuldføre komplekse arbejdsgange, der kombinerer ræsonnering, kodning, research, computerinteraktion og dokumentoprettelse. Den kan arbejde på tværs af flere trin, bruge tilvejebragte værktøjer og kontekst og tilpasse sig, når brugere ændrer krav eller retning under en opgave. OpenAIs udgivelsesnoter fremhæver applikationer såsom at producere dokumenter, regneark og præsentationer, der følger specifikke instruktioner og skabeloner.
Modellen tilbyder et kontekstvindue på 1.050.000 tokens og et maksimalt output på 128.000 tokens, hvilket gør det muligt at bearbejde store kodebaser, omfattende dokumentsamlinger eller langvarige agenthistorikker i én arbejdsgang. Dens ræsonneringsindsats kan konfigureres til low, medium, high, xhigh eller max, så udviklere kan balancere svartid og beregningsdybde efter opgavens sværhed.
Hvad er Claude Fable 5.1?
Anthropic Anthropic udgav Claude Fable 5.1 den 1. september 2026 som sin mest avancerede model til krævende ræsonnering og langhorizon agentisk arbejde. Den bygger på Claude Fable 5 med forbedringer i langvarige kodningsopgaver, flertrins research og oprettelse eller analyse af dokumenter, regneark og præsentationer. Anthropic anbefaler den til arbejdsbelastninger, hvor vedvarende ræsonnering og pålidelig eksekvering betyder mere end rå svartid—især når Claude Opus 5 ved højere indsatsindstillinger ikke leverer tilstrækkelig ydeevne.
Ifølge den officielle Claude Fable 5.1-specifikation tilbyder modellen et kontekstvindue på 1 million tokens og et maksimalt output på 128.000 tokens. Det giver kapacitet nok til at gennemgå store repositories, lange forretningsoptegnelser, forskningssamlinger eller udvidede agentforløb uden aggressiv opdeling af materialet i separate anmodninger. Den accepterer tekst- og billedinput og producerer tekstoutput, med en vidensgrænse i juni 2026.
Benchmark-sammenligning: Astra vinder flere rækker, men ikke alle vigtige
En benchmark-sammenligning mellem konkurrerende udbydere kræver mere forsigtighed end en normal generation-til-generation-sammenligning. OpenAI testede Fable 5.1 på flere Astra-lanceringsevalueringer, mens Anthropic brugte sine egne rammer og, i nogle tilfælde, en nyere opgaveudgivelse. Det gør de reneste sammenligninger til de tests, hvor definitioner og rapporterede indstillinger stemmer tilstrækkeligt overens til at understøtte en direkte beslutning.
GPT-6 Astra vs Claude Fable 5.1: hvilken er bedre til kodning og agentisk software
Kodning er et af Astras klare styrkeområder. På OpenAIs offentliggjorte lanceringstabel scorer Astra 57,9% mod 55,8% på Terminal-Bench 4.0, 74,1% mod 67,4% på DeepSWE v1.1 og 63,9% mod 57,8% på en intern database-migreringsevaluering.
| Kodningsbenchmark | GPT-6 Astra | Claude Fable 5.1 | Resultat |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,9% | 55,8% | Astra +2,1 point |
| DeepSWE v1.1 | 74,1% | 67,4% | Astra +6,7 point |
| FrontierCode 1.1 Extended | 64,5% | 63,6% | Astra +0,9 point |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Astra +2,4 point |
| Database migration, internal | 63,9% | 57,8% | Astra +6,1 point |
Astra repræsenterer et væsentligt gennembrud for eksekveringsfokuserede modeller: dens offentliggjorte resultater fører Fable 5.1 på Terminal-Bench 4.0, DeepSWE v1.1 og database-migreringsevalueringen, hvilket understreger dens fordel, når kode skal eksekveres, testes og verificeres på tværs af værktøjer.
Konklusionen er ikke, at Fable 5.1 er svag til kodning. Anthropic beskriver den som sin mest kapable model til ambitiøse kodningsprojekter, og dens egen CursorBench 3.2.0-resultat når 73,4%. Forskellen er arbejdsbelastningens form: Astras fordel bliver mere overbevisende, når kodning blandes med shell-eksekvering, repo-navigation, verifikation og andre værktøjer.
Vinder for eksekveringstung software engineering: Astra. En langvarig repository-agent er en tættere vurdering, fordi vedvarende kohærens, cache-adfærd og token-effektivitet kan betyde lige så meget som én benchmarkscore.
GPT-6 Astra vs Fable 5.1: hvilken er bedre til ræsonnering og videnskab
Ræsonneringssammenligningen er mere interessant, fordi der ikke er en total sejr. OpenAIs offentliggjorte evalueringer rapporterer Astra på 97,6% på FrontierMath Tier 4, 96,0% på GPQA Diamond og 64,6% på Terminal-Bench Science 0.1. Fable 5.1 registrerer henholdsvis 87,8%, 93,7% og 52,6% i den samme sammenligning.
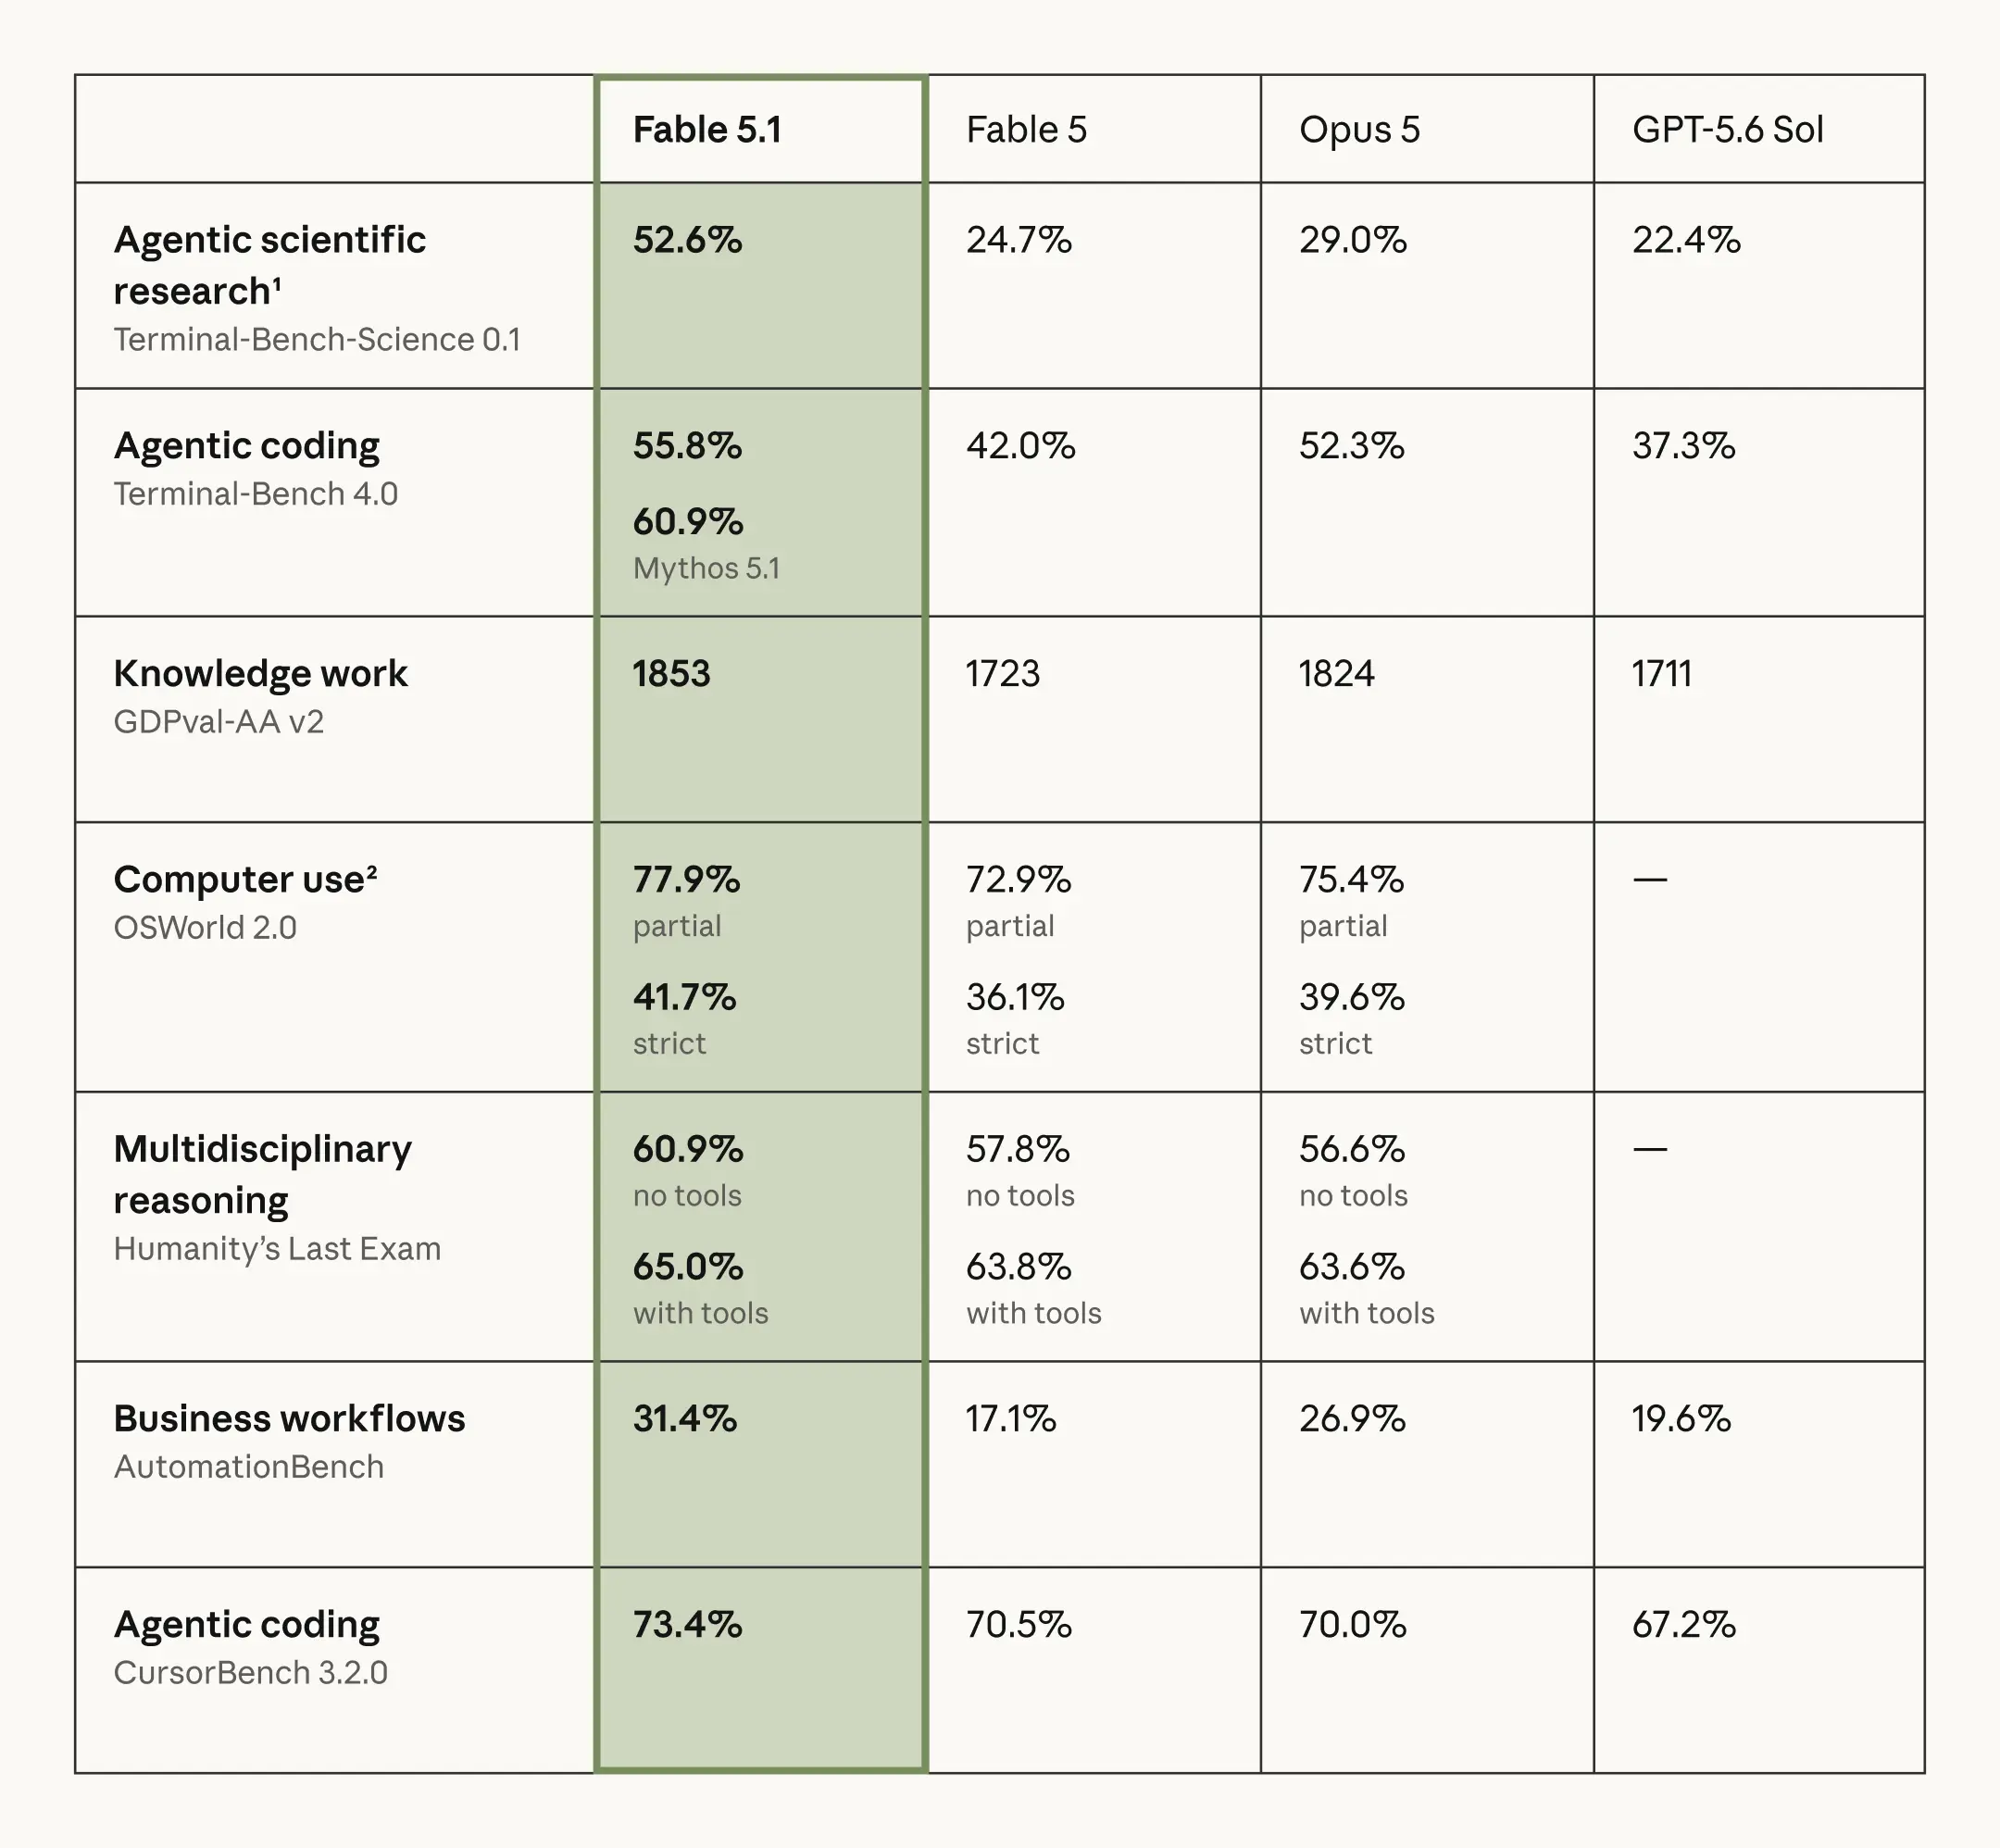
Fable 5.1 vender resultatet på Humanity’s Last Exam med værktøjer og scorer 65,0% mod Astras 57,2%. Anthropics officielle benchmarktabel rapporterer uafhængigt det samme 65,0%-resultat for Fable 5.1.
| Ræsonnerings-/videnskabsbenchmark | GPT-6 Astra | Claude Fable 5.1 | Vinder |
|---|---|---|---|
| FrontierMath Tier 4 v2 | 97,6% | 87,8% | Astra |
| GPQA Diamond | 96,0% | 93,7% | Astra |
| Terminal-Bench Science 0.1 | 64,6% | 52,6% | Astra |
| Humanity's Last Exam, med værktøjer | 57,2% | 65,0% | Fable 5.1 |
| Artificial Analysis Intelligence Index | 61,2 | 65,7 | Fable 5.1 |
Denne skelnen er vigtig. FrontierMath og Terminal-Bench Science betoner specialiseret matematisk eller videnskabelig problemløsning, især når ræsonnering interagerer med værktøjer og eksterne miljøer. Humanity’s Last Exam er bredere og tværfaglig. En praktisk tolkning er, at Astra ser stærkere ud ved dybt teknisk, værktøjs-eksekveret ræsonnering, mens Fable 5.1 bevarer en fordel på bredere frontier-ræsonnerings-evalueringer.
Kilde: Anthropic officiel benchmark
Computerbrug og professionelt arbejde favoriserer GPT-6 Astra
En direkte Astra-versus-Fable 5.1 OSWorld-sammenligning ville være vildledende. Anthropics benchmarknote siger, at Fable 5.1 bruger forfatternes opgaveudgivelse fra august 2026. Deres diagram rapporterer 77,9% delvis og 41,7% stringent, men disse tal er ikke ækvivalente med OpenAI 72,6%-resultatet.
| Professionel benchmark | GPT-6 Astra | Claude Fable 5.1 | Resultat |
|---|---|---|---|
| AutomationBench | 41,4% | 31,4% | Astra +10,0 point |
| BenchCAD | 95,9% | 84,3% | Astra +11,6 point |
| Terminal-Bench Science | 64,6% | 52,6% | Astra +12,0 point |
OpenAI træner også specifikt Astra omkring produktion af dokumenter, regneark og præsentationer og siger, at den er designet til at gennemføre flertrins professionelle arbejdsgange frem for blot at generere tekstkomponenten. Fable 5.1 er også bygget til langvarige agenter, browserbetjening, research, kodning og professionelle dokument-arbejdsgange, men Astra har aktuelt stærkere offentliggjort bevis for computermedieret eksekvering og artefaktproduktion.
Vinder for computerbrugsagenter og professionel automatisering: Astra.
GPT-6 Astra vs Claude Fable 5.1 lang kontekst: 1,05M vs 1M er den forkerte sammenligning
Astra har teknisk det større kontekstvindue: 1,05 millioner tokens mod Fable 5.1s 1 million. Den 5% forskel vil næppe afgøre en produktionsarkitektur. Prissætning inden for kontekstvinduet kan.
OpenAIs langkontekst-prisregel gælder, når en anmodning indeholder mere end 272K inputtokens: input- og cachetakster fordobles, mens outputtaksten stiger med 1,5 gange for hele anmodningen. Astras effektive takster bliver derfor $20 input, $2 cachet input og $75 output pr. MTok.
Fable 5.1-specifikationen dokumenterer et kontekstvindue på 1M med $10 input, $50 output og $0,25 cachelæsninger pr. MTok. For applikationer, der rutinemæssigt indlæser 300K, 500K eller 900K tokens i en anmodning, fortæller den nominelle kontekststørrelse derfor kun halvdelen af historien.
For meget store kontekster har Fable 5.1 de renere ratecard-økonomier, især når en stor del af konteksten kan caches.
GPT-6 Astra vs Claude Fable 5.1 prissætning: samme overskriftspris, meget forskellige agentøkonomier
Ved officielle Standard-takster starter de to modeller i præcis uafgjort på ucachet tekstinput og -output.
| Priskomponent | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input / MTok | $10,00 | $10,00 |
| Output / MTok | $50,00 | $50,00 |
| 5-minutters cache-write / MTok | $12,50 | $12,50 |
| Cache-læsning / MTok | $1,00 | $0,25 |
| Batch input/output-rabat | 50% | 50% |
| Langkontekst-tillæg | Over 272K input | Ingen på tværs af standard 1M kontekst |
Det nøgletal er ikke $10 eller $50. Det er $0,25. Anthropic sænkede Fable 5.1s cache-læsepris til $0,25 pr. million tokens, en fjerdedel af Astras standardpris på $1 for cached input og en ottendedel af Astras $2 langkontekst-cachepris.
Det kan betyde enormt meget for en agentløkke. En langvarig applikation kan gentagne gange bære en stor systemprompt, værktøjsdefinitioner, repo-kontekst og referencedokumenter på tværs af dusinvis af ture. Når den stabile præfiks gentagne gange læses fra cache, forstærker cache-prissætning på en måde, som en enkelt-turnus-benchmark aldrig indfanger.
Anthropics arbejdsbelastningsestimat siger, at den lavere cachepris kan reducere typiske Fable 5.1-arbejdsbelastningsomkostninger med cirka 25% og stærkt agentiske arbejdsbelastningsomkostninger med op til omkring 45%. Dette er udbyderestimater frem for universelle garantier, men de viser, hvorfor cache-økonomi fortjener sin egen sammenligningsdimension.
Gør det Fable 5.1 billigere?
Ikke automatisk. En model med dyrere tokens kan stadig give en lavere regning, hvis den løser opgaven med færre tokens, færre retries, færre mislykkede værktøjskald eller mindre væg-ur-tid. Derfor er omkostning pr. vellykket opgave mere informativ end pris pr. million tokens.
Den praktiske prisdom er delt: Fable 5.1 vinder ratecardet for cache-tunge og meget langkontekst-arbejdsbelastninger. Astra kan stadig vinde omkostning pr. fuldført opgave, når dens eksekveringsfordel væsentligt reducerer retries, tokenforbrug eller runtime.
CometAPI-prissætning indsnævrer beslutningen til arbejdsbelastningskvalitet
Begge modeller er tilgængelige via CometAPI. GPT-6 Astra API i CometAPI starter ved $8 pr. million inputtokens, mens Claude Fable 5.1 API i CometAPI starter ved samme $8 inputtakst. Det er 20% under udbydernes grundlæggende inputtakst.
| API-prissætning | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Officiel input/output | $10 / $50 | $10 / $50 |
| CometAPI input/output | $8 / $40 | $8 / $40 |
| Reduktion vs officiel grundtakst | 20% | 20% |
Det skaber en nyttig produktionsopsætning: i stedet for at beslutte udelukkende ud fra offentlige benchmarktabeller kan udviklere evaluere den samme arbejdsbelastning mod begge model-ID’er gennem ét API-miljø og sammenligne accept-rate, tokenforbrug, latenstid, værktøjsfejl og samlet forbrug. Priser og faktureringsregler kan ændre sig, så produktionsbudgettering bør bruge den live API-konfiguration frem for at hardkode værdierne i denne artikel.
Værktøjsbrug og agentdesign: samme mål, forskellig filosofi
Begge modeller er designet til agenter, men deres API’er udtrykker forskellige filosofier. GPT-6 Astra understøtter et værktøjsrigt Responses API-miljø. OpenAIs understøttede værktøjssæt omfatter websøgningsværktøj, filesøgning, billedgenerering, kodefortolker, hosted shell, Apply Patch, computerbrug, MCP og værktøjssøgning. Konfigurerbar ræsonneringsindsats lader en applikation beslutte, hvor meget compute der skal bruges.
Fable 5.1s ræsonneringsmodel er anderledes: adaptiv tænkning er altid aktiveret, med effort brugt til at styre dybde. Anthropic har også tilføjet per-besked-effort, tur-afgrænsede systemmeddelelser og læsbare statusopdateringer mellem værktøjskald, som er særligt nyttige i lange autonome sessioner.
GPT-6 Astra føles derfor optimeret omkring værktøjsbredde og end-to-end miljøkontrol, mens Fable 5.1 føles optimeret omkring vedvarende langhorizon-ræsonnering og agent-kontinuitet. Ingen arkitekturstil er universelt overlegen; din orkestreringslag betyder lige så meget som den rå model.
Hvorfor sikkerhed og deployeringsbegrænsninger betyder noget for GPT-6 Astra og Claude Fable 5.1
OpenAI beskriver Astra som sin første model, der når virksomhedens Critical-cybersikkerhedstærskel og implementerer yderligere værn omkring højkapabilitets-arbejdsgange. Den samme meddelelse beskriver produktionsmonitorering og afbrydelse af opgaver, når en agent kan overskride sin autoriserede ramme.
Fable 5.1 bruger en anden værnsarkitektur. Anthropic oplyser, at nogle cyber- og biologianmodninger identificeret af dets værn kan routes til mindre kapable modeller. Det betyder, at en produktionsscore kan afspejle både den underliggende model og værnene omkring den.
Dette er endnu en grund til, at kryds-udbyder-benchmarktabeller ikke bør behandles som fuldstændig kontrollerede laboratorie-sammenligninger. Enterprise-evalueringer bør inkludere afslag, fallback-adfærd, opgaveafbrydelse, revisionskrav, dataopbevaring og privatlivskontroller frem for først at overveje dem efter modelvalg.
GPT-6 Astra vs Claude Fable 5.1: hvilken model skal du vælge?
| Arbejdsbelastning | Anbefalet model | Hvorfor |
|---|---|---|
| Autonom computerbrugsagent | Astra | Stærkere offentliggjorte beviser for computerbrug og professionel eksekvering |
| Agentisk terminal/software engineering | Astra | Leder Terminal-Bench, DeepSWE og database-migreringsresultater |
| Videnskabelige værktøjs-arbejdsgange | Astra | Stærke FrontierMath-, GPQA- og Terminal-Bench Science-resultater |
| Bred frontier-ræsonnering | Fable 5.1 | Leder HLE med værktøjer og Intelligence Index |
| Langvarig asynkron agent | Fable 5.1 | Designet omkring langhorizon agentisk arbejde og statusopdateringer |
| 300K–1M-token-anmodninger | Fable 5.1 | Undgår Astras 272K langkontekst-tillæg i standardprissætning |
| Tung prompt-cache-genbrug | Fable 5.1 | $0,25/MTok officielle cache-læsninger |
| Dokument-/regneark-/præsentations-automatisering | Astra | Stærk positionering på professionelt arbejde og artefaktgenerering |
| Stor repository med gentaget cachet kontekst | Fable 5.1 | Cache-økonomi kan dominere gentagne agent-løkker |
| Blandede produktionsarbejdsbelastninger | Test begge | Forskellige styrker gør routing af arbejdsbelastning mere nyttig end en universal vinder |
Hvis din applikation beder modellen om at handle, bør Astra som regel være den første model at teste. Hvis applikationen beder modellen om at tænke længe over en meget stor og gentagne gange genbrugt kontekst, fortjener Fable 5.1 lige så meget eller mere opmærksomhed.
GPT-6 Astra vs Claude Fable 5.1: hvilken er bedst overordnet?
Der er ikke et rent 10–0-resultat. Astra vinder flere af de direkte sammenlignelige, udbyder-offentliggjorte rækker, med særlig konsekvente fordele på tværs af kodningseksekvering, videnskabelig tooling, computerbrug og professionel automatisering. For udviklere, der bygger en agent, der skal betjene software snarere end blot diskutere, hvad der skal gøres, er det en væsentlig fordel.
Fable 5.1s sejre er smallere, men strategisk vigtige. Dets 65,0% Humanity’s Last Exam-resultat og stærkere Intelligence Index-score viser, at Astra ikke blot dominerer generel ræsonnering. Fable 5.1 har også en strukturel prisfordel for cache-tunge agenter og anmodninger, der bruger en stor del af million-token-konteksten.
Den dybere forskydning er, at udvælgelse af frontier-modeller bevæger sig væk fra “hvilken chatbot giver det klogeste svar?” mod “hvilket system fuldfører dette job korrekt til den laveste totalomkostning?”
Hvordan man sammenligner dem til din egen applikation
En offentlig leaderboard bør indsnævre din shortlist, ikke træffe din produktionsbeslutning. Byg et fast evalueringssæt ud fra reelle opgaver. Kør identisk inputmateriale mod begge modeller, bevar ækvivalente værktøjstilladelser, og mål ikke kun, om det endelige svar ser godt ud, men om opgaven faktisk lykkes.
For en agentisk applikation inkluderer nyttige metrics samlet opgave-succes, menneskelig accept-rate, værktøjskald-fejl, retries, tid til fuldførelse, ucachet input, cache-læsninger, outputtokens og samlet API-forbrug.
En simpel deployeringsmetric er samlet API-forbrug ÷ accepterede fuldførte opgaver.
Det tal kan vende en beslutning baseret på benchmark. En model der tager mere pr. token kan være billigere, hvis den behøver færre retries. En model med billig caching kan blive dramatisk billigere over en 50-turnus agentløkke. En model der scorer højere isoleret kan tabe, når dine værktøjer, retrieval-lag og reelle acceptkriterier introduceres.
Astra og Fable 5.1 er tilgængelige via CometAPI; den stærkeste produktionsstrategi er ikke nødvendigvis at binde sig permanent til én udbyder. Hold modellen konfigurerbar, evaluer begge mod samme acceptkriterier og rout hver arbejdsbelastning til den model, der faktisk præsterer bedst.
FAQs
Er GPT-6 Astra bedre end Claude Fable 5.1?
Astra er stærkere på flere direkte sammenlignelige kodnings-, videnskabs- og professionelt-arbejde-benchmarks, herunder Terminal-Bench, DeepSWE, FrontierMath og AutomationBench. Fable 5.1 fører på Humanity’s Last Exam med værktøjer og Artificial Analysis Intelligence Index. Ingen model vinder alle dimensioner.
Hvilken model er bedre til kodning?
GPT-6 Astra er den bedre model til kodning, især til agentisk kodning og eksekvering. OpenAIs offentliggjorte sammenligning rapporterer 57,9% for Astra mod 55,8% for Fable 5.1 på Terminal-Bench 4.0, med større Astra-føringer på DeepSWE og database-migreringsevalueringen. Claude Fable 5.1 forbliver særdeles konkurrencedygtig til langvarigt repository-arbejde, men Astra har den stærkere samlede kodnings evidens.
Hvilken model er bedre til lang kontekst?
Claude Fable 5.1 er det bedre valg til langkontekst-arbejdsbelastninger, især til meget store anmodninger og gentagen prompt-cache-brug. Begge modeller tilbyder omtrent én million tokens kontekst, men GPT-6 Astra anvender højere takster, når input overstiger 272K tokens, mens Fable 5.1 opretholder en enklere takststruktur og tilbyder væsentligt billigere prompt-cache-læsninger.
Hvilken er billigst?
Ingen model er billigere ved standard basis-takst—de er lige; Claude Fable 5.1 er billigere for cache-tunge og meget langkontekst-arbejdsbelastninger. Officiel basisprissætning er $10 pr. million inputtokens og $50 pr. million outputtokens for begge modeller. Via CometAPI starter både GPT-6 Astra og Fable 5.1 aktuelt ved $8 pr. million inputtokens og $40 pr. million outputtokens. Fable 5.1 får omkostningsfordelen, når prompt-cache-læsninger eller Astras langkontekst-tillæg bliver materielle.
Skal udviklere kun bruge én af dem?
Ikke nødvendigvis. Deres styrker er tilstrækkeligt komplementære til, at en multi-model-evaluering eller routing-strategi kan overgå at vælge én model til hver anmodning. Test reelle produktionsarbejdsbelastninger og sammenlign omkostning pr. accepteret fuldført opgave frem for at basere dig på én enkelt benchmarkscore.