
TLDR Den 28. juni 2026 meddelte Elon Musk, at Grok 4.5 — bygget på xAI’s nye V9-basismodel med 1.5 billioner parametre og supplerende træningsdata fra Cursor AI-kodingsplatformen — gik i privat beta hos SpaceX og Tesla. Interne evalueringer hævder en ydeevne “tæt på, måske overgår” Anthropics Claude Opus, med løbende RLHF- og Grok Build-forbedringer.
For udviklere og virksomheder, der integrerer frontier-modeller i dag, tilbyder CometAPI øjeblikkelig, omkostningseffektiv adgang til Grok 4.3 (og andre xAI-modeller) via et enkelt OpenAI-kompatibelt endpoint sammen med 500+ modeller fra Anthropic, OpenAI, Google og flere — ofte med 20%+ besparelser sammenlignet med direkte priser, uden prompt-logning til privatlivsfokuserede arbejdsgange.
Vigtigste pointer
- En citeret linje tilskrevet Elon Musk siger, at Grok 4.5 er i privat beta hos SpaceX og Tesla, cirkuleret af AshutoshShrivastava (https://x.com/ai_for_success/status/2071192465319858576).
- TestingCatalog rapporterer (https://x.com/testingcatalog/status/2071198330906878287), at Grok 4.5 bygger på en 1.5T V9-basismodel med Cursor-data tilføjet i supplerende træning.
- Det eneste evidensmærkede signal er Mark Kretschmanns screenshot fra 28. juni (https://x.com/mark_k/status/2071119902841131380), der viser, at versionsnummeret for Grok / Cursor Composer 3 blev fjernet fra xAI-menuer.
- Der er ikke offentliggjort benchmark-scorer, priser, kontekstvindue eller API-timing i dette signal-sæt.
- Historien om Cursor-træningsdata har bygget sig op siden 16. juni på mindst tre konti, med Mark Kretschmann der kobler Grok 5 til et par på 6T og 10T parametre i Fable 5-vægklassen (https://x.com/mark_k/status/2068745721386267133).
Udgivelsesdato for Grok 4.5
Grok 4.5 gik i privat beta den 28. juni 2026 og er planlagt til offentlig udgivelse den 9. juli 2026 (i morgen pr. 8. juli).
Den bygger på tidligere versioner som Grok 4 (udgivet omkring juli 2025) og Grok 4.3. Den burde blive tilgængelig for berettigede brugere (f.eks. SuperGrok/Premium+ abonnenter) kort efter annonceringen. For API,CometAPI vil blive integreret med grok 4.5 API umiddelbart efter udgivelsen og vil tilbyde en lavere anskaffelsespris.
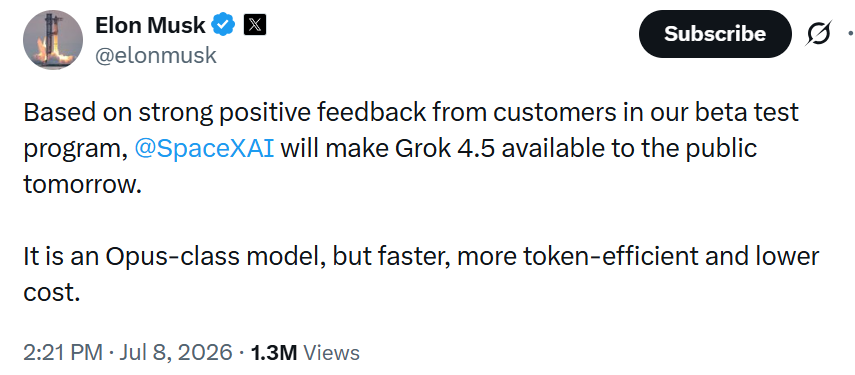
Public Release: I dag (8. juli 2026), Musk posted that, baseret på positiv beta-feedback, vil SpaceXAI / xAI gøre Grok 4.5 tilgængelig for offentligheden i morgen (9. juli). Den beskrives som en "Opus-klasse" model, der er hurtigere, mere token-effektiv og billigere end sammenlignelige modeller.
Signaler fra arkitekturen i grok 4.5: Hvad vi har set
Den primære kilde er Elon Musks egen X-post (https://x.com/elonmusk/status/2071184354756477041) den 28. juni 2026:
“Grok 4.5, based on our 1.5T V9 foundation model, with Cursor data added in supplemental training, is now in private beta at SpaceX & Tesla. Early evals show performance close to, perhaps exceeding Opus. RL is continuing to significantly improve the model, and the Grok Build harness gets better every day…”
Dette blev forstærket af konti som @testingcatalog og @ai_for_success, med arkitekturdetaljer om 1.5T V9 og Cursor-integration, "Grok 4.5 is based on 1.5T V9 foundation model, with Cursor data added in supplemental training.".
Cursor-signal: xAI/SpaceX’s bevægelse mod at opkøbe eller indgå et dybt partnerskab med Cursor (Anysphere) for ~$60B giver en rig kilde til ægte udvikler-IDE-spor, agentiske arbejdsgange og data for redigering af flere filer. Denne supplerende træning (efter prætræning) differentierer Grok 4.5 til kodeopgaver, selvom eksperter bemærker, at initial integration i prætræning ville være endnu stærkere.

Kilde: @mark_k
Menu-tilstands-signalet er smallere, men mere evidenslignende. Ifølge Mark Kretschmanns post fra 28. juni (https://x.com/mark_k/status/2071119902841131380) blev versionsnummeret for Grok 1.5T / Cursor Composer 3-modellen fjernet fra xAI-menuer om morgenen den 28. juni. Han beskriver det som et mønster, der kan gå forud for xAI-udgivelser. Dette er ikke en formel lancering, men det er mere konkret end et repostet performance-krav, fordi det er bundet til et screenshot.
Det senere kanariske signal skubbede historien frem. TestingCatalog opdagede (https://x.com/testingcatalog/status/2074214554523816272) en Grok web-UI-streng, der læser "Unlock the full power of Chat with Grok 4.5." Den slags spor dukker ofte op før en produktændring, men den kan også blive opgivet, forsinket eller gemt bag en begrænset udrulning.
Hvad vi med rimelighed kan forvente af Grok 4.5
Givet xAI’s udvikling og læk-detaljerne er her et jordnært outlook:
- Forbedret kodning og agentisk ydeevne: Supplerende Cursor-data bør løfte SWE-Bench-lignende opgaver, flerfil-ræsonnering og virkelige udvikler-arbejdsgange. Forvent styrker i teknisk ræsonnering, debugging og engineering i produktionsskala — områder på linje med SpaceX/Tesla-brugsscenarier.
- Skala og effektivitet: Ved 1.5T parametre på optimeret V9 (Blackwell-æra GPU’er via Colossus) balancerer den rå kraft med inferensmulighed. RL-forbedringer efter beta kan indsnævre huller i ræsonnering.
- Hurtig iteration: Musk nævnte månedlige nye modeller fra bunden. Grok 4.5 fungerer som et springbræt, med en større 2T+ kørsel, der allerede inkorporerer Cursor-data fra prætræning.
- Multimodal og værktøjsbrug: Oven på tidligere Grok-kapabiliteter (vision, søgning, Grok Build) kan man forvente udvidede agentiske funktioner.
- Offentlig udrulningstidslinje: UI-spor antyder dage til uger for bredere adgang. Historiske mønstre indikerer 1–2 uger fra teaser til preview.
For produktion i dag: Mens du venter, kan du integrere via CometAPI’s Grok-endpoints. Deres OpenAI-kompatible API understøtter problemfri skift og tilbyder besparelser (f.eks. Grok 4 til reducerede priser), perfekt til at bygge apps, der nemt kan opgraderes til Grok 4.5. Tjek CometAPI Grok-tilbud (https://www.cometapi.com/) for detaljer.
De hårde fakta kommer fra officielle dokumenter, og de officielle dokumenter er stille om Grok 4.5. xAI’s modelside (https://docs.x.ai/developers/models) lister grok-build-0.1 som en kodningsmodel, der er trænet specifikt til agentiske kodningsarbejdsgange, med et kontekstvindue på 256k og $1.00 / $2.00 pr. 1M input/output tokens i xAI-prisdokumenterne (https://docs.x.ai/developers/pricing). Den lister grok-4.3 til generel brug, med et 1M-token kontekstvindue og $1.25 / $2.50 pr. 1M input/output tokens. xAI’s side for rate limits (https://docs.x.ai/developers/rate-limits) inkluderer Grok 4.3 og Grok Build 0.1, og xAI’s function-calling-dokumenter (https://docs.x.ai/developers/tools/function-calling) forklarer den nuværende værktøjsoverflade, men ingen af disse sider lister Grok 4.5.
Den mangel betyder noget. En model kan være reel internt og stadig ikke være brugbar via den offentlige API. Teams bør adskille "xAI tester måske dette" fra "udviklere kan implementere dette".
Offentlig diskussion er stadig nyttig til et snævrere formål: den fortæller os, hvad buildere bør teste først.
Opfølgende spørgsmål er mere nyttige end hype:
- Reducerer Cursor-stil data mislykkede patch-forsøg?
- Navigerer Grok 4.5 i repositories bedre end Grok 4.3 eller Grok Build?
- Slår den Claude Opus 4.8 på reelle multi-fil opgaver?
- Kræver den færre retries, færre værktøjskald eller mindre menneskelig gennemgang?
- Forbliver den konkurrencedygtig, når latenstid og outputlængde måles?
- Generaliserer den uden for Cursor-lignende arbejdsgange?
Behandl X-tråde som signaler, ikke specifikationer. Specifikationerne begynder, når xAI opdaterer sine modeldokumenter eller release notes.
Grok 4.5 vs Claude Opus: Forventet ydeevne
Det reelle routing-spørgsmål er ikke "Er Grok 4.5 spændende?" Det er: Bør en kodnings- eller agent-arbejdsgang bruge Grok 4.5 i stedet for Claude Opus 4.8, når Grok 4.5 bliver tilgængelig?
Claude Opus 4.8 er den rene baseline, fordi Anthropic har offentlig dokumentation og benchmark-data. Anthropics modeloversigt (https://platform.claude.com/docs/en/about-claude/models/overview) lister Claude Opus 4.8 med et 1M-token kontekstvindue og 128k maks. output. Anthropics Opus 4.8-annoncering (https://www.anthropic.com/news/claude-opus-4-8) positionerer den omkring komplekst agentisk arbejde, kodning og virksomhedsbrugsscenarier, mens prissiden (https://platform.claude.com/docs/en/about-claude/pricing) giver den officielle API-prisbaseline.
Opus 4.8-systemkortet giver faktiske tal. I evalueringsoversigten rapporterer Opus 4.8 88.6 på SWE-bench Verified, 69.2 på SWE-bench Pro, 74.6 på Terminal-Bench 2.1, 83.4 på OSWorld-Verified og 1890 på GDPval-AA.
Forventede styrker ved Grok 4.5:
- Kodningsspecialisering: Cursor-data giver en unik fordel i virkelige udviklerspor, som syntetiske benchmarks undervurderer. Tidligere Grok-modeller var allerede konkurrencedygtige på kodning; dette kan skubbe den foran på agentiske opgaver.
- Skala og hastighed: 1.5T parametre + Colossus-infrastruktur kan give stærk throughput og håndtering af langt kontekstvindue.
- Pris/tilgængelighed: xAI-modeller er ofte prissat konkurrencedygtigt; CometAPI reducerer yderligere omkostninger (f.eks. Grok 4-serien med betydelige besparelser).
Claude Opus-styrker (nuværende flagskib):
- Dokumenterede benchmarks: Høj SWE-Bench (~80%+ i nyere versioner), stærk ræsonnering (GPQA, ARC-AGI), fremragende instruktionsfølgning og sikkerhed.
- Modent økosystem: Robust værktøjsbrug, artefakter og enterprise-funktioner.
Sammenligningstabel (projiceret/afledt baseret på tilgængelige data)
| Aspekt | Grok 4.5 (Forventet) | Claude Opus (Nuværende) |
|---|---|---|
| Parametre | 1.5T (V9) | Ikke offentliggjort (tæt/ekspert-mix) |
| Kodning (SWE-Bench, est.) | Konkurrencedygtig/førende (Cursor-boost) | ~80%+ Verified |
| Generel ræsonnering (GPQA/MMLU) | Tæt på/over Opus | Førende |
| Kontekstvindue | Stort (projekteret 200k+) | 200k+ |
| Pris (via API) | Konkurrencedygtig (billigere via CometAPI) | Premium |
| Dataspecialisering | Cursor IDE-spor | Bred + kurateret |
| Tilgængelighed | Privat beta → snart? | Offentlig API |
| Træningskadence | Månedlige modeller fra bunden | Iterativ |
Tabellen er syntetiseret ud fra lækager, tidligere benchmarks og analyser. Faktiske resultater afventer offentlige evalueringer.
Behandl Opus-sammenligningen som et benchmark-mål, ikke en konklusion. Hvis Grok 4.5 virkelig er tæt på eller over Opus, bør det ses i løste-opgave-raten, færre retries, lavere reviewer-redigeringer og bedre recovery i værktøjsloops. Hvis den kun vinder demos, er det ikke nok til produktionsrouting.
Tre ingeniørmæssige mørke kroge
Migreringsrisikoen handler ikke kun om modelkvalitet. Tre mindre synlige detaljer kan gøre en Grok 4.5-udrulning dyr eller skrøbelig.
1. Cursor-formede gevinster overføres måske ikke til din kodestak
Hvis træningssignalet kommer fra Cursor-arbejdsgange, kan modellen være stærkest i Cursor-lignende redigeringsmønstre. Dit produktionssystem kan være anderledes: server-side agenter, CI-reparationsbots, GitHub issue-triage, intern repo-migrering eller lokale udviklerassistenter.
Evaluerings-tjekliste:
- Inkluder reelle repositories, ikke legetøjsprompter.
- Inkluder opgaver, der kræver læsning før redigering.
- Inkluder opgaver for recovery efter fejlede tests.
- scor korrekthed af endelig patch, ikke kun svarkvalitet.
- Sammenlign ren chattilstand mod agenttilstand.
- Mål om Grok 4.5 reducerer retries sammenlignet med Opus 4.8 og Grok 4.3.
2. Ydeevne i privat beta kan afhænge af interne rammer
En model testet internt i SpaceX eller Tesla kan have fordel af interne værktøjer, kuraterede promper, private evalueringer eller specialiseret retrieval. En offentlig API-version kan opføre sig anderledes.
Evaluerings-tjekliste:
- Registrér den præcise model-ID og udgivelsesdato.
- Registrér værktøjs-tilgængelighed for hver kørsel.
- Adskil modelkvalitet fra rammekvalitet.
- Spor p50- og p95-latens.
- Spor værktøjsfejl og ugyldige værktøjskald.
- Undgå at sammenligne en intern agent-demo med et råt API-kald.
3. Priser og kontekstbegrænsninger kan udligne benchmark-gevinster
Selv hvis Grok 4.5 er stærkere, er den måske ikke billigere. Tokenpris, kontekstvindue, outputgrænse, prompt-caching, rate limits og værktøjskald-omkostning betyder alt.
Brug denne ruteringsmetrik:
Effektiv omkostning pr. løst opgave = (primær modelomkostning + retry-omkostning + fallback-omkostning + omkostning til menneskelig review) / succesfulde opgaver
Hvis Grok 4.5 løser flere opgaver med færre retries, kan den retfærdiggøre en højere tokenpris. Hvis den bruger flere tokens, looper længere eller kræver mere review, vil launch-hypen ikke oversætte til lavere arbejdsbyrdeomkostninger.
Sådan evaluerer du Grok 4.5 selv
Brug lækkeperioden til at forberede evalueringen, før modellen dukker op.
1. Byg et sæt på 20 opgaver til en kodeagent
Inkluder reelle opgaver:
- bugfix i dit eget repo
- refaktorering på tværs af flere filer
- afhængighedsmigrering
- reparation af fejlede tests
- kodereview med subtil regression
- dokumentationsopdatering knyttet til kode
- UI-fejl fra screenshot plus kilde
- SQL- eller datapipeline-problem
- værktøjskald-arbejdsgang
- lang-kontekst spørgsmål om repository
2. Kør de samme opgaver på tilgængelige baselines
Vent ikke på Grok 4.5 for at begynde at måle. Kør det samme opgavesæt på:
- Grok 4.3 for nuværende xAI generel ræsonnering
- Grok Build 0.1 som den officielle xAI-kodningsbaseline hvor tilgængelig
- Claude Opus 4.8 for højkapable kodnings- og agentiske opgaver
- Claude Sonnet 5 for lavere omkostninger i produktion
- din nuværende produktionsmodel
3. Mål omkostninger ved løste opgaver
Spor:
- input-tokens
- output-tokens
- værktøjskald
- retries
- mislykkede patches
- testrate for bestået
- latenstid
- reviewer-redigeringer
- endelig pass/fail-score
- pris pr. accepteret patch
Sammenlign ikke enkeltstående outputs. Sammenlign de samme opgaver, samme instruktioner, samme værktøjer og samme scoringsrubrik.
4. Tilføj først Grok 4.5 efter offentlig tilgængelighed
Når xAI eller CometAPI eksponerer en stabil Grok 4.5-model-ID, tilføj den til den samme evaluering. Omskriv ikke evalueringen omkring den nye model. Hele pointen er at holde benchmarken så stabil, at sammenligningen giver mening.
5. Beslut efter opgavetype
Brug den vindende model efter opgavetype, ikke efter brand:
- Brug den billigere model, når opgavesucces er lignende.
- Brug Opus 4.8, når fejl er dyre, og Grok 4.5 ikke har bevist paritet.
- Brug Grok 4.5 kun, dér hvor den slår nuværende baselines på dine egne opgaver.
- Behold en fallback-rute, indtil fejlrater, latenstid og omkostning er stabile.
Hvad vi ved vs. hvad vi endnu ikke kan verificere
Bekræftet / Stærkt signaleret:
- 1.5T V9-basismodel + Cursor-supplerende træning.
- Privat beta hos SpaceX/Tesla (28. juni 2026).
- Musk-tilskrevet “tæt på/over Opus”-påstand.
- Månedlig roadmap for nye modeller.
- UI-kanariske spor.
Ubekræftet / Åbne spørgsmål:
- Præcise benchmarks (intet systemkort).
- Offentlig udgivelsesdato og API-priser.
- Fuldt kontekstvindue, multimodale kapabiliteter.
- Præcis Cursor-datamængde, licens og blandingsforhold.
- Ydeevne vs. specifik Opus-version eller andre frontier-modeller (f.eks. GPT-5.5, Gemini 3.x).
- Grok 4.5 vs. rygteomtalte større Grok 5-varianter.
Behandl påstande som leverandør-retning. Historien viser, at interne evalueringer kan afvige fra offentlige; uafhængig verifikation er essentiel.
Hvad du skal holde øje med næste
Hold øje med fem ting de næste par uger:
- xAI-modeldokumenter, der tilføjer en Grok 4.5 model-ID.
- xAI release notes, der bekræfter offentlig eller preview-tilgængelighed.
- Uafhængige kodnings-agent benchmarks, især SWE-bench (https://www.swebench.com/), Terminal-Bench (https://www.tbench.ai/) og Cursor-lignende kodnings-agent opgaver.
- Ægte udviklerrapporter om Cursor-lignende kodnings-arbejdsgange.
- CometAPI-katalog eller dashboard-opdateringer for Grok 4.5-tilgængelighed.
Det første pålidelige købssignal vil ikke være et viralt X-opslag. Det vil være en model-ID plus gentagelige evalueringsresultater.
Fremtidsperspektiv: Månedlige modeller og videre
xAI’s tempo — nye basismodeller månedligt — kan redefinere iterationshastigheden. Grok 4.5 er et inkrementelt spring; Grok 5-varianter lover mere. Forvent fortsat fokus på sandhedssøgning, humor og reel nytte i overensstemmelse med Musks vision.
Opfordring til handling: Tilmeld dig CometAPI i dag for at få adgang til kraftfulde Grok-modeller til en overkommelig pris og ligge i front. Hold øje med x.ai og X for officielle Grok 4.5-opdateringer. AI-koderevolutionen accelererer — positionér dine arbejdsgange nu.