Tekniske specifikationer for Qwen3.8-Flash
| Specifikation | Qwen3.8-Flash |
|---|---|
| Udbyder | Alibaba / Qwen |
| Modelfamilie | Qwen3.8 |
| Model-ID | qwen3.8-flash |
| Modeltype | Multimodal ræsonneringsmodel |
| Inputmodaliteter | Tekst, billede, video |
| Outputmodalitet | Tekst |
| Kontekstvindue | 1,000,000 tokens |
| Maksimalt output | 128,000 tokens |
| Maksimalt ræsonnementsbudget | 262,144 tokens |
| Tænkemodus | Understøttet |
| Funktionskald | Understøttet |
| Indbyggede værktøjer | Understøttet |
Qwens nuværende API-dokumentation angiver qwen3.8-flash som en produktionsmodel i Qwen3.8-serien med et 1M-token kontekstvindue og 128K maksimalt output. Den understøtter input af tekst, billeder og video, funktionskald, indbyggede værktøjer og struktureret output.
For visuelle arbejdsbelastninger inkluderer de dokumenterede grænser op til 16 megapixel pr. billede, op til 2,048 billed-URL’er eller 250 Base64-billeder, og op til 64 videoer, hvor videoer kan være op til 2 timer.
Hvad er Qwen3.8-Flash?
Qwen3.8-Flash er Alibabas omkostningseffektive multimodale ræsonneringsmodel i Qwen3.8-familien, designet til kodning, agent-baserede arbejdsgange, langkontekst-analyse og visuel forståelse. Den leverer samme 1M-token kontekstklasse som Qwen3.8-Max, men sigter mod væsentligt lavere API-omkostninger. Qwens egen udviklervejledning anbefaler eksplicit Qwen3.8-Flash, når brugere ønsker lignende kapabiliteter til en lavere pris, mens Qwen3.8-Max er positioneret som det stærkere ræsonneringsvalg.
Modellen er særligt interessant, fordi “Flash” ikke betyder en simpel lille model. Produktions-API-modellen kombinerer langkontekst-ræsonnering, multimodalt input, værktøjsbrug og struktureret output i et relativt billigt endepunkt.
Hvad er de vigtigste funktioner i Qwen3.8-Flash?
- 1M-token-kontekst: Qwen3.8-Flash kan behandle ekstremt lange dokumenter og kodebaser, hvilket gør den velegnet til analyse af repositories og langvarige agentsessioner.
- Multimodal forståelse: API’et accepterer tekst, billeder og video, så udviklere kan kombinere kode, skærmbilleder, diagrammer, dokumenter og video i én arbejdsgang.
- Tænkemodus: Modellen understøtter Qwens tænkemodus med et dokumenteret maksimalt ræsonnementsbudget på 262,144 tokens.
- Understøttelse af agenter og værktøjer: Funktionskald og indbyggede værktøjer er understøttet, inklusive kapabiliteter som websøgning, kodeeksekvering og relaterede Qwen-hostede værktøjer.
- Struktureret output: Udviklere kan anmode om strukturerede svar, hvilket gør modellen lettere at integrere i applikationer, der kræver JSON eller skemabegrænsede resultater.
- Forståelse af lange videoer: Den visuelle API-dokumentation angiver videoinput på op til to timer, hvilket gør Qwen3.8-Flash nyttig til videoanalyse frem for kun kort billedtekstanalyse.
Hvad er de bedste anvendelsesområder for Qwen3.8-Flash?
Kodning og softwareudvikling
1M-token-konteksten er nyttig til store kodearkiver, lange fejlsøgningssessioner og multifils-kodeanalyse. Modellens funktionskald og understøttelse af ræsonnering gør den også velegnet til kodeagenter frem for kun kodefuldførelse.
Agent-baserede arbejdsgange
Qwen3.8-Flash understøtter funktionskald og indbyggede værktøjer, så en applikation kan lade modellen hente information, eksekvere kode eller interagere med eksterne systemer.
Analyse af lange dokumenter
Et million-token kontekstvindue gør modellen egnet til store kontrakter, teknisk dokumentation, forskningssamlinger og virksomhedens vidensbaser, hvor gentagen opdeling i bidder ellers ville være nødvendig.
Video- og visuel analyse
Qwen3.8-Flash accepterer både billeder og video. De nuværende visuelle API-grænser tillader videoer på op til to timer, hvilket gør den relevant for mødeoptagelser, tutorials, forelæsninger, demonstrationer og analyse af longform visuelt indhold.
Omkostningsfølsom produktions-AI
Dette er formentlig modellens største kommercielle fordel. Qwen anbefaler eksplicit Flash som det billigere alternativ til Qwen3.8-Max, hvilket gør den egnet til højvolumenapplikationer, hvor reasoning på flagskibsniveau ikke er nødvendig ved hver forespørgsel.
Hvad er begrænsningerne ved Qwen3.8-Flash?
Qwen3.8-Flash bør ikke fortolkes som den højest ydende model i Qwen3.8-familien, blot fordi den deler 1M-kontekstvinduet med Qwen3.8-Max.
Den primære afvejning er kapabilitet kontra omkostninger: Qwen anbefaler selv Qwen3.8-Max, når den stærkeste ræsonneringspræstation er påkrævet.
En anden overvejelse er, at et 1M kontekstvindue ikke betyder, at hver forespørgsel bør indeholde en million tokens. Store kontekster øger behandlingskravene, og udviklere bør bruge genfinding, caching og konteksthåndtering, når hele konteksten ikke er nødvendig.
Endelig bør udviklere skelne mellem den hostede qwen3.8-flash og open-weight Qwen3.8-Flash-Next. Sidstnævnte er forhåndsvisningen af arkitekturen og har uafhængigt dokumenterede vægte og arkitektur; produktions-API-modellen bør dokumenteres i henhold til sine egne API-specifikationer.
Er Qwen3.8-Flash velegnet til produktions-API-applikationer?
Ja, især når applikationen har brug for multimodal ræsonnering, lang kontekst, værktøjsbrug og relativt lave token-omkostninger.
Den er en stærkere produktionskandidat end Flash-Next, når kravet blot er at kalde en hostet Qwen-API, fordi qwen3.8-flash eksplicit eksponeres som en produktionsmodel i Qwens API-dokumentation med defineret kontekst, output, værktøjer og multimodale grænser.
For maksimal ræsonneringskvalitet er Qwen3.8-Max fortsat det mere passende valg. For højvolumenarbejdsbelastninger, hvor omkostninger og throughput betyder mere, er Qwen3.8-Flash den mere økonomiske mulighed.
Qwen3.8-Flash API-parametre
En standard OpenAI-kompatibel forespørgsel kan bruge parametre som:
| Parameter | Formål |
|---|---|
| model | qwen3.8-flash |
| messages | Samtale og multimodalt input |
| temperature | Styring af sampling |
| max_tokens | Maksimalt genereret output |
| stream | Streaming-svar |
| tools | Definitioner af funktioner/værktøjer |
| tool_choice | Adfærd for værktøjsvalg |
| response_format | Konfiguration af struktureret output |
| enable_thinking | Aktiverer tænkemodus i understøttede Qwen-API’er |
Quickstart-dokumentation bruger OpenAI SDK med modelidentifikatoren qwen3.8-flash. Eksemplet aktiverer ræsonnering med extra_body={"enable_thinking": True}.
Sådan bruger du qwen3.8-flash API i CometAPI
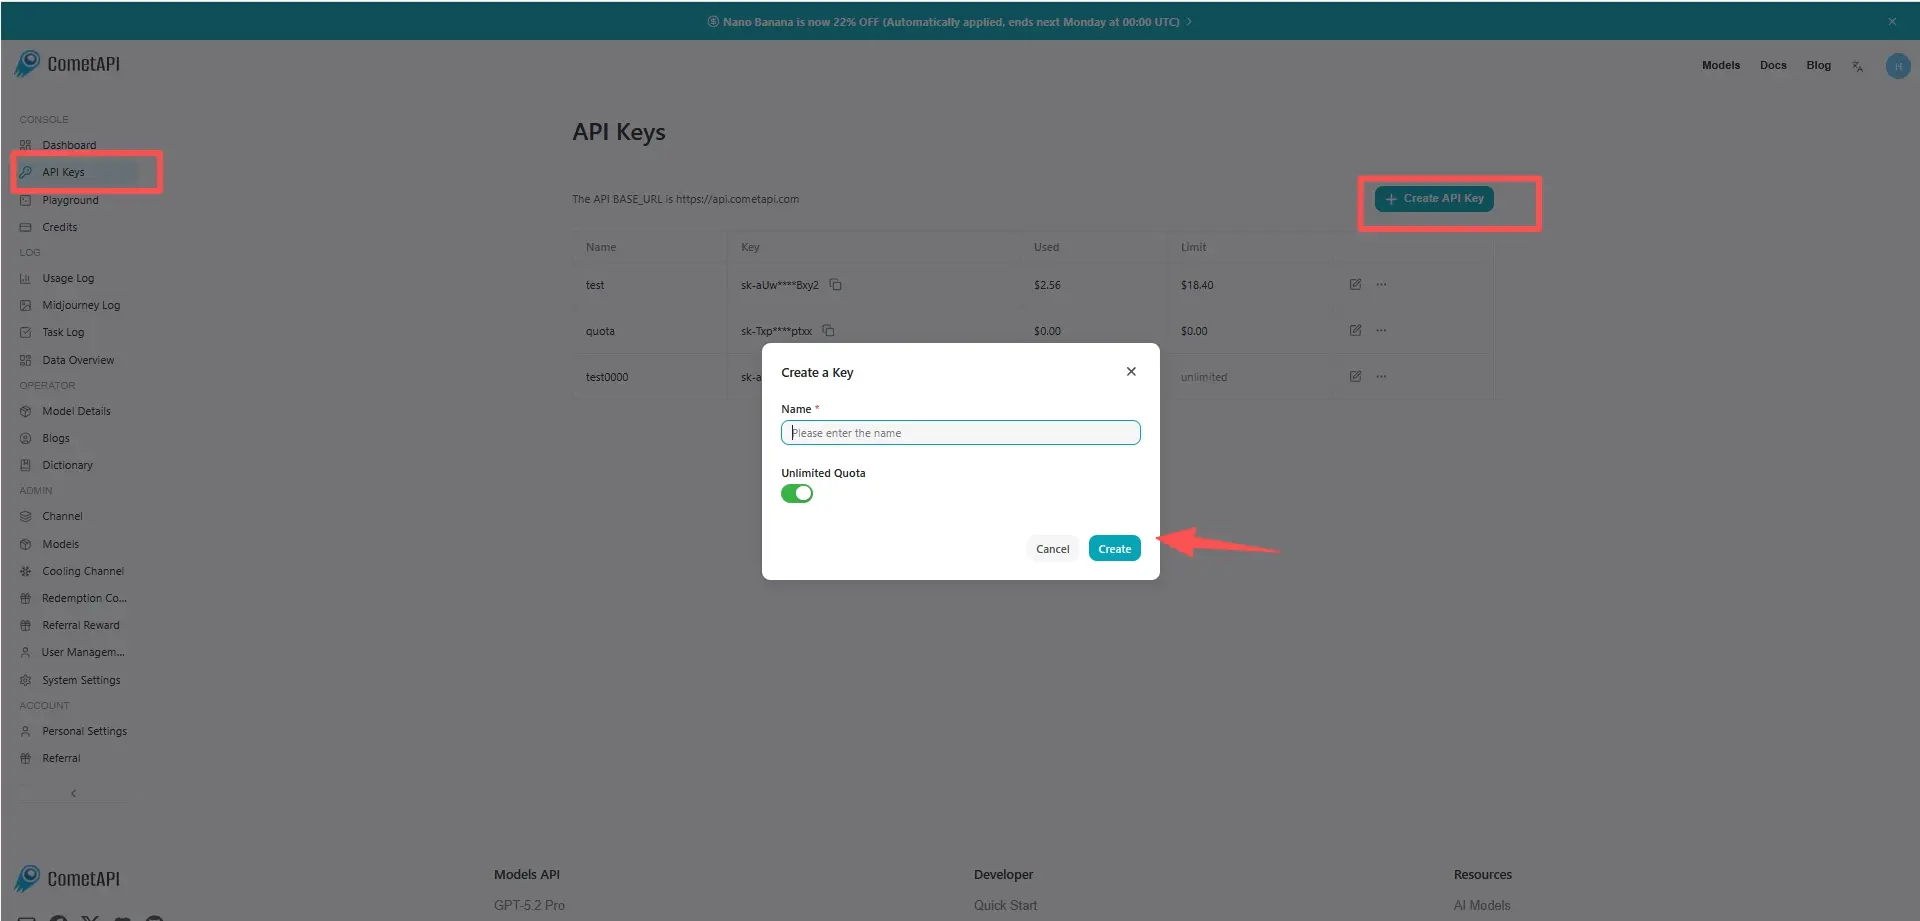
Trin 1: Få API-adgang
Log ind på cometAPI. Hvis du endnu ikke er bruger hos os, skal du først registrere dig. Log ind på din CometAPI-konsol. Hent adgangslegitimations-API-nøglen til interfacet. Klik på “Add Token” ved API-tokenet i det personlige center, hent token-nøglen: sk-xxxxx og indsend.
Trin 2: Send forespørgsler til qwen3.8-flash API
Vælg endepunktet “qwen3.8-flash” for at sende API-forespørgslen og angiv request body. Forespørgselsmetoden og request body fås fra vores websteds API-dokumentation. Vores websted stiller også Apifox-test til rådighed for din bekvemmelighed. Erstat <YOUR_API_KEY> med din faktiske CometAPI-nøgle fra din konto.
Indsæt dit spørgsmål eller din anmodning i content-feltet—det er det, modellen svarer på. Behandl API-svaret for at få det genererede svar. Den understøtter AI SDK, OpenAI Chat Completions, OpenAI Responses og Anthropic Messages-kompatible grænseflader.
Trin 3: Behandl svar
API’et returnerer strukturerede kandidat-svar, inklusive genereret tekst, citater, sikkerhedsmetadata og valgfrie værktøjsuddata. For multimodale forespørgsler kan beskedindholdet struktureres med tekst- og billedeinput, når det valgte CometAPI-endepunkt eksponerer modellens vision-kapabilitet.