
Qwen3.8-Flash forklaret: 1M kontekst, 6B aktivt MoE-design, kode- og multimodale benchmarks, pris/ydelse, sammenligninger og CometAPI-adgang.
TL;DR Alibaba's Qwen3.8-Flash er en produktionsmodel til højvolumen-kodning, agenter, lang-kontekst-arbejde og multimodale opgaver. Den understøtter 1M tokens hosted kontekst og kombinerer stærke benchmark-resultater med lave API-priser. En open-weight-modpart, Qwen3.8-Flash-Next, er tilgængelig til lokal evaluering og deployment.
Nøglepunkter
- Navngivning: produktion vs. open-weight: Qwen3.8-Flash er den hostede produktionsmodel; Qwen3.8-Flash-Next er open-weight-arkitekturudgivelsen, der bruges til at offentliggøre modeldetaljer og benchmarks.
- Ekstrem sparsom aktivering: 125B hovedparametre + 51B N-gram-indlejringer, med kun 6B aktive parametre pr. token.
- Lang kontekst: 262K native kontekst for den åbne model, udvidelig til 1M med YaRN; produktionsruten QwenCloud eksponerer 1M kontekst som standard.
- Stærk agentisk kodning: Qwen rapporterer 62.5 på SWE-bench Pro, 73.9 på CoWorkBench, 73.5 på Toolathlon Verified og 91.9 på LiveCodeBench v6.
- Multimodal styrke: Qwen rapporterer 84.5 på AndroidWorld, 88.5 på RealWorldQA og 90.6 på MathVision uden en kodefortolker.
- Effektivitet: QSA når op til 7.6x prefill og 4.9x decode kernel-speedups ved 1M tokens, og Qwen rapporterer 8.6x højere 1M-token prefill-throughput end Qwen3.7-Plus under et high prefix-cache-hit setup.
- Priser: Alibaba Cloud viser aktuelt US$0.15/M input og US$0.47/M output for international deployment; CometAPI viser US$0.12/M input og US$0.376/M output.
Officielt Qwen3.8-Flash-lanceringsbillede — Alibaba/Qwen-kilde
Hvad er Qwen3.8-Flash?
Qwen3.8-Flash er Alibaba Qwens effektivitetsorienterede produktionsmodel til kodning, agenter, lang-kontekst-vidensarbejde og multimodale opgaver. Modellen blev annonceret sammen med en open-weight-modpart kaldet Qwen3.8-Flash-Next. Alibaba beskriver den som en open-weight multimodal MoE-model optimeret til kapabilitet, latenstid og omkostninger og siger, at arkitekturen er en tidlig forhåndsvisning af idéer tiltænkt Qwen4.
“Flash”-mærkningen er vigtig. Qwen3.8-Max er det større flagskibslag for maksimal kapabilitet, mens Qwen3.8-Flash er bygget til at levere meget af den nyttige kode- og agentperformance med dramatisk lavere aktiv beregning. Udgivelsen aktiverer 6B parametre pr. token, sammenlignet med langt større aktive fodaftryk i flagskibs-MoE-systemer.
Produktionsmodellen serviceres under model-ID’et qwen3.8-flash. QwenCloud understøtter OpenAI-kompatible Chat Completions og Responses-API’er plus en Anthropic-kompatibel grænseflade, hvilket gør modellen ligetil at integrere i eksisterende agent- og kodestakke.
Qwen3.8-Flash vs. Qwen3.8-Flash-Next: Hvad er forskellen?
Qwen3.8-Flash-Next er open-weight-modeludgivelsen. Den eksponerer arkitekturen, modelvægte, deploymentsvejledning og benchmarksuite. Vægtene er tilgængelige på Hugging Face og ModelScope. Den åbne model understøtter en native kontekst på 262.144 tokens og kan udvides til 1M med YaRN.
Qwen3.8-Flash er produktions-API-versionen. I den officielle udgivelse siger Alibaba, at produktionsversionen bruger 1M kontekst som standard og inkluderer officielle indbyggede værktøjer. I praksis bør udviklere, der evaluerer den hostede model, bruge Qwen3.8-Flash API-adfærd og priser, mens Flash-Next-udgivelsen er den bedste offentlige kilde til arkitektur- og benchmarkdetaljer.
Qwen3.8-Flash-specifikationer
| Specifikation | Qwen3.8-Flash / Flash-Next |
|---|---|
| Udbyder | Alibaba Qwen |
| Produktionsmodel-ID | qwen3.8-flash |
| Open-weight-model | Qwen3.8-Flash-Next |
| Arkitektur | Multimodal Mixture-of-Experts; GDN + QSA hybrid attention |
| Hovedparametre | 125B |
| Aktiverede parametre | 6B pr. token |
| N-gram-embedding-parametre | 51B |
| Native åben-model-kontekst | 262.144 tokens |
| Udvidet/hostet kontekst | Op til 1.000.000 tokens |
| Produktionsinputmodaliteter | Text + image dokumenteret i officielle integrationseksempler |
| Open-weight-modaliteter | Text + vision; udgivet som multimodal |
| Reasoning-kontroller | low / medium / xhigh i QwenCloud-eksempler |
| Parallelle værktøjskald | Understøttet i officiel Codex-modelkonfiguration |
| Åbne vægte | Ja, for Qwen3.8-Flash-Next |
| Lancering | Udgivelsesvindue 26.–27. august 2026 |
Det vigtigste effektivitets-tal er 6B aktiverede parametre pr. token. De yderligere 51B N-gram-embedding-parametre er opslagbaseret kapacitet; Qwen bemærker, at de ikke indgår i det per-token matrixmultiplikationsbudget på samme måde som transformer-vægte.
Hvad er nyt i Qwen3.8-Flash-arkitekturen?
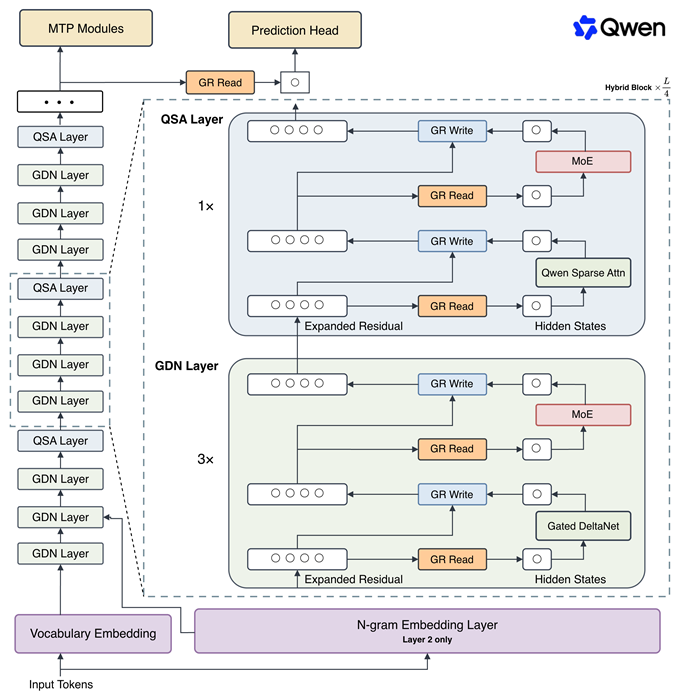
Officielt Qwen-arkitekturdiagram — Qwen3.8-Flash-Next
1. GDN + Qwen Sparse Attention (QSA)
Modellen blander to mekanismer. Tre ud af fire lag bruger Gated DeltaNet (GDN) til at komprimere historisk information til en tilstand af fast størrelse, mens det resterende lag bruger global attention til præcis hentning. Det globale attention-lag bruger derefter Qwen Sparse Attention til at reducere mængden af kontekst, der skal behandles direkte.
Det praktiske mål er enkelt: GDN håndterer billig hukommelse, mens QSA bruger fuld attention kun dér, hvor hentning betyder noget. Dette er særligt værdifuldt for lang-kontekst-applikationer, hvor almindelig fuld attention bliver dyr i både beregning og KV-cache-trafik.
2. Gated Residual med fire informationsveje
Gated Residual udvider residualstrømmen til fire parallelle grene. En dynamisk elementvis gate styrer, hvor meget information der læses fra og skrives til hver gren. Dette giver tidlig information flere måder at overleve dybe netværk på i stedet for at blive gentagne gange blandet i én strøm. Qwen siger også, at residualtilstanden kan lagres i FP8 for at reducere hukommelsestrafik.
3. N-gram-indlejringer øger kapaciteten uden proportional beregning
Qwen tilføjer 51B N-gram-embedding-parametre, som adresseres ved hjælp af lokal tokenkontekst. I modsætning til normale transformer-vægte hentes disse parametre via opslag og kan offloades til host-hukommelse med asynkron forudindlæsning. Designet udvider modelkapaciteten, samtidig med at den per-token aritmetik holdes lav.
4. Muon optimizer og co-design af træning
Qwen træner modellen med Muon optimizer for kerners 2D linear-map-vægte, mens AdamW bevares for indlejringer, routere og udvalgte low-rank-parametre. Holdet har også tilpasset skalaloven til den nye arkitektur og rapporterer, at batchstørrelses-warmup var unødvendig, hvilket undgår 18.8% ekstra optimizer-trin i deres eksperimenter.
5. Ultrasparsom MoE og multi-token-forudsigelse
Modellen bevarer en stor ekspertpulje, men ruter kun et lille antal eksperter pr. token. Den bruger også multi-token-forudsigelse, som hjælper spekulativ dekodning ved at øge accept-rater og samtidig forbedre rygraden under træning. Tilsammen understøtter disse valg det samme designmål: mere kapacitet og throughput uden at betale flagskibs-beregning for hvert token.
Qwen3.8-Flash benchmark-performance
Kodnings-benchmarks
Alibaba offentliggør benchmarksuiten under Qwen3.8-Flash-Next, open-weight-modparten til produktionsmodellen Qwen3.8-Flash. Følgende tabeller bruger Qwens rapporterede udgivelsesscorer og fokuserer på peers, der også er tilgængelige via CometAPI.
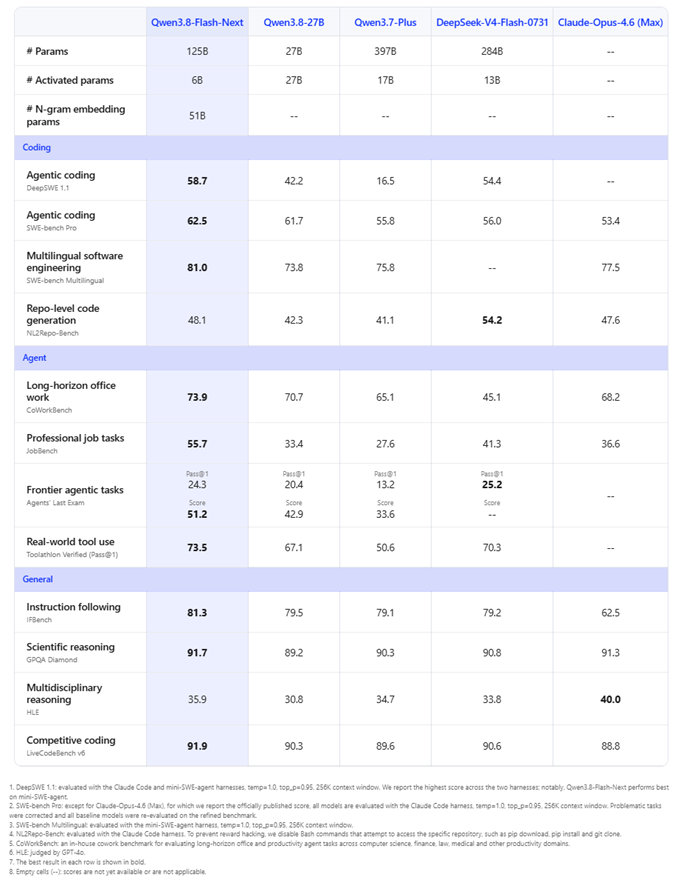
Officielt Qwen sprog-benchmarkdiagram
| Benchmark | Qwen3.8-Flash | DeepSeek V4 Flash | Claude Opus 4.6 |
|---|---|---|---|
| DeepSWE 1.1 | 58.7 | 54.4 | — |
| SWE-bench Pro | 62.5 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | — | 77.5 |
| NL2Repo-Bench | 48.1 | 54.2 | 47.6 |
| CoWorkBench | 73.9 | 45.1 | 68.2 |
| JobBench | 55.7 | 41.3 | 36.6 |
| Toolathlon Verified | 73.5 | 70.3 | — |
| IFBench | 81.3 | 79.2 | 62.5 |
| GPQA Diamond | 91.7 | 90.8 | 91.3 |
| HLE | 35.9 | 33.8 | 40.0 |
| LiveCodeBench v6 | 91.9 | 90.6 | 88.8 |
Kodningsresultat: Qwen3.8-Flash fører de valgte peers på SWE-bench Pro (62.5), SWE-bench Multilingual (81.0) og LiveCodeBench v6 (91.9). Den store undtagelse er NL2Repo-Bench, hvor DeepSeek V4 Flash scorer 54.2 mod 48.1.
Agentresultat: Qwen3.8-Flash opnår 73.9 på CoWorkBench og 55.7 på JobBench, væsentligt over de valgte peers i Qwens udgivelsestabel. Den ligger også lidt foran DeepSeek V4 Flash på Toolathlon Verified, 73.5 mod 70.3.
Reasoning-resultat: Feltet er tættere. Qwen3.8-Flash scorer 91.7 på GPQA Diamond, tæt på Claude Opus 4.6 med 91.3 og DeepSeek V4 Flash med 90.8. På HLE fører Claude Opus 4.6 med 40.0 mod Qwens 35.9.
Multimodale benchmarks
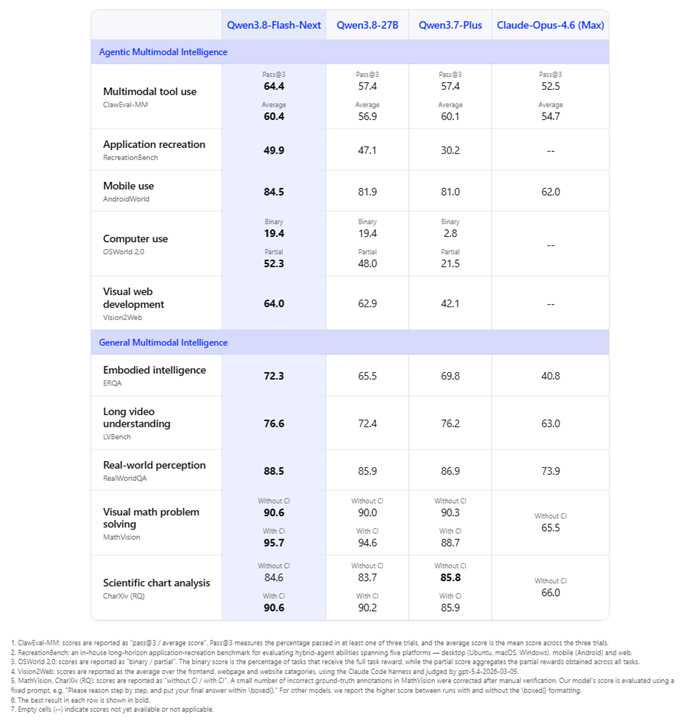
Officielt Qwen vision-language-benchmarkdiagram
| Benchmark | Qwen3.8-Flash | Claude Opus 4.6 |
|---|---|---|
| ClawEval-MM (Pass@3 / Avg) | 64.4 / 60.4 | 52.5 / 54.7 |
| AndroidWorld | 84.5 | 62.0 |
| ERQA | 72.3 | 40.8 |
| LVBench | 76.6 | 63.0 |
| RealWorldQA | 88.5 | 73.9 |
| MathVision (no CI / with CI) | 90.6 / 95.7 | 65.5 / — |
| CharXiv RQ (no CI / with CI) | 84.6 / 90.6 | 66.0 / — |
De multimodale udgivelsesresultater er et af de stærkeste argumenter for Qwen3.8-Flash. Qwen rapporterer 84.5 på AndroidWorld, 88.5 på RealWorldQA og 90.6 på MathVision uden en kodefortolker. Disse scorer antyder, at modellen er tiltænkt agenter, der skal læse skærmbilleder, forstå visuel tilstand og fortsætte handlinger frem for blot at besvare billedspørgsmål.
Benchmark-note: Dette er leverandør-rapporterede udgivelsesresultater, ikke en neutral head-to-head labtest. Flere benchmarks bruger forskellige harnesses eller værktøjskonfigurationer, og nogle er in-house. Betragt tallene som retningsgivende beviser, og valider derefter modellen på dine egne prompts, værktøjer, latenstidsmål og acceptkriterier.
Hvorfor Qwen3.8-Flash er hurtig og omkostningseffektiv
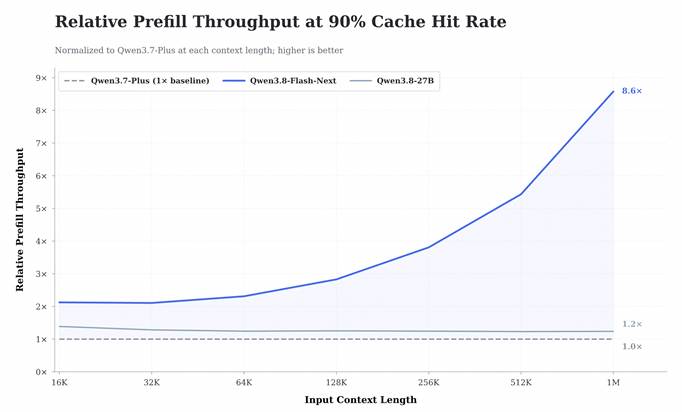
Officielt Qwen lang-kontekst-effektivitetsdiagram
Ved en 1M-token-kontekst rapporterer Qwen op til 7.6x hurtigere prefill og 4.9x hurtigere decode for QSA attention-kernen. I et serving-eksperiment med 90% prefix-cache-hit-rate nåede Qwen3.8-Flash-Next 8.6x prefill-throughput af Qwen3.7-Plus.
Den større systemhistorie er aktiv beregning. En 125B hovedmodel lyder normalt stor, men kun 6B parametre aktiveres pr. token. Det aktive fodaftryk er under halvdelen af de 13B aktiverede parametre, der rapporteres for DeepSeek V4 Flash, og langt under de cirka 95B aktiverede parametre, der rapporteres for Qwen3.8-Max. Parameterantal oversættes ikke lineært til hastighed, men designet giver Qwen3.8-Flash et klart effektivitetsmål.
Alibaba rapporterer også, at træningen krævede omkring en niendedel af ressourcerne i forhold til Qwen3.7-Plus, samtidig med at ydeevnen for kodning og kontoropgaver blev forbedret. Separat rapporteres QwenWork Standard-tilstand drevet af modellen at reducere tokenforbruget pr. opgave med 75% og omtrent fordoble genereringshastigheden i forhold til den tidligere tilstand. Disse produktniveau-tal bør ikke behandles som universelle API-latenstidsgarantier, men de viser, hvordan Alibaba forventer, at modellen skal bruges.
Qwen3.8-Flash priser
Alibabas lanceringsmeddelelse viser QwenCloud-priser på $0.16 pr. million input-tokens og $0.47 pr. million output-tokens. Priser kan variere efter region, produktoverflade, caching eller senere opdateringer, så produktionsteams bør altid tjekke den live udbyderside før estimering af en stor arbejdsbyrde.
På det tidspunkt denne artikel blev udarbejdet, viser CometAPI Qwen3.8-Flash til $0.12 pr. million input-tokens og cirka $0.376 pr. million output-tokens. CometAPI’s models side mærker dette som 20% rabat i forhold til den angivne referencepris.
| Rute | Input / 1M tokens | Output / 1M tokens | Eksempel: 10M input + 2M output |
|---|---|---|---|
| QwenCloud lanceringsrate | $0.16 | $0.47 | $2.54 |
| CometAPI angivet rate | $0.12 | ~$0.376 | ~$1.95 |
For en arbejdsbyrde med 10 millioner input-tokens og 2 millioner output-tokens er regnestykket ved lanceringsraten cirka $2.54 på QwenCloud mod cirka $1.95 til den aktuelt angivne CometAPI-rate. Reelle agentregninger kan være højere, fordi værktøjskald, retries, lang reasoning, gentagen kontekst og eksterne tjenester tilføjer omkostninger. Sammenlign pris pr. accepteret resultat i stedet for kun tokenpris.
Qwen3.8-Flash vs. Qwen3.8-Max vs DeepSeek V4 Flash
| Dimension | Qwen3.8-Flash | Qwen3.8-Max | Gemini 3.7 Flash | DeepSeek V4 Flash |
|---|---|---|---|---|
| Positionering | Effektivitetsførst Qwen-produktionsmodel | Qwen-flagskibsmodel | Googles arbejdshest-Flash-model | Effektivitetsførst tekst-MoE |
| Samlede/aktive parametre | 125B + 51B opslag / 6B | 2.4T / ~95B | Ikke offentliggjort | 284B / 13B |
| Kontekst | 1M hostet | 1M | 1,048,576 | 1M |
| Multimodal | Text + vision dokumenteret | Text + image + video | Text + image + video + audio + PDF | Tekstfokuseret |
| Reasoning-kontroller | low / medium / xhigh | Avanceret reasoning / hurtig tilstand | low / medium / high | Non-think / Think / Think Max |
| CometAPI inputpris | US$0.12/M | US$1.60/M | US$0.60/M | US$0.176/M |
| Officiel udbyderpris (input / output) | US$0.15 / US$0.47 (Alibaba Cloud international) | US$2 / US$6 (Alibaba Cloud international) | US$0.75 / US$3.75 til 31. dec. 2026 | Spids: US$0.44 / US$1.32; off-peak: US$0.22 / US$0.66 |
| Bedst egnet | Højvolumen-kodning, agenter, cowork | Sværeste Qwen-opgaver, langhorisont-autonomi | Google-værktøjsøkosystem, brede multimodale agenter | Høj-throughput tekst-reasoning og kodning |
Hvor Qwen3.8-Flash vinder
- Aktiv-beregnings-effektivitet: 6B aktiverede parametre er usædvanligt lille for en model, der leverer stærke agentiske kodnings- og multimodale scorer.
- Værdi i Qwen-økosystemet: Qwen3.8-Flash er dramatisk billigere end Qwen3.8-Max for arbejdsbyrder, der ikke behøver flagskibsniveauet.
- Balance mellem agent og kontor: Udgivelsen er usædvanligt stærk på CoWorkBench, JobBench, Toolathlon, SWE-bench Pro og multimodale agentopgaver frem for kun akademisk QA.
- Open-weight-vej: Qwen3.8-Flash-Next leverer vægte til teams, der har brug for lokal deployment, uafhængig evaluering eller finjustering.
Hvor en anden model kan være bedre
- Brug Qwen3.8-Max for maksimal Qwen-kapabilitet. Max-laget har et meget større aktivt beregningsbudget og er designet til de hårdeste langhorisont-opgaver.
- Brug Gemini 3.7 Flash når bred inputmodalitet betyder noget. Googles Flash-model dækker eksplicit lyd, video, PDF og dybe Google-værktøjsintegrationer.
- Brug DeepSeek V4 Flash når tekst-først effektivitet er prioriteten. Den vinder NL2Repo-Bench i Qwens sammenligning og forbliver et stærkt omkostningsfokuseret kodningsalternativ.
- Brug Claude Opus 4.6 når premium-reasoning og enterprise-procesmodenhed retfærdiggør prisen. I Qwens udgivelsestabel fører den stadig HLE og er fortsat meget konkurrencedygtig på GPQA.
Bedste anvendelsesområder for Qwen3.8-Flash
Kodningsagenter og repository-arbejde
Qwen3.8-Flash passer godt til issuetriage, refaktorering, code review, repository-navigation, testgenerering, debugging og værktøjsdrevne kodningsloops. De høje LiveCodeBench- og SWE-bench Pro-resultater antyder, at den ikke blot er en lav-latenstidschatmodel; den er designet til at udføre flertrins softwarearbejde.
Lang-kontekst enterprise-vidensarbejde
En produktionskontekst på 1M tokens kan rumme store dokumentsamlinger, kodebaser, logs, mødeudskrifter eller langvarig agenthistorik. CoWorkBench- og JobBench-resultaterne gør modellen særligt interessant til dokumentsyntese, regneark-/slidede-arbejdsgange, forskningssupport, compliance-gennemgang og operationel analyse.
Multimodale agenter
Scorerne på AndroidWorld, RealWorldQA, ERQA og MathVision peger mod agenter, der skal forstå skærmbilleder, visuelle dokumenter, interfaces, diagrammer og billeder fra den virkelige verden som en del af en arbejdsgang. Dette gør modellen relevant for browseragenter, UI-test, visuel QA, dokumentagenter og skærm-bevidst automatisering.
Højvolumen-routing
Fordi Qwen3.8-Flash er meget billigere end flagskibsmodeller, er en praktisk arkitektur at rute det meste produktionstrafik til Flash og kun eskalere tvetydige, højrisiko- eller særligt vanskelige forespørgsler til Qwen3.8-Max eller en anden premium-model. Samlede gateways som CometAPI gør dette routingmønster lettere, fordi applikationen kan skifte udbydere bag én API-kontrakt.
Begrænsninger og forbehold
- Benchmarks er selvrapporterede. Nogle bruger Qwen-valgte harnesses, in-house-opgaver eller værktøjsaktiverede indstillinger. Uafhængig verifikation er stadig vigtig.
- Ikke alle benchmarks er en sejr. DeepSeek V4 Flash fører NL2Repo-Bench i den officielle sammenligning, og Claude Opus 4.6 fører HLE.
- Computerbrug er stadig svært i absolutte termer. Udgivelsen rapporterer en OSWorld 2.0-binær score på 19.4, selvom delkredit-ydelsen er meget højere.
- Hostet og open-weight-adfærd kan afvige. Systemprompter, værktøjer, kontekststyring, kvantisering, serving-stack og udbyderopdateringer kan flytte real-world-resultater væk fra den publicerede Flash-Next-benchmarkopsætning.
- Priser er dynamiske. Lanceringsannoncen og aktuelle aggregator-sider kan vise lidt forskellige referencepriser. Brug live-endpoint-prisen, når du budgetterer.
Sådan bruger du Qwen3.8-Flash API med CometAPI
CometAPI eksponerer Qwen3.8-Flash via et OpenAI-kompatibelt endpoint, så eksisterende OpenAI SDK-integrationer kan typisk skifte ved at ændre API-nøgle, base-URL og model-ID.
Hvorfor bruge CometAPI til Qwen3.8-Flash?
CometAPI giver udviklere et samlet API-endpoint til at teste Qwen3.8-Flash sammen med andre modeller uden at vedligeholde separate udbyderintegrationer. Det er særligt nyttigt til benchmark-sammenligninger, fallback-routing og omkostningsbaseret modelvalg.
- Opret en CometAPI API-nøgle. Generér en nøgle i CometAPI-dashboardet og gem den i en miljøvariabel frem for i kildekoden.
- Brug den samlede base-URL. Sæt SDK’ens base-URL til
https://api.cometapi.com/v1. - Vælg modellen. Brug qwen3.8-flash som model-ID.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[
        {"role": "system", "content": "You are a precise coding assistant."},
        {"role": "user", "content": "Review this API design and identify reliability risks."},
    ],
)

print(response.choices[0].message.content)
cURL
curl "https://api.cometapi.com/v1/chat/completions" \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-flash",
    "messages": [
      {"role": "user", "content": "Summarize the main risks in this migration plan."}
    ]
  }'
For production, add timeout handling, retry policy, token limits, structured output validation, and model-routing telemetry. If your workflow is agentic, track tool-call failures and accepted-task rate in addition to raw model latency.
Ofte stillede spørgsmål
Er Qwen3.8-Flash open source?
Produktionsruten Qwen3.8-Flash er en hostet API. Dens open-weight-modpart, Qwen3.8-Flash-Next, har vægte udgivet på Hugging Face og ModelScope. “Open-weight” er den mere præcise betegnelse, fordi brugsrettigheder afhænger af modellens licens.
Hvad er Qwen3.8-Flash kontekstvinduet?
Den åbne model understøtter 262.144 tokens native og kan udvides til 1.000.000 tokens med YaRN. Alibaba siger, at produktionsservicen Qwen3.8-Flash bruger en 1M-token kontekst som standard.
Hvor mange parametre har Qwen3.8-Flash?
Udgivelsen har en 125B-parameter hovedmodel, 51B N-gram-embedding-parametre og 6B aktiverede parametre pr. token. Det lave antal aktiverede parametre er centralt for dens effektivitetsdesign.
Understøtter Qwen3.8-Flash billeder?
Ja. Udgivelsen er multimodal, open-weight-deployment-stakken understøtter tekst og vision, og officielle integrationseksempler viser tekst- og billedeinput for den hostede model. Udbyderspecifikke overflader kan eksponere forskellige modalitetskombinationer, så tjek den aktuelle API-kapabilitetsside før deployment.
Er Qwen3.8-Flash bedre end Qwen3.8-Max?
Ikke universelt. Qwen3.8-Flash er det bedre valg, når latenstid, aktiv beregning og pris betyder noget. Qwen3.8-Max er flagskibsversionen til de hårdeste langhorisont- og højværdiafgaver. Et routing-system kan bruge begge.
Hvad koster Qwen3.8-Flash?
Alibaba annoncerede $0.16/M input og $0.47/M output tokens for QwenCloud ved lancering. CometAPI viser aktuelt cirka $0.12/M input og $0.376/M output. Tjek livepriser, fordi udbyder- og aggregatorrater kan ændre sig.
Konklusion
Qwen3.8-Flash er et af de klareste eksempler på det aktuelle skifte fra “større model” til “bedre systemøkonomi.” Dens 125B-hovedrygrad ser stor ud på papiret, men modellen aktiverer kun 6B parametre pr. token og tilføjer kapacitet via opslag-stil N-gram-indlejringer. QSA, Gated Residual, ultrasparsom MoE-routing og et lang-kontekst-orienteret serving-design trækker alle i samme retning: levere agentisk kodning og multimodal kapabilitet uden flagskibsniveauets inferensomkostning.
Udgivelsesresultaterne er særligt overbevisende for software engineering, kontoragenter, værktøjsbrug og visuelle workflows. Samtidig er modellen ikke ensartet overlegen: DeepSeek V4 Flash vinder mindst én repo-genererings-benchmark i Qwens egen tabel, Claude Opus 4.6 er fortsat stærkere på HLE, og Qwen3.8-Max er stadig det mere kapable Qwen-lag.
For udviklere er det mest praktiske næste skridt at evaluere Qwen3.8-Flash på reelle opgaver og sammenligne pris pr. accepteret resultat mod Gemini 3.7 Flash, DeepSeek V4 Flash og premium-modellerne i din routing-stack. CometAPI giver én OpenAI-kompatibel grænseflade til den slags multi-model-test og deployment.