
TLDR Qwens team hos Alibaba lancerede officielt Qwen3.8-Max den 3. august 2026 — en sparsom Mixture-of-Experts-model med i alt 2,4 billioner parametre (95 milliarder aktive), et kontekstvindue på 1 million tokens og indbygget multimodal (tekst + billede + video) understøttelse.
Det er den første Max-klasse Qwen-model, der er planlagt til åbne vægte (forventet ugen efter). Med en aggressiv pris på $2 pr. million inputtokens og $6 pr. million outputtokens leverer den stærke resultater på langhorisonterede agent-baserede opgaver, autonom softwareudvikling (inklusive et dokumenteret 16-dages selvforbedrende kodeprojekt), forskningsreplikation samt multimodale benchmarks. Den konkurrerer tæt med modeller som Kimi K3 og ligger over lettere muligheder som DeepSeek V4 Flash på kapabilitet, samtidig med at den er langt mere omkostningseffektiv end de førende vestlige frontier-modeller ved output-tunge workloads. Udviklere kan få adgang i dag via QwenCloud / Alibaba Cloud Model Studio og gennem samlede platforme som CometAPI.
Vigtigste pointer
- Skala og effektivitet: 2.4T total / 95B aktiv MoE-arkitektur bygget på Qwen 3.5-fundamentet muliggør frontier-niveau ydeevne til praktiske inferensomkostninger.
- Styrke på lang horisont: Demonstreret fler-dages autonom kodning (265 commits, 127 PRs over ~16 dage uden menneskelig indblanding), reproduktion + forbedring af forskningsartikler samt simuleret e-handel over et år.
- Benchmark-højdepunkter: PaperBench 93.0 (førende), Terminal Bench 2.1 86.6, stærke multimodale og dokumentresultater; konkurrencedygtig, men ikke dominerende, på alle rene kodningsagent-leaderboards versus Claude Fable 5 eller GPT-5.6 Sol.
- Prismæssig fordel: Flade $2 / $6 pr. 1M tokens på hele 1M-konteksten (cachet input ~$0.25), underbyder Kimi K3 på output og mange vestlige modeller.
- Tilgængelighed: Live på QwenCloud og Alibaba Cloud Model Studio (OpenAI- og Anthropic-kompatible API'er); åbne vægte planlagt; allerede listet på CometAPI som
qwen3.8-maxfor samlet adgang sammen med 500+ andre modeller. Åbne vægte kommer snarligt; en mindre Qwen3.8-27B-variant er også planlagt til praktisk lokal/edge-implementering. - Praktisk fordel: Udnytter end-to-end leveranceevne frem for enkelt-svar — ideel til kodeagenter, forskningspipelines, kontorarbejdsgange og vedvarende agent-loops.
Hvad er Qwen3.8-Max?
Qwen3.8-Max er Alibabas nyeste og mest kapable flagskibsmodel i Qwen-serien, officielt udgivet den 3. august 2026 (efter en midt-juli-forhåndsvisning på World AI Conference i Shanghai). Den repræsenterer et bevidst skifte mod modeller, der kan fuldføre komplekse, fler-dages opgaver end-to-end med minimal supervision og producere leveringsklare resultater.
Arkitektonisk er den en sparsom Mixture-of-Experts (MoE)-model, der skalerer til 2,4 billioner parametre i alt, hvoraf kun cirka 95 milliarder aktiveres pr. token. Dette design, bygget på Qwen 3.5-fundamentet, balancerer enorm kapacitet med inferenseffektivitet. Modellen understøtter et kontekstvindue på 1 million tokens (dokumenteret maks. input omkring 991K tokens og maks. output omkring 131K tokens), native multimodale input (tekst, billeder og video) og tekstoutput. Den inkluderer kontroller for ræsonneringsindsats (xhigh / medium / low) og understøtter både OpenAI Chat Completions og Anthropic-kompatible protokoller, hvilket gør den drop-in-kompatibel med populære agentrammer som Claude Code, Codex, Qoder CLI, Qwen Code og OpenClaw.
I modsætning til tidligere Max-klasse modeller, der forblev lukkede, har Alibaba forpligtet sig til at frigive vægtene for Qwen3.8-Max (og en mindre Qwen3.8-27B-variant) ugen efter lancering via Hugging Face og ModelScope — første gang en Max-tier Qwen-model bliver åbent tilgængelig.
Modellen er positioneret til kodeagenter, professionelt arbejde i virkeligheden (“cowork”), forskning, planlægning over lang horisont og multimodale agent-loops. Officielle demoer fremhæver selvforbedrende adfærd: modellen opretter issues, tildeler dem til sig selv, skriver og tester kode, itererer på feedback og forbedrer egne værktøjer over længere perioder.
Kilder: Officiel Qwen-blog og Alibaba Cloud-meddelelser (august 2026); Artificial Analysis modelkort; uafhængige anmeldelser, der opsummerer GA-udgivelsen.
Hvad er nyt i Qwen3.8-Max?
Sammenlignet med forgængeren Qwen3.7-Max leverer 3.8-generationen markante gevinster i agent-baseret kodning, pålidelighed over lang horisont, multimodal ræsonnering og dokument/kontorydelse. Centrale innovationer omfatter:
Ægte autonomi over lang horisont:
Modellen kan opretholde lukket-loop adaptiv læring over hundreder af ture eller flere dage. Dokumenterede eksempler inkluderer et 16-dages autonomt softwareprojekt, der producerede et selvforbedrende CLI-værktøj (oh-my-cli) med 265 commits, 127 pull requests og 151 issues helt uden menneskelig indgriben; reproduktion og forbedring af en forskningsartikels metodologi (inklusive GPU-træningsloops og målbare benchmark-gevinster); samt et fuldt simuleret års e-handelsdrift, som klart overgik baseline.
Multimodal som en kontinuerlig feedback-loop:
Vision er ikke kun en inputmodalitet. Modellen bruger visuel forståelse til planlægning, udførelsesmonitorering og selvkorrektion — hvilket muliggør opgaver som screenshot-til-kode-rekreation, interaktiv spil/animationsgenerering og 2D-til-3D-visualisering.
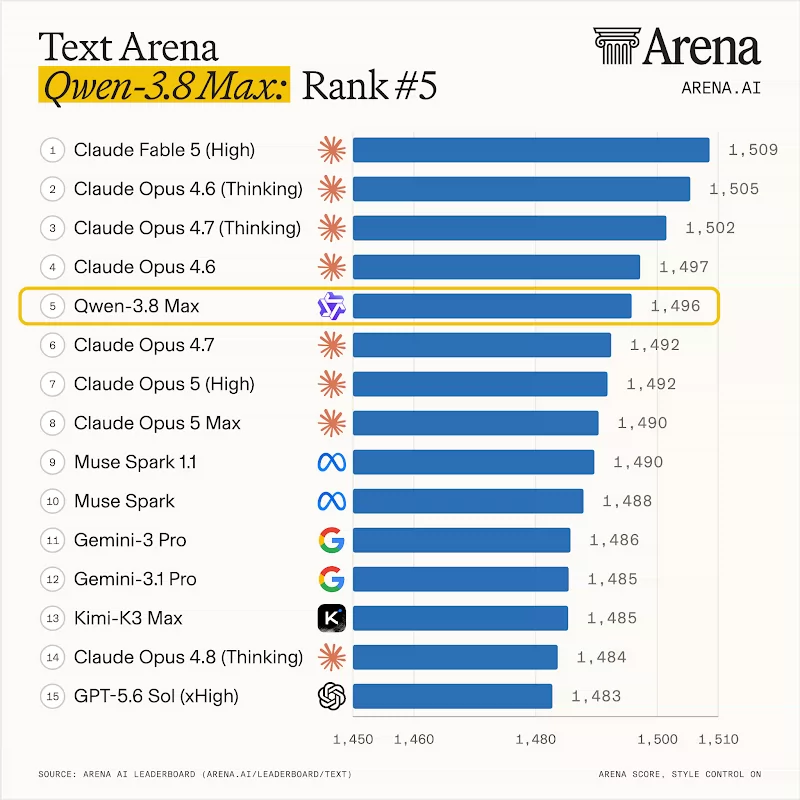
Modellen placerer sig højt på Text Arena (rapporteret som nummer fem) og Vision Arena (rapporteret som nummer to) i tidlige data efter udgivelse.

Fokus på end-to-end leverancer:
Vægt på at producere produktionsklare output på tværs af hundreder af professioner frem for isolerede svar.
Thinking og Fast Inference-tilstande
To tilstande: thinking mode og fast inference mode. Thinking mode er til dybere ræsonnering og kompleks planlægning. Fast mode er til lav-latens svar, når opgaven er enkel. Alibaba Cloud's OpenCode-dokumenter viser thinking aktiveret for Qwen3.8-ruterne og lister ræsonneringskontroller for preview-ruten, inklusive xhigh, medium og low.
Denne opdeling er værdifuld for produktdesign. Teams bør ikke bruge den tungeste ræsonneringstilstand til enhver forespørgsel. En supportbot kan klassificere en simpel sag billigt, opsummere med en hurtigere model og kun eskalere til Qwen3.8-Max thinking mode, når brugeren beder om en kompliceret afgørelse om politik, rodanalyse, kontraktgennemgang eller en plan for kodemigrering.
Disse kapabiliteter blev valideret gennem interne langkørende eksperimenter og et omfattende benchmark-sæt, der dækker kodeagenter, generelle agenter, multimodal ræsonnering, dokumentforståelse og perception/grounding-opgaver.
Benchmarking: Ydelse ved datakvantisering
Alibaba offentliggjorde et omfattende internt benchmark-sæt ved GA. Uafhængig verifikation (Artificial Analysis Intelligence Index, LMArena m.fl.) var stadig ved at indhente i dagene lige efter udgivelsen; tidlige Artificial Analysis-data placerede Qwen3.8-Max med en Intelligence Index på 53 (rang ~16/186 i det fulgte sæt), med bemærket høj verbositet og relativt lavere hastighed.
Udvalgte officielle/rapporterede score (Qwen3.8-Max vs. udvalgte peers):
| Benchmark | Qwen3.8-Max | Claude Fable 5 / Opus 4.8 | GPT-5.6 Sol (max) | Qwen3.7-Max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | 88.8 | 74.5 |
| PaperBench | 93.0 | 88.8 / 80.3 | 90.5 | 64.8 |
| SWE-bench Pro | 67.7 | 80.0 / 69.2 | 64.6 | 60.6 |
| FrontierSWE | 73.5 | 88.8 | — | 40.7 |
| DeepSWE 1.1 | 56.6 | 70.0 | 73.0 | 21.6 |
| IFBench | 82.8 | ~63.5 | — | 79.1 |
| GPQA Diamond | 92.6 | 92.6 | 94.1 | 92.4 |
| OmniDocBench 1.5 | 92.1 | — | — | — |
| OSWorld-Verified | 86.1 | — | — | — |
Qwen3.8-Max fører ofte eller placerer sig nær toppen på multimodal ræsonnering, dokument/kontoropgaver og visse agent-baserede kode-/forskningsmetrikker, mens den halter efter de stærkeste lukkede modeller på nogle rene software-engineering agent-suiter. Den generationsmæssige spring på FrontierSWE og DeepSWE er især bemærkelsesværdig. Betragt leverandørtal som vejledende; uafhængige kørsler og arbejdsbelastningsspecifik evaluering forbliver afgørende.
API-priser for Qwen3.8-Max
Officiel pris i Alibaba Cloud Model Studio / QwenCloud for Qwen3.8-Max (GA-satser primo august 2026):
- Input: $2,00 pr. 1 million tokens
- Output: $6,00 pr. 1 million tokens (inkluderer thinking/reasoning-tokens)
- Cachet input: cirka $0,25 pr. 1 million tokens (betydelige besparelser ved gentagne lange kontekster)
Prissætningen er flad på tværs af hele 1M-token-kontekstvinduet — en bemærkelsesværdig fordel i forhold til mange konkurrenter, der pålægger tillæg for lang kontekst. Masse- og andre rabatter kan gælde afhængigt af region og plan.
Sammenligningskontekst (anslåede listepriser i samme periode):
- Kimi K3: ~$3 / $15
- Højere ende Claude / GPT frontier-modeller: ofte $5+ / $15–25+
- DeepSeek V4 Flash-varianter: væsentligt lavere (ofte under $0,50 samlet for mange anvendelser)
For teams, der allerede bruger flere udbydere, tilbyder samlede gateways som CometAPI typisk ~20% rabat i forhold til officielle satser, et enkelt OpenAI-kompatibelt endpoint, samlet fakturering og let modelswitching eller failover. Dette gør eksperimenter med Qwen3.8-Max (og samtidig sammenligning mod DeepSeek V4 Flash, Kimi-modeller eller andre) operationelt enklere og ofte billigere. Tjek de aktuelle CometAPI-prissider og tilbud om gratis credits for de nyeste effektive satser.
Hvordan matcher Qwen3.8-Max Kimi K3 og DeepSeek V4 Flash
| Dimension | Qwen3.8-Max | Kimi K3 | DeepSeek V4 Flash |
|---|---|---|---|
| Samlede / Aktive parametre | 2.4T / ~95B | ~2.8T / ~104B | 284B / 13B |
| Kontekst | 1M | 1M | 1M |
| Multimodal | Tekst + Billede + Video | Tekst + Billede + Video | Kun tekst |
| Pris (ind/ud) | $2 / $6 | $3 / $15 | ~$0,14 / $0,28 (meget billigere) |
| Åbne vægte | Planlagt (næste uge) | Allerede frigivet | MIT, tilgængelig |
| Styrker | Autonomi over lang horisont, multimodal, PaperBench, pris på output | Stærke uafhængige score, fører på frontend-kodning Arena | Ekstrem omkostningseffektivitet, solid agent-kodning ift. størrelse |
| Relativ position | Konkurrencedygtig/førende på flere agent- og multimodale benchmarks | Let fordel på nogle auditerede intelligence-indekser | Fremragende værdi; lavere absolut kapabilitet |
Qwen3.8-Max matcher generelt eller overgår Kimi K3 på omkostningseffektivitet for output-tungt arbejde og multimodale opgaver, mens DeepSeek V4 Flash forbliver budgetkongen for højvolumen tekstarbejdsgange, hvor topkapabilitet er sekundær. Mange teams vil bruge alle tre via en samlet gateway, rute simpel trafik til Flash-klassen og komplekse agentsessioner til Qwen3.8-Max eller Kimi K3.
Matcher Qwen3.8-Max Kimi K3?
På nogle måder, ja. Den matcher 1M-kontekstniveauet, har stærk multimodal positionering og er billigere på standard officielle input/output-priser. Den matcher ikke Kimi K3's 2,8T samlede parameterantal, og Kimis offentlige dokumentation giver i øjeblikket særligt detaljerede retningslinjer for værktøjer, kontekstcaching, struktureret output og vision.
Matcher Qwen3.8-Max DeepSeek V4 Flash?
Den konkurrerer på 1M-kontekst og MoE-arkitektur, men produkterne er rettet mod forskellige opgaver. DeepSeek V4 Flash er den økonomiske, hurtige rute. Qwen3.8-Max er den større, højkapable rute til arbejde, hvor multimodal forståelse, avanceret ræsonnering og enterprise-produktivitet betyder mere end den lavest mulige tokenpris.
Hvad kan Qwen3.8-Max?
Kodning og softwareudvikling
Qwen3.8-Max er et stærkt bud til full-stack udvikling, code review, repo-forståelse, migrationsplanlægning, API-design, debugging, test-ræsonnering og softwarearkitektur. Den lange kontekst hjælper, når modellen skal have mange filer, logs og krav i syne. Brug den til svære kodeopgaver, ikke til hver autocomplete eller simpel lint-forklaring.
Kontor- og videnarbejde
Modellens “Cowork”-positionering er vigtig. Enterprise-medarbejdere stiller ikke kun chatspørgsmål. De sammenligner PDF'er, opsummerer møder, gennemgår slides, tolker regneark, tjekker kontrakter, skriver rapporter og forbereder beslutninger ud fra rodet evidens. Qwen3.8-Max's multimodale og langkontekst-design gør den velegnet til kontorarbejdsgange, hvor tekst, dokumenter, screenshots og strukturerede data skal ræsonneres over samlet.
Agent-baserede arbejdsgange
Qwen3.8-Max er nyttig til agentplanlægning: at bryde et mål ned i trin, beslutte hvilket værktøj der skal kaldes, evaluere resultater og revidere planen. I CometAPI bliver dette mere praktisk, fordi den samme applikation kan rute simple trin til billigere modeller og reservere Qwen3.8-Max til planlægning eller verifikation.
Kom godt i gang og tips til CometAPI-integration
- Direkte adgang: Brug QwenCloud eller Alibaba Cloud Model Studio med model-ID
qwen3.8-max. Både OpenAI-kompatible og Anthropic-kompatible endpoints understøttes. - Samlet adgang via CometAPI: Tilmeld dig på CometAPI.com, få en API-nøgle, sæt
base_urltilhttps://api.cometapi.com/v1, og kaldmodel="qwen3.8-max". Den samme nøgle virker til DeepSeek V4 Flash, Kimi K3, Claude, GPT og hundredvis af andre modeller — ideelt til eksperimenter, omkostningskontrol og produktionsrouting. CometAPI fremhæver konkurrencedygtige priser, lav latens og hurtig tilføjelse af nye modeller (Qwen3.8-Max blev listet kort efter lancering). - Agentrammer: Plug direkte ind i Claude Code, OpenClaw eller egne frameworks. Aktiver højere ræsonneringsindsats for komplekse opgaver over lang horisont.
- Åbne vægte: Følg med på Hugging Face / ModelScope for den kommende frigivelse, hvis du har behov for on-premise eller fintunede deployment.