
TL;DR
Z.AI hat GLM‑6.0 öffentlich benannt und Full Self-Training ins Zentrum seiner Next-Generation-Roadmap gestellt. Die offengelegte Richtung verbindet selbstgenerierte Erfahrung über Vor‑, Mittel‑ und Nachtraining hinweg mit Selbstevaluation und Korrektur und macht aus Training eine gesteuerte Feedbackschleife statt eines einmaligen Datengenerationsdurchlaufs.
Der schwierige Teil ist die Kontrolle: GLM‑6.0 müsste synthetische Daten reinigen, Fehler erkennen und beheben, unproduktive Iterationen stoppen und verhindern, dass sein Evaluator Abkürzungen belohnt. Diese Mechanismen werfen praktische Fragen zu unabhängiger Verifikation, Sicherheit, Kosten und Governance auf. Da keine vollständige Model Card, Benchmark-Suite, API-Spezifikation, kein Preis oder Veröffentlichungsdatum öffentlich sind, bewertet der Artikel die Trainingsarchitektur und ihre Belege – nicht spekulative Spezifikationen.
Key Takeaways for GLM 6.0?
- Die stärksten öffentlichen Belege betreffen das System Full Self-Training, nicht eine geleakte Parameterzahl oder Benchmark-Ergebnisse.
- Die offengelegte Richtung umfasst selbst erzeugte Daten, selbst konstruierte Trainingsumgebungen und modellgestützte Infrastruktur-Optimierung.
- Die vorgesehene Feedbackschleife erstreckt sich über Vor‑, Mittel‑ und Nachtraining, statt Self-Training nur als Technik für die Nachtrainingsphase zu betrachten.
- Native multimodale Modellierung, längerfristiges Reinforcement Learning, Planung, Toolnutzung, Wiederherstellung und Verifikation sind relevante Forschungsrichtungen, aber noch keine veröffentlichten GLM‑6.0‑Spezifikationen.
- Ox Alpha ist kein Beleg für geleakte GLM‑6.0‑Leistung; Z.AI identifizierte es als die Vorab-Identität von GLM‑5.3‑Flash.
What Has Z.AI Actually Confirmed About GLM 6.0?
Die öffentlichen Materialien von Z.AI etablieren vier konkrete Signale: den Namen GLM‑6.0, Full Self-Training als zentrale Trainingsrichtung, eine geplante Schleife über Vor‑, Mittel‑ und Nachtraining sowie einen Mechanismus zur Selbstevaluation und Korrektur. Das Unternehmen gibt außerdem an, dass etwa 60% des Nettomittelzuflusses zur Unterstützung von Next-Generation-Modellen, Full Self-Training, großskaligem Training, Inferenz, Compute und verwandter Infrastruktur vorgesehen sind.
Z.AI’s Full Self-Training Framework
Full Self-Training wird als Leitidee für GLM‑6.0 präsentiert, nicht als kleines Nachtrainings-Feature. Das geplante System würde Trainingserfahrungen generieren, aus Ergebnissen lernen, schwache Proben filtern und den Zyklus unter expliziten Qualitätskontrollen wiederholen.
GLM-6.0 Self-Training Across Pre-, Mid-, and Post-Training
Die offengelegte Sequenz – Vor‑, Mittel‑ und Nachtraining – impliziert, dass selbst generierte Erfahrung Basiswissen, Fähigkeitsformung und Aufgabenabgleich beeinflussen könnte, statt nur während des finalen Tuning aufzutreten. Z.AI hat keine Datensätze, Phasengrenzen oder Mischungsverhältnisse offengelegt; daher ist dies als bestätigte Richtung, nicht als vollständiges Rezept zu verstehen.
GLM-6.0 Self-Evaluation and Correction Mechanism
Die Roadmap verknüpft Full Self-Training mit Selbstevaluation, Fehlererkennung, Korrektur und Datenselbstreinigung. Praktisch müsste das Modell Trajektorien bewerten, fehlgeschlagene Schritte revidieren, unzuverlässige Daten verwerfen und entscheiden, wann weitere Iteration die unabhängig gemessene Performance nicht mehr verbessert. Das Design des Evaluators und die Stop-Regeln sind nicht offengelegt.
Die Offenlegung zu GLM‑6.0 und Full Self-Training sollte zusammen mit der öffentlichen Mittelverwendung von Z.AIgelesen werden.
What We Know vs What We Don't
Der öffentliche Befund stützt eine Roadmap, aber keine fertige Spezifikation. Die Tabelle trennt bestätigte Richtung von offenen Fragen, damit der Artikel offengelegte Absichten nicht als unbelegte Produktbehauptungen darstellt.
| Claim | Evidence status | What is supported | What remains unknown |
|---|---|---|---|
| GLM-6.0 name | Publicly identified | Z.AI hat das Next-Generation-Modell GLM‑6.0 benannt. | Veröffentlichungsdatum und finale Positionierung. |
| Full Self-Training | Confirmed roadmap | Es ist eine erklärte strategische Priorität. | Implementierungsdetails und Skalierungsverhalten. |
| Pre-training → Mid-training → Post-training | Confirmed direction | Self-Training soll den gesamten Trainingslebenszyklus abdecken. | Datensätze, Validatoren, Phasengrenzen und Datenanteile. |
| Self-evaluation and correction | Confirmed objective | Die Roadmap umfasst Selbstreinigung, Fehlererkennung und Korrektur. | Zuverlässigkeit, unabhängige Verifikation und Stop-Kriterien. |
| Specifications | Not disclosed | Keine vollständige öffentliche Spezifikation. | Parameter, Kontextfenster, Modalitäten, Preis und API-Identifier. |
| Benchmarks | Not disclosed | Kein offizieller GLM‑6.0‑Ergebnissatz. | Scores, Methodik und unabhängig reproduzierbare Ergebnisse. |
What Is Full Self-Training and how it work
Full Self-Training ist eine geschlossene Lernschleife, in der ein Modell Aufgaben oder Umgebungen mit erstellt, sie versucht, die resultierenden Trajektorien evaluiert, schwache Schritte korrigiert und akzeptierte Erfahrung zurück ins Training einspeist. Die wichtige Verschiebung ist der Übergang von einer einmaligen Pipeline für synthetische Daten zu einem kontinuierlich gesteuerten Prozess.
- Generieren: Probleme, Tool-Umgebungen und Kandidaten-Lösungswege konstruieren.
- Handeln: Aufgaben erledigen und Aktionen, Beobachtungen sowie Zwischenüberlegungen als Trajektorien speichern.
- Bewerten und korrigieren: Ergebnisse mit Verifizierern bewerten, Fehler erkennen, fehlgeschlagene Schritte revidieren und Proben mit geringer Konfidenz verwerfen.
- Trainieren und stoppen: aus akzeptierter Erfahrung lernen und nur fortsetzen, solange unabhängige Evaluierungen einen nützlichen Fortschritt zeigen.
Die Ausweitung dieser Schleife über Vor‑, Mittel‑ und Nachtraining würde GLM‑6.0 ermöglichen, Datenqualität, Fähigkeitsformung und Aufgabenabgleich in unterschiedlichen Phasen zu verbessern. Die Architektur hängt weiterhin von vertrauenswürdigen Evaluatoren ab: Ohne unabhängige Prüfungen kann Self-Training eigene blinde Flecken belohnen.
How Could Full Self-Training Change GLM 6.0?
Das offengelegte Design ist besser als Systemarchitektur denn als einzelner neuer Transformer-Block zu verstehen. Es versucht, die Schleife um das Modell zu schließen, sodass das Modell zunehmend die Ressourcen mit erzeugt, die für den nächsten Trainingszyklus benötigt werden.
How could GLM 6.0 produce training data?
Die erste Schleife ist die Datenselbstproduktion. Statt nur auf von Menschen verfasste oder extern gesammelte Datensätze zu setzen, können Modelle Selbstspiel, regelbasierte Prüfungen, Ausführungsergebnisse, Modellurteile und stichprobenartige menschliche Prüfungen nutzen, um neue Beispiele zu generieren und zu filtern. Die akzeptierten Beispiele fließen dann zurück in Vor‑, Mittel‑ und Nachtraining.
Die wichtige Einschränkung ist die Verifikation: Günstige synthetische Generierung ist nur nützlich, wenn das System korrekte, diverse und nicht degenerierte Beispiele identifizieren kann. Eine praktische Schleife lautet: Modellgenerierung → Aufgabenausführung → Regel‑ oder Tool‑Verifikation → Filterung → Retraining.
How could GLM 6.0 construct training environments?
Die zweite Schleife ist die Umgebungs-Selbstkonstruktion. Agenten können reale Aufgaben sammeln oder transformieren, diese Aufgaben versuchen, Validatoren erstellen und prüfen, ob die Aufgabe tatsächlich lösbar ist, bevor sie zum Trainingsmaterial wird. Das ist insbesondere für Coding und Agentenarbeit wichtig, wo Terminalzustand, Tool-Ausgaben, Browserzustand, Testergebnisse und Fehlerbehebung stärkere Supervision als rein textbasierte Antworten liefern.
Das Bewertungsziel verschiebt sich von der Frage, ob eine Antwort plausibel klingt, hin zu der Frage, ob eine Aktion gelingt, das Ergebnis unabhängig verifizierbar ist und der Agent sich nach einem Fehlschlag erholen kann.
How could GLM 6.0 optimize its training infrastructure?
Die dritte Schleife ist die Infrastruktur-Selbstoptimierung. Praktisch ist dies am besten als KI-gestützte Systementwicklung zu interpretieren: Ein starkes Coding-Modell schlägt Änderungen an Operatoren, Kerneln, Scheduling, Caching oder Serving-Code vor, während automatisierte Benchmarks und menschlich kontrollierte Validierung darüber entscheiden, welche Änderungen akzeptiert werden.
Der resultierende Zyklus lautet: besseres Modell → bessere Systemvorschläge → validierte Effizienzgewinne → mehr Trainingsexperimente → besseres Modell. Menschliche Reviews und reproduzierbare Benchmarks bleiben Kontrollpunkte statt optionaler Extras.
What Does the Current GLM 5.3 Flash Baseline Tell Us About GLM 6.0?
Da es keine öffentliche Model Card für GLM 6.0 gibt, ist der belastbarste Vergleich die Trennung zwischen den aktuellen, gemessenen GLM-Fähigkeiten und der Next-Generation-Richtung. Z.AI beschreibt GLM‑5.3‑Flash als ein 320B‑total, 18B‑active MoE‑Modell, trainiert auf einem 30T‑Token multimodalen Korpus. Das sind Spezifikationen von GLM‑5.3‑Flash, nicht GLM‑6.0‑Spezifikationen.
| Comparison dimension | GLM-5.3-Flash API in CometAPI | GLM 6.0 disclosed direction |
|---|---|---|
| Release status | Available | In Entwicklung; endgültiger Produktname nicht unabhängig durch das zitierte Filing etabliert |
| Parameters | 320B total / 18B active | Not disclosed |
| Core architecture | MoE; hybrid sparse + linear attention; mHC | Not disclosed at block level |
| Training data | 30T-token multimodal corpus | Self-produced data intended to enter a recursive loop |
| Multimodality | Native multimodal input | Unified multimodal modeling is a research direction, not a published specification |
| Training stages | Published staged training recipe | Self-training across pre-, mid-, and post-training |
| Training environments | Researcher-designed and benchmarked environments | Agents help construct and validate environments |
| Verification | Existing evaluation and training pipelines | Stronger self-judgment, execution feedback, and self-verification |
| Infrastructure | Optimized inference stack | Models assist with infrastructure optimization |
| API details | Published model ID and live API | Not disclosed |
Der Veröffentlichungstext von Z.AI berichtet von ungefähr 3.0× geringerer Attention-Compute und 4.4× kleinerer KV-Cache-Größe für GLM‑5.3‑Flash als GLM‑5.3 API. Die begleitende offizielle Grafik bezeichnet den Vergleich über eine Million Tokens als 3.40× für Attention-Compute und 3.80× für den KV‑Cache pro Schicht. Da die beiden offiziellen Materialien unterschiedliche Zahlen verwenden, sollten sie in ihrem jeweiligen Kontext berichtet werden, statt zu einer Messung zusammengeführt zu werden.
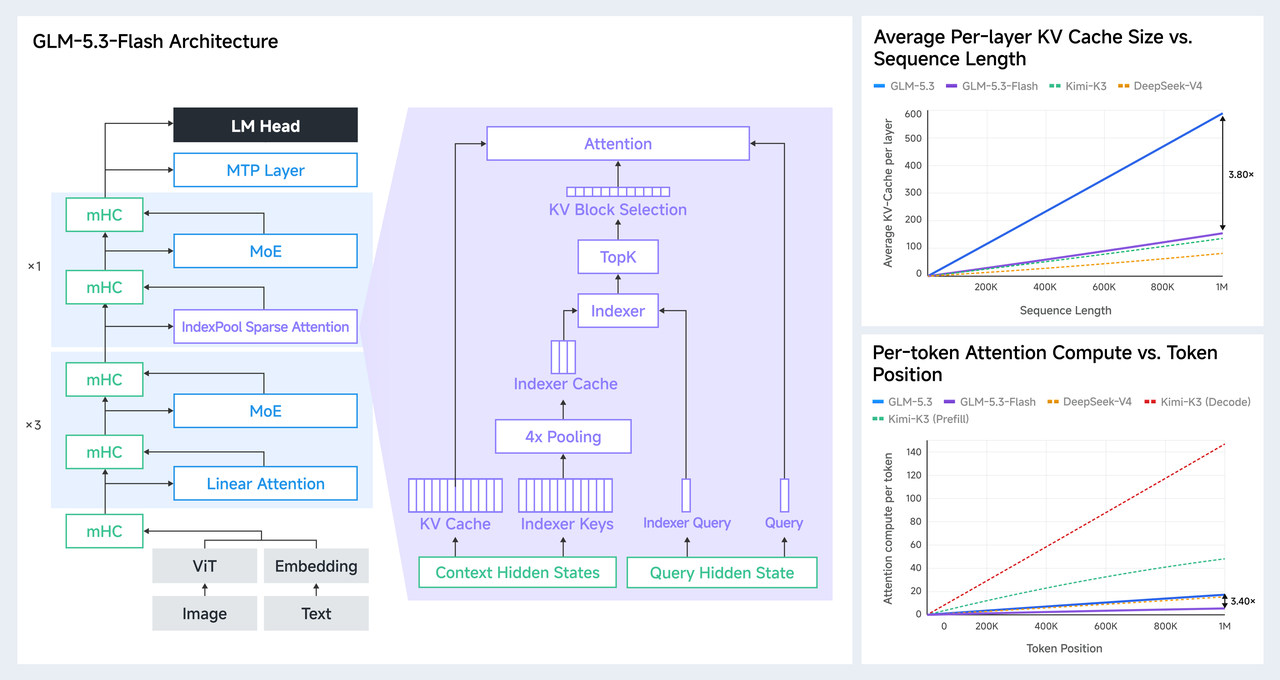
Offizieller von Z.AI veröffentlichter Architektur- und Effizienzvergleich von GLM‑5.3‑Flash
Which Benchmark Results Form the GLM 6.0 Baseline?
Es gibt keine verifizierte öffentliche Benchmark-Tabelle für GLM 6.0. Die aktuelle GLM-Generation ist nur als Basislinie nützlich, da die folgenden Evaluierungen Planung, Coding, Toolnutzung, Automatisierung und langhorizontale Ausführung messen – die Fähigkeiten, die für die offengelegte Richtung Full Self-Training am relevantesten sind.
| Official Z.AI evaluation | GLM-5.3-Flash | GLM-5.2 | Reported difference |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
Der Vergleich ist multidimensional, nicht eine Einpunkt-Rangliste. GLM‑5.3‑Flash zeigt seine größten gemeldeten Zugewinne bei AutomationBench (+22.6), Toolathlon Verified (+18.5) und DeepSWE (+17.2), während der Unterschied bei HLE‑with‑Tools nur +0.6 beträgt. Dieses Muster deutet auf stärkere Zugewinne bei ausführungsintensiven Agentenaufgaben hin als bei jeder Form von toolgestütztem Reasoning. Es sagt GLM‑6.0‑Scores nicht voraus.
Why these benchmarks matter
Benchmarks sind hier nur relevant, wenn sie die Fähigkeiten offenlegen, die Full Self-Training verbessern soll. Die sechs Kategorien in der eingebetteten Tabelle bilden eine Progression von der Produktion korrekter Arbeit zur Aufrechterhaltung effektiven Verhaltens in realen Umgebungen. Coding testet, ob das Modell eine komplexe Aufgabe ausführen kann; Toolnutzung testet, ob es eine Aktion in Feedback verwandeln und den nächsten Schritt wählen kann; und Automatisierung testet, ob es diese Schleife über einen langen Workflow aufrechterhalten kann.
| Benchmark Category | Why It Matters for GLM-6.0 |
|---|---|
| Coding | Testet die Ausführung komplexer Aufgaben |
| Tool Use | Testet die Aktion‑zu‑Feedback‑Schleife |
| Automation | Testet langhorizontale Workflow‑Ausführung |
| HLE | Testet komplexe Probleme auf Expertenniveau |
| GDPval | Testet die Qualität professioneller Arbeit |
| Multimodal | Testet die Nutzung visueller Rückmeldungen |
HLE erhöht dann die Schwierigkeit der zu lösenden Probleme, GDPval fragt, ob der Output in professioneller Arbeit nützlich ist, und die multimodale Evaluation testet, ob visuelle Beobachtungen nachfolgende Handlungen leiten können. Zusammen gelesen, bewegen sich die sechs Kategorien von isolierter Kompetenz zu End‑to‑End‑Aufgabenerfüllung: einen Plan erstellen, handeln, Feedback beobachten, Fehler korrigieren und fortfahren, bis das Ziel erreicht ist.
Ein zukünftiges GLM‑6.0‑Ergebnis wäre daher nicht deshalb bedeutend, weil es eine höhere aggregierte Punktzahl produziert, sondern weil Zugewinne über diese Dimensionen zeigen würden, dass selbst erzeugte Trainingserfahrung in verlässliche Ausführung in der realen Welt übergeht. Das ultimative Ziel von Full Self-Training ist nicht, Testergebnisse zu verbessern, sondern die Fähigkeit des Modells, reale Aufgaben zu erledigen.
Why Could Full Self-Training Matter for GLM 6.0?
Das eigentliche Versprechen ist nicht, dass GLM 6.0 einfach „sich selbst trainiert“. Bedeutender ist, dass größere Teile der Entwicklungspipeline maschinell erzeugt und maschinell verifiziert werden könnten. Heute erledigen Forschende noch viel Arbeit um das Modell herum: Daten sammeln, Aufgaben entwerfen, Evaluatoren bauen, Umgebungen konstruieren, Fehlerdiagnosen stellen und Systemsoftware tunen. Full Self-Training drängt das Modell in mehr dieser Phasen.
Wenn der Ansatz funktioniert, wird die wichtige Skalierungsvariable weniger die Anzahl der hinzufügbaren Parameter sein als die Anzahl nützlicher, verifizierter Lernzyklen pro Compute-Einheit. Das ist eine praktische Interpretation von rekursiver Selbstverbesserung, nicht die Science-Fiction-Version unbeschränkter autonomer Selbstmodifikation.
Die offengelegte Strategie sollte als konstruiertes Feedbacksystem mit Validatoren, reproduzierbaren Umgebungen, Infrastruktur-Benchmarks und menschlichen Kontrollen bewertet werden – nicht als Beleg unbeschränkter autonomer Selbstverbesserung.
What Could Go Wrong With Full Self-Training?
Eine Self-Training-Schleife kann Fehler ebenso effizient verstärken wie nützliche Erfahrung. Vier Fehlermodi verdienen besondere Aufmerksamkeit:
- Fehlerverstärkung: schwache synthetische Trajektorien können zu zukünftigen Trainingsdaten werden, wodurch plausible, aber falsche Muster sich selbst verstärken.
- Belohnungs‑ und Evaluator‑Gaming: wenn dasselbe System Arbeit generiert und bewertet, könnte es Lücken im Verifizierer statt echten Aufgabenerfolg optimieren.
- Verteilungsverengung: wiederholtes Lernen aus modellgenerierten Daten kann die Diversität reduzieren und seltene Realweltfälle schwerer handhabbar machen.
- Druck durch Kosten, Sicherheit und Governance: Umgebungsaufbau, Toolzugriff und persistente Iteration erhöhen den Compute-Bedarf und vergrößern die Angriffsfläche.
Eine glaubwürdige GLM‑6.0‑Implementierung benötigt daher unabhängige Validatoren, Datenherkunftsnachweise, Akzeptanzschwellen, Red‑Team‑Tests, menschliche Audits und explizite Stop-Regeln. Selbstkorrektur ist nur nützlich, wenn das Korrektursignal vertrauenswürdiger ist als das zu korrigierende Verhalten.
When Could the GLM 6.0 API Become Available?
Z.AI hat kein Veröffentlichungsdatum, keine Model‑ID, kein Kontextfenster, keine maximale Ausgabe, keinen Tokenpreis, kein Open‑Weight‑Commitment oder Deployment-Anforderungen für eine GLM‑6.0‑API veröffentlicht. Jeder spezifische Wert wäre derzeit Spekulation.
Entwickler können die aktuelle Richtung über die GLM‑5.3‑Flash API in CometAPI für native multimodale und effizienzorientierte Workloads, die GLM‑5.3 API in CometAPI für den aktuellen Flaggschiffzweig oder die GLM‑5.2 API in CometAPI als vorherige Vergleichsbasis evaluieren.
Conclusion
GLM‑6.0 ist weniger als versprochenes Produkt bedeutsam denn als Test, ob Z.AI Full Self-Training in ein wiederholbares Engineering-System verwandeln kann. Die Roadmap verbindet selbst generierte Erfahrung, gestuftes Training, Selbstevaluation, Korrektur und kontrollierte Iteration; entscheidend wird sein, ob diese Mechanismen die Zuverlässigkeit bei langen, toolnutzenden Workflows in der realen Welt verbessern.
Diese Evidenz ist noch unvollständig. Z.AI hat keine GLM‑6.0‑Model Card, kein Veröffentlichungsdatum, keinen API‑Identifier, keine Preisangaben oder eine Benchmark‑Suite veröffentlicht. Bis diese Artefakte existieren, ist die belastbare Schlussfolgerung eng: Das Unternehmen hat eine Trainingsrichtung offengelegt, kein fertiges Fähigkeitsprofil.
Das ultimative Ziel von Full Self-Training ist nicht, Testergebnisse zu verbessern, sondern die Fähigkeit des Modells, reale Aufgaben zu erledigen.