
Zusammenfassung
GPT-6 Astra erzielt außergewöhnliche Spitzenergebnisse. Die größten Zugewinne zeigen sich dort, wo Schlussfolgern in Handlungen umgesetzt werden muss: Terminal-Bedienung, Software-Nutzung, Automatisierung, Retrieval über lange Kontexte, wissenschaftliche Workflows und Cybersicherheit. Bei bereits gesättigten akademischen Tests ist der Fortschritt gegenüber der vorherigen OpenAI-Generation oft deutlich kleiner.
Das Modell kombiniert ein Kontextfenster mit 1.050.000 Token mit umfangreicher Tool-Unterstützung. OpenAIs veröffentlichte Ausführungsbenchmarks deuten darauf hin, dass das praktische Upgrade vor allem bei langfristigen Aufgaben am stärksten ist, aber Harness-Design, Reasoning-Aufwand, Latenz und Tool-Zugriff beeinflussen das Ergebnis wesentlich.
Wichtigste Erkenntnisse
- Astras deutlichste Zugewinne liegen in der agentischen Ausführung, nicht in jeder Form der Beantwortung von Fragen.
- Terminal-Bench, AutomationBench, Computerbedienung und Datenbankmigration zeigen wesentlich größere Bewegungen als GPQA oder DeepSWE.
- Das ARC-AGI-3-Ergebnis zeigt, dass Modellzustand, Kontextmanagement und das Evaluierungsharness die Endpunktzahl dominieren können.
- Ein großes Kontextfenster zählt nur, wenn Informationen nahe der Grenze weiterhin abrufbar bleiben; MRCR ist aussagekräftiger als die allein beworbene Kapazität.
- Höhere Tokenpreise bedeuten nicht automatisch höhere Aufgabenkosten, wenn das Modell weniger Token, Runden, Wiederholungen oder menschliche Korrekturen benötigt.
- Produktionsentscheidungen sollten Erfolgsrate, verstrichene Zeit, Gesamtkosten, Tool-Zuverlässigkeit und Korrekturaufwand gemeinsam vergleichen.
GPT-6 Astra auf einen Blick
OpenAI spezifiziert bis zu 128.000 Ausgabe-Token, Text- und Bild-Eingaben, Text-Ausgabe und Reasoning-Aufwand von low bis max. Diese Spezifikationen ermöglichen große, mehrstufige Workflows, beweisen jedoch nicht, dass ein Modell die richtigen Belege abruft oder eine Aufgabe zuverlässig abschließt.
| Offizielle Spezifikation | GPT-6 Astra in CometAPI | Praktische Bedeutung |
|---|---|---|
| Modell-ID | gpt-6-astra | Stabiler Bezeichner für API-Routing |
| Kontextfenster | 1.050.000 Token | Unterstützt große Repositories, Archive und Agentenverläufe |
| Maximale Ausgabe | 128.000 Token | Ermöglicht umfangreiche Berichte, Patches und strukturierte Artefakte |
| Wissensstichtag | 30. April 2026 | Spätere Fakten erfordern Tools oder bereitgestellte Quellen |
| Eingabe | Text und Bilder | Unterstützt Dokumente, Screenshots, Diagramme und gemischte Evidenz |
| Ausgabe | Text | Produziert Prosa, Code und strukturierte Texte |
| Reasoning-Aufwand | low, medium, high, xhigh, max | Tauscht Latenz und Kosten gegen tiefere Suche |
| Agentenfunktionen | Funktionsaufrufe, strukturierte Ausgaben, Computerbedienung, Web-/Dateisuche, gehostete Shell, Apply Patch, MCP | Ermöglicht End-to-End-Workflows statt isolierter Antworten |
| OpenAI Standard-Eingabe | $10 pro Million Token | Eingabegröße und Cache-Wiederverwendung beeinflussen die Gesamtkosten |
| OpenAI zwischengespeicherte Eingabe | $1 pro Million Token | Gilt, wenn das Prompt-Präfix aus dem Cache wiederverwendet wird |
| OpenAI Cache-Schreibvorgänge | $12.50 pro Million Token | Wird mit 1.25× der Rate für unzwischengespeicherte Eingaben abgerechnet |
| OpenAI Standard-Ausgabe | $50 pro Million Token | Ausführliche Ausgaben können die Aufgabenkosten dominieren |
| Anfragen über 272K Eingabe-Token | Eingabe- und Cache-Raten ×2; Ausgaberate ×1.5 | Die höheren Raten gelten für die gesamte Anfrage |
Ein Kontextlimit misst Kapazität, nicht nutzbaren Abruf. Eine Tool-Liste misst Verfügbarkeit, nicht erfolgreiche Ausführung. Benchmarks sind notwendig, um zu testen, ob diese Spezifikationen in abgeschlossene Arbeit übersetzt werden.
Was zeigen die Benchmark-Ergebnisse von GPT-6 Astra?
Das Portfolio zeigt ein uneinheitliches Muster. Astra liegt bei einigen akademischen und softwarebezogenen Reasoning-Tests kaum über Sol, erzielt jedoch zweistellige Zugewinne bei Terminal-Arbeit, Automatisierung, Datenbankmigration, visueller Interaktion, Langkontext-Retrieval und fortgeschrittener Mathematik.
| Veröffentlichung Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Es ergeben sich drei Cluster. Erstens deuten die 1,4-Punkte-Differenzen bei DeepSWE und GPQA auf begrenzte inkrementelle Bewegung bei Aufgaben hin, bei denen starke Modelle bereits gut abschneiden. Zweitens zeigen Zugewinne über 20 Punkte bei Terminal-Bench, AutomationBench, Datenbankmigration und Million-Token-Retrieval eine deutlich größere Veränderung in der Ausführung. Drittens ist ARC-AGI-3 ein Ausreißer, dessen Interpretation vom Harness abhängt.
Ergebnisse unabhängiger Tests
Artificial Analysis meldet für Astra und Sol etwa 61 auf seinem Intelligence Index, während es einen deutlich klareren Gewinn auf seinem Coding Agent Index zeigt. Dies bestätigt das Muster in OpenAIs Daten: Die größten Verbesserungen konzentrieren sich auf agentische Ausführung.
Bei maximalem Aufwand im Codex-Harness verwendet Astra Berichten zufolge etwa ein Drittel so viele Token wie Sol auf dem Coding Agent Index. Der Tokenverbrauch des Intelligence Index fällt nur um etwa 10%. Da Astras pro-Token-Rate höher ist, erzeugen diese beiden Effizienzprofile unterschiedliche Ökonomien.
| Unabhängige Bewertung | Beobachtetes Ergebnis | Interpretation für den Betrieb |
|---|---|---|
| Intelligence Index | Geringe Trennung von Sol | Breites Reasoning rechtfertigt möglicherweise keinen hohen Aufpreis |
| Coding Agent Index | Klarer agentischer Fortschritt | Weniger Token können eine höhere Tokenrate ausgleichen |
| AA-Omniscience | Halluzinationsrate fällt von 92% auf 51% bei max Aufwand | Besseres Enthalten kann für Recherche- und Retrieval-Systeme wichtig sein |
| Langfristige Wissensarbeit | Gemischte Fortschritte über Aufgaben hinweg | Lokale Evaluierung bleibt notwendig |
Kein unabhängiger Benchmark zertifiziert faktische Richtigkeit oder Sicherheit im Betrieb. Teams sollten richtige Antworten, gerechtfertigte Unsicherheit, unbelegte Behauptungen und Verstöße gegen Quellenvorgaben gesondert bewerten.
Warum eignet sich Astra besser für langfristige agentische Arbeit?
GPT-6 Astra fügt drei Steuerungen hinzu, die für Arbeit ausgelegt sind, die sich während der Ausführung verändert. Langzeit-Zuverlässigkeit hängt auch vom gesamten Kontektsystem ab: Das Kontextfenster bestimmt die Kapazität; Kompaktierung steuert, wie älteres Material verdichtet wird; persistentes Reasoning trägt relevanten Modellzustand weiter; Retrieval hält frühere Evidenz durchsuchbar; und die Anwendung muss wichtige Tool-Ausgaben, Testergebnisse, fehlgeschlagene Ansätze und Nutzeranforderungen bewahren. Diese Mechanismen sollten zusammen mit dem Agenten-Harness getestet werden.
- Asynchrone Tool-Aufrufe: Astra kann unabhängiges Reasoning fortsetzen oder andere Tools aufrufen, während eine Anwendung ein langlaufendes Tool ausführt.
- Mid-Turn-Steuerung: Eine Anwendung kann über WebSocket eine Korrektur oder neue Anforderung senden, ohne bereits geleistete Arbeit zu verwerfen.
- Mid-Conversation-Anpassung des Reasoning-Aufwands: Eine Konfigurationsaktualisierung kann den Reasoning-Aufwand erhöhen oder senken, während das gecachte Prompt-Präfix erhalten bleibt.
Wo GPT-6 Astra tatsächlich besser wird
Agentisches Coding: Terminal-Arbeit ist die größere Aufrüstung
Terminal-Bench 4.0 bewertet, ob ein Agent schwierige Terminal-Aufgaben durcharbeiten kann, statt nur eine isolierte Code-Antwort zu generieren. Astra erreicht 57,9%, 20,6 Prozentpunkte über Sol und 2,1 Punkte über Fable. Das ist ein erheblicher generationeller Fortschritt für OpenAI, aber ein deutlich engerer Vorteil gegenüber einem anderen frontier-agentischen System.
DeepSWE erzählt eine andere Geschichte: 74,1% für Astra und 72,7% für Sol. Die 1,4-Punkte-Differenz warnt davor, von einem Coding-Benchmark zu generalisieren. Astra scheint vor allem zu gewinnen, wenn Coding Interaktion mit der Umgebung, Iteration, Zustandserhaltung und Verifikation erfordert.
Database Migration Tasks verstärkt diese Interpretation. Das Ergebnis von 63,9% liegt 21,2 Punkte über Sol und 6,1 Punkte über Fable. Migrationsarbeit kombiniert Codeverständnis, Tool-Nutzung, Sequenzierung und operatives Urteilsvermögen – die Art von zusammengesetztem Workflow, bei dem kleine Reasoning-Verbesserungen sich zu deutlich größeren Completion-Gewinnen aufsummieren können.
Für Coding-Agenten sollten Modell und Harness gemeinsam evaluiert werden. Repository-Anweisungen, Terminal-Tools, Retry-Verhalten, Kontextbewahrung und Testausführung tragen alle zum gemessenen Ergebnis bei.
Computerbedienung: Erfolgsrate und Laufzeit zählen beide
Bei Agents’ Last Exam erzielt GPT-6 Astra 59,3%, verglichen mit 53,6% für GPT-5.6 Sol: ein Gewinn von 5,7 Prozentpunkten. Dies fügt den OSWorld 2.0- und ScreenSpot-Pro-Ergebnissen im obigen Benchmark-Überblick ein breiteres Agenten-Aufgabenergebnis hinzu.
Über die Genauigkeit hinaus liefert der OSWorld-Laufzeitvergleich eine weitere praktische Dimension: OpenAI berichtet etwa 40 Minuten pro Aufgabe für Astra gegenüber etwa 75 Minuten für Sol, also etwa 47% weniger verstrichene Zeit bei gleichzeitig erhöhter Erfolgsrate.
Ein Agent, der etwas häufiger erfolgreich ist und viel schneller fertig wird, kann die Durchsatzleistung stark steigern. Beschaffungstests sollten daher Erfolgsrate, verstrichene Zeit, Tool-Aufrufe, Wiederholungen und menschliche Interventionen berichten – nicht nur Genauigkeit.
Automatisierung und professionelle Arbeit
AutomationBench steigt von 18,1% auf 41,4%, ein Gewinn von 23,3 Punkten. Die absolute Punktzahl ist noch weit von perfekt entfernt, aber die Veränderung des Fehlerprofils ist aussagekräftiger als eine Ein-Punkt-Bewegung nahe der Sättigung. Bei BenchCAD erreicht Astra 95,9% und liegt 12,6 Punkte vor Sol und 11,6 Punkte vor Fable.
Diese Ergebnisse stützen eine spezifische Aussage: Astra ist besser darin, Anweisungen in Sequenzen validierter Aktionen umzusetzen. Sie beweisen nicht gleiche Zugewinne für jeden Geschäftsworkflow. Ein Produktionsprozess kann Authentifizierungs-Schritte, proprietäre Schnittstellen, uneindeutige Richtlinien oder Datenformate einführen, die im Benchmark fehlen.
Wissenschaft
Wissenschaft ist einer von Astras deutlichsten Fähigkeitsgewinnen. Bei FrontierMath Tier 4 v2 erreicht Astra 97,6%, verglichen mit 83,0% für Sol und 87,8% für Fable. Der Vorsprung von 14,6 Punkten gegenüber Sol ist erheblich, obwohl der Benchmark eine ausgewählte Aufgabenverteilung abdeckt und nicht den gesamten wissenschaftlichen Workflow misst.
Cybersicherheit
Cybersicherheit ist ein zweiter großer Gewinn, mit höherem Gewicht als eine gewöhnliche Ranglistenbewegung. Bei ExploitBench, der die Monate Juni bis August 2026 umfasst, erzielt Astra 39,0% gegenüber 5,5% von Sol. OpenAI berichtet, dass dieser neuere Satz sich auf Schwachstellen der vorangegangenen drei Monate konzentriert, um die historische Exposition zu reduzieren. In OpenAIs Cybersicherheitsbewertung zeigte Astra die Fähigkeit, zwei zuvor unbekannte Zero-Day-Schwachstellen während kontrollierter Tests zu entdecken und auszunutzen. Dieses Ergebnis ist wichtig, weil die Bewertung an kürzlich offengelegte Schwachstellen angepasst war, wodurch die Wahrscheinlichkeit verringert wurde, dass die Benchmark-Leistung einfach durch memorisierte Beispiele verursacht wurde. Das Ergebnis trug dazu bei, dass Astra OpenAIs kritischen Cybersicherheitsfähigkeitsschwellenwert erreichte und damit die erforderlichen Schutzmaßnahmen für den Einsatz verändert. Die Bedeutung liegt nicht darin, dass Astra in der Lage ist, uneingeschränkte Cyber-Operationen autonom durchzuführen, sondern darin, dass sein Fähigkeitsniveau die Anforderungen an Einsatz-Schutzmaßnahmen verändert. Systeme mit stärkerer Fähigkeit zur Schwachstellenentdeckung und -ausnutzung erfordern strengere Zugriffskontrollen, Monitoring, Sandboxing und Mechanismen zur menschlichen Prüfung.
Langlaufende Aufgaben: Das Kontextfenster ist nicht die ganze Geschichte
Astras Kontextfenster mit 1.050.000 Token beschreibt Kapazität, nicht Kontinuität. Langlaufende Leistung hängt auch von Kompaktierung, persistentem Zustand, durchsuchbarem früherem Kontext, behaltenem Reasoning-Zustand und der Bewahrung von Tool-Ausgaben ab. In MRCR v2 erzielt Astra 100,0% bei 256K–512K und 96,3% bei 512K–1M, während Sol 91,5% und 73,8% erreicht. Die 22,5-Punkte-Differenz im längsten Bereich zeigt, dass nutzbares Retrieval nahe der Grenze wichtiger ist als die allein beworbene Kapazität.
MRCR bleibt ein synthetischer Retrieval-Test, daher sollte die Produktionsevaluierung die Evidenz bewahren, die Zusammenfassungen oft verlieren: warum eine frühere Korrektur scheiterte, das Verhalten einer bestimmten Komponente, Testergebnisse, historische Anforderungen und Details, die in Tool-Ausgaben vergraben sind. Repositories und Forschungsarchive sollten auch mit doppelten Namen, Querverweisen, veralteten Richtlinien, widersprüchlichen Quellen und langen Ablenkerspannen getestet werden. Dies trennt rohe Kontextkapazität von der Kontextbewahrung und dem Retrieval-Verhalten, das ein langfristiger Agent tatsächlich benötigt.
Kontextbewahrung: warum Astra sich von traditionellen Langkontext-Systemen unterscheidet
Traditionelle Langkontext-Workflows folgen in der Regel einem Muster:
context → compaction → summary → continue
Dieser Ansatz reduziert den Tokenverbrauch, führt jedoch ein kritisches Risiko ein: wichtige Zwischeninformationen können während der Zusammenfassung verschwinden.
Die verlorenen Informationen sind oft nicht die endgültige Antwort selbst, sondern die betrieblichen Details, die für zukünftige Entscheidungen erforderlich sind:
- warum eine frühere Korrektur gescheitert ist;
- welche Komponente ein anomales Verhalten zeigte;
- welches Testergebnis die Implementierungsrichtung geändert hat;
- welche Nutzeranforderung später hinzugefügt wurde;
- welche Tool-Ausgabe wichtige Evidenz enthielt.
GPT-6 Astra adressiert diese Einschränkung, indem es Mechanismen zur Kontextbewahrung und zum Retrieval innerhalb langlaufender Agenten-Workflows kombiniert.
Anstatt sich nur auf komprimierte Zusammenfassungen zu verlassen, kann das System wichtige Notizen bewahren, frühere Informationen bei Bedarf abrufen und Kontinuität zwischen mehreren Tool-Interaktionen aufrechterhalten.
Für Coding-Agenten wie Codex bedeutet dies, dass eine lange Debugging-Aufgabe Folgendes behalten kann:
- frühere fehlgeschlagene Experimente;
- Repository-Änderungen;
- Testausgaben;
- Architekturentscheidungen;
- ungelöste Probleme.
Daher besteht der Wert von Astras 1M-Token-Kontextfenster nicht nur in der Menge an Informationen, die es aufnehmen kann, sondern darin, ob das System nach Stunden der Interaktion die richtigen Informationen bewahren und wiederherstellen kann.
Schlussfolgerung und Interpretation
ARC-AGI-3: Das Harness ist Teil des Ergebnisses
ARC-AGI-3 liefert den klarsten Beleg dafür, dass ein Frontier-Benchmark ein System und nicht ein isoliertes Modell messen kann. ARC Prize berichtet 62,7% mit dem Standard-Harness bei max Aufwand und 99,9% mit dem Provider Adapter bei high Aufwand.
| ARC Prize Bewertung | Standard-Harness | Provider Adapter | Adapter-Gewinn |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
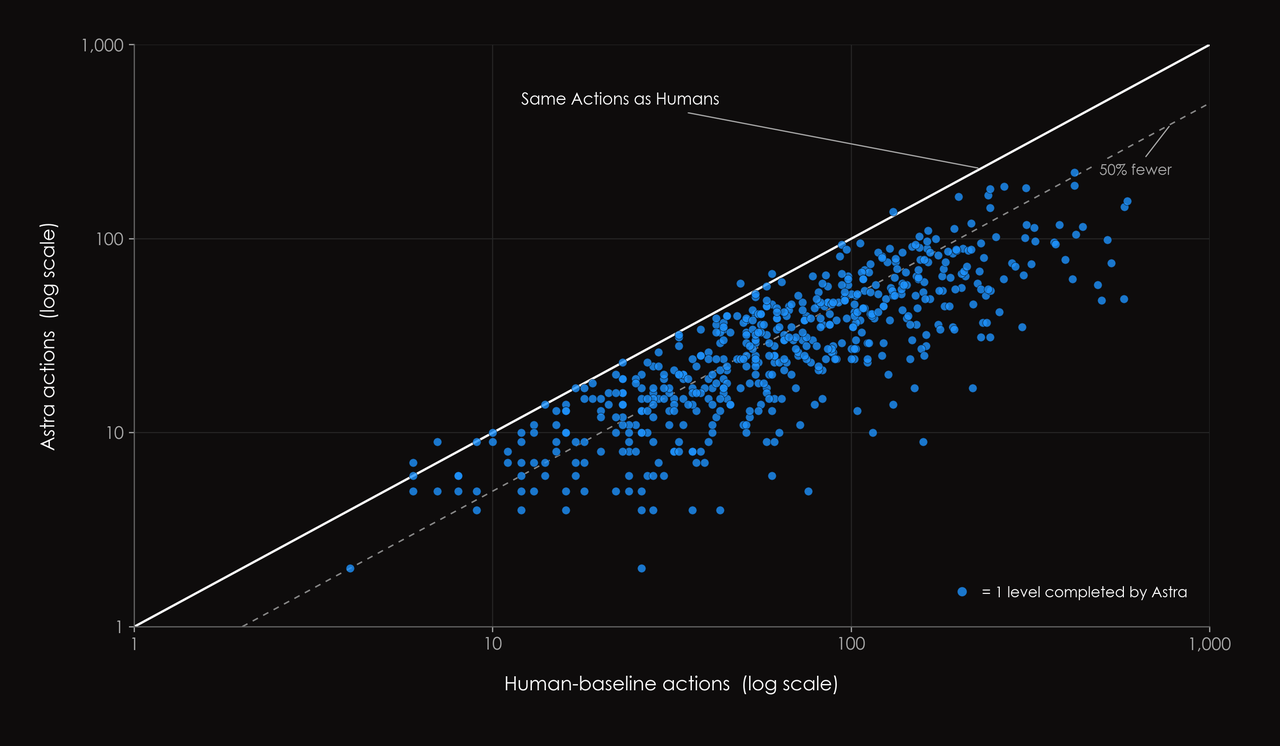
ARC-Prize-Vergleich der Aktions-Effizienz von Astra über Evaluierungsharnesses
Die anbieterneutrale Harness-Policy verlangt, dass das Modell wichtige Informationen im sichtbaren Zustand bewahrt. Der Provider Adapter hält zusätzlichen Reasoning-Zustand vor und verwendet anbieter-spezifisches Kontextmanagement. Über gemeinsam gelöste Spiel-Reasoning-Paare hinweg berichtet ARC Prize eine 3,66× schnellere Ausführung und 49% weniger Gesamt-Token mit dem Adapter.
Das 99,9%-Ergebnis misst ein spezifisches Modell–Provider–Adapter-System und sollte nicht als harness-unabhängiges Maß für rohe Modellintelligenz betrachtet werden. Kontextarchitektur ist Teil des getesteten Systems.
Reasoning-Aufwand skaliert nicht linear
Die ARC-Tabelle zeigt auch, dass maximaler Aufwand nicht immer die höchste Punktzahl liefert. High Aufwand erreicht 99,9% mit dem Provider Adapter, während max 98,6% erreicht. Im Standard-Harness performt max am besten.
OpenAI merkt an, dass die Launch-Tabellenwerte im Allgemeinen den besten beobachteten Reasoning-Setting verwenden. Dieser Ansatz schätzt eine Leistungsobergrenze, identifiziert jedoch nicht die beste Produktionskonfiguration. Teams sollten mehrere Aufwandsstufen testen und den marginalen Qualitätsgewinn pro zusätzlicher Sekunde und Dollar berechnen.
Mathematik und akademisches Schlussfolgern
FrontierMath Tier 4 v2 steigt von 83,0% auf 97,6%, ein Gewinn von 14,6 Punkten. Das ist ein großer Benchmark-Fortschritt, aber kein Beleg dafür, dass die frontier Mathematik gelöst ist. Die Evaluation umfasst eine ausgewählte Aufgabenverteilung und misst nicht jede Phase der mathematischen Forschung, einschließlich Problemselektion, formaler Beweisverifikation, langfristiger Programmentwicklung oder adversarialer Peer-Review.
GPQA Diamond liefert das Gegenmuster: 96,0% für Astra, 94,6% für Sol, 93,7% für Fable und 95,3% für Gemini 3.8 Flash. Die Modelle gruppieren sich eng nahe der Decke. Die 1,4-Punkte-Differenz Astra–Sol zu berichten ist korrekt, sie als breite Intelligenzrevolution zu bezeichnen, würde die Evidenz übertreiben.
Kritische Fähigkeit + Schutzmaßnahmen
| Cybersicherheitsbewertung | Astra | Sol | Absoluter Zuwachs |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, Juni–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI erstellte ExploitBench (Juni–August 2026) aus Schwachstellen, die in den vorangegangenen drei Monaten offengelegt wurden, wodurch die Chance reduziert wurde, dass die historische Schwachstellenexposition das Ergebnis künstlich erhöhte. Astra erzielt 39,0% auf diesem Satz gegenüber 5,5% von Sol, und OpenAI berichtet, dass Astra zwei zuvor unbekannte Zero-Day-Schwachstellen gefunden und ausgenutzt hat. Diese Ergebnisse trugen dazu bei, dass Astra das erste breit eingesetzte Modell von OpenAI wurde, das die Schwelle der kritischen Cybersicherheitsfähigkeit erreichte, was Schutzmaßnahmen und Zugriffsrichtlinien direkt beeinflusste.
Wie man Ergebnisse nahe der Sättigung liest
Ergebnisse über 90% erfordern eine sorgfältigere Sprache als Ergebnisse im mittleren Bereich. Der Sprung von 50% auf 60% löst zehn zusätzliche Aufgaben pro hundert. Der Sprung von 95% auf 96% löst nur eine zusätzliche Aufgabe pro hundert, obwohl er die verbleibende Fehlerzahl von fünf auf vier reduziert – eine Reduktion der Fehler um 20%. Beide Beschreibungen sind mathematisch korrekt, unterstützen jedoch sehr unterschiedliche Überschriften.
Die entgegengesetzte Vorsicht gilt für niedrig bewertete Benchmarks. Ein Anstieg von 18,1% auf 41,4% bleibt weit unter zuverlässiger autonomer Ausführung, verdoppelt jedoch mehr als die Zahl der erfolgreichen Fälle und kann einen beaufsichtigten Workflow transformieren. Die absolute Punktzahl bestimmt, ob das System bereit ist; die Größe der Verbesserung zeigt, wie schnell sich die Fähigkeit verändert. Produktionsentscheidungen brauchen beides.
Ein multidimensionaler Vergleich
| Dimension | Astra | Sol | Fable | Entscheidungssignal |
|---|---|---|---|---|
| Allgemeines akademisches Reasoning | Exzellent; oft nahe der Sättigung | Knapp dahinter | Wettbewerbsfähig | Kleine Lücken entscheiden selten allein den Einsatz |
| Terminal-Ausführung | Spitzenklasse | Großer generationeller Abstand | Enger Wettbewerber | Das gesamte Coding-Harness testen |
| Computerbedienung | Höhere Erfolgsrate und geringere Laufzeit | Langsamer und weniger akkurat | Unzureichende vergleichbare Daten in der Launch-Tabelle | Erfolg pro Stunde messen |
| Langkontext-Retrieval | Stark nahe 1M Token | Materielle Degradation nahe der Grenze | Unzureichende direkt vergleichbare Daten | Produktionsnahe Retrieval-Tests verwenden |
| Reasoning-Steuerung | low bis max | Unterschiedlicher Aufwandrahmen | Ansatz mit adaptivem Denken | Konfiguration, nicht nur Modellname, abstimmen |
| Cyber-Fähigkeit | Qualitativ höhere Risikostufe | Niedrigere veröffentlichte Ergebnisse | Hier nicht verglichen | Schutzmaßnahmen und Zugriffsrichtlinien sind wichtig |
| Token-Ökonomie | Höhere Rate; teils weniger Token | Niedrigere Rate | Vom Workload abhängig | Kosten pro erfolgreicher Aufgabe vergleichen |
Das Ergebnis ist vom Workload abhängig. Astra ist am überzeugendsten, wenn die Aufgabe eine nachhaltige Interaktion mit Tools und Umgebungen, Erholung nach Fehlern oder zuverlässiges Retrieval über sehr große Kontexte erfordert. Sol kann für begrenzte Arbeit mit moderatem Kontext und begrenzter Iteration wirtschaftlicher bleiben. Fable ist ein enger Wettbewerber bei Terminal-Arbeit und führt einige externe akademische Bewertungen an, daher ist ein anwendungsbezogener Benchmark nützlicher als ein anbieterbezogenes Fazit.
Wer sollte GPT-6 Astra verwenden?
| Anwendungsfall | Empfehlung |
|---|---|
| Einfache Klassifikation | Nicht unbedingt Astra verwenden |
| Einfache Zusammenfassung | Nicht unbedingt Astra verwenden |
| Standard-RAG | Kosten vs. Leistung zuerst benchmarken |
| Langdokument-Synthese & -Analyse | Astra testen |
| Agentisches Coding | Dringend empfohlen zu testen |
| Computerbedienung | Dringend empfohlen zu testen |
| Mehrschritt-Automatisierung | Dringend empfohlen zu testen |
| Komplexe Recherche | Testen lohnt sich |
| Wissenschaftliches Rechnen / Spezialsoftware | Testen lohnt sich |
| Cybersicherheit | Starke Fähigkeiten, erfordern jedoch geeignete Schutzmaßnahmen |
| Hoher Durchsatz, einfache Aufgaben | Niedrigere Kostenmodelle können kosteneffizienter sein |
Rechtfertigen die Leistungsgewinne von GPT-6 Astra den höheren Preis?
GPT-6 Astra ist deutlich teurer als GPT-5.6 Sol, aber die Benchmark-Verbesserungen sind nicht gleichmäßig über Workloads verteilt. Die Preisfrage kann daher nicht durch den Vergleich der Token-Raten allein beantwortet werden.
| Szenario | Leistungszuwachs | Kostenbegründung |
|---|---|---|
| Einfaches Q&A | Geringe Verbesserung | Meist den Aufpreis nicht wert |
| Coding-Agent | Großer Fortschritt | Aufpreis kann gerechtfertigt sein |
| Langkontext-Analyse | Signifikante Verbesserung | Hängt von Retrieval-Bedarf ab |
| Computer-Automatisierung | Starke Verbesserung | Oft einen Test wert |
| Allgemeines Reasoning | Begrenzte Verbesserung | Kosten sorgfältig vergleichen |
Zu OpenAI-Standardraten kostet GPT-6 Astra $10 pro Million Eingabe-Token, $1 pro Million zwischengespeicherter Eingabe-Token, $12.50 pro Million Cache-Schreib-Token und $50 pro Million Ausgabe-Token. Standard-Eingabe und -Ausgabe sind 2,5× die $4- und $20-Raten für GPT-5.6 Sol. Wenn eine Anfrage 272K Eingabe-Token überschreitet, verdoppeln sich bei Astra die Eingabe- und Cache-Raten und die Ausgaberate steigt um 1,5× für die gesamte Anfrage.
Der Preisaufschlag passt am deutlichsten zu agentischer Arbeit. Astra gewinnt über 20 Prozentpunkte bei Terminal-Bench, AutomationBench, Datenbankmigration und MRCR im längsten Bereich; unabhängige Tests berichten zudem etwa ein Drittel des Tokenverbrauchs von Sol auf dem Coding Agent Index. Die Übereinstimmung ist bei breitem Reasoning schwächer, wo der Intelligence Index nahezu gleichauf liegt und der Tokenverbrauch nur um etwa 10% fällt. Die Kaufentscheidung sollte daher die Kosten pro erfolgreicher Aufgabe vergleichen, einschließlich Ausgabe, Cache-Aktivität, Tool-Nutzung, verstrichener Zeit, Wiederholungen, Fehlschläge und menschlicher Korrekturen.
Kosten pro erfolgreicher Aufgabe
Kosten pro erfolgreicher Aufgabe = (Eingabekosten + Ausgabekosten + Tool-Kosten + Retry-Kosten + Kosten der menschlichen Prüfung) / Erfolgreiche Aufgaben
Erwartete Geschäftskosten
Erwartete Geschäftskosten = API-Kosten + Tool-Kosten + Retry-Kosten + Kosten der menschlichen Prüfung + Fehlerkosten
Die Entscheidungsmetrik sollte die Gesamtkosten geteilt durch erfolgreiche Aufgaben sein, bewertet bei einem akzeptablen Qualitätsniveau – nicht der Listenpreis pro Million Token.
Wie Entwickler Astra benchmarken sollten
Öffentliche Ranglisten sollten bestimmen, was man testen sollte, nicht die endgültige Einsatzentscheidung treffen. Erstellen Sie einen repräsentativen Aufgabensatz mit Routinefällen, schweren Fällen, Fällen mit fehlendem Kontext, Tool-Fehlern und adversarialen Anweisungen. Verwenden Sie für jedes Modell denselben Produktions-Prompt, Berechtigungen, Quelldateien, Zeitbudget und Abschlusskriterien.
| Bewertungsdimension | Messgröße | Warum es wichtig ist |
|---|---|---|
| Aufgabenerfolg | Akzeptanzkriterien bestanden | Verhindert, dass überzeugende, aber unvollständige Antworten als Erfolg zählen |
| Zuverlässigkeit | Erfolgsverteilung über wiederholte Läufe | Deckt instabile Einzelsiege auf |
| Tool-Ausführung | Verifizierte erfolgreiche Aktionen | Trennt Tool-Aufrufe von korrekten Ergebnissen |
| Faktizität | Unterstützte Fakt-Aussagen | Misst Evidenzqualität und Enthalten |
| Latenz | Median- und Tail-Abschlusszeit | Erfasst operationellen Durchsatz |
| Kosten | Gesamtkosten pro erfolgreicher Aufgabe | Enthält Wiederholungen und fehlgeschlagene Versuche |
| Menschlicher Aufwand | Korrekturen und Prüfminuten | Dominiert oft die realen Einsatzkosten |
| Steuerbarkeit | Erholung nach geänderten Anforderungen | Testet das Verhalten von langlaufenden Agenten |
Die Astra-API in CometAPI verwendet die Modell-ID gpt-6-astra. Eine Multi-Modell-API macht es praktikabel, dieselbe Evaluierung über Astra, Sol, Fable und Gemini auszuführen, ohne den Benchmark um die Schlagzeile eines einzelnen Anbieters neu zu gestalten. Leiten Sie anspruchsvolle agentische Aufgaben an das Modell, das seinen Aufpreis verdient, und nutzen Sie kostengünstigere Modelle dort, wo der gemessene Vorteil verschwindet.
Fazit
Astras Benchmark-Blatt ist beeindruckend, aber die spektakulärsten Ergebnisse sind nicht automatisch die nützlichsten. ARC-AGI-3 demonstriert das Potenzial eines anbieter-spezifischen Agenten-Harness; die Standard-Harness-Punktzahl zeigt, wie stark die Infrastruktur beiträgt. GPQA und der unabhängige Intelligence Index zeigen, dass gewöhnliche Reasoning-Gewinne moderat sein können. Terminal-Arbeit, Automatisierung, Computerbedienung, Langkontext-Retrieval, wissenschaftliche Workflows und Cybersicherheit erzählen die wichtigere Geschichte.
Der Release handelt weniger davon, dass ein Chatbot proportional bei jeder Frage „intelligenter“ wird, und mehr davon, dass frontier Intelligenz besser darin wird, Arbeit zu vollenden. Ob sich dieses Upgrade lohnt, hängt von der gesamten Modell-System-Konfiguration und der Ökonomie erfolgreicher Produktionsaufgaben ab.