
TL;DR
DeepSeek V4.1 Flash ist DeepSeeks effizienzorientiertes multimodales Modell für Coding, Reasoning, Agents und Long-Context-Workloads. Die offizielle technische Dokumentation beschreibt ein 552B Mixture-of-Experts-Design mit 8B aktiven Parametern für Input und 16B für Output, dazu native Bildverständnis-Fähigkeiten und einen deutlich kleineren KV-Cache-Footprint.
Für Entwickler, die die DeepSeek V4.1 Flash API über CometAPI nutzen, ist die Integration in der Praxis OpenAI-kompatibel: Verwenden Sie https://api.cometapi.com/v1 als Base-URL, setzen Sie das Modell auf deepseek-v4.1-flash und rufen Sie die standardmäßige Chat Completions-Schnittstelle auf.
Ein wichtiger Namensunterschied: Die erstparteige DeepSeek-API verwendet deepseek-flash, während CometAPI deepseek-v4.1-flash nutzt. Behandeln Sie Modellbezeichner als anbieterabhängige Konfiguration.
Zentrale Erkenntnisse
- DeepSeek V4.1 Flash kombiniert ein 552B-MoE-Backbone, natives Bildverständnis und ein asymmetrisches Input-/Output-Rechenprofil.
- In CometAPI verwenden Sie deepseek-v4.1-flash; in der erstparteigen DeepSeek-API verwenden Sie deepseek-flash.
- CometAPI veröffentlicht Basispreise ab $0.12/M Input-Tokens, während DeepSeeks Off-Peak-Cache-Miss-Inputpreis $0.15/M beträgt.
- Die größten gemessenen Unterschiede konzentrieren sich auf Benchmarks zu Coding, Terminal, Repository, Automatisierung und Tool-unterstützten Agents.
- Vor dem Produktions-Rollout erweiterte Felder wie Thinking-Steuerungen, Vision-Payloads, Streaming, Tool-Aufrufe und strukturierte Ausgaben genau auf derjenigen Provider-Route validieren, die Sie deployen.
Was ist die DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash ist das neueste Flash-Modell auf einer Mixture-of-Experts-Architektur mit 552B Parametern. Das kausale Encoder-Decoder-Design aktiviert 8B Parameter für die Eingabeverarbeitung und 16B für die Ausgabeerzeugung.
Für die Integrationsplanung stellt die offizielle DeepSeek-API ein Kontextfenster von 1M Tokens und eine maximale Ausgabe von 384K Tokens bereit. Der Upstream-Dienst unterstützt OpenAI-kompatible Chat Completions- und Responses-APIs, eine Anthropic-kompatible API, Streaming, JSON-Ausgabe, Tool-Aufrufe und native Bild-Inputs. Dieser Leitfaden verwendet die CometAPI-Route für Chat Completions; prüfen Sie daher vor dem Produktionseinsatz die Feature-Durchleitung auf dieser Route.
| Spezifikation | Details der offiziellen DeepSeek V4.1 Flash API |
|---|---|
| Architektur | 552B MoE, kausaler Encoder-Decoder |
| Aktive Parameter | 8B für Input; 16B für Output |
| Kontextlänge | 1M Tokens |
| Maximale Ausgabe | 384K Tokens |
| Schnittstellen | Chat Completions, Responses-API, Anthropic-kompatible API |
| Streaming | Unterstützt |
| Strukturierte Ausgabe | JSON-Ausgabe und JSON Schema über unterstützte Endpunkte |
| Tool-Aufrufe | Unterstützt, inkl. Tool-Nutzung im Thinking-Modus |
| Vision-Input | JPEG, PNG, GIF und WebP |
| Bildlimits | 32 MiB inline; 64 MiB pro Datei; bis zu 600 Bilder/Request |
| Erstparteige Modell-ID | deepseek-flash |
| CometAPI Modell-ID | deepseek-v4.1-flash |
Hinweis des Anbieters: Modell-IDs und erweiterte Request-Felder sind route-spezifisch. Verwenden Sie deepseek-v4.1-flash für CometAPI-Beispiele in diesem Leitfaden und testen Sie Vision, Tool-Aufrufe, strukturierte Ausgabe und Thinking-Steuerungen auf dem tatsächlich eingesetzten Endpoint.
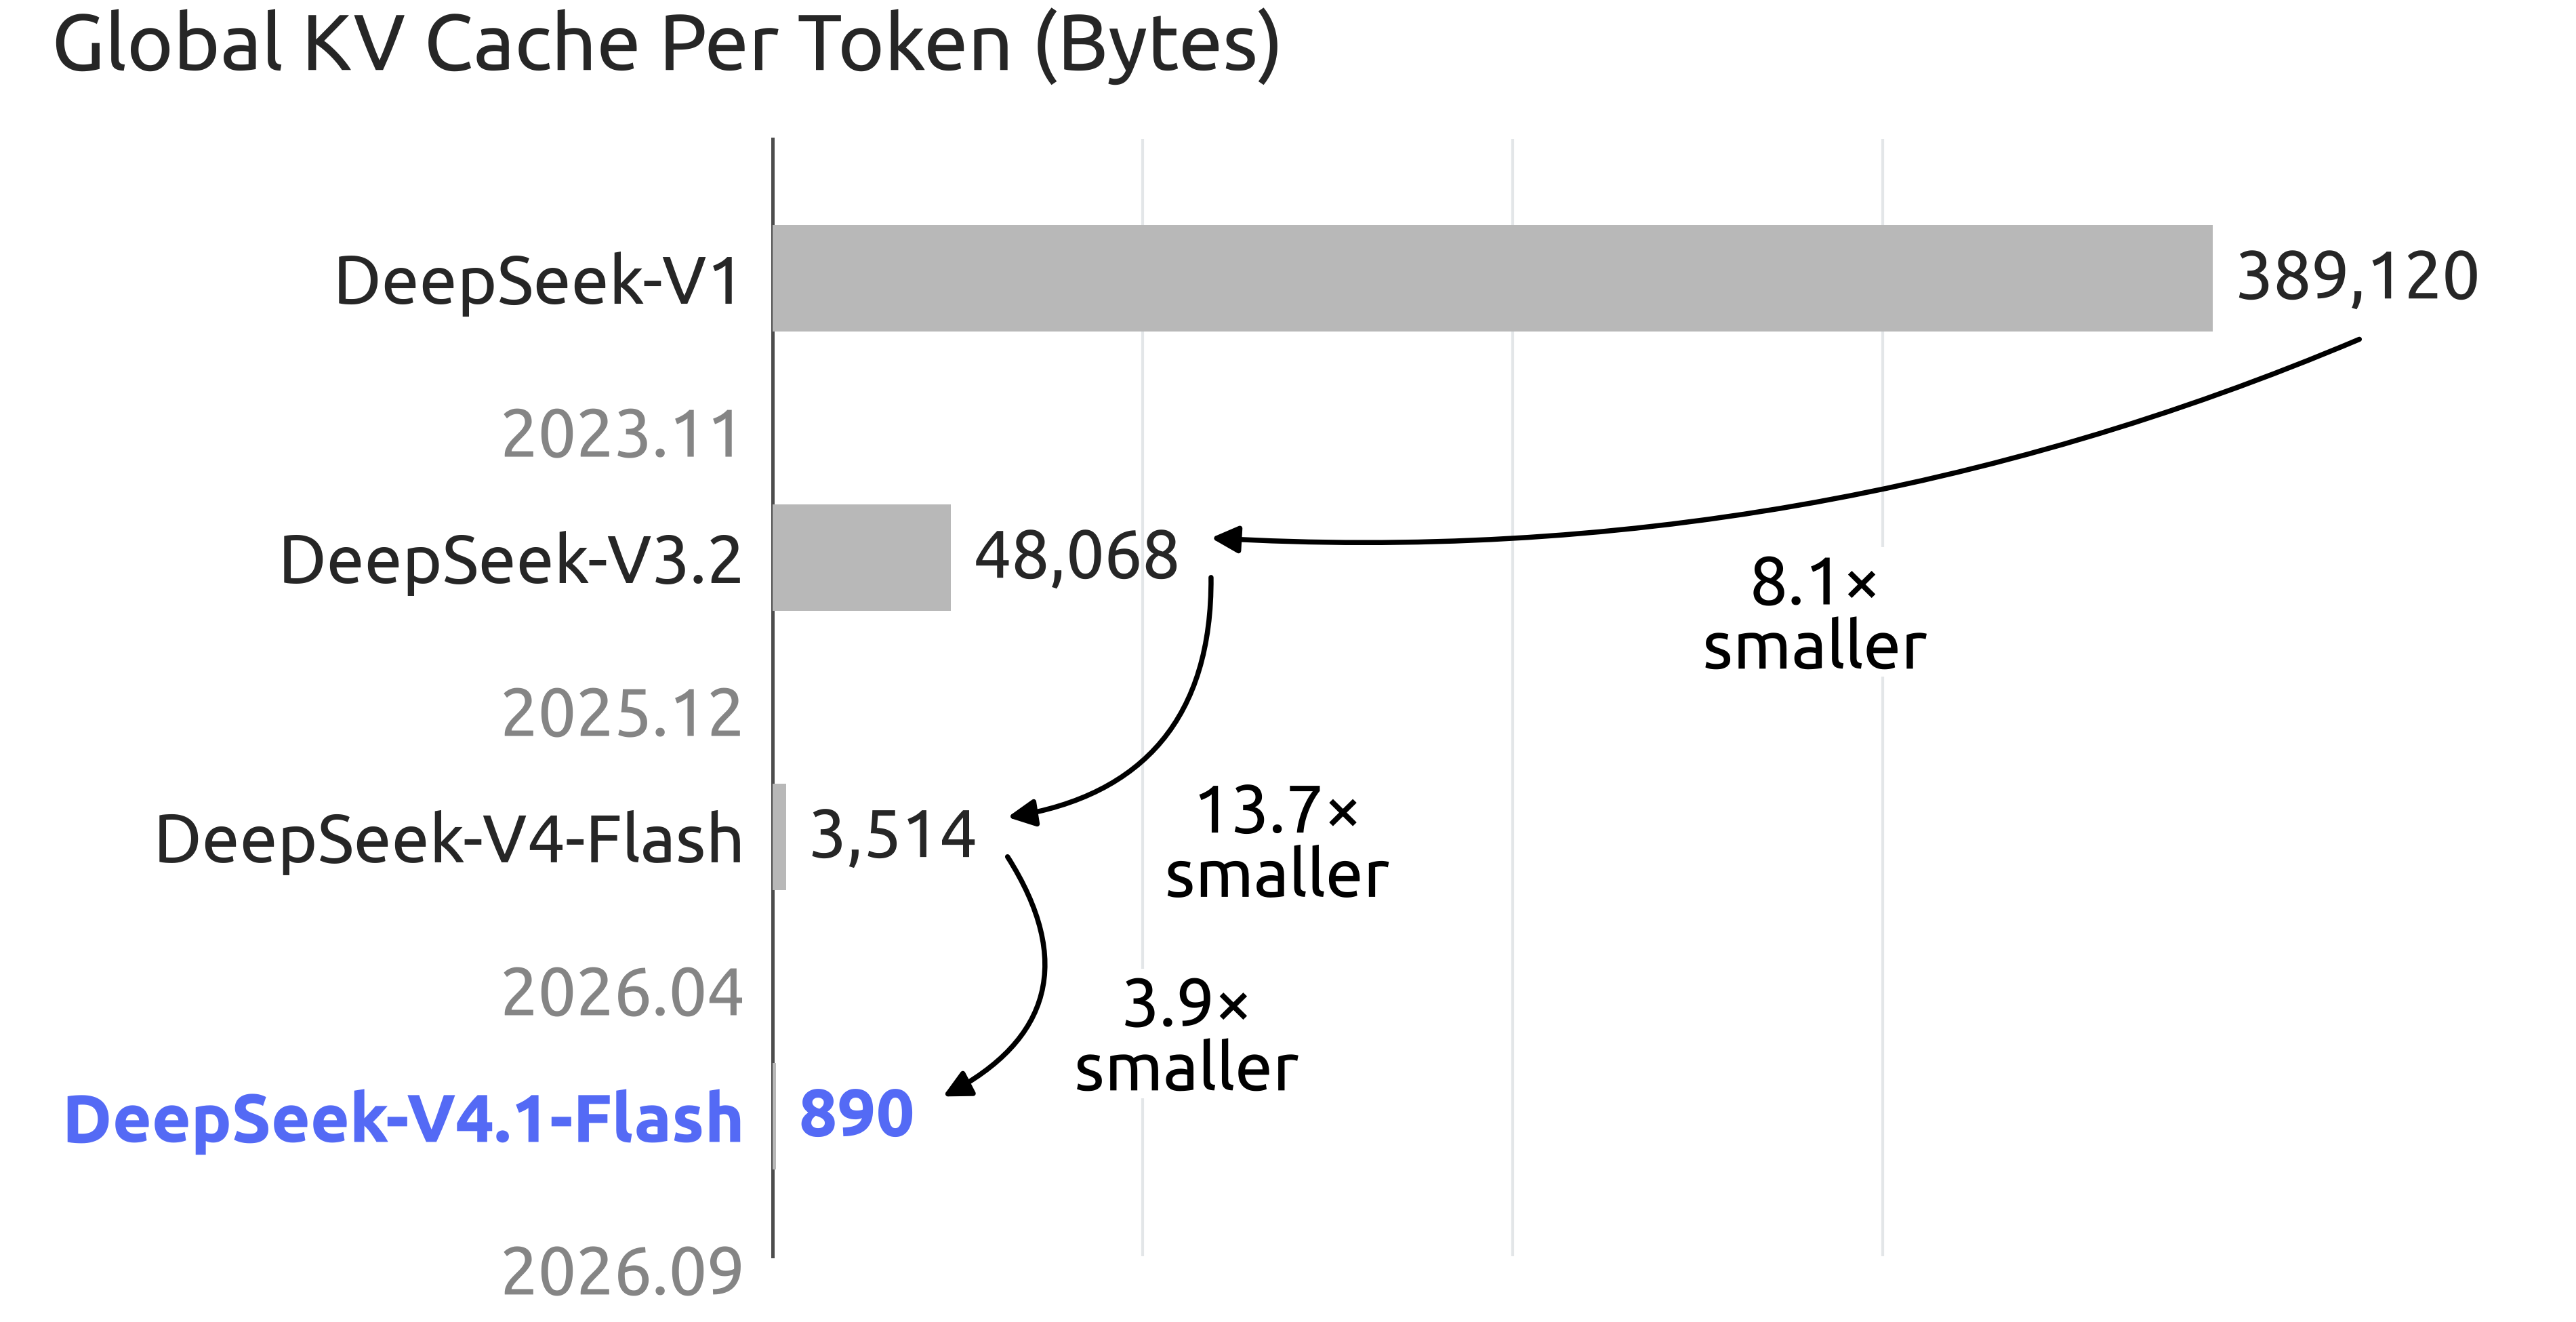
DeepSeek berichtet zudem, dass der globale KV-Cache etwa 890 Bytes pro Token beträgt, gegenüber 3,514 Bytes pro Token bei der vorherigen V4 Flash-Generation. Diese Reduktion ist insbesondere für langlaufende Agents relevant, die große Prompts, Tool-Schemata und Konversationshistorien wiederholt wiederverwenden.
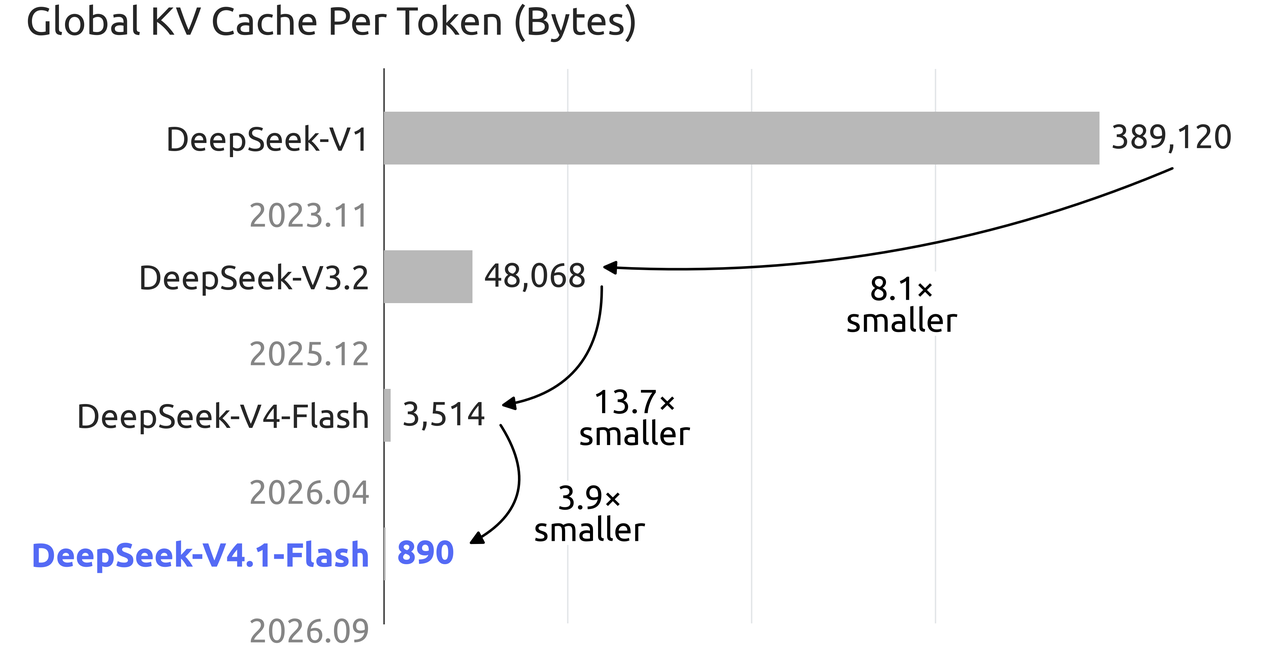
Offizieller DeepSeek KV-Cache-Vergleich ? official image source
Wie stark ist DeepSeek V4.1 Flash für Coding und AI-Agents?
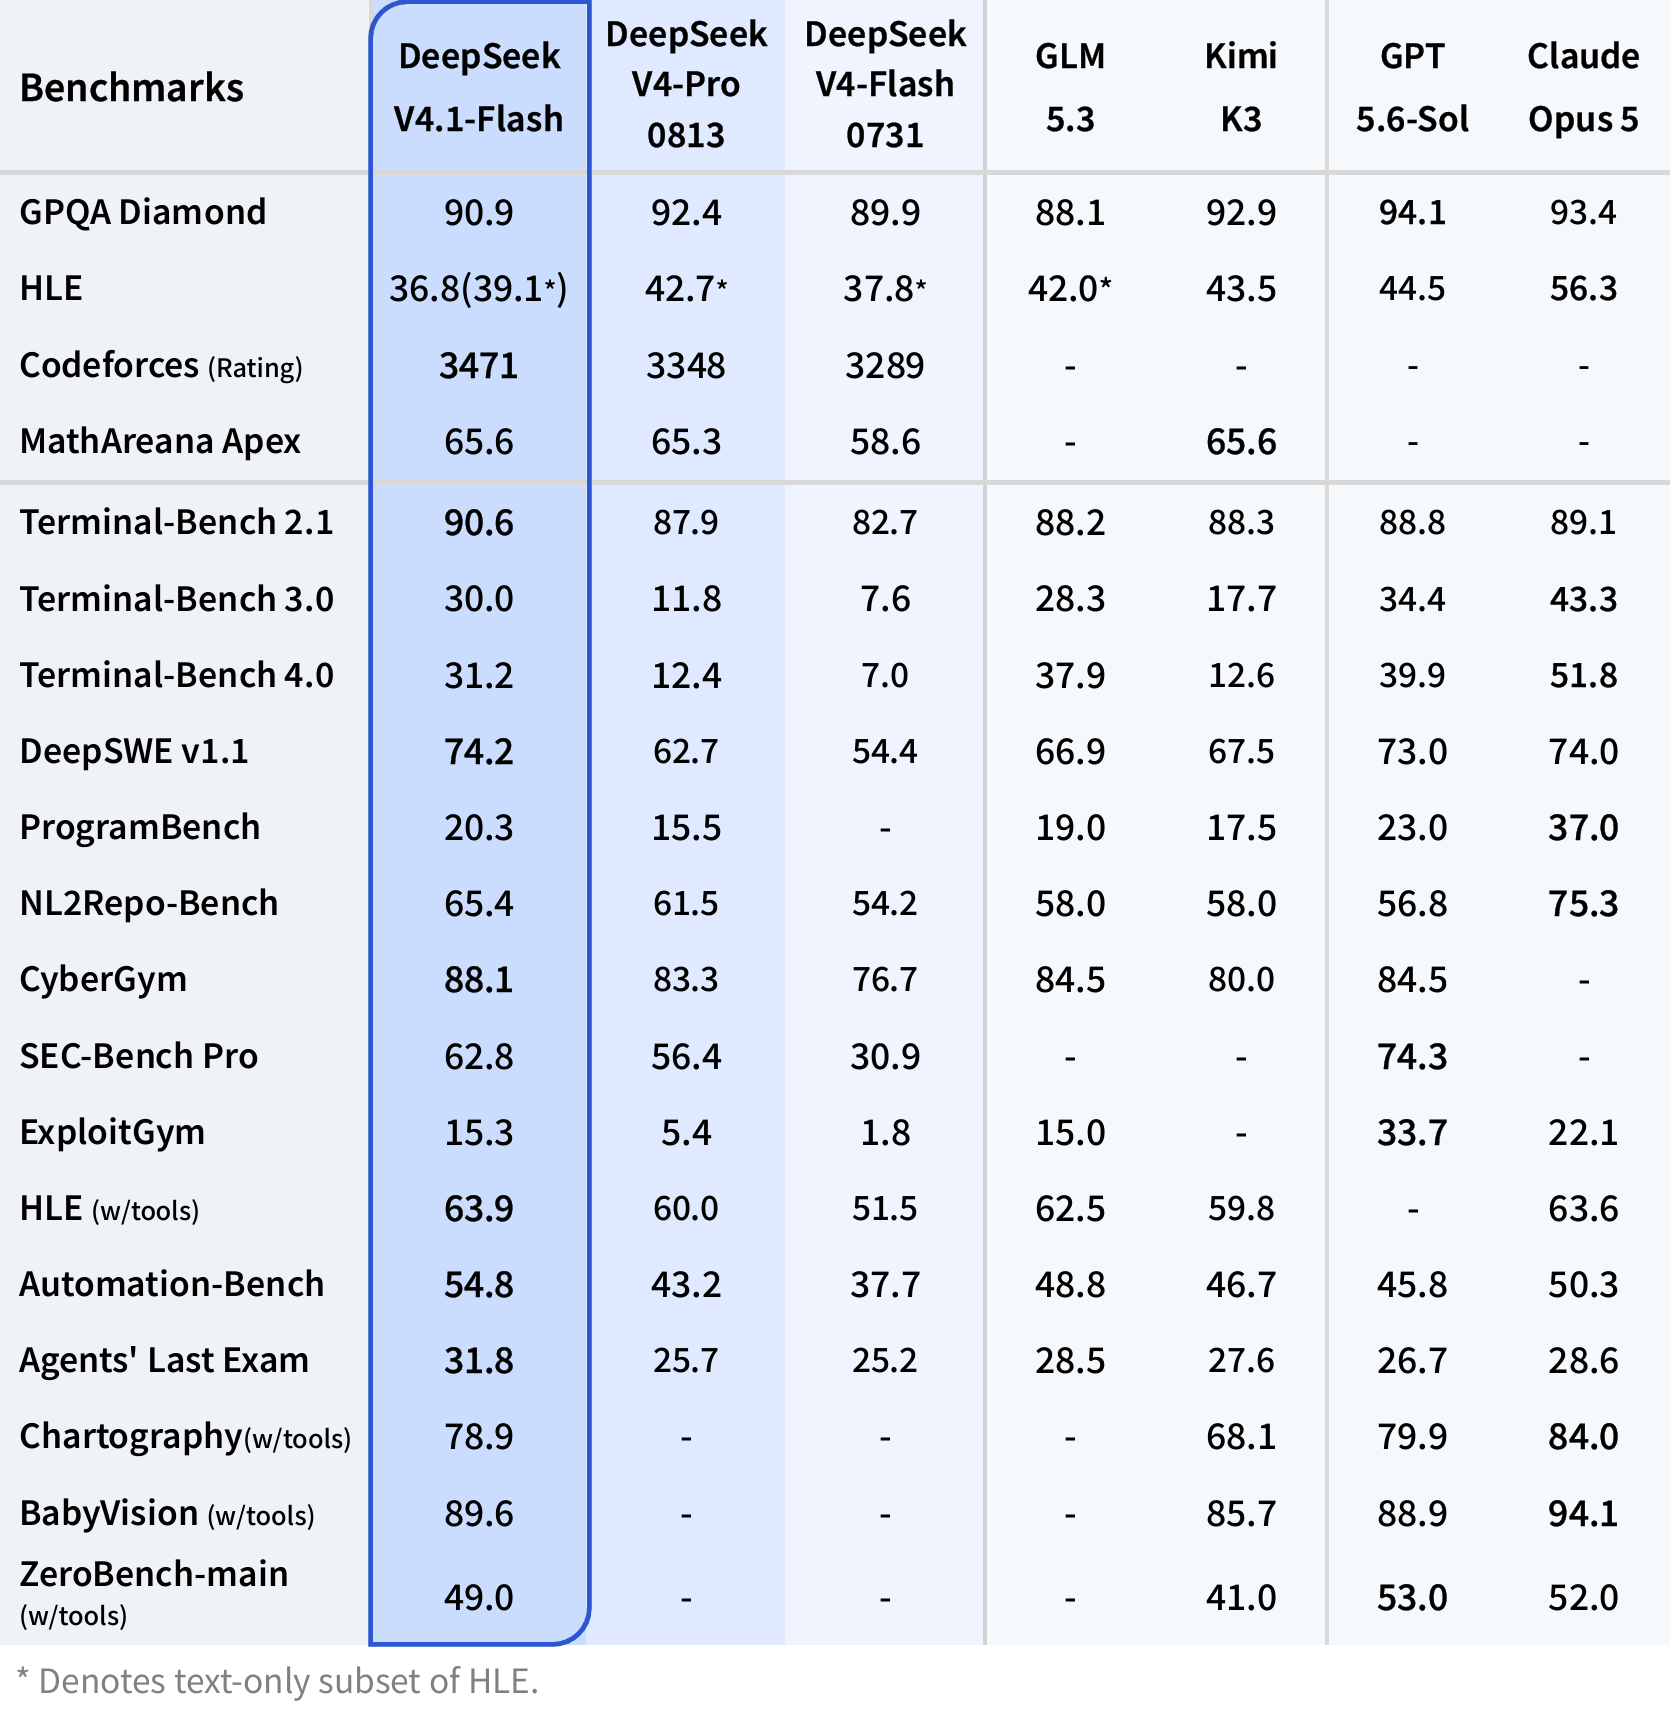
Dieser Leitfaden konzentriert sich auf Benchmarks, die die API-Auswahl direkt informieren. DeepSeek charakterisiert V4.1 Flash als überlegen gegenüber Flaggschiffmodellen, einschließlich V4 Pro, innerhalb seines veröffentlichten Evaluationspakets. Die praxisrelevantesten Zugewinne erscheinen bei Terminalarbeit, Softwareentwicklung, Repository-Aufgaben, Automatisierung und Tool-unterstützten Agents; Produktionsteams sollten das Modell dennoch anhand eigener Prompts und Completion-Kriterien validieren.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| HLE with tools | 63.9 | 60.0 | 51.5 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Die praktische Schlussfolgerung ist enger als „V4.1 ist schlauer“. DeepSeek V4.1 Flash ist besonders attraktiv für wiederholte Tool-Nutzung, Terminalaktionen, Repository‑skaliertes Coding, Automatisierung und lange Agent-Trajektorien. Reine Wissens- oder Reasoning-Workloads können zu einer anderen Rangfolge führen.
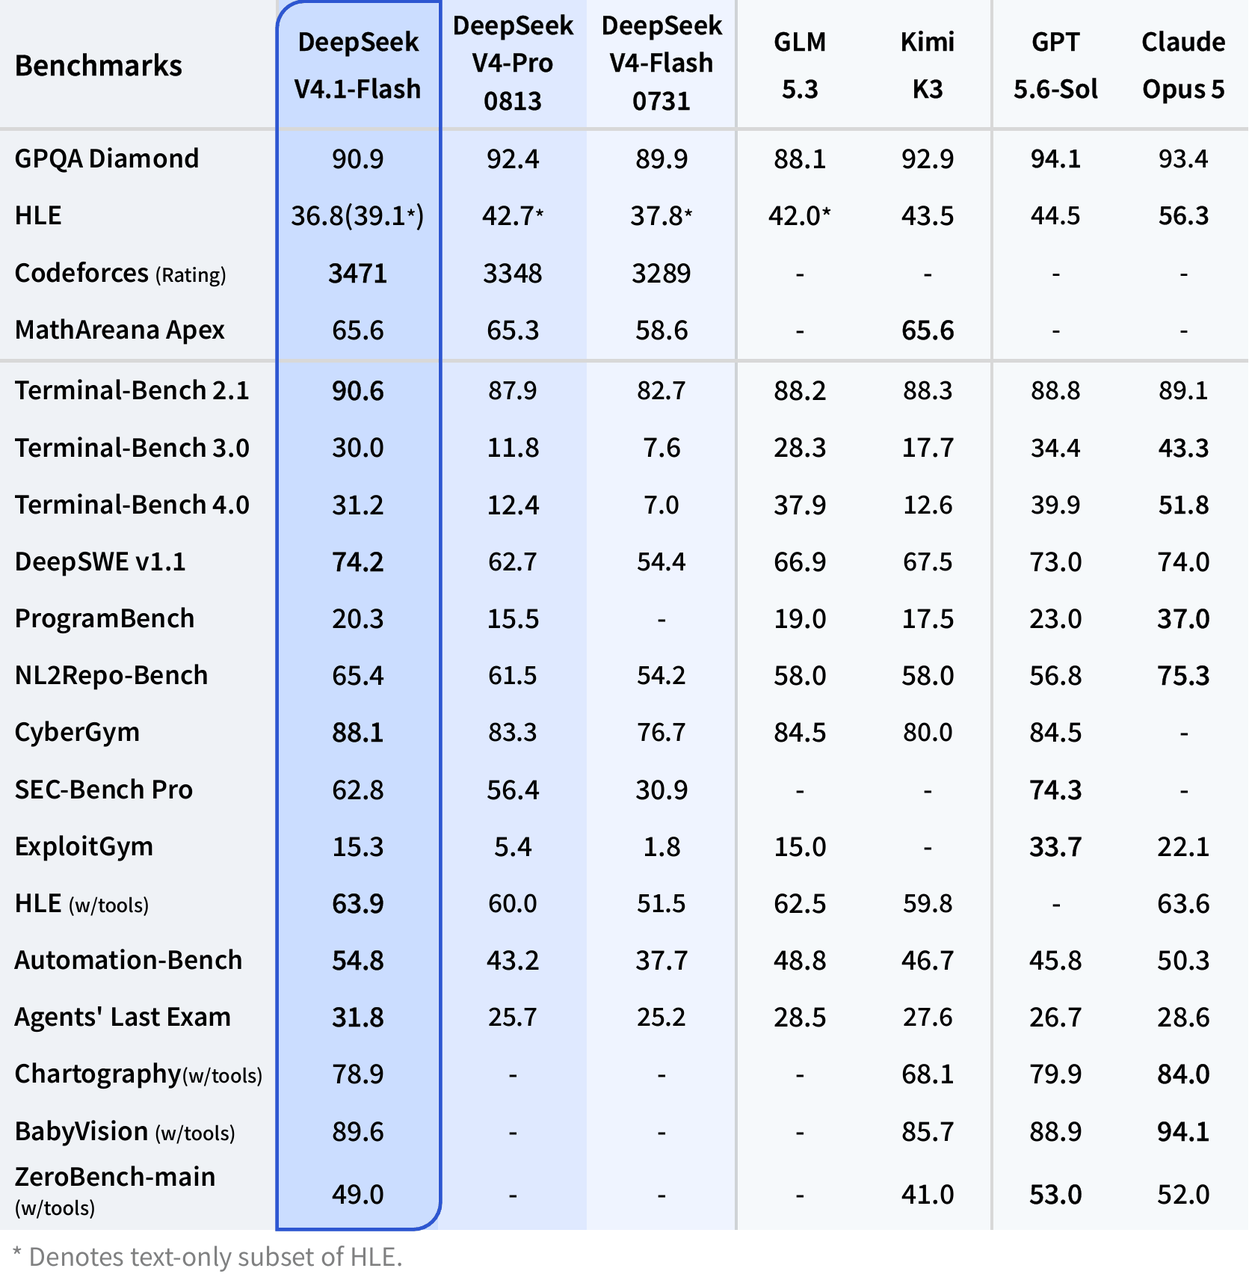
Offizielle DeepSeek-Benchmark-Ergebnisse ? official image source
Warum die DeepSeek V4.1 Flash API über CometAPI nutzen?
Der wesentliche Integrationsvorteil besteht darin, dass die DeepSeek V4.1 Flash API in CometAPI über dasselbe OpenAI-kompatible Clientmuster aufgerufen werden kann, das auch für andere Modelle verwendet wird. Das reduziert SDK-Wechsel in Multi-Model-Anwendungen.
| Einstellung | Wert |
|---|---|
| Base-URL | https://api.cometapi.com/v1 |
| Chat-Endpoint | /chat/completions |
| Modell-ID | deepseek-v4.1-flash |
| Authentifizierung | Bearer-API-Schlüssel |
| Python SDK | OpenAI-SDK-kompatibel |
| JavaScript SDK | OpenAI-SDK-kompatibel |
Dies vermeidet auch einen häufigen Integrationsfehler: die erstparteige Modellbezeichnung aus DeepSeek in eine CometAPI-Anfrage zu kopieren. Die Provider-Routen beziehen sich auf dieselbe Modellfamilie, aber die dokumentierten Modell-IDs sind unterschiedlich.
| Dimension | CometAPI DeepSeek V4.1 Flash | Offizielle DeepSeek-API |
|---|---|---|
| Base-URL | https://api.cometapi.com/v1 | https://api.deepseek.com |
| Modell | deepseek-v4.1-flash | deepseek-flash |
| Schnittstelle | OpenAI-kompatibel | OpenAI-kompatibel |
| Basis/Off-Peak Input | $0.12/M Basis | $0.15/M Off-Peak Cache Miss |
| Basis/Off-Peak Output | $0.48/M Basis | $0.60/M Off-Peak |
| Cache Read/Hit | $0.0024/M Basis | $0.003/M Off-Peak |
Verbindung zu DeepSeek V4.1 Flash mit CometAPI
API-Schlüssel und Base-URL konfigurieren
Erstellen Sie einen CometAPI-API-Schlüssel, speichern Sie ihn in einer Umgebungsvariablen und konfigurieren Sie die OpenAI-kompatible Base-URL als https://api.cometapi.com/v1. Betten Sie keine Produktions-Credentials in Quellcode ein.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
``````sh
$env:COMETAPI_KEY="YOUR_COMETAPI_KEY"
Erste API-Anfrage ausführen
Verwenden Sie die CometAPI-Modellkennung deepseek-v4.1-flash mit dem standardmäßigen Chat Completions-Endpoint.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Eine erfolgreiche Antwort verwendet die vertraute OpenAI-Style-Completion-Struktur, sodass Anwendungen, die bereits choices[0].message.content lesen, nur minimalen Migrationsaufwand haben.
Python-SDK-Beispiel
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Für die Produktion explizite Timeouts, begrenzte Retries, Request-Logging und Usage-Monitoring ergänzen.
JavaScript-SDK-Beispiel
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
Die Client-Abstraktion bleibt unverändert, während Base-URL und Modell-ID zur Provider-Konfiguration werden.
Funktionen der DeepSeek V4.1 Flash API
Reasoning und Thinking-Modus konfigurieren
DeepSeek dokumentiert sowohl Thinking- als auch Non-Thinking-Betrieb. Beim Routing über CometAPI sollten Sie sicherstellen, dass anbieterabhängige Felder exakt wie erwartet durchgereicht werden, bevor Sie sie als Produktionsvertrag voraussetzen.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant distributed job scheduler."
        }
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"}
    },
)
Testen Sie jede unterstützte Aufwandsstufe gegen Ihre eigenen Ziele für Latenz, Token-Nutzung und Aufgabenabschluss, da Provider-Mappings variieren können.
Bilder mit Vision-Input analysieren
DeepSeek V4.1 Flash akzeptiert Bilder in JPEG, PNG, GIF und WebP. Offizielle Limits umfassen 32 MiB pro Inline-Bild, 64 MiB pro dateibasiertem Bild, bis zu 600 Bilder pro Request und ein Limit von 8.192 Zeichen für externe Bild-URLs. Bilder gehören in user- oder developer-Nachrichten, nicht in system- oder assistant-Nachrichten.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Validieren Sie Bildgröße, URL-Erreichbarkeit, Vorverarbeitung, Token-Nutzung und Latenz auf genau der CometAPI-Route, die in der Produktion verwendet wird.
Antworten per SSE streamen
Streaming reduziert die wahrgenommene Latenz, indem es inkrementelle Ausgaben für interaktive Coding-, Chat- und Agent-Oberflächen liefert.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Produktionsclients sollten unterbrochene Streams, leere Deltas, Timeout-Recovery, Retry-Grenzen und abschließende Usage-Abrechnung handhaben.
Was kostet die DeepSeek V4.1 Flash API?
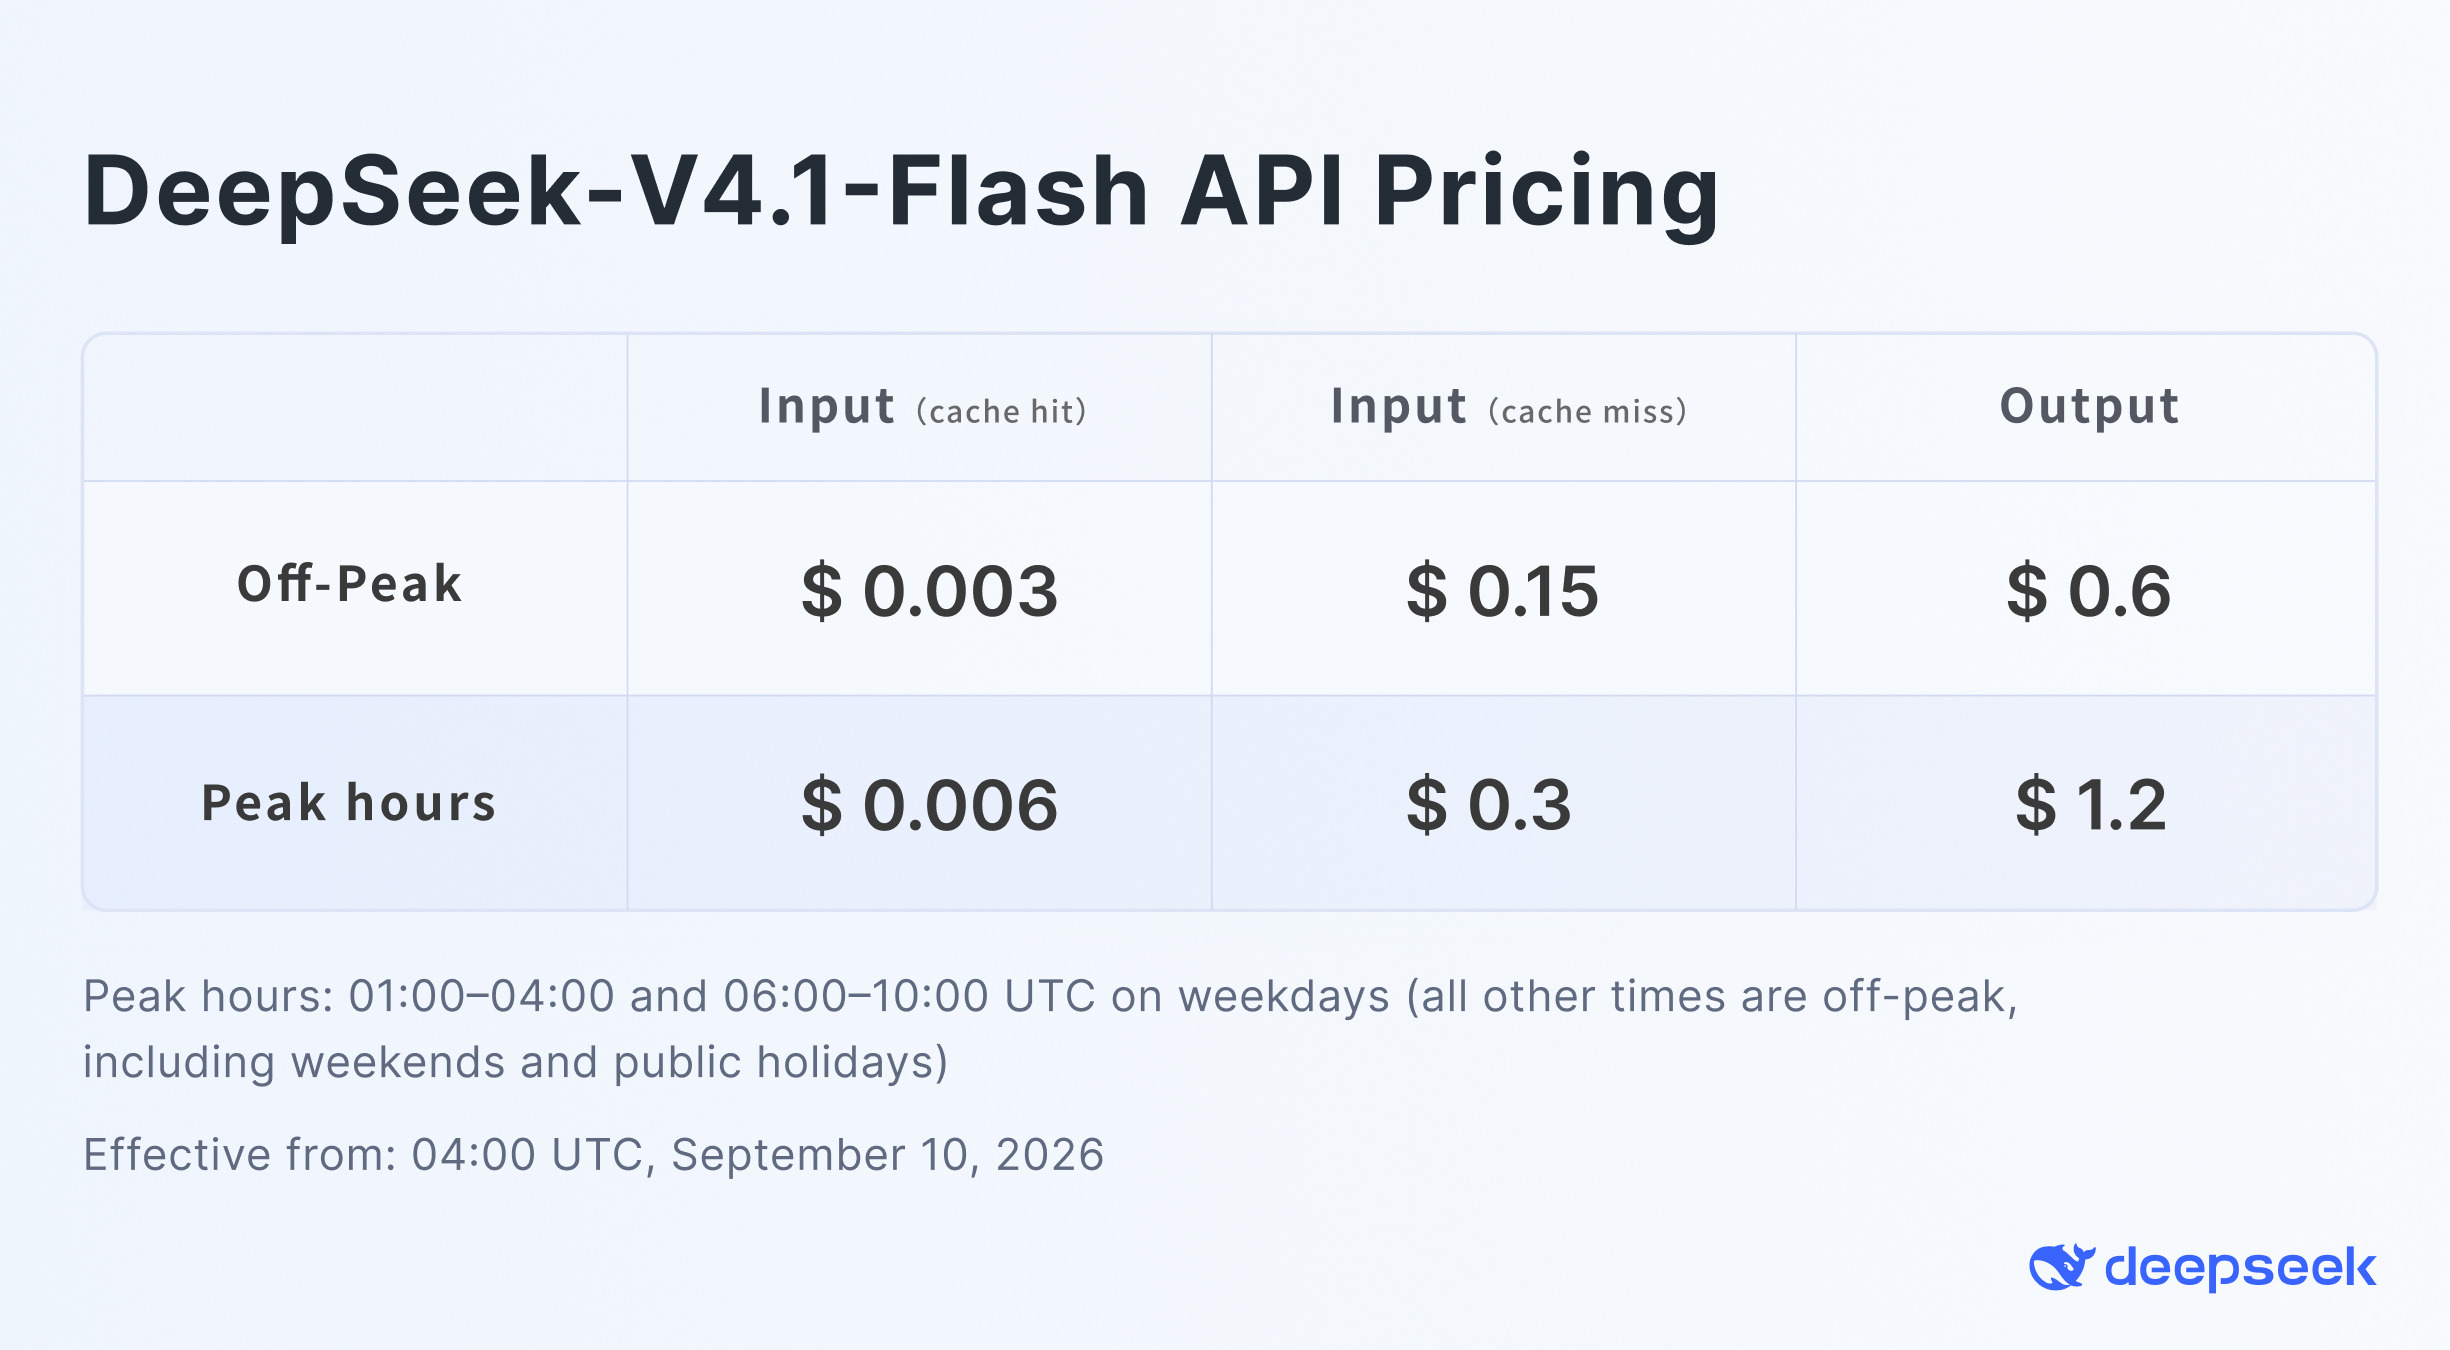
DeepSeeks dokumentierte API-Preise nutzen Peak- und Off-Peak-Zeitfenster. Das offizielle Preisbild zeigt Off-Peak-Sätze von $0.003/M Cache-Hit-Input, $0.15/M Cache-Miss-Input und $0.60/M Output; Peak-Sätze sind doppelt so hoch.
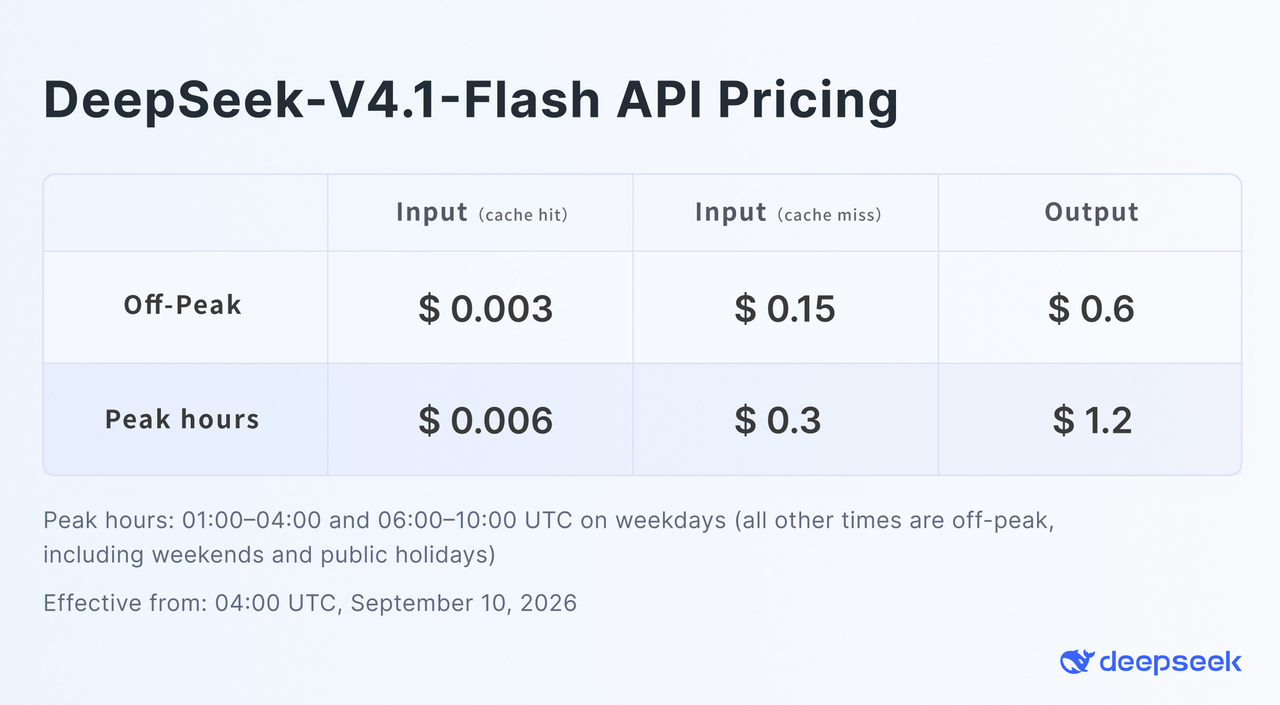
Offizielle Preise der DeepSeek V4.1 Flash API ? official image source
| Tokenkategorie | CometAPI DeepSeek V4.1 Flash | Offizielle DeepSeek-Preise |
|---|---|---|
| Input / Cache Miss | $0.1200/M Basis | $0.15/M Off-Peak |
| Output | $0.4800/M Basis | $0.60/M Off-Peak |
| Cache Read / Cache Hit | $0.0024/M Basis | $0.003/M Off-Peak |
| Peak-Multiplikator | 2x während passender Fenster | 2x während passender Fenster |
| Wochentags Peak-Fenster 1 | 01:00-04:00 UTC | 01:00-04:00 UTC |
| Wochentags Peak-Fenster 2 | 06:00-10:00 UTC | 06:00-10:00 UTC |
Ein einfaches Basispreis-Beispiel für 100M Cache-Miss-Input-Tokens und 20M Output-Tokens:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Die tatsächlichen Produktionskosten hängen vom Mix aus gecachten Tokens, Peak-Multiplikatoren, Request-Bedingungen und dem aktuellen Providerpreis ab. Der große Unterschied zwischen Cache-Hit- und Cache-Miss-Preisen macht stabile wiederverwendbare Präfixe – Systeminstruktionen, Tool-Schemata und gemeinsamer Kontext – zu einem wichtigen Kostenhebel.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
| Dimension | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| Primäres Profil | Effizientes Reasoning, Agents, Vision | High-End-V4-Reasoning | Vorherige schnelle V4-Stufe |
| Native Vision | Ja | Modellabhängig / route-spezifisch | Separate Vision-Route in der Vor-Generation |
| Thinking | Ja | Ja | Ja |
| Agent-Performance | In vielen publizierten Agent-Tests am stärksten | Stark | Niedriger als V4.1 in publizierten Tests |
| Erstparteige kanonische ID | deepseek-flash | deepseek-v4-pro | Legacy-/Kompatibilitätsalias |
| CometAPI-ID | deepseek-v4.1-flash | deepseek-v4-pro | deepseek-v4-flash |
| Bester Einsatz | Neue Hochvolumen-Workloads für Agents/Coding | Workloads, die speziell auf Pro validiert sind | Legacy-Kompatibilität und Vergleiche |
Aktueller Status: DeepSeeks laufende
Models & Pricing documentation
gibt an, dass DeepSeek V4 Pro nach dem 14. September 2026 weiterhin verfügbar ist, bei unveränderter Abrechnung. Prüfen Sie die Live-Dokumentation, bevor Sie sich auf Routing- oder Migrationsverhalten verlassen.
Was sollten Sie testen, bevor Sie die DeepSeek V4.1 Flash API in Produktion bringen?
- Modell-Routing: deepseek-v4.1-flash in CometAPI bestätigen und anbieterabhängige IDs in der Konfiguration statt in der Anwendungslogik halten.
- Prompt-Regression: repräsentative Produktionsprompts ausführen und den Aufgabenabschluss vergleichen, nicht nur Benchmarkscores.
- Strukturierte Ausgabe: jede JSON-Antwort gegen das Anwendungsschema validieren und einen Reparatur- oder Retry-Pfad definieren.
- Tool-Aufrufe: Argumenttypen, fehlerhafte Aufrufe, parallele Aufrufe und Abbruchbedingungen für Schleifen testen.
- Thinking-Steuerungen: prüfen, welche Felder CometAPI durchreicht, und die Auswirkungen jeder Einstellung auf Latenz und Tokenverbrauch messen.
- Vision: reale Screenshots und Dokumente testen, einschließlich Größenlimits, nicht erreichbarer URLs und nicht unterstützter Message-Rollen.
- Streaming: leere Deltas, unterbrochene Verbindungen, Retry-Grenzen und abschließende Usage-Abrechnung handhaben.
- Langer Kontext und Caching: Antwortqualität, Cache-Hit-Rate und Kosten messen, wenn die Prompt-Länge zunimmt.
- Zuverlässigkeit: p50, p95 und p99 Latenz erfassen; 429, 5xx, Timeouts und Fallback-Pfade durchspielen.
- Kostenkontrolle: Input-, gecachte Input-, Reasoning- und Output-Tokens pro abgeschlossener Aufgabe verfolgen.
Für Agent-Workloads vergleichen Sie die Kosten pro abgeschlossener Aufgabe – nicht nur Dollar pro Million Tokens. Ein Modell kann pro Output-Token teurer sein und dennoch End-to-End günstiger, wenn es Retries und Tool-Aufrufe reduziert; umgekehrt gilt das auch, wenn höherer Reasoning-Aufwand Tokens hinzufügt, ohne den Aufgabenabschluss zu verbessern.
Lohnt sich die Nutzung der DeepSeek V4.1 Flash API?
Für neue DeepSeek-Integrationen ist DeepSeek V4.1 Flash ein starker Standardkandidat innerhalb der Flash-Familie, da es bessere veröffentlichte Agentic-Performance mit nativer Vision und aggressiver Preisgestaltung kombiniert.
Seine stärksten Einsatzszenarien sind nicht allein generischer Chat. Besser geeignet sind Coding-Agents, automatisierte Softwareentwicklung, Long-Context-Analysen, multimodale Assistenten, hochvolumige Workflow-Automatisierung und Tool-nutzende Agents, bei denen wiederholter Kontext die Gesamtkosten dominieren kann.
Für Entwickler, die eine OpenAI-Style-SDK-Architektur beibehalten möchten, bietet die DeepSeek V4.1 Flash API in CometAPI das in diesem Leitfaden verwendete Integrationsmuster: Behalten Sie die Standard-Client-Schnittstelle bei, richten Sie sie auf https://api.cometapi.com/v1 und verwenden Sie deepseek-v4.1-flash.
DeepSeek V4.1 Flash API FAQ
Wie sollte ich provider-spezifische Modell-IDs organisieren?
Speichern Sie Provider, Base-URL und Modell-ID gemeinsam in umgebungsspezifischer Konfiguration. So verhindern Sie, dass eine erstparteige ID wie deepseek-flash versehentlich an eine CometAPI-Route gesendet wird, die deepseek-v4.1-flash erwartet.
Wie kann ich die Cache-Wiederverwendung in langlaufenden Agents verbessern?
Halten Sie stabile Systeminstruktionen, Tool-Schemata und gemeinsamen Referenzkontext am Anfang des Prompts. Hängen Sie volatile Nutzereingaben und Tool-Ergebnisse später an, damit sich das wiederverwendbare Präfix seltener ändert.
Wie vergleiche ich V4.1 Flash am sichersten mit V4 Pro?
Spielen Sie denselben Produktionsaufgabensatz nach, begrenzen Sie das Retry-Budget und vergleichen Sie Abschlussrate, Latenz, Anzahl der Tool-Aufrufe und Gesamt-Tokens. Ein niedrigerer Preis pro Token garantiert keine niedrigeren Kosten pro erfolgreicher Aufgabe.
Welche Fallback-Policy sollte ein Agent verwenden?
Definieren Sie, welche Fehler retry-fähig sind, setzen Sie eine strikte Retry-Obergrenze und wählen Sie ein Fallback-Modell erst, nachdem der Tool-Zustand erhalten wurde, der für eine sichere Fortsetzung nötig ist. Protokollieren Sie jeden Fallback, damit stille Qualitätsdrifts sichtbar werden.
Wie sollten Bildinputs vor dem Senden validiert werden?
Prüfen Sie die echte Dateisignatur, das unterstützte Format, die Bytegröße, die Erreichbarkeit der URL und die Message-Rolle. Entfernen Sie unnötige Metadaten und senden Sie keine sensiblen Bilder, sofern Ihre Aufbewahrungs- und Zugriffspolicen dies nicht ausdrücklich erlauben.
Wann sollte ich die Responses-API statt Chat Completions in Betracht ziehen?
Verwenden Sie Chat Completions, wenn ein bestehender OpenAI-kompatibler Nachrichten-Workflow beibehalten werden soll. Ziehen Sie die Responses-API in Betracht, wenn die Anwendung von typisierten Input-Items, Tool-Output-Bildern oder JSON-Schema-Ausgabe profitiert, und bestätigen Sie dann, dass die gewählte Provider-Route die benötigten Felder unterstützt.
Wie gehe ich mit Schema-Validierungsfehlern um?
Weisen Sie ungültige Ausgaben zurück, bevor sie nachgelagerte Systeme erreichen, protokollieren Sie den Validierungsfehler und versuchen Sie einen begrenzten Reparatur-Retry. Wenn wiederholte Reparaturen fehlschlagen, leiten Sie die Aufgabe zu einem sicheren Fallback um, statt plausibles, aber ungültiges JSON zu akzeptieren.