
Antwort zuerst
Kimi K4 wurde nicht offiziell veröffentlicht, und Moonshot AI hat weder endgültige Spezifikationen, Benchmark-Ergebnisse, API-Preise noch ein Veröffentlichungsdatum publiziert. Der bisher stärkste öffentliche Hinweis stammt aus Berichten, dass Moonshot zusätzliche Nvidia-Blackwell-Kapazitäten sucht für einen Nachfolger, der deutlich größer als Kimi K3 sein soll. Das ist ein bedeutendes Indiz dafür, dass ein Next-Gen-Modell vorbereitet wird, aber keine offizielle Produktankündigung.
Verantwortungsvoll diskutieren lässt sich die Richtung, die K4 einschlagen könnte. Moonshots aktuelles 2,8-Billionen-Parameter-Kimi K3 kombiniert bereits Sparse-Mixture-of-Experts-Skalierung, Native Vision, ein Kontextfenster von einer Million Tokens und langhorizontige Agent-Fähigkeiten. Kimi K4 dürfte daher eher an verlässlicher agentischer Ausführung, Coding-Tiefe, multimodaler Begründung und Skalierungseffizienz gemessen werden als allein an der Parameterzahl.
Die zentrale Schlussfolgerung ist einfach: Kimi K4 scheint in Entwicklung zu sein, aber fast jede außerhalb des Unternehmens kursierende Zahl bleibt unbestätigt. Jede glaubwürdige Vorschau muss verifizierte K3-Fakten, K4-Berichte und vorwärtsgerichtete Schlüsse trennen.
Was ist Kimi K4?4
Kimi K4 ist der öffentliche Name für den erwarteten Nachfolger von Kimi K3. Es sollte derzeit als ein in Entwicklung befindliches Modell und nicht als angekündigtes API-Produkt betrachtet werden. Moonshot AI hat keine K4-Model-Card, keinen technischen Bericht, keine API-Kennung, keine Preisseite, keine Lizenz oder Benchmark-Tabelle veröffentlicht.
The Information berichtet, dass Moonshot AI Pläne für Kimi K4 diskutiert. Unter Berufung auf zwei mit der Sache vertraute Personen beschreibt der Bericht K4 als deutlich größer als K3 und sagt, Moonshot suche Zugang zu zusätzlichen Nvidia-Blackwell-Chips, um das Modell vorzubereiten. Er bestätigt jedoch weder fünf Billionen, sechs Billionen oder eine andere exakte Parameterzahl, noch legt er fest, ob K4 als offene Gewichte, ausschließlich über gehostete Produkte oder in mehrere Varianten aufgeteilt bereitgestellt wird.
Diese Unsicherheit ist wichtig, weil Kimi-Veröffentlichungen historisch Modellgewichte, gehostete APIs, Endnutzerprodukte und spezialisierte Agentensysteme kombiniert haben. Eine zukünftige K4-Ankündigung könnte sich auf ein einzelnes Modell, eine Modellfamilie oder ein breiteres System rund um Routing, Tools, Speicher und multimodale Komponenten beziehen.
Warum zieht Kimi K4 so früh Aufmerksamkeit auf sich?
Kimi K3 hat die Skalierungsgrenze für Open-Weight-Modelle angehoben
Kimi K3 setzte einen ungewöhnlich ambitionierten Ausgangspunkt. Seine offizielle Modellzusammenfassung nennt 2,8 Billionen Gesamtparameter, 104 Milliarden aktivierte Parameter, 93 Layer, 896 geroutete Experten, 16 ausgewählte Experten pro Token, zwei Shared Experts und eine Kontextlänge von 1.048.576 Tokens. Das Modell umfasst zudem einen 401-Millionen-Parameter-MoonViT‑V2‑Vision-Encoder.
Diese Kombination macht K3 aus zwei Gründen wichtig. Erstens zeigt sie, dass Open-Weight-Modelle in dieselbe breite Fähigkeitsklasse wie führende proprietäre Systeme skalieren können. Zweitens demonstriert das sparse Design, dass Gesamtparameterzahl und Inferenzkosten nicht dasselbe sind: Pro Token ist nur ein Teil der Experten aktiv.
Berichte deuten auf einen noch größeren Nachfolger hin
Branchenberichte sagen, Moonshot AI suche zusätzliche Compute der Blackwell-Klasse für K4 und beschreiben das geplante Modell als deutlich größer als K3. Der Bericht ist der beste öffentliche Beleg dafür, dass K4 mehr ist als Community-Spekulation, lässt aber die endgültige Architektur, den Trainingsplan, die Modellgröße und den Deployment-Plan offen.
Die Compute-Geschichte ist relevant, weil Scale zwei getrennte Engpässe schafft. Das Training erfordert genügend Beschleuniger, Netzwerk, Speicher und technische Stabilität, um einen Frontier-Run abzuschließen. Das Serving benötigt dann eine separate Inferenzstrategie mit akzeptabler Latenz und Kosten. Ein größeres K4 würde daher architektonische und systemische Verbesserungen erfordern, nicht nur mehr Hardware.
Die Architektur von K3 wurde auf weitere Skalierung ausgelegt
Moonshots Kimi K3 Technical Blog beschreibt Kimi Delta Attention und Attention Residuals als das architektonische Rückgrat eines Modells, das über das Billionen-Parameter-Regime hinaus skalieren soll. Kimi Delta Attention liefert eine effiziente Attention-Grundlage, während Attention Residuals Repräsentationen selektiv über die Modelltiefe hinweg abrufen, statt sie gleichmäßig anzusammeln.
K3 nutzt außerdem Stable LatentMoE und aktiviert effektiv 16 von 896 gerouteten Experten. Quantile Balancing leitet die Expertenzuweisung aus Router-Score-Quantilen ab, und Per-Head Muon optimiert Attention-Heads unabhängig. Diese Entscheidungen weisen auf die Probleme, die K4 lösen muss: stabiles Routing, ausgewogene Expert:innen-Auslastung, effiziente Long-Context-Attention und vorhersehbares Training in extremem Maßstab.
Warum wäre Kimi K4 bedeutsam, wenn Kimi K3 bereits ein 2.8T-Modell ist?
Kimi K3 operiert bereits in einem ungewöhnlich großen Maßstab, daher kann K4 nicht einfach daran gemessen werden, ob es mehr Parameter hat. Die sinnvollere Frage ist, ob zusätzlicher Trainings-Compute zu besserer Aufgabenbewältigung, stärkerer Langhorizont-Zuverlässigkeit und niedrigeren effektiven Inferenzkosten führt.
Eine nützliche K4-Evaluierung sollte daher vier Kennzahlen in den Vordergrund stellen:
- Task Completion Rate
- Zuverlässigkeit von Langhorizont-Agenten
- Coding-Erfolgsrate
- Kosten pro erfolgreich abgeschlossener Aufgabe
Letztere ist für Entwickler:innen besonders wichtig. Ein Modell, das pro erfolgreicher Repository-Reparatur weniger kostet, kann wertvoller sein als ein Modell mit höherem Benchmark-Score, aber deutlich mehr fehlgeschlagenen Trajektorien.
Erwartete Kimi K4-Spezifikationen
Die Tabelle unten unterscheidet K3s bestätigte technische Basis von K4-Berichten und Inferenz. Erwartet bedeutet nicht angekündigt. Unbekannte Felder sollten unbekannt bleiben, bis Moonshot AI eine Model-Card oder API-Dokumentation veröffentlicht.
| Specification basis | Kimi K3 bestätigt | Kimi K4 öffentliche Berichte | Vertrauensgrad |
|---|---|---|---|
| Model status | Veröffentlicht | In Entwicklung | Berichtet |
| Architecture | Sparse MoE | Nicht offengelegt; wahrscheinlich eine Sparse-MoE-Evolution | Inferenz |
| Total parameters | 2.8T | Berichten zufolge deutlich größer als K3 | Berichtet; exakter Wert unbekannt |
| Activated parameters | 104B | Nicht offengelegt | Unbekannt |
| Expert configuration | 896 geroutet; 16 ausgewählt; 2 shared | Nicht offengelegt | Unbekannt |
| Context window | 1,048,576 Tokens | Wahrscheinlich mindestens 1M, aber nicht bestätigt | Erwartet |
| Attention | KDA plus Gated MLA | Mögliche Next-Gen-KDA | Inferenz |
| Native vision | MoonViT‑V2 | Multimodale Fortsetzung wahrscheinlich | Erwartet |
| Open weights | Verfügbar | Nicht bestätigt | Unbekannt |
| API model ID | kimi-k3 | Nicht angekündigt | Unbekannt |
| Release date | Verfügbar | Nicht angekündigt | Unbekannt |
Die wichtigste Zurückhaltung betrifft die Parameterzeile. Deutlich größer legt keine exakte Größe fest. Ebenso können K3s Kontextfenster von einer Million Tokens, das multimodale Design und der Open-Weight-Release nicht einfach in K4s Spezifikationsblatt als bestätigte Fakten kopiert werden. Es sind richtungsweisende Erwartungen, keine veröffentlichten Produktzusagen.
Welche Features könnte Kimi K4 einführen?
-
Größere, aber effizientere Sparse-MoE-Skalierung
Naheliegend ist ein größeres Mixture-of-Experts-Modell. Wichtiger ist jedoch, ob K4 die Beziehung zwischen Gesamtkapazität, aktivierter Kapazität und Betriebskosten verbessert. Die Expertenzahl zu erhöhen, ohne das Routing zu verbessern, könnte zu untergenutzten Spezialist:innen, Hot Experts, Kommunikationsengpässen und instabilem Training führen.
Ein glaubwürdiger K4-Fortschritt würde zusätzliche Kapazität mit besserem Load-Balancing, stärker spezialisierten Expert:innen, niedrigeren Aktivierungsraten oder engerer Cross-Expert-Koordination kombinieren. Keines dieser Details wurde offengelegt, daher sollten Artikel sie als Entwicklungsziele und nicht als geleakte Features beschreiben.
Weiterentwickelte Kimi Delta Attention
Kimi Delta Attention ist zentral für K3s Long-Context-Design. Eine Next-Gen-Version könnte den Abruf über Millionentoken-Eingaben verbessern, den Speicherbedarf für Attention-States reduzieren und wichtige Informationen während langer Agentenläufe bewahren. Der Praxistest wäre nicht allein die Größe des Kontextfensters, sondern ob das Modell entfernte Evidenz finden, kombinieren und ohne aggressives Chunking oder wiederholtes Retrieval darauf handeln kann.
Zuverlässigere Langhorizont-Agenten
Kimi K3 ist bereits auf langlaufende technische und wissensbasierte Arbeit ausgerichtet. Seine offiziellen Demonstrationen umfassen Compiler-Entwicklung, GPU-Kernel-Optimierung, wissenschaftliches Coding, interaktive Recherche, Spieleentwicklung und Chip-Design-Workflows. K4 müsste diese beeindruckenden Demos in konsistentere Alltagsausführung überführen.
Wichtige Kennzahlen sind weniger unnötige Tool-Aufrufe, stärkere Zielbindung, bessere Erholung nach Fehlschlägen, verlässlichere Verifikation und geringere Varianz zwischen Läufen. Ein Modell, das einmal einen schwierigen Benchmark schafft, sich in Produktion aber unvorhersehbar verhält, ist weniger nützlich als ein etwas schwächeres Modell mit verlässlicher Ausführung.
Stärkeres Coding und Software Engineering
K4 wird wahrscheinlich weiterhin stark auf Coding fokussiert sein, aber die Front verschiebt sich über die Generierung isolierter Funktionen hinaus. Wettbewerbsfähige Software-Engineering-Modelle müssen Repositories abbilden, Abhängigkeiten verstehen, Terminals bedienen, mehrere Dateien ändern, Tests ausführen, Fehler diagnostizieren und ihren Ansatz revidieren.
K3 ist bereits stark auf ProgramBench, SWE-Marathon, FrontierSWE und Terminal-Aufgaben. K4s klarste Chance ist es, die verbleibende Lücke bei der tiefen Repository-Reparatur zu schließen, ohne K3s Vorteil bei ausdauernder Mehrschrittarbeit zu verlieren.
Tiefere native Multimodalität
K3 kombiniert Text und Vision auf Modellebene, und Moonshots Produktbeispiele erweitern diese Fähigkeit auf Video-Editing und Vision-in-the-Loop-Entwicklung. K4 könnte Screenshot-zu-Code-Workflows, Diagramm- und Dokumentenverständnis, zeitliche Videokompetenz, Interface-Tests und Agenten verbessern, die visuelle Ergebnisse überprüfen, bevor sie fortfahren.
Der Schlüsselunterschied liegt zwischen dem Annehmen von Bildern und der Nutzung von Wahrnehmung in einer Closed Loop. Ein multimodaler Agent muss ein gerendertes Ergebnis beobachten, die Abweichung identifizieren, seine Arbeit editieren und die Revision verifizieren. Das ist anspruchsvoller als eine einzelne Bildfrage zu beantworten.
Bessere Inferenz- und Deployment-Effizienz
Ein größeres Modell als K3 könnte selbst bei offenen Gewichten schwer selbst zu hosten sein. K4 würde von quantisierungsbewusstem Training, effizienter Experten-Parallelisierung, spekulativem Decoding, optimiertem KV-State-Management und kleineren Begleitvarianten profitieren. Für die meisten Teams dürfte gehosteter API-Zugang praktischer bleiben, als ein Sparse-Modell im Frontier-Maßstab direkt zu betreiben.
Welche Benchmark-Performance bräuchte Kimi K4?
Für K4 gibt es keine veröffentlichten Benchmark-Ergebnisse. Verantwortungsbewusst ist, die Messlatte zu definieren, die K3 und aktuelle Frontier-Konkurrenten setzen, und dann zu identifizieren, wo ein Nachfolger sich verbessern müsste. Die erweiterte Basis unten umfasst Reasoning, Coding, Terminalbedienung, Deep Research, agentische Wissensarbeit und Tabellenaufgaben. Alle Werte stammen aus der offiziellen Kimi K3 Model-Card, die in der Tabellenüberschrift verlinkt ist.
| Official benchmark suite | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| DeepSWE | 67.5 | 73.0 | 70.0 | 59.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 | 71.7 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| DeepSearchQA (F1) | 95.0 | Not reported | 94.2 | 93.1 |
| ResearchRubrics | 76.2 | 73.8 | Not reported | 73.5 |
| GDPval-AA v2 (Elo) | 1686 | 1736 | 1747 | 1593 |
| SpreadsheetBench 2 | 34.8 | 32.4 | 34.7 | 31.6 |
Dies sind von Moonshot berichtete Vergleichsergebnisse und keine einzige kontrollierte unabhängige Rangliste. Einige Modelle wurden über unterschiedliche Agenten-Frameworks evaluiert, und die offiziellen Fußnoten beschreiben Fallbacks, Cyberguards, Hardware-Substitutionen, Reasoning-Settings und benchmarkspezifische Verfahren. GDPval-AA v2 ist ein Elo-Rating und sollte nicht numerisch mit prozentbasierten Zeilen verglichen werden. Kleine Score-Unterschiede sollten nicht als universelle Überlegenheit interpretiert werden.
Offizieller Coding-Benchmark-Snapshot
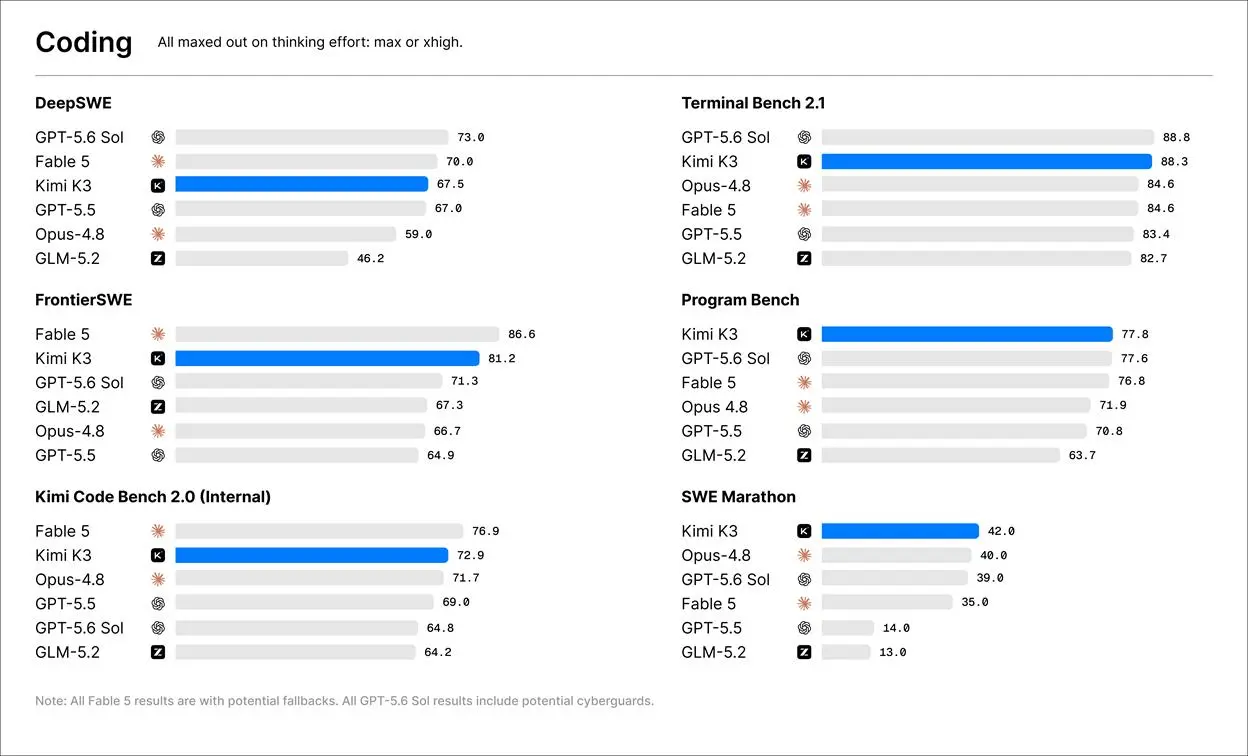
Offizieller Kimi K3 Coding-Vergleich. Die Grafik ist eine Veröffentlichung von Moonshot; konsultieren Sie die aktuelle Model-Card und Fußnoten für die neuesten Zahlen und die Evaluierungsmethodik.
Benchmark-Ergebnisse und Interpretation
GPT-5.6 Sol liegt auf DeepSWE vor Kimi K3 und deutet damit auf einen Vorteil bei schwieriger Repository-Überarbeitung hin. Claude Fable 5 führt auf FrontierSWE, während K3 auf diesem Benchmark deutlich vor GPT-5.6 Sol und Claude Opus 4.8 bleibt.
K3s Profil wird bei ausdauernder Arbeit markanter. Es liegt leicht vor ProgramBench und verzeichnet das stärkste SWE-Marathon-Ergebnis im ausgewählten Vergleich. Es führt auch auf BrowseComp und liegt auf SpreadsheetBench 2 praktisch gleichauf mit Claude Fable 5.
Für K4 sollte das Ziel nicht ein fester Prozentzuwachs auf jeder Grafik sein. Nützlicher ist, tiefe Codebasis-Reparatur und Computerbedienungs-Zuverlässigkeit zu verbessern, ohne K3s Stärken bei langhorizontigem Coding, Browsing und agentischer Wissensarbeit zu verlieren.
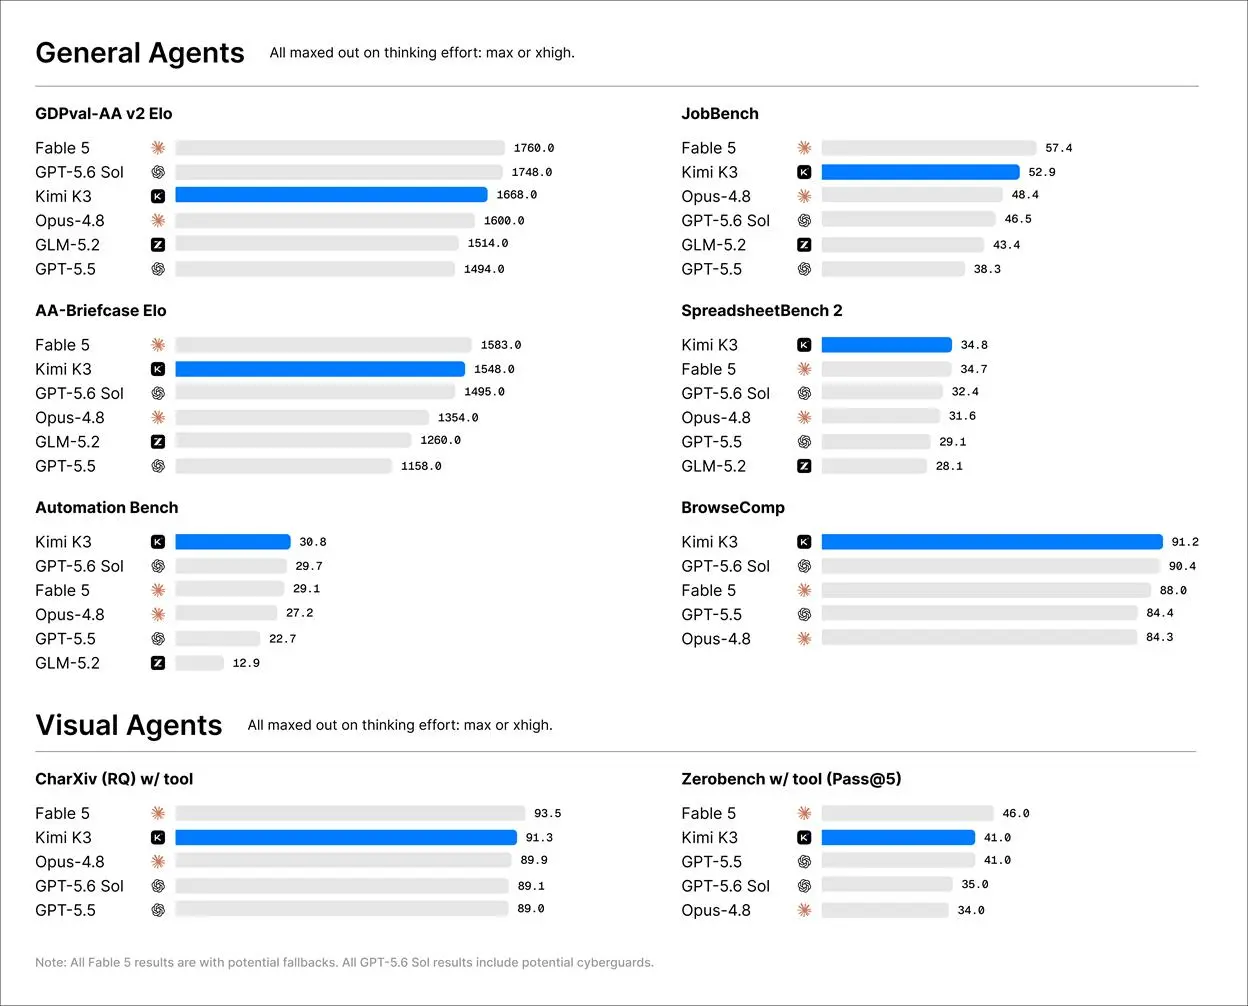
Offizieller Kimi K3 Vergleich allgemeiner und visueller Agenten. Quelle: Moonshot AI Kimi K3 Modellseite.
Kimi K4 vs Kimi K3, GPT-5.6 Sol und Claude Fable 5
Ein Vorabvergleich kann K4 keine nicht existierenden Scores zuweisen. Er kann jedoch die Wettbewerbsposition zeigen, die K4 voraussichtlich einnehmen würde, wenn es die K3-Linie fortsetzt.
| Dimension | Erwartete Position von Kimi K4 | Kimi K3 bestätigt | Geschlossene Referenzen: GPT-5.6 Sol und Claude Fable 5 |
|---|---|---|---|
| Availability | In Entwicklung | Verfügbar | Verfügbar |
| Model openness | Unbekannt | Open Weights | Proprietär |
| Confirmed context | Unbekannt | 1M Tokens | Anbieterdefiniert oder 1M-Klasse |
| Primary strength | Erwartete Frontier-Intelligenz im größeren Maßstab | Langhorizontiges Coding und Wissensarbeit | Frontier-Reasoning, Coding und Computerbedienung |
| Multimodality | Erwartet; nicht bestätigt | Native Vision | Multimodal |
| Self-hosting | Unbekannt | Möglich mit erheblicher Infrastruktur | Nicht verfügbar |
| Agent maturity | Erwartete Verbesserung | Stark | Stark |
| Deployment cost | Unbekannt und potenziell hoch | Hoch fürs Self-Hosting; gehostete API verfügbar | Nur gehostete API |
| Main reason to watch | Scale plus mögliche Offenheit | Verifizierter offener Frontier-Baseline | Maximale geschlossene Modellfähigkeit |
Vergleichsergebnis
Kimi K3 differenziert sich durch offene Gewichte, ein Kontextfenster von einer Million Tokens und starke Langhorizont-Performance. GPT-5.6 Sol bleibt auf einigen schwierigen Reasoning- und Repository-Reparaturaufgaben stärker, während Claude Fable 5 insbesondere im Software Engineering und bei Computer-Use-Agenten wettbewerbsfähig ist.
Bleibt K4 offen oder breit zugänglich und schließt diese Fähigkeitslücken, wäre seine Bedeutung mehr als eine größere Parameterzahl. Es würde zeigen, dass offene oder halb-offene Systeme die Zuverlässigkeit der stärksten proprietären Agentenplattformen erreichen können. Wird K4 hingegen geschlossen und extrem teuer im Betrieb, fällt die praktische Unterscheidung deutlich kleiner aus.
Was könnte Kimi K4 für Open-Weight-AI bedeuten?
K3 zeigt bereits, dass Open-Weight-Entwicklung in einen Maßstab vordringt, der einst fast ausschließlich proprietären Labs vorbehalten war. K4 könnte diese Grenze weiter verschieben, aber Offenheit hat mehrere Ebenen: herunterladbare Gewichte, nutzbarer Code, eine praktikable Lizenz, reproduzierbare Inferenz, erschwingliche Hardware-Anforderungen und zugängliche gehostete APIs.
Ein Modell kann technisch offen, aber wirtschaftlich unzugänglich sein. K3s 2,8T-Skala bedeutet, dass ernsthaftes Self-Hosting trotz sparsamer Aktivierung und Quantisierung erhebliche Infrastruktur erfordert. Ein noch größeres K4 könnte die Lücke zwischen Forschenden, die die Gewichte inspizieren können, und Organisationen, die das Modell effizient betreiben können, vergrößern.
Für das breitere Ökosystem wäre der ideale K4-Release eine Kombination aus transparenten Gewichten, effizienten Inferenzrezepten, starkem Tool-Use-Verhalten und einer gehosteten API. Diese Kombination würde Forschenden erlauben, das Modell zu untersuchen, Unternehmen könnten es über eine API einsetzen, und spezialisierte Teams es für private oder regulierte Workloads anpassen.
Wann wird Kimi K4 veröffentlicht?
Moonshot AI hat kein Veröffentlichungsdatum für Kimi K4 angekündigt. Öffentliche Berichte verbinden das Modell mit Compute-Beschaffung und Entwicklungsplanung. Ein präziser Monat, ein Quartal oder ein Countdown ist damit unzuverlässig.
Unbekannt ist auch, ob K4 zeitgleich im Kimi-Webprodukt, Kimi Code, Kimi Work, der Moonshot API und einem Open-Weight-Repository erscheint. K3 ist auf mehreren dieser Flächen verfügbar, aber K4 könnte einem gestaffelten Rollout oder einer anderen Distributionsstrategie folgen.
Beachtenswerte Signale sind ein offizieller technischer Blog von Moonshot, ein verifiziertes Modell-Repository, Kimi-Plattform-Dokumentation, eine veröffentlichte Lizenz und eine Model-Card mit reproduzierbaren Evaluierungsdetails. Social-Posts und Parametergerüchte sollten sekundär bleiben, bis eine dieser Quellen erscheint.
Wie lassen sich Kimi-Modelle nutzen, während man auf K4 wartet?
K4 ist derzeit nicht aufrufbar. Entwickler:innen können stattdessen die aktuelle Architektur über Kimi K3 auf CometAPI evaluieren. Die aktuelle Modell-ID ist einfacher Code-Text: kimi-k3. Die Anfrage nutzt POST /v1/chat/completions. Senden Sie keine Produktionsanfragen an eine spekulative kimi-k4-Kennung, bevor eine offizielle Integrationsseite sie veröffentlicht.
Erstellen Sie ein CometAPI-Konto und generieren Sie einen API-Schlüssel. Speichern Sie den Schlüssel in einer Umgebungsvariablen, statt ihn im Anwendungscode zu hardcoden.
from openai import OpenAI client = OpenAI( api_key="YOUR_COMETAPI_KEY", base_url="https://api.cometapi.com/v1", ) response = client.chat.completions.create( model="kimi-k3", messages=[ { "role": "user", "content": "Analyze the architecture of this software project." } ], ) print(response.choices[0].message.content)
Der Codeblock ist Python. Endpoint, Model-ID, Parameternamen und Code-Schlüsselwörter werden absichtlich als Code dargestellt und nicht als Hyperlinks. Sobald K4 verfügbar ist, sollten Entwickler:innen seine reale Modellkennung, Endpoint-Kompatibilität, unterstützte Modalitäten und Preise bestätigen, bevor sie das Produktionsrouting ändern.
Was wissen wir über Kimi K4 noch nicht?
Ein verantwortungsvoller Pre-Release-Artikel sollte die folgenden Unbekannten beibehalten, statt sie mit Community-Schätzungen zu füllen:
- Finale Gesamt- und aktivierte Parameterzahlen
- Anzahl der Experten, Shared Experts und Routing-Strategie
- Kontextfenster und maximale Ausgabelänge
- Unterstützte Ein- und Ausgabemodalitäten
- Open-Weight-Status, Repository und Lizenz
- API-Model-ID, Endpoints, Reasoning-Modi und Preise
- Offizielle Benchmark-Ergebnisse und Evaluierungs-Frameworks
- Quantisierungsformate und Self-Hosting-Hardware-Anforderungen
- Produktverfügbarkeit und Veröffentlichungsdatum
Dieser Abschnitt explizit zu halten, verhindert, dass prognostizierte Spezifikationen später als offizielle Fakten wiederholt werden. Er erleichtert zudem Updates, sobald Moonshot AI Primärdokumentation veröffentlicht.
FAQ
Wurde Kimi K4 veröffentlicht?
Nein. Es gibt keine offizielle Kimi K4 Model-Card, API-Dokumentation oder öffentliche Release-Ankündigung. Die aktuelle Diskussion basiert hauptsächlich auf Berichten, dass Moonshot AI einen größeren Nachfolger von K3 vorbereitet.
Wie groß wird Kimi K4 sein?
Die exakte Größe ist unbekannt. Berichten zufolge könnte es deutlich größer als K3 sein, aber konkrete Multi-Billionen-Parameterangaben wurden von Moonshot AI nicht bestätigt.
Wird Kimi K4 open source sein?
Das ist nicht bestätigt. K3 hat offene Gewichte unter der Kimi K3 License, aber eine frühere Veröffentlichungsstrategie garantiert nicht dieselbe Distribution für K4.
Wird Kimi K4 ein Kontextfenster von einer Million Tokens haben?
Es ist vernünftig zu erwarten, dass K4 K3s Long-Context-Fähigkeit beibehält oder verbessert, aber Moonshot AI hat kein K4-Kontextlimit veröffentlicht.
Können Entwickler:innen Kimi K4 jetzt über CometAPI nutzen?
Keine bestätigte K4-Model-Route ist verfügbar. Entwickler:innen können derzeit Kimi K3 testen und es über dieselbe Integrationsschicht mit anderen Frontier-Modellen vergleichen.
Fazit
Kimi K4 sollte nicht auf eine gemunkelte Parameterzahl reduziert werden. K3 beweist bereits, dass Moonshot AI extreme Sparse-Modellskala, Millionentoken-Kontext, Native Vision, offene Gewichte und langhorizontiges Agentenverhalten kombinieren kann. Die eigentliche Frage ist, ob K4 diese Skala in verlässlichere Softwareentwicklung, stärkere Computerbenutzung, bessere multimodale Feedback-Loops und effizientere Inferenz umsetzen kann.
Die wichtigsten Details bleiben unbekannt: exakte Architektur, Veröffentlichungsdatum, Benchmark-Scores, Lizenz, API-Zugang und Betriebskosten. Bis Moonshot Primärdokumentation veröffentlicht, sollte jede K4-Spezifikation über das berichtete Entwicklungssignal hinaus als Erwartung oder Inferenz gekennzeichnet werden.
Entwickler:innen müssen nicht warten, um die aktuelle Richtung von Moonshot AI zu evaluieren. Kimi K3 ist bereits über CometAPI verfügbar und bietet eine praktische Basis für Coding, Long-Context-Reasoning, multimodale Analyse und Agent-Workflows, bevor Kimi K4 eintrifft.