
TL;DR
GPT-Image-2.5 no tiene un “precio por imagen” fijo. OpenAI cobra el uso de la API por tokens. Tanto GPT-Image-2.5 Flare como GPT-Image-2.5 Sunburst usan las mismas tarifas oficiales por token: $5 por millón de tokens de entrada de texto, $8 por millón de tokens de entrada de imagen y $30 por millón de tokens de salida de imagen. Las entradas en caché de texto e imagen cuestan $1.25 y $2 por millón de tokens, respectivamente.
Para una imagen de 1024×1024, observaciones de calculadoras de terceros sugieren que la generación solo de salida puede variar desde aproximadamente $0.006 en calidad baja hasta alrededor de $0.211 en calidad máxima. La calidad alta ronda $0.053 en ese modelo de planificación. Las facturas reales dependen de los tokens del prompt, imágenes de referencia, reintentos, entradas de edición y el uso real de tokens de salida.
Conclusiones clave
- OpenAI cobra la API de GPT-Image-2.5 por tokens en lugar de un precio universal por imagen.
- Flare y Sunburst tienen las mismas tarifas por token; Sunburst no es un modelo más caro por token.
- Las tarifas oficiales son $5/M para entrada de texto, $8/M para entrada de imagen y $30/M para salida de imagen.
- GPT-Image-2.5 introduce modos de calidad low, medium, high, xhigh, max y auto.
- Una estimación de planificación para una imagen 1024×1024 es aproximadamente $0.0059 en low, $0.0527 en high y $0.2107 en max, antes de los costos de tokens de entrada.
- Flare es la mejor opción predeterminada para generación de alto volumen y sensible a la latencia, mientras que Sunburst se orienta a edición de precisión y flujos creativos premium.
- CometAPI promociona un 20% de descuento en sus APIs del modelo GPT-Image-2.5, con precios destacados de $4/M para entrada y $24/M para salida frente a las tarifas oficiales de $5/M y $30/M correspondientes.
¿Qué es GPT-Image-2.5 y por qué pagas?
OpenAI lanzó ChatGPT Images 2.5 el 8 de septiembre de 2026. La actualización se centra en detalles más nítidos, iluminación y texturas más naturales, mayor preservación de sujetos de referencia, edición multi-turno más fiable y menor latencia de generación. OpenAI afirma que la latencia de generación puede ser hasta un 50% menor que en Images 2.0.
La familia de API tiene dos variantes. GPT-Image-2.5 Flare está optimizado para generación rápida y de alta calidad para el día a día y es la opción predeterminada recomendada por OpenAI para la mayoría de las aplicaciones. GPT-Image-2.5 Sunburst enfatiza la precisión de edición y flujos creativos premium, donde preservar un sujeto o composición existente es más importante que la latencia mínima.
| Especificación | GPT-Image-2.5 Flare | GPT-Image-2.5 Sunburst |
|---|---|---|
| ID del modelo de la API | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
| Posicionamiento | Generación rápida para uso diario | Generación y edición de precisión |
| Entrada | Texto e imágenes | Texto e imágenes |
| Salida | Imágenes | Imágenes |
| Generación de imágenes | Sí | Sí |
| Edición de imágenes | Sí | Sí |
| Ajustes de calidad | low, medium, high, xhigh, max, auto | low, medium, high, xhigh, max, auto |
| Tamaño cuadrado recomendado | 1024×1024 | 1024×1024 |
| Tamaño apaisado recomendado | 1536×1024 | 1536×1024 |
| Tamaño vertical recomendado | 1024×1536 | 1024×1536 |
| Salida con transparencia | PNG / WebP | PNG / WebP |
| Mejor ajuste | Generación a gran volumen, iteración rápida | Imágenes de producto, creatividad de campaña, ediciones precisas |
| Tarifa oficial de salida de imagen | $30/M tokens | $30/M tokens |
La documentación del modelo principal confirma que ambas variantes aceptan entrada de texto e imagen y producen salida de imagen, mientras que function calling, salidas estructuradas y fine-tuning no forman parte de la interfaz del modelo de imagen.
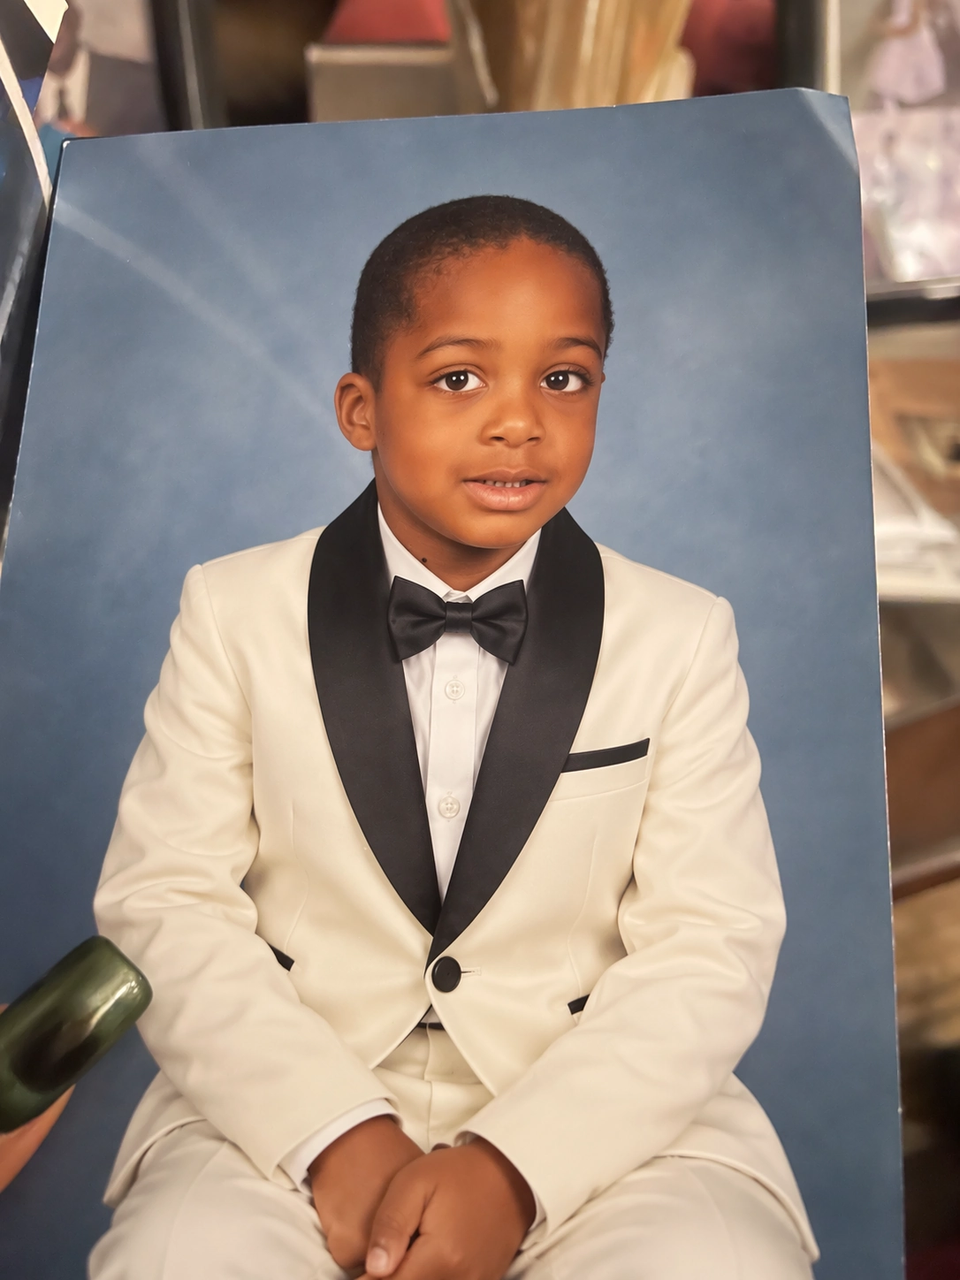
Ejemplo oficial de edición de precisión de GPT-Image-2.5 publicado por OpenAI; el retrato editado preserva la pose y el fondo mientras cambia la ropa del niño.
GPT-Image-2.5 Flare está disponible como
gpt-image-2.5-flare, mientras que su snapshot fechado es
gpt-image-2.5-flare-2026-09-08. Sunburst ofrece de forma similar
gpt-image-2.5-sunbursty
gpt-image-2.5-sunburst-2026-09-08. Los desarrolladores que necesiten un comportamiento del modelo más predecible entre despliegues deberían considerar si fijar un snapshot fechado es apropiado para su flujo de trabajo.
¿Cuánto cuesta la API de GPT-Image-2.5?
La forma más sencilla de entender los precios de GPT-Image-2.5 es separar el costo de entrada del costo de la imagen generada.
La documentación oficial del modelo de OpenAI ofrece las siguientes tarifas por token tanto para Flare como para Sunburst.
| Tipo de token | Precio estándar por 1M tokens | Precio en caché por 1M tokens |
|---|---|---|
| Entrada de texto | $5.00 | $1.25 |
| Entrada de imagen | $8.00 | $2.00 |
| Salida de imagen | $30.00 | — |
| Salida de texto | No facturado | — |
El número importante para la mayoría de las cargas de trabajo de texto a imagen es $30 por millón de tokens de salida de imagen. Un prompt corto normalmente contribuye relativamente poco en comparación con la propia imagen generada. Los flujos de trabajo de edición pueden costar más porque las imágenes de referencia también consumen tokens de entrada de imagen.
Costo total de la API = costo de entrada de texto + costo de entrada de imagen + costo de salida de imagen.
Para una simple llamada de texto a imagen sin imagen de referencia, el componente de salida de imagen suele dominar. Para un flujo de trabajo de edición de imagen con varios recursos de referencia de alta resolución, el costo de entrada se vuelve más relevante.
¿Cuánto cuesta una imagen de GPT-Image-2.5?
Aquí es donde el precio se vuelve menos directo.
La documentación de Flare y la documentación de Sunburst indican que la calculadora de GPT Image 2 no estima el consumo de tokens de GPT Image 2.5. Por otra parte, APIdog registró una entrada compartida de la calculadora de GPT Image 2.5 el 9 de septiembre de 2026 con presupuestos estimados de tokens de salida para Flare y Sunburst. Estas cifras son estimaciones de presupuesto y no precios oficiales garantizados por imagen.
| Calidad | Tokens de salida 1024×1024 | Costo estimado de salida | Tokens de salida 1536×1024 | Costo estimado de salida |
|---|---|---|---|---|
| low | 196 | $0.00588 | 158 | $0.00474 |
| medium | 439 | $0.01317 | 343 | $0.01029 |
| high | 1,756 | $0.05268 | 1,372 | $0.04116 |
| xhigh | 3,122 | $0.09366 | 2,459 | $0.07377 |
| max | 7,024 | $0.21072 | 5,488 | $0.16464 |
Estos números cubren solo la salida de imagen. Tu solicitud real también puede incluir tokens de entrada de texto, tokens de entrada de imagen, reintentos, variaciones, pasadas de edición u otro uso.
Una afirmación más precisa que “GPT-Image-2.5 cuesta $0.053 por imagen” es: una generación de 1024×1024 en alta calidad puede presupuestarse en aproximadamente $0.053 en costo de tokens de salida según la estimación observada, antes de los costos de entrada y reintentos.
¿Es la alta calidad de GPT-Image-2.5 cuatro veces más barata que la alta de GPT Image 2?
A primera vista, sí: las etiquetas sugieren una reducción dramática.
Los presupuestos de tokens registrados por APIdog muestran la alta de GPT-Image-2.5 en alrededor de 1,756 tokens de salida, o aproximadamente $0.05268 para una imagen 1024×1024. La alta de GPT Image 2 estaba alrededor de $0.211 para el mismo tamaño cuadrado.
Sin embargo, no es una comparación “mismas calidades por un cuarto del precio” en términos equivalentes. La escala de calidad cambió.
| Ajuste de GPT-Image-2.5 | Costo aprox. de salida 1024×1024 | Equivalente aproximado del presupuesto de tokens en GPT Image 2 |
|---|---|---|
| low | $0.00588 | baja anterior |
| medium | $0.01317 | por debajo de la media anterior |
| high | $0.05268 | media anterior |
| xhigh | $0.09366 | entre media y alta anteriores |
| max | $0.21072 | alta anterior |
Los desarrolladores que migren un pipeline existente no deberían simplemente reutilizar el ajuste high y concluir que el nuevo modelo es cuatro veces más barato. Si el objetivo es aproximadamente el mismo presupuesto de tokens de salida que la alta de GPT Image 2, el ajuste más cercano en GPT-Image-2.5 es max, no high.
¿Cuesta más GPT-Image-2.5 Sunburst que Flare?
No — no por token. Ambas variantes usan la misma carta de precios oficial. Sunburst no tiene una tarifa $/token más alta simplemente porque esté posicionada como el modelo de mayor precisión.
| Factor de costo | Flare | Sunburst |
|---|---|---|
| Entrada de texto | $5/M | $5/M |
| Texto en caché | $1.25/M | $1.25/M |
| Entrada de imagen | $8/M | $8/M |
| Imagen en caché | $2/M | $2/M |
| Salida de imagen | $30/M | $30/M |
| Compensación primaria | Menor latencia | Mayor precisión de edición |
La diferencia es principalmente el tiempo y el ajuste al flujo de trabajo, no el precio por token. OpenAI posiciona Flare como la opción predeterminada para la mayoría de las aplicaciones y afirma que ofrece imágenes de mayor calidad que GPT Image 2 con hasta un 50% menos de latencia. Sunburst está pensado para ediciones más controladas y trabajo visual de producción, y puede tardar más en generar.
Si Sunburst produce un recurso de campaña utilizable en un intento, mientras que Flare requiere dos o tres reintentos, Sunburst puede tener en realidad un menor costo por imagen aceptada, a pesar de tener el mismo precio nominal por token.
¿Qué tan bueno es GPT-Image-2.5 por su precio?
El precio importa solo si la calidad de salida es competitiva.
La tabla de clasificación actual de preferencias humanas de Arena sitúa ambas variantes de GPT-Image-2.5 por delante de GPT Image 2 en generación de texto a imagen y edición de una sola imagen. Son puntuaciones de preferencia de terceros y no benchmarks de calidad controlados por OpenAI, y los resultados de GPT-Image-2.5 están marcados como preliminares.
| Modelo | Puntuación de Arena en texto a imagen | Puntuación de edición de imagen única |
|---|---|---|
| GPT-Image-2.5 Sunburst | 1421 ± 13 | 1520 ± 9 |
| GPT-Image-2.5 Flare | 1399 ± 13 | 1491 ± 9 |
| GPT Image 2 (medium) | 1381 ± 4 | 1461 ± 3 |
| Grok Imagine Image 2.0 (low) | 1315 ± 12 | 1439 ± 8 |
El conjunto de referencia también incluye la API Grok Imagine Image 2.0 en CometAPI.
El resultado más notable es la puntuación de edición. Sunburst aventaja a Flare en aproximadamente 29 puntos en la tabla de edición de una sola imagen, mientras que ambos se mantienen por delante de GPT Image 2. Eso está alineado con el posicionamiento de OpenAI de Sunburst como la opción orientada a la precisión. Ver la tabla de edición de imágenes.
El material de evaluación propio de OpenAI se centra más en la seguridad que en la preferencia estética. En su system card, la empresa informa tasas finales de presentaciones de generación insegura del 1.09% para Sunburst, 1.41% para Flare y 1.64% para la base de Images 2.0 en su conjunto de evaluación de seguridad adversarial. Estas son mediciones de seguridad, no puntuaciones de calidad de imagen.
¿Cuánto cuesta GPT-Image-2.5 en CometAPI?
Para los desarrolladores que quieren el modelo a través de una pasarela de API multi-modelo, ambas variantes están disponibles en CometAPI. La API de GPT-Image-2.5 Flare en CometAPI muestra $4 por millón de tokens de entrada y $24 por millón de tokens de salida, en comparación con las cifras oficiales de $5/M y $30/M, lo que representa un 20% de descuento. La API de GPT-Image-2.5 Sunburst en CometAPI publica la misma comparación destacada.
| Ruta de precios | Precio de entrada | Precio de salida de imagen | Descuento mostrado |
|---|---|---|---|
| OpenAI oficial | $5/M entrada texto | $30/M salida imagen | — |
| CometAPI | $4/M entrada | $24/M salida | 20% |
Detalle de precios a verificar antes de presupuestar producción: OpenAI distingue entrada de texto a $5/M de entrada de imagen a $8/M, mientras que CometAPI resume los precios con un par general entrada/salida. Los flujos con muchas imágenes de referencia deberían confirmar el panel de facturación en vivo antes de asumir que cada token de entrada de imagen recibe la tarifa de entrada mostrada.
| Calidad | Costo aprox. de salida en OpenAI | Costo aprox. de salida en CometAPI |
|---|---|---|
| low | $0.00588 | $0.00470 |
| medium | $0.01317 | $0.01054 |
| high | $0.05268 | $0.04214 |
| xhigh | $0.09366 | $0.07493 |
| max | $0.21072 | $0.16858 |
De nuevo, se trata de costos estimados de salida, no de precios integrales por solicitud.
¿Cuánto costarían 10,000 imágenes de GPT-Image-2.5?
El precio a gran escala hace que la diferencia sea más fácil de ver. Supongamos que una plataforma de contenido genera 10,000 imágenes cuadradas y que cada salida consume aproximadamente el presupuesto de tokens observado para su nivel de calidad seleccionado.
| Calidad | Gasto aprox. de salida en OpenAI para 10,000 imágenes | Gasto aprox. de salida en CometAPI |
|---|---|---|
| low | $58.80 | $47.04 |
| medium | $131.70 | $105.36 |
| high | $526.80 | $421.44 |
| xhigh | $936.60 | $749.28 |
| max | $2,107.20 | $1,685.76 |
La tabla es útil para presupuestar infraestructura, pero un equipo de producción real debería rastrear algo más significativo que el costo por imagen generada: el costo por imagen aceptada.
Usando la estimación de alta calidad 1024×1024 de la tabla, diez generaciones cuestan aproximadamente $0.5268 en tokens de salida. Si se aceptan seis, el costo efectivo de tokens de salida es $0.5268 ÷ 6 = $0.0878 por recurso aceptado.
Un modelo más capaz que reduzca los reintentos puede ser económicamente mejor incluso si una sola solicitud consume ligeramente más tokens.
¿Qué ajuste de calidad de GPT-Image-2.5 ofrece la mejor relación valor-precio?
Para la mayoría de las aplicaciones de producción, high es un punto de partida sensato en lugar de max. Low es más adecuado para previsualizaciones y experimentación barata. Medium funciona bien cuando se generan muchos conceptos que se filtrarán después. High ofrece un equilibrio más sólido de calidad de producción manteniéndose dramáticamente por debajo del presupuesto máximo de tokens. Xhigh se vuelve atractivo cuando los recursos necesitan un pulido adicional pero no justifican el presupuesto completo de max. Max debería reservarse en general para recursos finales donde la fidelidad importa más que el costo de generación.
La ventaja económica subyacente de la escala de seis niveles es que no tienes que pagar precios de calidad máxima en todas las etapas de un flujo creativo. Un pipeline práctico puede generar conceptos en medium, seleccionar candidatos, refinar los supervivientes en high y producir solo los recursos principales finales en xhigh o max.
¿Cómo puedes calcular el costo de GPT-Image-2.5 a partir del uso de la API?
La forma más segura de estimar el gasto de producción es registrar el uso real de tokens en lugar de depender permanentemente de una tabla estática por imagen. Para las tarifas oficiales de OpenAI, el cálculo es directo:
Estima cada solicitud en palabras: multiplica los tokens de entrada de texto por $5 por millón, los tokens de entrada de imagen por $8 por millón y los tokens de salida de imagen por $30 por millón, luego suma las tres cantidades. Por ejemplo, 120 tokens de entrada de texto más 1,756 tokens de salida de imagen cuestan alrededor de $0.0006 + $0.05268 = $0.05328 antes de cualquier cargo por entrada de imagen. Para solicitudes de edición, añade los tokens de entrada de imagen informados por la API, especialmente cuando se suministran varias imágenes de referencia.
Para una generación simple con 120 tokens de entrada de texto y 1,756 tokens de salida de imagen, la parte de salida es alrededor de $0.05268, mientras que el prompt corto añade solo una cantidad muy pequeña. Para edición, añade los tokens de entrada de imagen devueltos por tu solicitud real. Eso es particularmente importante cuando se proporcionan múltiples imágenes de referencia.
¿Vale la pena el precio de GPT-Image-2.5?
Para la mayoría de las nuevas integraciones de imagen de OpenAI, Flare es el punto de partida obvio. Comparte la misma tarifa por token que GPT Image 2, mientras que OpenAI informa una mayor calidad de imagen y hasta un 50% menos de latencia. La escala de calidad ampliada también permite a los desarrolladores gastar menos en borradores sin renunciar a la opción de un presupuesto de tokens mucho mayor para imágenes finales.
Sunburst tiene más sentido cuando los fallos de edición son costosos. Fotografía de comercio electrónico, campañas de marca, revisiones repetidas de imágenes, flujos de trabajo de preservación de sujetos y otros trabajos creativos de producción pueden justificar un tiempo de generación más largo porque el objetivo real no es el costo mínimo por solicitud, sino el costo mínimo por recurso aprobado.
Para cargas de trabajo de alto volumen sensibles al precio, la estrategia más sólida no es “usar siempre la calidad más barata”. Es enrutar tareas de forma inteligente: Flare para generación y exploración, Sunburst donde la precisión de edición reduce materialmente el retrabajo y niveles de calidad más altos solo después de que un recurso haya ganado el presupuesto adicional de tokens.
FAQ
¿Una suscripción a ChatGPT incluye créditos de API para GPT-Image-2.5?
No. El acceso a ChatGPT y la facturación de la API para desarrolladores son independientes. El uso de la API se cobra a la cuenta de API según los tokens procesados.
¿Qué datos de uso debería conservar un equipo para auditorías de costos?
Almacena el modelo, el ajuste de calidad, las dimensiones de la imagen, los tokens de entrada de texto, los tokens de entrada de imagen, los tokens de salida de imagen, el número de reintentos y si el resultado fue aceptado. Estos campos permiten conciliar facturas y calcular el costo por recurso aceptado.
¿Cómo deberían los equipos estimar el costo de producción antes de escalar?
Ejecuta un lote representativo con la calidad y dimensiones previstas, registra el uso real de tokens y divide el costo total del lote por el número de recursos aceptados. Esto captura reintentos y tasas de rechazo que una estimación estática por imagen no puede medir.