
Resumen rápido: Para usar la Claude Fable 5.1 API en CometAPI, prepara una clave de API, establece el ID de modelo en claude-fable-5-1 y valida una solicitud pequeña antes de construir un flujo de trabajo más largo. Esta guía cubre acceso, esfuerzo, streaming, herramientas, caché, migración y comprobaciones de producción. Trata el despliegue como algo más que cambiar el string del modelo: confirma la compatibilidad de la ruta, valida salidas y mide la calidad de tareas aceptadas, latencia y costo antes de ampliar el uso.
Puntos clave
- Haz que funcione una solicitud primero: confirma credenciales, acceso al modelo, el endpoint elegido y una respuesta utilizable con datos de prueba no sensibles.
- Elige el esfuerzo deliberadamente: comienza en alto y compara otras configuraciones en tareas representativas en lugar de usar esfuerzo máximo para cada solicitud. Claude Code predetermina Alto. Claude Cowork / Claude.ai predetermina Medio.
- Revisa el comportamiento de migración: la selección forzada de herramientas se rechaza; mantén pasos de flujo de trabajo obligatorios y validación de argumentos de herramientas en el código de la aplicación.
- Mide el flujo de trabajo completo: rastrea uso de caché, costo de tokens, latencia, rechazos, comportamiento de fallback y si el resultado final pasa tus comprobaciones de aceptación.
Para contexto, consulta el seguimiento anterior de Fable 5.1 de CometAPI y el tutorial del Fable 5 API. Este artículo se concentra en el flujo de integración actual.
¿Qué es Claude Fable 5.1?
Claude Fable 5.1 es el modelo de disponibilidad general de mayor capacidad de Anthropic para codificación ambiciosa, investigación multietapa, uso de computadora y flujos profesionales con muchos documentos. Anthropic recomienda comenzar la mayoría de las cargas con Claude Opus 5 y escalar a Fable 5.1 cuando evaluaciones de Opus de alto esfuerzo aún se queden cortas.
La distinción es operacional: Fable 5.1 está diseñado para seguir trabajando a través de pasos dependientes, recuperarse tras una llamada de herramienta fallida, verificar resultados y reportar progreso durante ejecuciones largas. Eso puede mejorar tasas de finalización, pero también hace que costo, latencia y observabilidad sean centrales para el despliegue.
Especificaciones de la API de Claude Fable 5.1
| Especificación oficial | Claude Fable 5.1 |
|---|---|
| Proveedor | Anthropic |
| ID del modelo | claude-fable-5-1 |
| Fecha de lanzamiento | September 1, 2026 |
| Ventana de contexto | 1,000,000 tokens |
| Salida máxima | 128,000 tokens |
| Entrada y salida | Text and images to text |
| Pensamiento | Adaptive, always on |
| Esfuerzo predeterminado | API is High, Claude Code defaults to High,Claude Cowork / Claude.ai defaults to Medium |
| Niveles de esfuerzo | low, medium, high, xhigh, max |
| Límite de conocimiento | June 2026 |
| Precio oficial | $10 input / $50 output per million tokens |
| Lectura de caché | $0.25 per million tokens |
La descripción general oficial confirma una ventana de contexto de 1M y 128K de salida máxima. El pensamiento adaptativo está siempre activo; la profundidad de razonamiento se controla con effort en lugar de un presupuesto tradicional de thinking-tokens.
API de Claude Fable 5.1: rendimiento oficial en benchmarks
El resumen de benchmarks es intencionalmente compacto porque el propósito principal del artículo es la implementación. Los resultados a continuación identifican dónde la prima del API probablemente importe más.
| Benchmark de Anthropic | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1,853 Elo | 1,723 | 1,824 | 1,711 |
| OSWorld 2.0, parcial | 77.9% | 72.9% | 75.4% | — |
| Humanity's Last Exam, sin tools | 60.9% | 57.8% | 56.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
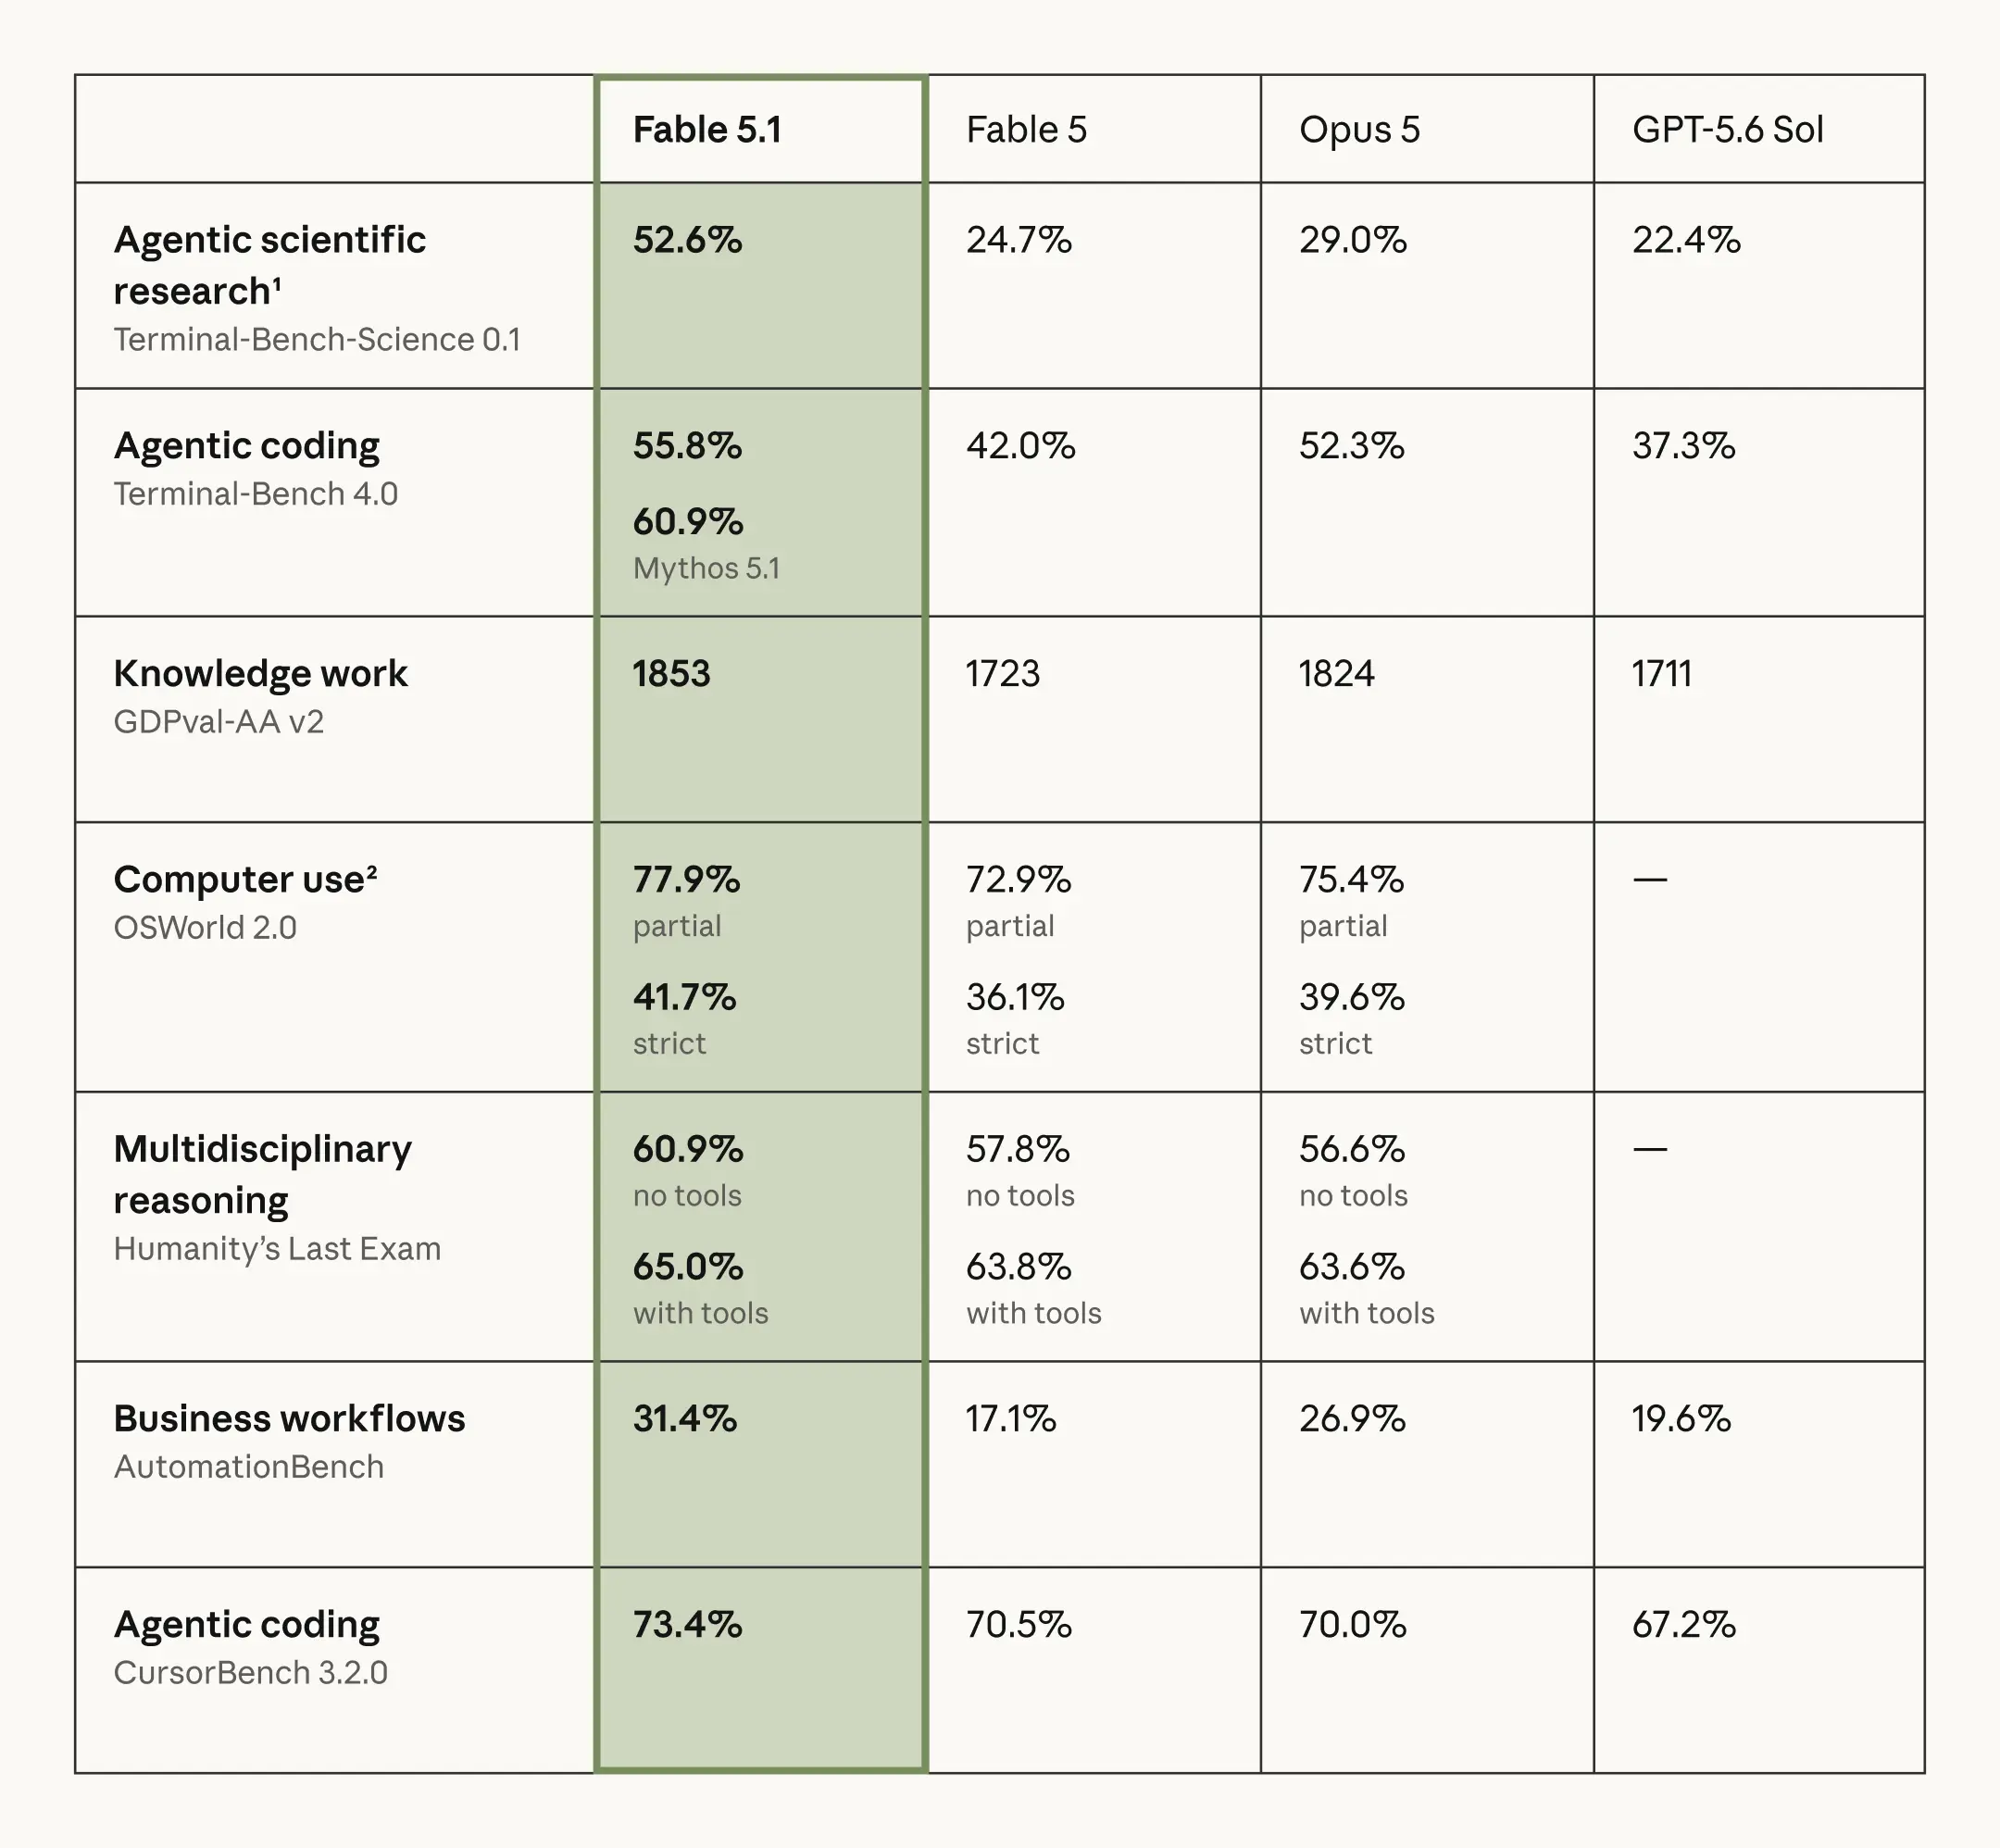
Comparación oficial de benchmarks de Claude Fable 5.1 de Anthropic
La mayor ganancia generacional en este conjunto es Terminal-Bench-Science: 52.6% versus 24.7%. AutomationBench sube de 17.1% a 31.4%, mientras que Terminal-Bench 4.0 mejora a 55.8%. El resultado es un caso sólido para probar Fable 5.1 en agentes de investigación, codificación de larga duración y automatización empresarial—no para enrutar cada solicitud corta al modelo más caro.
¿Qué cambió respecto a la API Claude Fable 5?
| Dimensión | Claude Fable 5.1 | Claude Fable 5 | Impacto de migración |
|---|---|---|---|
| Función principal | Agentes y research de larga duración más fuertes | Modelo público original Mythos-class | Re-evaluar los flujos más difíciles |
| Elección forzada de tools | Devuelve un error | Anteriormente soportado | Eliminar cualquier forcing y el por nombre |
| Historial de thinking | Reglas de compatibilidad más estrictas | Comportamiento anterior | Mantener historiales solo-append |
| Actualizaciones de progreso | Actualizaciones legibles entre llamadas de tools | No disponible en esta forma | Exponer estado de ejecuciones largas |
| Esfuerzo por mensaje | Disponible en beta | No disponible en esta forma | Ajustar profundidad dentro de una conversación |
| Precio de lectura de caché | $0.25 / MTok | $1.00 / MTok | Recalcular la economía de contextos largos |
| Precio de entrada/salida | $10 / $50 | $10 / $50 | Sin cambio en tarifas de lista |
Tres cambios incompatibles
Ya no se admite el uso forzado de herramientas
Claude Fable 5.1 rechaza valores tool_choice que obliguen cualquier herramienta o una herramienta específicamente nombrada, devolviendo un error 400 invalid-request. Mantén la selección automática, usa esquemas estrictos o salidas estructuradas para validación y aplica pasos obligatorios del flujo de trabajo en la orquestación de la aplicación en lugar de forzar una llamada de herramienta del modelo.
Modelos anteriores no pueden leer bloques de pensamiento de Fable 5.1
La compatibilidad de thinking es de un solo sentido: Fable 5.1 puede consumir bloques de pensamiento creados por modelos Claude anteriores compatibles, pero los modelos anteriores no pueden leer bloques creados por Fable 5.1. Un router o fallback que cambie a un modelo anterior puede descartar esos bloques antes de la inferencia, por lo que las integraciones deben registrar los cambios de modelo y probar explícitamente el comportamiento de fallback.
Editar turnos anteriores invalida el pensamiento preservado
Cambiar un system prompt anterior, definición de herramienta, mensaje o bytes de archivo referenciado puede invalidar bloques de pensamiento posteriores. Trata el prefijo de la conversación como de solo adición, usa instrucciones a mitad de conversación en lugar de reescribir el historial y monitorea transformaciones por desajuste de prefijo durante la migración.
Cinco capacidades añadidas de la API
Esfuerzo por mensaje
Las aplicaciones pueden cambiar el esfuerzo durante una conversación sin invalidar la caché de prompt. Esta capacidad beta permite que un flujo reduzca el esfuerzo en seguimientos rutinarios y lo aumente en turnos de planificación, depuración o verificación difíciles.
Mensajes de sistema con alcance de turno
Un mensaje de sistema beta puede aplicarse a un turno y dejar de renderizarse tras el siguiente mensaje del usuario mientras permanece sin cambios en el historial. Es útil para instrucciones temporales en bucles de herramientas porque preserva tanto la coincidencia de caché de prompt como la validez de bloques de pensamiento posteriores.
Actualizaciones de progreso legibles entre llamadas de herramientas
Con la opción beta de visualización de progreso, bloques de pensamiento seleccionados pueden llevar breves actualizaciones de estado que una aplicación puede mostrar a usuarios mientras el razonamiento privado permanece oculto. Los agentes de larga ejecución deben tratar estas actualizaciones como estado operativo, no como respuestas finales.
Precio de lectura de caché más bajo
Las lecturas de caché cuestan $0.25 por millón de tokens, un cuarto de la tarifa de lectura de caché de Fable 5, mientras que los precios base de entrada y salida permanecen sin cambios. Esto puede reducir materialmente el costo de sesiones largas que reutilizan repetidamente un prefijo estable en caché.
Proveniencia del contenido
El texto generado lleva la marca de agua estadística de Anthropic, mientras que los medios compatibles recuperados a través del Files API pueden incluir credenciales de contenido C2PA firmadas. Estos mecanismos de procedencia no agregan tokens de prompt ni requieren cambios en el formato de la solicitud.
¿Qué necesitas antes de usar la API de Claude Fable 5.1?
- Una cuenta y clave de API: inicia sesión en CometAPI y genera una clave en la consola de claves API. Verifica el acceso al modelo y que tu cuenta esté lista para facturación basada en uso antes de enviar llamadas de prueba.
- Un runtime local: usa una terminal con curl para el primer ejemplo HTTP. Para los ejemplos en Python, prepara Python y pip en un entorno aislado y luego instala el SDK usado por tu ejemplo elegido.
- Una ruta seleccionada: la Claude Fable 5.1 API en CometAPI ofrece formatos Messages y Chat Completions. Usa la base URL y formato de solicitud coincidente; no mezcles sus payloads.
- Configuración segura: establece
COMETAPI_KEYfuera de archivos fuente comprometidos, usaclaude-fable-5-1como ID de modelo y asegúrate de que tu red pueda alcanzarhttps://api.cometapi.com. - Una prueba segura y verificación de aceptación: comienza con un prompt corto y no sensible. Confirma que la respuesta contiene contenido utilizable, inspecciona uso y estado de finalización y verifica los requisitos de manejo de datos de tu organización antes de enviar documentos o logs reales.
Cómo acceder a Claude Fable 5.1 a través de CometAPI
CometAPI expone Claude Fable 5.1 mediante una ruta Messages compatible con Anthropic y una ruta Chat Completions compatible con OpenAI. Usa Messages cuando necesites effort nativo, thinking, caching y semántica de herramientas de Claude; usa Chat Completions cuando tu aplicación ya estandariza el SDK de OpenAI.
Paso 1: Almacena la clave de API
export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Paso 2: Realiza la primera solicitud de Messages
curl https://api.cometapi.com/v1/messages \
  --header "Authorization: Bearer $COMETAPI_KEY" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "max_tokens": 2048,
    "messages": [{
      "role": "user",
      "content": "Review this deployment architecture and list the three highest-risk failure modes."
    }]
  }'
Paso 3: Usa el SDK de Anthropic para Python
pip install anthropic
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
)

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[{
        "role": "user",
        "content": "Find the root cause of this test failure and propose a verified patch.",
    }],
)

print(response.content[0].text)
Paso 4: Usa el SDK de OpenAI para Python
pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="claude-fable-5-1",
    messages=[{
        "role": "user",
        "content": "Design a migration plan for this service.",
    }],
)

print(response.choices[0].message.content)
¿Cómo funciona el razonamiento de la API Claude Fable 5.1?
Modelos anteriores no pueden leer bloques de pensamiento de Claude Fable 5.1
Los bloques de pensamiento producidos por Fable 5.1 no son retrocompatibles con modelos Claude anteriores. Si un flujo cambia de modelo a mitad de conversación, elimina los bloques de thinking incompatibles o inicia una nueva rama conservando solo los mensajes visibles para el usuario y resultados de herramientas requeridos para la siguiente solicitud.
Editar turnos anteriores invalida el pensamiento preservado
Un bloque de pensamiento preservado está vinculado criptográficamente al estado de conversación precedente. Cambiar un system prompt anterior, definición de herramienta, mensaje del usuario, respuesta del asistente o resultado de herramienta puede romper ese vínculo y disparar un error de historial de thinking. Mantén el prefijo reproducido idéntico byte a byte y añade nuevos turnos en lugar de reescribir los antiguos.
Pensamiento preservado a lo largo de turnos
Cuando el prefijo de la conversación permanece sin cambios, el pensamiento preservado puede llevar un estado de razonamiento útil a turnos posteriores. Almacena bloques de pensamiento con su orden de mensajes original, reprodúcelos solo a un modelo compatible y trata una edición del historial como una nueva rama de conversación en lugar de mutar la transcripción existente.
Controla el razonamiento con el esfuerzo
Comienza el trabajo de producción difícil en esfuerzo alto y luego prueba configuraciones más bajas en turnos rutinarios y más altas solo donde la calidad de tareas aceptadas mejore lo suficiente como para justificar latencia y tokens adicionales. Debido a que el esfuerzo puede cambiar entre turnos, una conversación ya no necesita un único nivel de razonamiento a lo largo de todo el intercambio.
Fable 5.1 utiliza pensamiento adaptativo como su único modo de thinking. Comienza en esfuerzo alto y luego mide configuraciones más bajas para trabajo rutinario y xhigh o max solo cuando la capacidad adicional justifique costo y latencia.
| Esfuerzo | Rol recomendado | Compensación |
|---|---|---|
| low | Trabajo rutinario, bien especificado | Más rápido y más económico |
| medium | Tráfico de producción equilibrado | Profundidad moderada |
| high | Trabajo difícil predeterminado | Mejor punto de partida |
| xhigh | Codificación y agentes de larga duración | Más latencia y tokens |
| max | Tareas más difíciles de mayor valor | Costo y latencia secundarios |
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Audit this repository migration plan.",
    }],
)
API Claude Fable 5.1: transmite respuestas largas, usa herramientas y caché de prompt
Configura conjuntamente los siguientes controles: esfuerzo de razonamiento, streaming, ejecución de herramientas, caché de prompt y manejo de salvaguardas y datos retenidos. Cada uno afecta cómo se observa, valida y opera una solicitud de larga ejecución.
Transmite respuestas largas
El streaming es el valor predeterminado más seguro para tareas largas y de alto esfuerzo porque evita esperar a que una respuesta grande se complete antes de que la aplicación reciba cualquier salida.
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
Usa herramientas sin forzar la elección de herramienta
Fable 5.1 rechaza la selección forzada de herramientas usando tool_choice de tipo any o una herramienta nombrada. Usa selección automática, esquemas estrictos, valida argumentos de herramientas en el código de la aplicación y controla la secuencia obligatoria del flujo fuera del modelo. Si un flujo requiere ejecutar una herramienta específica, no confíes en tool_choice para hacer cumplir la secuencia. Haz que la aplicación invoque esa herramienta o implementa el paso requerido en el código de orquestación.
tools = [{
    "name": "search_incidents",
    "description": "Search recent production incidents",
    "input_schema": {
        "type": "object",
        "properties": {
            "service": {"type": "string"},
            "days": {"type": "integer"},
        },
        "required": ["service", "days"],
    },
}]

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    tools=tools,
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "Review checkout incidents from the last 30 days.",
    }],
)
Usa caché de prompt para contextos largos
Anthropic lista lecturas de caché a $0.25 por millón de tokens, un cuarto de la tasa de Fable 5. Coloca instrucciones de sistema estables, esquemas de herramientas y material de referencia grande antes del contenido dinámico del usuario y luego verifica aciertos de caché en los metadatos de uso.
messages = [{
    "role": "user",
    "content": [
        {
            "type": "text",
            "text": large_reference_document,
            "cache_control": {"type": "ephemeral"},
        },
        {
            "type": "text",
            "text": "Identify obligations that changed in this revision.",
        },
    ],
}]
Gestiona salvaguardas y retención de datos
Anthropic indica que muchas solicitudes señaladas de ciberseguridad y biología se enrutan a modelos menos capaces. Trata un rechazo o fallback como un estado de aplicación: registra la razón de paro, muestra un mensaje apropiado al usuario y enruta a una alternativa aprobada donde la política lo permita.
Fable también requiere retención de datos de 30 días por defecto para monitoreo de seguridad. Confirma la elegibilidad organizacional y configuraciones de retención antes de depurar una solicitud sintácticamente válida como si fuera solo un problema de formato de API.
Fable 5.1 vs Opus 5 vs Sonnet 5
| Dimensión de decisión | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Contexto / salida máx. | 1M / 128K | 1M / 128K | 1M / 128K |
| Precio oficial in/out | $10 / $50 | $5 / $25 | $2 / $10 |
| Latencia relativa | Más lenta | Moderada | Rápida |
| Esfuerzo predeterminado | high | high | high |
| Principal fortaleza | Máxima capacidad de largo horizonte | Razonamiento general premium | Equilibrio velocidad/costo |
| Mejor rol en producción | Escalación de capacidad | Trabajo complejo por defecto | Baseline de alto volumen |
Resultado de selección: inicia el tráfico rutinario en Sonnet 5, usa Opus 5 para trabajo general complejo y escala solo las tareas más difíciles o repetidamente fallidas a Fable 5.1. Esto sigue la guía de Anthropic y evita que el razonamiento premium se convierta en el costo predeterminado de cada solicitud.
Precios a través de CometAPI
| Ruta | Entrada / MTok | Salida / MTok | Lectura de caché / MTok |
|---|---|---|---|
| Precio de lista de Anthropic | $10 | $50 | $0.25 |
| Precio listado en CometAPI | $8 | $40 | Check live route |
| Diferencia nominal in/out | 20% menor | 20% menor | Varía por ruta |
La página del modelo en vivo de CometAPI es la fuente de verdad para disponibilidad de rutas y precios actuales. Para una solicitud con 100,000 tokens de entrada sin caché y 10,000 tokens de salida, la estimación simple de CometAPI es $1.20; el costo real puede cambiar con caching, reasoning, comportamiento por lotes y routing. Los precios están sujetos a cambio; verifica la página del modelo en vivo antes de presupuestar producción.
Lista de verificación de migración desde Fable 5
- Cambia el ID del modelo de claude-fable-5 a claude-fable-5-1.
- Elimina tool_choice any y forcing de herramienta nombrada; usa auto.
- Sustituye supuestos de presupuesto de thinking antiguos por output_config.effort.
- Comienza la evaluación en esfuerzo alto y luego ajusta contra tareas reales.
- Mantén historiales de solo adición cuando contengan bloques de pensamiento preservados.
- Incrementa max_tokens para ejecuciones largas de alto esfuerzo.
- Verifica aciertos de caché a partir de metadatos de uso.
- Maneja rechazos y fallbacks como estados explícitos.
- Reproduce trazas de producción y compara tasa de tareas aceptadas, latencia y costo.
Estrategia de migración más segura: mantén historiales de solo adición. Fable 5.1 puede preservar bloques de pensamiento a través de turnos, pero los bloques de pensamiento reproducidos están vinculados al estado de conversación precedente; cambiar system prompts, tools o mensajes anteriores puede invalidar ese vínculo.
Errores comunes de la API
Error 400 tras cambiar llamadas de herramientas
Causa probable: tool_choice forzado usando any o una herramienta nombrada. Usa auto y aplica la secuencia requerida en la lógica de la aplicación.
claude-fable-5.1 no funciona
El ID canónico usa guiones: claude-fable-5-1.
La salida termina antes de lo esperado
effort controls how much reasoning the model performs, while max_tokens limits the response token budget. Higher effort can require more output budget, so production applications should tune both independently. Raise max_tokens where justified and stream long responses.
La caché de prompt nunca acierta
Mantén el prefijo en caché idéntico byte a byte; timestamps, herramientas reordenadas y cambios en system messages impiden la reutilización.
Una respuesta HTTP exitosa no contiene una respuesta normal
Inspecciona stop_reason y metadatos de fallback en lugar de tratar cada rechazo como un error de transporte.
Reproducir el historial produce un error de pensamiento
No edites turnos anteriores antes de bloques de pensamiento preservados de Fable 5.1. Usa historial de solo adición o controles de migración actuales.
¿Cómo deberías usar la API Claude Fable 5.1 en producción?
Separa el enrutamiento de solicitudes, ejecución de modelos, ejecución de herramientas, validación y evaluación. Registra ID de modelo, esfuerzo, latencia, uso de tokens, uso de caché, razón de paro, comportamiento de fallback y éxito final de la tarea.
Usa Fable 5.1 para migraciones a nivel de repositorio, depuración difícil, agentes de larga duración, investigación profunda, síntesis de documentos grandes y tareas de alto valor donde modelos más baratos fallan repetidamente. Evítalo como predeterminado para resúmenes, clasificación, extracción y respuestas cortas de atención al cliente.
Ejemplo: Investigar un incidente de checkout
Un equipo podría proporcionar errores de checkout sanitizados, diffs de despliegue recientes y runbooks relevantes. La aplicación recupera registros de incidentes coincidentes y luego pide al modelo clasificar posibles causas y conectar cada hipótesis con evidencia. Un ingeniero revisa los pasos diagnósticos propuestos y aprueba una prueba en un sandbox usando transacciones sintéticas. La puerta de aceptación es un comportamiento reproducible, evidencia rastreable y comprobaciones de regresión aprobadas; cualquier remediación en producción requiere aprobación humana separada.
Ejemplo: Analizar cambios en requisitos operativos
Un equipo podría suministrar un manual operativo aprobado, políticas de soporte y un borrador revisado. Mantén el material de referencia inalterado como contexto estable y luego pide al modelo comparar obligaciones cambiadas, equipos responsables, plazos y excepciones. Cada hallazgo propuesto debe referenciar los pasajes relevantes en ambas versiones y distinguir cambios explícitos de interpretaciones inciertas. La puerta de aceptación es que un revisor confirme cada cambio reportado contra su evidencia citada antes de actualizar procedimientos o notificar equipos afectados.
Conclusión
Claude Fable 5.1 no es una actualización de string de modelo plug-and-play. Su comportamiento con herramientas forzadas, reglas de historial de pensamiento, controles de effort, economía de caché y características de progreso en ejecuciones largas requieren una migración deliberada.
El despliegue más efectivo usa Claude Sonnet 5 para volumen rutinario, Claude Opus 5 para tráfico complejo por defecto y Claude Fable 5.1 como una escalación de capacidad medida. Promuévelo solo cuando la finalización de tareas aceptadas mejore lo suficiente como para justificar costo y latencia totales.