
TL;DR
Z.AI a publiquement nommé GLM-6.0 et placé le Full Self-Training au centre de sa feuille de route de nouvelle génération. L’orientation divulguée relie l’expérience auto-générée à travers le pré-entraînement, l’entraînement intermédiaire et le post-entraînement avec l’auto-évaluation et la correction, transformant l’entraînement en une boucle de rétroaction gouvernée plutôt qu’en un seul passage de génération de données.
La partie difficile est le contrôle : GLM-6.0 devra purifier les données synthétiques, détecter et réparer les erreurs, arrêter les itérations improductives, et empêcher son évaluateur de récompenser les raccourcis. Ces mécanismes soulèvent des questions pratiques sur la vérification indépendante, la sécurité, le coût et la gouvernance. En l’absence de fiche de modèle complète, de batterie de benchmarks, de spécification d’API, de prix ou de date de sortie publics, l’article évalue l’architecture d’entraînement et ses preuves — et non des spécifications spéculatives.
Points clés pour GLM 6.0 ?
- Les éléments publics les plus solides concernent le système de Full Self-Training, pas une fuite sur le nombre de paramètres ou un résultat de benchmark.
- L’orientation divulguée couvre des données auto-produites, des environnements d’entraînement auto-construits, et l’optimisation de l’infrastructure assistée par le modèle.
- La boucle de rétroaction visée s’étend du pré-entraînement à l’entraînement intermédiaire et au post-entraînement, plutôt que de traiter l’auto-entraînement comme une technique uniquement post-entraînement.
- La modélisation multimodale native, l’apprentissage par renforcement à long horizon, la planification, l’utilisation d’outils, la récupération et la vérification sont des axes de recherche pertinents, mais ce ne sont pas encore des spécifications publiées de GLM 6.0.
- Ox Alpha n’est pas une preuve des performances fuitées de GLM 6.0 ; Z.AI l’a identifié comme l’identité pré-release de GLM-5.3-Flash.
Que Z.AI a-t-il réellement confirmé sur GLM 6.0 ?
Les documents publics de Z.AI établissent quatre signaux concrets : le nom GLM-6.0, le Full Self-Training comme orientation centrale d’entraînement, une boucle envisagée couvrant le pré-, l’inter- et le post-entraînement, et un mécanisme d’auto-évaluation et de correction. L’entreprise indique également qu’environ 60 % du produit net est destiné à soutenir les modèles de prochaine génération, le Full Self-Training, l’entraînement et l’inférence à grande échelle, le calcul et l’infrastructure associée.
Le cadre de Full Self-Training de Z.AI
Le Full Self-Training est présenté comme l’idée organisatrice de GLM-6.0, et non comme une petite fonctionnalité de post-entraînement. Le système envisagé générerait de l’expérience d’entraînement, apprendrait des résultats, filtrerait les échantillons faibles, et répéterait le cycle sous des contrôles qualité explicites.
Auto-entraînement de GLM-6.0 du pré-, à l’inter-, puis au post-entraînement
La séquence divulguée — pré-entraînement, entraînement intermédiaire et post-entraînement — implique que l’expérience auto-générée pourrait influencer la connaissance fondationnelle, la mise en forme des capacités et l’alignement des tâches, plutôt que d’apparaître uniquement lors de l’affinage final. Z.AI n’a pas divulgué les jeux de données, les frontières entre étapes ou les ratios de mélange ; il faut donc traiter cela comme une direction confirmée plutôt qu’une recette complète.
Mécanisme d’auto-évaluation et de correction de GLM-6.0
La feuille de route relie le Full Self-Training à l’auto-évaluation, la détection d’erreurs, la correction et l’auto-épuration des données. En pratique, le modèle devra juger des trajectoires, réviser les étapes échouées, écarter les données non fiables, et décider quand une itération supplémentaire n’améliore plus les performances mesurées de façon indépendante. La conception de l’évaluateur et les règles d’arrêt ne sont pas divulguées.
Le GLM-6.0 and Full Self-Training disclosure doit être lu conjointement avec l’ public proceeds allocation de Z.AI.
Ce que nous savons vs ce que nous ignorons
Le dossier public soutient une feuille de route, mais pas une spécification finalisée. Le tableau sépare la direction confirmée des questions ouvertes afin que l’article ne transforme pas une intention divulguée en affirmation de produit non étayée.
| Claim | Evidence status | What is supported | What remains unknown |
|---|---|---|---|
| GLM-6.0 name | Publicly identified | Z.AI has named the next-generation model GLM-6.0. | Release date and final positioning. |
| Full Self-Training | Confirmed roadmap | It is a stated strategic priority. | Implementation details and scaling behavior. |
| Pre-training → Mid-training → Post-training | Confirmed direction | Self-training is intended to span the training lifecycle. | Datasets, validators, stage boundaries, and data ratios. |
| Self-evaluation and correction | Confirmed objective | The roadmap includes self-purification, error detection, and correction. | Reliability, independent verification, and stopping criteria. |
| Specifications | Not disclosed | No complete public specification. | Parameters, context window, modalities, price, and API identifier. |
| Benchmarks | Not disclosed | No official GLM-6.0 result set. | Scores, methodology, and independently reproducible results. |
Qu’est-ce que le Full Self-Training et comment cela fonctionne
Le Full Self-Training est une boucle d’apprentissage fermée dans laquelle un modèle aide à créer des tâches ou des environnements, les tente, évalue les trajectoires résultantes, corrige les étapes faibles et réinjecte l’expérience acceptée dans l’entraînement. Le changement important est de passer d’un pipeline ponctuel de données synthétiques à un processus continuellement gouverné.
- Générer : construire des problèmes, des environnements d’outillage et des voies de solution candidates.
- Agir : accomplir des tâches et conserver actions, observations et raisonnements intermédiaires sous forme de trajectoires.
- Évaluer et corriger : noter les résultats avec des validateurs, détecter les erreurs, réviser les étapes échouées et rejeter les échantillons à faible confiance.
- Entraîner et arrêter : apprendre de l’expérience acceptée, puis continuer uniquement tant que des évaluations indépendantes montrent une amélioration utile.
Étendre cette boucle au pré-entraînement, à l’entraînement intermédiaire et au post-entraînement permettrait à GLM-6.0 d’améliorer la qualité des données, la mise en forme des capacités et l’alignement des tâches à différentes étapes. L’architecture dépend toujours d’évaluateurs fiables : sans contrôles indépendants, l’auto-entraînement peut récompenser ses propres angles morts.
Comment le Full Self-Training pourrait-il changer GLM 6.0 ?
La conception divulguée doit être comprise comme une architecture système plutôt que comme un nouveau bloc Transformer unique. Elle tente de fermer la boucle autour du modèle afin que celui-ci contribue de plus en plus à générer les ressources nécessaires au cycle d’entraînement suivant.
Comment GLM 6.0 pourrait-il produire des données d’entraînement ?
La première boucle est l’auto-production de données. Au lieu de dépendre uniquement d’ensembles de données rédigés par des humains ou collectés en externe, les modèles peuvent utiliser l’auto-jeu, des vérifications basées sur des règles, des résultats d’exécution, des jugements de modèles et des contrôles humains ponctuels pour générer et filtrer de nouveaux exemples. Les exemples acceptés retournent ensuite au pré-entraînement, à l’entraînement intermédiaire et au post-entraînement.
La contrainte importante est la vérification : une génération synthétique peu coûteuse n’est utile que si le système peut identifier des exemples corrects, divers et non dégénérés. Une boucle pratique est génération par modèle → exécution de tâche → vérification par règle ou outil → filtrage → réentraînement.
Comment GLM 6.0 pourrait-il construire des environnements d’entraînement ?
La deuxième boucle est l’auto-construction d’environnements. Les agents peuvent collecter ou transformer des tâches du monde réel, tenter ces tâches, créer des validateurs et vérifier si la tâche est réellement solvable avant qu’elle ne devienne matière d’entraînement. Cela compte particulièrement pour le code et le travail d’agent, où l’état terminal, la sortie d’outils, l’état du navigateur, les résultats de tests et la récupération après échec fournissent une supervision plus solide que des réponses purement textuelles.
La cible d’évaluation passe de la plausibilité d’une réponse à la réussite d’une action, la vérifiabilité indépendante du résultat, et la capacité de l’agent à se remettre d’un échec.
Comment GLM 6.0 pourrait-il optimiser son infrastructure d’entraînement ?
La troisième boucle est l’auto-optimisation de l’infrastructure. En pratique, cela s’interprète comme de l’ingénierie système assistée par IA : un modèle de programmation performant propose des changements aux opérateurs, aux kernels, à l’ordonnancement, au cache ou au code de service, tandis que des benchmarks automatisés et une validation sous contrôle humain déterminent les changements acceptés.
Le cycle résultant est meilleur modèle → meilleures propositions systèmes → gains d’efficacité validés → plus d’expériences d’entraînement → meilleur modèle. L’examen humain et des benchmarks reproductibles restent des points de contrôle, non des options.
Que nous indique la base actuelle GLM 5.3 Flash sur GLM 6.0 ?
En l’absence de fiche publique de GLM 6.0, la comparaison la plus défendable sépare les capacités mesurées actuelles de GLM de l’orientation de la prochaine génération. Z.AI décrit GLM-5.3-Flash comme un modèle MoE total 320B, 18B actifs, entraîné sur un corpus multimodal de 30T tokens. Ce sont des spécifications de GLM-5.3-Flash, pas des spécifications de GLM 6.0.
| Comparison dimension | GLM-5.3-Flash API in CometAPI | GLM 6.0 disclosed direction |
|---|---|---|
| Release status | Available | In development; final product name not independently established by the cited filing |
| Parameters | 320B total / 18B active | Not disclosed |
| Core architecture | MoE; hybrid sparse + linear attention; mHC | Not disclosed at block level |
| Training data | 30T-token multimodal corpus | Self-produced data intended to enter a recursive loop |
| Multimodality | Native multimodal input | Unified multimodal modeling is a research direction, not a published specification |
| Training stages | Published staged training recipe | Self-training across pre-, mid-, and post-training |
| Training environments | Researcher-designed and benchmarked environments | Agents help construct and validate environments |
| Verification | Existing evaluation and training pipelines | Stronger self-judgment, execution feedback, and self-verification |
| Infrastructure | Optimized inference stack | Models assist with infrastructure optimization |
| API details | Published model ID and live API | Not disclosed |
Le texte de sortie de Z.AI rapporte environ 3,0× de calcul d’attention en moins et une taille de KV-cache 4,4× plus petite pour GLM-5.3-Flash que pour GLM-5.3 API . Le graphique officiel associé étiquette la comparaison au million de tokens à 3,40× pour le calcul d’attention et 3,80× pour le KV cache par couche. Comme les deux supports officiels utilisent des chiffres différents, ils doivent être rapportés dans leurs contextes respectifs plutôt que fusionnés en une seule mesure.
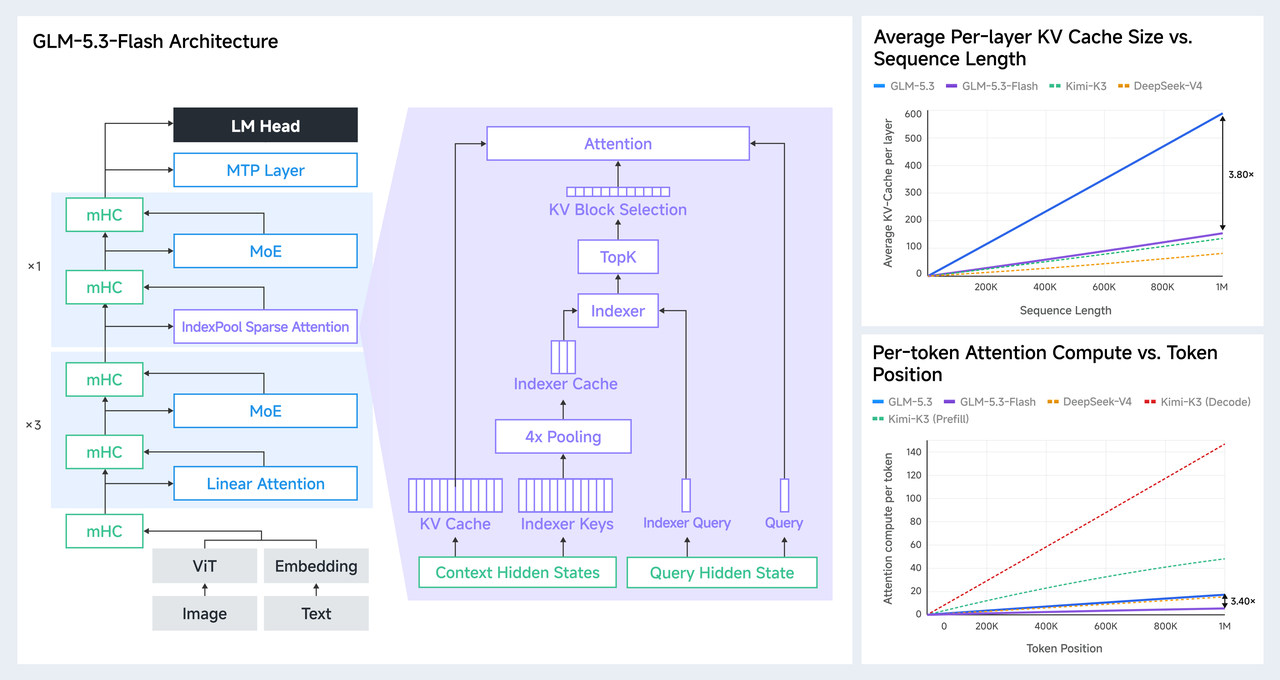
Comparaison officielle de l’architecture et de l’efficacité de GLM-5.3-Flash publiée par Z.AI
Quels résultats de benchmarks forment la base de GLM 6.0 ?
Aucun tableau de benchmarks vérifié de GLM 6.0 n’est public. La génération actuelle de GLM ne sert que de base car les évaluations ci-dessous mesurent la planification, le code, l’utilisation d’outils, l’automatisation et l’exécution à long horizon — les capacités les plus pertinentes pour l’orientation de Full Self-Training divulguée.
| Official Z.AI evaluation | GLM-5.3-Flash | GLM-5.2 | Reported difference |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
La comparaison est multidimensionnelle plutôt qu’un classement à score unique. GLM-5.3-Flash montre ses gains déclarés les plus importants sur AutomationBench (+22,6), Toolathlon Verified (+18,5) et DeepSWE (+17,2), tandis que la différence sur HLE-with-Tools n’est que de +0,6. Ce schéma suggère des gains plus forts sur des tâches d’agent fortement orientées exécution que sur toute forme de raisonnement assisté par outils. Cela ne prédit pas les scores de GLM 6.0.
Pourquoi ces benchmarks comptent
Les benchmarks ne comptent ici que s’ils révèlent les capacités que le Full Self-Training est censé améliorer. Les six catégories du tableau intégré forment une progression allant de la production d’un travail correct au maintien d’un comportement efficace dans des environnements réels. Le codage teste si le modèle peut exécuter une tâche complexe ; l’utilisation d’outils teste s’il peut transformer une action en retour d’information et choisir l’étape suivante ; et l’automatisation teste s’il peut préserver cette boucle sur un long flux de travail.
| Benchmark Category | Pourquoi cela compte pour GLM-6.0 |
|---|---|
| Coding | Teste l’exécution de tâches complexes |
| Tool Use | Teste la boucle action→retour d’information |
| Automation | Teste l’exécution de flux de travail à long horizon |
| HLE | Teste la résolution de problèmes de niveau expert complexes |
| GDPval | Teste la qualité du travail professionnel |
| Multimodal | Teste l’utilisation du retour visuel |
HLE augmente ensuite la difficulté des problèmes à résoudre, GDPval demande si la sortie est utile dans le travail professionnel, et l’évaluation multimodale teste si des observations visuelles peuvent guider les actions suivantes. Ensemble, les six catégories vont de la compétence isolée à l’achèvement de tâches de bout en bout : générer un plan, agir, observer le retour, corriger les erreurs et poursuivre jusqu’à l’objectif.
Un futur résultat GLM-6.0 serait donc significatif non pas parce qu’il produit un score agrégé plus élevé, mais parce que des gains sur ces dimensions montreraient que l’expérience d’entraînement auto-générée se transfère en une exécution fiable dans le monde réel. Le but ultime du Full Self-Training n’est pas d’améliorer les scores de test, mais d’améliorer la capacité du modèle à mener à bien des tâches réelles.
Pourquoi le Full Self-Training pourrait-il compter pour GLM 6.0 ?
La véritable promesse n’est pas que GLM 6.0 va simplement « s’entraîner tout seul ». Le changement le plus significatif est que des parties plus larges du pipeline de développement pourraient devenir générées et vérifiées par la machine. Aujourd’hui, les chercheurs effectuent encore une grande partie du travail autour du modèle : collecte de données, conception de tâches, construction d’évaluateurs, création d’environnements, diagnostic des défaillances et réglage des logiciels système. Le Full Self-Training pousse le modèle dans davantage de ces étapes.
Si l’approche fonctionne, la variable d’échelle importante devient moins le nombre de paramètres ajoutés que le nombre de cycles d’apprentissage utiles et vérifiés pouvant être exécutés par unité de calcul. C’est une interprétation pratique de l’auto-amélioration récursive plutôt que la version de science-fiction d’une auto-modification autonome illimitée.
La stratégie divulguée doit être évaluée comme un système de rétroaction ingénieré avec des validateurs, des environnements reproductibles, des benchmarks d’infrastructure et des contrôles humains — et non comme une preuve d’auto-amélioration autonome illimitée.
Que pourrait-il mal tourner avec le Full Self-Training ?
Une boucle d’auto-entraînement peut amplifier les erreurs aussi efficacement qu’elle compose l’expérience utile. Quatre modes de défaillance méritent une attention particulière :
- Amplification d’erreurs : des trajectoires synthétiques faibles peuvent devenir de futures données d’entraînement, permettant à des schémas plausibles mais incorrects de se renforcer.
- Jeu de la récompense et de l’évaluateur : si le même système produit le travail et le juge, il peut optimiser pour les failles du vérificateur au lieu de la réussite réelle de la tâche.
- Rétrécissement de distribution : apprendre à répétition sur des données générées par le modèle peut réduire la diversité et rendre les cas réels peu fréquents plus difficiles à traiter.
- Pression sur le coût, la sécurité et la gouvernance : la construction d’environnements, l’accès aux outils et l’itération persistante augmentent la demande de calcul et élargissent la surface d’attaque.
Une implémentation crédible de GLM-6.0 a donc besoin de validateurs indépendants, de provenance des données, de seuils d’acceptation, de tests de red teaming, d’audits humains et de règles d’arrêt explicites. L’auto-correction n’est utile que lorsque le signal de correction est plus fiable que le comportement corrigé.
Quand l’API GLM 6.0 pourrait-elle être disponible ?
Z.AI n’a pas publié de date de sortie d’API GLM 6.0, d’identifiant de modèle, de fenêtre de contexte, de sortie maximale, de prix par token, d’engagement d’ouverture des poids, ni d’exigences de déploiement. Toute valeur spécifique serait actuellement spéculative.
Les développeurs peuvent évaluer l’orientation actuelle via GLM-5.3-Flash API in CometAPI pour des charges multimodales natives et orientées efficacité, GLM-5.3 API in CometAPI pour la branche phare actuelle, ou GLM-5.2 API in CometAPI comme référence de comparaison de la génération précédente.
Conclusion
GLM-6.0 importe moins comme produit promis que comme test de la capacité de Z.AI à transformer le Full Self-Training en un système d’ingénierie reproductible. La feuille de route relie l’expérience auto-générée, l’entraînement par étapes, l’auto-évaluation, la correction et l’itération contrôlée ; la preuve décisive sera de savoir si ces mécanismes améliorent la fiabilité sur des flux de travail réels, longs et utilisant des outils.
Cette preuve est encore incomplète. Z.AI n’a pas publié de fiche de modèle GLM-6.0, de date de sortie, d’identifiant d’API, de tarification ou de batterie de benchmarks. Jusqu’à l’existence de ces éléments, la conclusion défendable est étroite : l’entreprise a divulgué une orientation d’entraînement, pas un profil de capacités finalisé.
Le but ultime du Full Self-Training n’est pas d’améliorer les scores de test, mais d’améliorer la capacité du modèle à mener à bien des tâches réelles.