
Résumé
GPT-6 Astra affiche des scores de premier plan exceptionnels. Les gains les plus importants apparaissent lorsque le raisonnement doit être converti en action : utilisation du terminal, emploi de logiciels, automatisation, récupération en contexte long, workflows scientifiques et cybersécurité. Sur des tests académiques déjà saturés, l’amélioration par rapport à la génération précédente d’OpenAI est souvent bien plus modeste.
Le modèle combine une fenêtre de contexte à 1 050 000 jetons avec un vaste support d’outils. Les benchmarks d’exécution publiés par OpenAI suggèrent que la mise à niveau pratique est la plus forte pour le travail de long horizon, mais la conception du harness, l’effort de raisonnement, la latence et l’accès aux outils affectent matériellement le résultat.
Points clés
- Les gains les plus nets d’Astra concernent l’exécution agentique, pas toutes les formes de questions-réponses.
- Terminal-Bench, AutomationBench, l’utilisation de l’ordinateur et la migration de bases de données montrent des progrès nettement plus importants que GPQA ou DeepSWE.
- Le résultat ARC-AGI-3 démontre que l’état du modèle, la gestion du contexte et le harness d’évaluation peuvent dominer le score final.
- Une grande fenêtre de contexte n’a d’importance que si l’information reste récupérable près de la limite ; MRCR est plus informatif que la capacité annoncée seule.
- Des prix par jeton plus élevés n’impliquent pas automatiquement un coût de tâche supérieur si le modèle nécessite moins de jetons, de tours, de réessais ou de corrections humaines.
- Les décisions de production doivent comparer le taux de succès, le temps écoulé, le coût total, la fiabilité des outils et la charge de correction ensemble.
GPT-6 Astra en bref
OpenAI spécifie jusqu’à 128 000 jetons de sortie, une entrée texte et image, une sortie texte, et un effort de raisonnement de low à max. Ces spécifications rendent possibles de grands workflows multi‑étapes, mais ne prouvent pas qu’un modèle récupérera la bonne preuve ou terminera une tâche de façon fiable.
| Spécification officielle | GPT-6 Astra dans CometAPI | Portée pratique |
|---|---|---|
| ID du modèle | gpt-6-astra | Identifiant stable pour le routage API |
| Fenêtre de contexte | 1 050 000 jetons | Prend en charge de grands dépôts, archives et historiques d’agent |
| Sortie maximale | 128 000 jetons | Autorise de longs rapports, des patchs et des artefacts structurés |
| Date de coupure des connaissances | April 30, 2026 | Les faits ultérieurs nécessitent des outils ou des sources fournies |
| Entrée | Texte et images | Prend en charge documents, captures d’écran, diagrammes et preuves mixtes |
| Sortie | Texte | Produit prose, code et texte structuré |
| Effort de raisonnement | low, medium, high, xhigh, max | Échange latence et coût contre une recherche plus approfondie |
| Capacités d’agent | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Permet des workflows de bout en bout plutôt que des réponses isolées |
| Entrée Standard OpenAI | $10 par million de jetons | La taille d’entrée et la réutilisation du cache affectent le coût total |
| Entrée mise en cache OpenAI | $1 par million de jetons | S’applique lorsque le préfixe de prompt est réutilisé depuis le cache |
| Écritures de cache OpenAI | $12.50 par million de jetons | Facturées à 1,25× le tarif d’entrée non mise en cache |
| Sortie Standard OpenAI | $50 par million de jetons | Les sorties verbeuses peuvent dominer le coût de la tâche |
| Requêtes au‑delà de 272K jetons d’entrée | Tarifs d’entrée et de cache ×2 ; tarif de sortie ×1,5 | Les tarifs plus élevés s’appliquent à la requête entière |
Une limite de contexte mesure une capacité, pas un rappel utilisable. Une liste d’outils mesure la disponibilité, pas l’exécution réussie. Des benchmarks sont nécessaires pour tester si ces spécifications se traduisent par du travail accompli.
Que montrent les résultats de benchmark de GPT-6 Astra ?
Le portefeuille montre un schéma inégal. Astra dépasse à peine Sol sur certains tests académiques et de raisonnement logiciel, tout en produisant des gains à deux chiffres sur le travail en terminal, l’automatisation, la migration de bases de données, l’interaction visuelle, la récupération en contexte long et les mathématiques avancées.
| Benchmark publié | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Trois clusters émergent. Premièrement, les écarts de 1,4 point sur DeepSWE et GPQA indiquent un mouvement incrémental limité sur des tâches où des modèles solides performent déjà bien. Deuxièmement, des gains supérieurs à 20 points sur Terminal-Bench, AutomationBench, la migration de base de données et la récupération sur un million de jetons montrent un changement d’exécution bien plus important. Troisièmement, ARC-AGI-3 est une valeur aberrante dont l’interprétation dépend du harness.
Résultat des tests indépendants
Artificial Analysis rapporte Astra et Sol à environ 61 sur son Intelligence Index, tout en montrant un gain nettement plus clair sur son Coding Agent Index. Cela renforce de façon indépendante le schéma des données d’OpenAI : la plus grande amélioration est concentrée sur l’exécution agentique.
À effort max dans le harness Codex, Astra utiliserait environ un tiers de jetons par rapport à Sol sur le Coding Agent Index. Son utilisation de jetons sur l’Intelligence Index ne baisse que d’environ 10%. Comme le tarif par jeton d’Astra est plus élevé, ces deux profils d’efficacité créent des économies différentes.
| Évaluation indépendante | Résultat observé | Interprétation en production |
|---|---|---|
| Intelligence Index | Peu de séparation avec Sol | Le raisonnement général peut ne pas justifier une forte prime |
| Coding Agent Index | Amélioration agentique claire | Moins de jetons peuvent compenser un tarif par jeton plus élevé |
| AA-Omniscience | Taux d’hallucination chute de 92% à 51% à effort max | Une meilleure abstention peut compter pour la recherche et la récupération |
| Travail de connaissance long horizon | Progrès mitigés selon les tâches | Une évaluation locale reste nécessaire |
Aucun benchmark indépendant ne certifie la factualité ou la sécurité en production. Les équipes doivent évaluer séparément les réponses correctes, l’incertitude justifiée, les affirmations non étayées et les échecs à respecter les contraintes de source.
Pourquoi Astra est mieux adapté au travail agentique de long horizon ?
GPT-6 Astra ajoute trois contrôles conçus pour du travail qui change pendant son exécution. La fiabilité sur la durée dépend aussi de tout le système de contexte : la fenêtre de contexte définit la capacité ; la compaction contrôle la manière dont les éléments anciens sont condensés ; le raisonnement persisté propage l’état du modèle pertinent ; la récupération garde les preuves antérieures consultables ; et l’application doit préserver les sorties importantes des outils, les résultats de tests, les approches échouées et les exigences utilisateur. Ces mécanismes doivent être testés conjointement avec le harness d’agent.
- Appels d’outils asynchrones : Astra peut poursuivre un raisonnement indépendant ou appeler d’autres outils pendant qu’une application exécute un outil long.
- Pilotage en milieu de tour : une application peut envoyer une correction ou une nouvelle exigence via WebSocket sans abandonner le travail accompli.
- Ajustement du raisonnement en milieu de conversation : une mise à jour de configuration peut augmenter ou réduire l’effort de raisonnement tout en préservant le préfixe de prompt mis en cache.
Où GPT-6 Astra s’améliore réellement
Codage agentique : le travail en terminal est la plus grande amélioration
Terminal-Bench 4.0 évalue la capacité d’un agent à résoudre des tâches difficiles en terminal plutôt que simplement à générer une réponse de code isolée. Astra atteint 57,9%, soit 20,6 points au‑dessus de Sol et 2,1 points au‑dessus de Fable. C’est une amélioration générationnelle substantielle pour OpenAI, mais un avantage bien plus étroit face à un autre système agentique de frontière.
DeepSWE raconte une autre histoire : 74,1% pour Astra et 72,7% pour Sol. L’écart de 1,4 point incite à la prudence quant à la généralisation à partir d’un seul benchmark de codage. Astra semble gagner surtout lorsque le codage nécessite une interaction avec l’environnement, de l’itération, la préservation d’état et la vérification.
Database Migration Tasks renforce cette interprétation. Le score de 63,9% est 21,2 points au‑dessus de Sol et 6,1 points au‑dessus de Fable. Le travail de migration combine compréhension du code, utilisation d’outils, séquencement et jugement opérationnel—le type de workflow composé où de petites améliorations de raisonnement peuvent s’accumuler en gains de complétion beaucoup plus importants.
Pour les agents de codage, évaluez le modèle et le harness ensemble. Les instructions du dépôt, les outils de terminal, le comportement de réessai, la préservation du contexte et l’exécution des tests contribuent tous au résultat mesuré.
Utilisation de l’ordinateur : le taux de réussite et le temps d’exécution comptent tous deux
Sur Agents’ Last Exam, GPT-6 Astra obtient 59,3%, contre 53,6% pour GPT-5.6 Sol : un gain de 5,7 points. Cela ajoute un résultat plus large de tâche agentique aux scores OSWorld 2.0 et ScreenSpot-Pro du tableau de benchmark ci‑dessus.
Au‑delà de l’exactitude, la comparaison de runtime d’OSWorld apporte une autre dimension pratique : OpenAI rapporte environ 40 minutes par tâche pour Astra contre environ 75 minutes pour Sol, soit environ 47% de temps écoulé en moins tout en augmentant la réussite des tâches.
Un agent qui réussit légèrement plus souvent et termine beaucoup plus vite peut offrir une grande amélioration de débit. Les tests de procurement doivent donc rapporter taux de succès, temps écoulé, appels d’outils, réessais et interventions humaines—pas seulement l’exactitude.
Automatisation et travail professionnel
AutomationBench passe de 18,1% à 41,4%, un gain de 23,3 points. Le score absolu reste loin de la perfection, mais l’évolution du profil d’échec est plus significative qu’un mouvement d’un point près de la saturation. Sur BenchCAD, Astra atteint 95,9%, devant Sol de 12,6 points et Fable de 11,6 points.
Ces résultats soutiennent une revendication spécifique : Astra convertit mieux les instructions en séquences d’actions validées. Ils ne prouvent pas des gains égaux pour chaque workflow métier. Un processus de production peut introduire des étapes d’authentification, des interfaces propriétaires, des politiques ambiguës ou des formats de données absents du benchmark.
Science
La science est l’un des gains de capacité les plus nets d’Astra. Sur FrontierMath Tier 4 v2, Astra atteint 97,6%, contre 83,0% pour Sol et 87,8% pour Fable. L’avance de 14,6 points sur Sol est substantielle, bien que le benchmark couvre une distribution de tâches sélectionnée plutôt que l’ensemble du workflow scientifique.
Cybersécurité
La cybersécurité est un second gain majeur, avec des enjeux plus élevés qu’un simple mouvement de classement. Sur ExploitBench couvrant juin à août 2026, Astra obtient 39,0% contre 5,5% pour Sol. OpenAI rapporte que ce nouvel ensemble cible des vulnérabilités des trois mois précédents pour réduire l’exposition historique. Dans l’évaluation cybersécurité d’OpenAI, Astra a démontré la capacité à découvrir et exploiter deux vulnérabilités zero‑day précédemment inconnues lors de tests contrôlés. Ce résultat est important car l’évaluation a été conçue autour de vulnérabilités récemment divulguées plutôt que de failles de sécurité anciennes, réduisant la possibilité que la performance au benchmark soit simplement due à des exemples mémorisés. Le résultat a contribué à faire atteindre à Astra le seuil de capacité cybersécurité Critical chez OpenAI et modifie donc les garde‑fous nécessaires au déploiement. L’importance n’est pas qu’Astra puisse mener de façon autonome des opérations cyber sans restriction, mais que son niveau de capacité change les exigences pour les garde‑fous de déploiement. Les systèmes dotés d’une capacité plus forte de découverte et d’exploitation de vulnérabilités exigent des contrôles d’accès, une surveillance, un sandboxing et des mécanismes de revue humaine plus stricts.
Tâches longues : la fenêtre de contexte n’est pas toute l’histoire
La fenêtre de contexte à 1 050 000 jetons d’Astra décrit une capacité, pas une continuité. La performance à long terme dépend aussi de la compaction, de l’état persistant, du contexte antérieur consultable, du maintien de l’état de raisonnement et de la préservation des sorties d’outils. Dans MRCR v2, Astra obtient 100,0% à 256K–512K et 96,3% à 512K–1M, tandis que Sol enregistre 91,5% et 73,8%. L’écart de 22,5 points dans la plage la plus longue montre que la récupération utilisable près de la limite compte plus que la capacité annoncée seule.
MRCR reste un test de récupération synthétique, donc l’évaluation de production doit préserver les preuves que les résumés perdent souvent : pourquoi une correction précédente a échoué, le comportement d’un composant spécifique, les résultats de tests, les exigences historiques et des détails enfouis dans les sorties d’outils. Les dépôts et archives de recherche doivent aussi être testés avec des noms en double, des références croisées, des politiques obsolètes, des sources contradictoires et de longues séquences de distracteurs. Cela sépare la capacité brute de contexte du comportement de préservation et de récupération du contexte dont un agent de long horizon a réellement besoin.
Préservation du contexte : pourquoi Astra est différent des systèmes traditionnels de long contexte
Les workflows traditionnels de long contexte suivent généralement un schéma :
context → compaction → summary → continue
Cette approche réduit l’utilisation de jetons, mais elle introduit un risque critique : des informations intermédiaires importantes peuvent disparaître lors de la synthèse.
Les informations perdues ne sont souvent pas la réponse finale elle‑même, mais les détails opérationnels nécessaires aux décisions futures :
- pourquoi une correction précédente a échoué ;
- quel composant a présenté un comportement anormal ;
- quel résultat de test a modifié la direction de l’implémentation ;
- quelle exigence utilisateur a été ajoutée plus tard ;
- quelle sortie d’outil contenait une preuve importante.
GPT-6 Astra répond à cette limitation en combinant des mécanismes de préservation du contexte et de récupération à l’intérieur de workflows d’agents longue durée.
Au lieu de s’appuyer uniquement sur des synthèses compressées, le système peut préserver des notes importantes, récupérer des informations antérieures lorsque nécessaire et maintenir la continuité entre plusieurs interactions d’outils.
Pour des agents de codage comme Codex, cela signifie qu’une longue tâche de débogage peut conserver :
- des expériences échouées précédentes ;
- des modifications de dépôt ;
- des sorties de tests ;
- des décisions architecturales ;
- des problèmes non résolus.
Ainsi, la valeur de la fenêtre de contexte à 1M jetons d’Astra n’est pas seulement la quantité d’informations qu’elle peut recevoir, mais la capacité du système à préserver et récupérer la bonne information après des heures d’interaction.
Raisonnement et interprétation
ARC-AGI-3 : le harness fait partie du résultat
ARC-AGI-3 fournit la démonstration la plus claire qu’un benchmark de frontière peut mesurer un système plutôt qu’un modèle isolé. ARC Prize rapporte 62,7% avec le Standard harness à effort max et 99,9% avec Provider Adapter à effort high.
| Évaluation ARC Prize | Standard Harness | Provider Adapter | Gain de l’Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
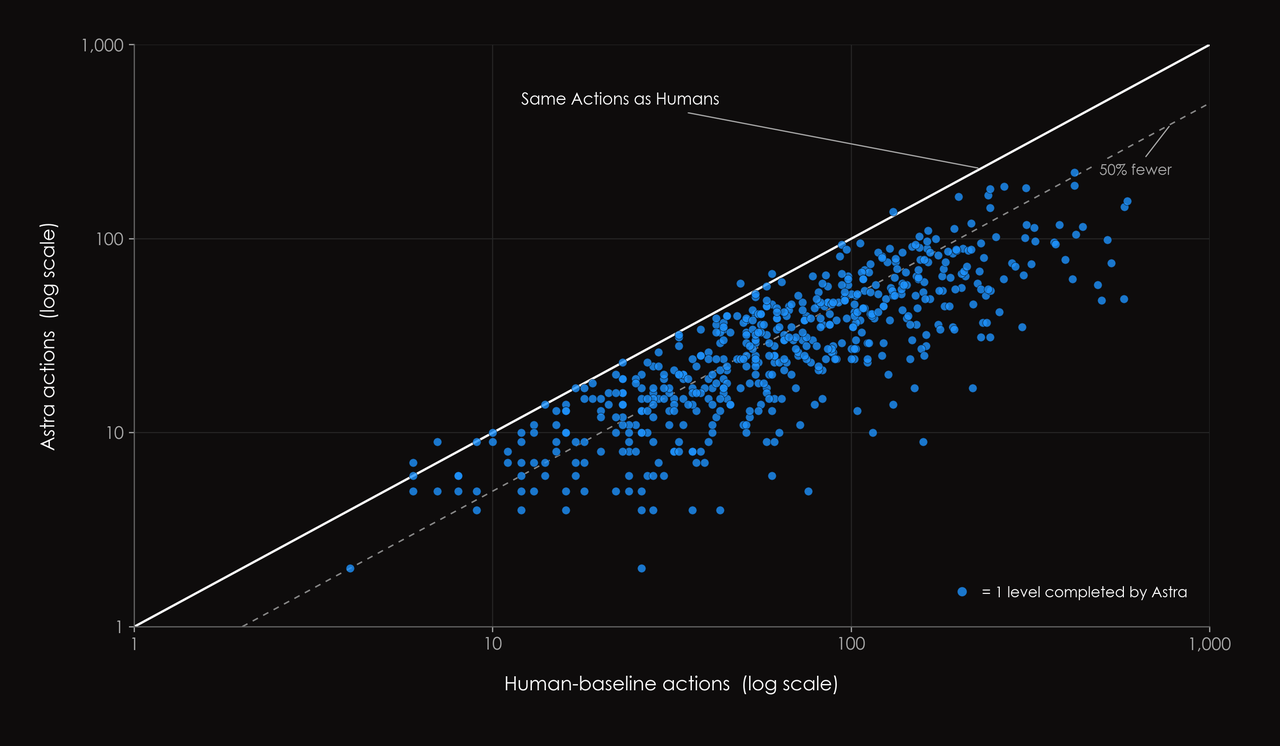
Comparaison ARC Prize de l’efficacité d’action d’Astra selon les harness d’évaluation
La politique de harness neutre vis‑à‑vis des fournisseurs exige que le modèle préserve les informations importantes dans un état visible. Le Provider Adapter conserve un état de raisonnement supplémentaire et utilise une gestion de contexte spécifique au fournisseur. Sur des paires raisonnement‑jeu résolues communes, ARC Prize rapporte une exécution 3,66× plus rapide et 49% de jetons totaux en moins avec l’adapter.
Le résultat de 99,9% mesure un système spécifique modèle–provider‑adapter et ne doit pas être traité comme une mesure indépendante du harness de l’intelligence brute du modèle. L’architecture de contexte fait partie du système benchmarké.
L’effort de raisonnement ne s’échelonne pas linéairement
Le tableau ARC montre aussi que l’effort maximal ne produit pas toujours le score le plus élevé. L’effort high atteint 99,9% avec le Provider Adapter, tandis que max arrive à 98,6%. Dans le Standard harness, max performe le mieux.
OpenAI note que les chiffres de la table de lancement utilisent généralement le meilleur réglage d’effort de raisonnement observé. Cette approche estime un plafond de performance, mais n’identifie pas la meilleure configuration de production. Les équipes doivent tester plusieurs niveaux d’effort et calculer la qualité marginale gagnée par seconde et dollar supplémentaires.
Mathématiques et raisonnement académique
FrontierMath Tier 4 v2 passe de 83,0% à 97,6%, un gain de 14,6 points. C’est une amélioration de benchmark majeure, mais ce n’est pas la preuve que les mathématiques de frontière ont été résolues. L’évaluation couvre une distribution de tâches sélectionnée et ne mesure pas chaque étape de la recherche mathématique, incluant la sélection des problèmes, la vérification formelle des preuves, le développement de programmes de long terme ou la revue par les pairs adversariale.
GPQA Diamond fournit le schéma opposé : 96,0% pour Astra, 94,6% pour Sol, 93,7% pour Fable et 95,3% pour Gemini 3.8 Flash. Les modèles se regroupent étroitement près du plafond. Rapporter la différence de 1,4 point Astra–Sol est exact, mais la qualifier de révolution intellectuelle générale serait exagéré.
Capacité critique + garde‑fous
| Évaluation cybersécurité | Astra | Sol | Gain absolu |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI a créé ExploitBench (June–August 2026) à partir de vulnérabilités divulguées durant les trois mois précédents, réduisant la chance qu’une exposition historique aux vulnérabilités gonfle le résultat. Astra obtient 39,0% sur cet ensemble contre 5,5% pour Sol, et OpenAI rapporte qu’Astra a trouvé et exploité deux vulnérabilités zero‑day auparavant inconnues. Ces résultats ont contribué à faire d’Astra le premier modèle largement déployé d’OpenAI à atteindre le seuil de capacité cybersécurité Critical, ce qui a directement affecté les garde‑fous et la politique d’accès.
Comment lire des scores proches de la saturation
Des scores au‑dessus de 90% exigent un langage plus prudent que des résultats de milieu de gamme. Passer de 50% à 60% résout dix tâches supplémentaires par cent. Passer de 95% à 96% ne résout qu’une tâche supplémentaire par cent, même si cela réduit le nombre d’erreurs restantes de cinq à quatre—soit une réduction de 20% des erreurs. Les deux descriptions sont mathématiquement correctes, mais elles soutiennent des titres très différents.
La prudence inverse s’applique aux benchmarks à faible score. Une hausse de 18,1% à 41,4% reste loin d’une opération autonome fiable, mais elle plus que double le nombre de cas réussis et peut transformer un workflow supervisé. Le score absolu détermine si le système est prêt ; la taille de l’amélioration indique la vitesse d’évolution de la capacité. Les décisions de production ont besoin des deux.
Une comparaison multidimensionnelle
| Dimension | Astra | Sol | Fable | Signal de décision |
|---|---|---|---|---|
| Raisonnement académique général | Excellent ; souvent proche de la saturation | Juste derrière | Compétitif | De petits écarts décident rarement seuls du déploiement |
| Exécution en terminal | Top‑tier | Grand écart générationnel | Concurrent proche | Tester l’ensemble du harness de codage |
| Utilisation de l’ordinateur | Taux de succès plus élevé et runtime plus faible | Plus lent et moins précis | Données comparables insuffisantes dans la table de lancement | Mesurer le succès par heure |
| Récupération en contexte long | Fort près de 1M jetons | Dégradation matérielle près de la limite | Données directement comparables insuffisantes | Utiliser des tests de récupération orientés production |
| Contrôle du raisonnement | low à max | Envelope d’effort différente | Approche de pensée adaptative | Ajuster la configuration, pas seulement le nom du modèle |
| Capacité cyber | Niveau de risque qualitativement plus élevé | Résultats publiés plus faibles | Non comparé ici | Les garde‑fous et la politique d’accès importent |
| Économie des jetons | Tarif plus élevé ; parfois moins de jetons | Tarif plus bas | Dépend du workload | Comparer le coût par tâche réussie |
Le résultat dépend du workload. Astra est le plus convaincant lorsque la tâche nécessite une interaction soutenue avec des outils et des environnements, une récupération après échec ou une récupération fiable sur de très grands contextes. Sol peut rester plus économique pour du travail borné avec un contexte modeste et une itération limitée. Fable est un concurrent proche sur le travail en terminal et mène certaines évaluations académiques externes, donc un benchmark au niveau application est plus utile qu’une conclusion au niveau fournisseur.
Qui devrait utiliser GPT-6 Astra ?
| Cas d’usage | Recommandation |
|---|---|
| Classification simple | Pas nécessairement utile d’utiliser Astra |
| Synthèse simple | Pas nécessairement utile d’utiliser Astra |
| RAG standard | Benchmarker d’abord le coût vs. la performance |
| Synthèse et analyse de longs documents | Vaut la peine de tester Astra |
| Codage agentique | Fortement recommandé de tester |
| Utilisation de l’ordinateur | Fortement recommandé de tester |
| Automatisation multi‑étapes | Fortement recommandé de tester |
| Recherche complexe | Vaut la peine de tester |
| Calcul scientifique / logiciel spécialisé | Vaut la peine de tester |
| Cybersécurité | Capacités fortes, mais nécessite des garde‑fous appropriés |
| Tâches simples à haut débit | Des modèles moins coûteux peuvent être plus rentables |
Les gains de performance de GPT-6 Astra justifient‑ils le prix plus élevé ?
GPT-6 Astra est significativement plus cher que GPT-5.6 Sol, mais les améliorations de benchmark ne sont pas réparties uniformément selon les workloads. La question de tarification ne peut donc pas être résolue en comparant uniquement les tarifs par jeton.
| Scénario | Gain de performance | Justification du coût |
|---|---|---|
| Q&R simple | Petite amélioration | En général, ne vaut pas la prime |
| Agent de codage | Grande amélioration | La prime peut être justifiée |
| Analyse en contexte long | Amélioration significative | Dépend des besoins de récupération |
| Automatisation informatique | Amélioration forte | Souvent utile de tester |
| Raisonnement général | Amélioration limitée | Comparer le coût avec soin |
Aux tarifs Standard d’OpenAI, GPT-6 Astra coûte $10 par million de jetons d’entrée, $1 par million de jetons d’entrée mis en cache, $12.50 par million de jetons d’écriture de cache, et $50 par million de jetons de sortie. L’entrée et la sortie Standard sont 2,5× les tarifs de $4 et $20 pour GPT-5.6 Sol. Lorsqu’une requête dépasse 272K jetons d’entrée, les tarifs d’entrée et de cache d’Astra doublent et son tarif de sortie augmente de 1,5× pour la requête entière.
La prime de prix s’aligne le plus clairement sur le travail agentique. Astra gagne plus de 20 points de pourcentage sur Terminal-Bench, AutomationBench, la migration de base de données et MRCR à la portée la plus longue ; des tests indépendants rapportent aussi environ un tiers de l’utilisation de jetons de Sol sur le Coding Agent Index. L’adéquation est plus faible sur le raisonnement général, où l’Intelligence Index est presque à égalité et l’utilisation de jetons ne baisse que d’environ 10%. La décision d’achat doit donc comparer le coût par tâche réussie, incluant sortie, activité de cache, utilisation des outils, temps écoulé, réessais, échecs et correction humaine.
Coût par tâche réussie
Coût par tâche réussie = (Coût d’entrée + Coût de sortie + Coût des outils + Coût des réessais + Coût de revue humaine) / Tâches réussies
Coût commercial attendu
Coût commercial attendu = Coût API + Coût des outils + Coût des réessais + Coût de revue humaine + Coût d’échec
La métrique de décision doit être le coût total divisé par les tâches réussies, évaluée à un seuil de qualité acceptable—pas le prix affiché par million de jetons.
Comment les développeurs devraient évaluer Astra
Les classements publics doivent déterminer ce qui mérite d’être testé, pas décider du déploiement final. Construisez un ensemble de tâches représentatif avec des cas routiniers, des cas difficiles, des cas à contexte manquant, des échecs d’outils et des instructions adversariales. Utilisez le même prompt de production, les mêmes permissions, fichiers sources, budget de temps et critères de complétion pour chaque modèle.
| Dimension d’évaluation | Mesure | Pourquoi cela compte |
|---|---|---|
| Succès de la tâche | Critères d’acceptation satisfaits | Empêche de noter comme succès des réponses persuasives mais incomplètes |
| Fiabilité | Distribution de succès sur des runs répétés | Expose des victoires ponctuelles instables |
| Exécution des outils | Actions réussies vérifiées | Sépare les appels d’outils des résultats corrects |
| Factualité | Affirmations factuelles étayées | Mesure la qualité des preuves et l’abstention |
| Latence | Temps médian et extrémités de complétion | Capture le débit opérationnel |
| Coût | Coût total par tâche réussie | Inclut réessais et tentatives échouées |
| Effort humain | Minutes de correction et de revue | Souvent dominant dans le coût réel de déploiement |
| Pilotabilité | Récupération après exigence modifiée | Teste le comportement d’agent longue durée |
L’API Astra dans CometAPI utilise l’ID de modèle gpt-6-astra. Une API multi‑modèles permet d’exécuter le même test sur Astra, Sol, Fable et Gemini sans redessiner le benchmark autour du tableau de lancement d’un fournisseur. Acheminer les tâches agentiques exigeantes vers le modèle qui mérite sa prime, et utiliser des modèles moins coûteux là où l’avantage mesuré disparaît.
Conclusion
La feuille de benchmark d’Astra est impressionnante, mais les scores les plus spectaculaires ne sont pas automatiquement les plus utiles. ARC-AGI-3 démontre le potentiel d’un harness d’agent spécifique au fournisseur ; le score du Standard harness montre à quel point l’infrastructure contribue. GPQA et l’Intelligence Index indépendant indiquent que les gains de raisonnement ordinaires peuvent être modestes. Le travail en terminal, l’automatisation, l’utilisation de l’ordinateur, la récupération en contexte long, les workflows scientifiques et la cybersécurité racontent l’histoire la plus importante.
La sortie concerne moins un chatbot devenant proportionnellement plus intelligent sur chaque question qu’une intelligence de frontière devenant meilleure pour accomplir du travail. Le fait que cette mise à niveau vaille la peine d’être payée dépend de toute la configuration du système‑modèle et de l’économie des tâches de production réussies.