Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT-5.3-Codex-Spark とは何ですか?どのように使いますか?
technology / CometAPIリサーチ
GPT-5.3-Codex-Spark とは何ですか?どのように使いますか? 2026年2月、OpenAI は GPT-5.3-Codex-Spark を発表した。これは、リアルタイムコーディングに明確に最適化された Codex ファミリーの研究プレビュー版である。Codex-Spark は、極めて低いレイテンシと非常に高いトークンスループットのためにモデルサイズをトレードオフとしており—Cerebras との提携により提供される低レイテンシのハードウェアパス上で提供される場合、同モデルは >1,000 トークン/秒の生成速度と 128k トークンのコンテキストウィンドウを実現すると OpenAI は報告している。このリリースはインタラクティブな開発者ワークフローを対象としている: ライブコーディング、即時編集、IDE 内の密な編集–コンパイル–実行ループ、そして応答性が重要となるエージェント駆動のコーディングワークフロー。
2026年2月、OpenAI は GPT-5.3-Codex-Spark を発表した。これは、リアルタイムコーディングに明確に最適化された Codex ファミリーの研究プレビュー版である。Codex-Spark は、極めて低いレイテンシと非常に高いトークンスループットのためにモデルサイズをトレードオフとしており—Cerebras との提携により提供される低レイテンシのハードウェアパス上で提供される場合、同モデルは >1,000 トークン/秒の生成速度と 128k トークンのコンテキストウィンドウを実現すると OpenAI は報告している。このリリースはインタラクティブな開発者ワークフローを対象としている: ライブコーディング、即時編集、IDE 内の密な編集–コンパイル–実行ループ、そして応答性が重要となるエージェント駆動のコーディングワークフロー。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)2026年2月、OpenAIはGPT-5.3-Codex-Spark を発表しました。これはCodexファミリーの研究プレビュー版で、リアルタイムコーディング に明確に最適化されています。Codex-Sparkはモデルサイズをトレードオフして極めて低いレイテンシと非常に高いトークンスループットを実現しており—OpenAIは、Cerebrasとの提携により提供される低レイテンシのハードウェア経路で提供された場合に、生成が1,000トークン/秒超 、モデルのコンテキストウィンドウが128kトークン であると報告しています。このリリースはインタラクティブな開発者ワークフローをターゲットにしており、ライブコーディング、即時の編集、IDE内でのタイトな編集–コンパイル–実行ループ、そして応答性が鍵となるエージェント型のコーディングワークフローを想定しています。
GPT-5.3-Codex-Spark とは?
GPT-5.3-Codex-Sparkは、
明確性、出典の帰属、最新のAPI用語について確認済みです。
インタラクティブなソフトウェア開発
特化型・低レイテンシ
ほぼ即応
研究プレビュー
超高速生成: 低レイテンシ提供層において、Cerebras Wafer Scale Engine 3 (WSE-3) ハードウェア上で>1,000トークン/秒。大きなコンテキストウィンドウ: 128,000トークン(128k)—長大なコードベース、完全な依存関係ツリー、大きな履歴を1リクエストで取り込めます。テキストのみ(当初): ローンチ時のCodex-Sparkはテキスト入力のみ(マルチモーダル入力なし)。研究プレビューと独立したレート制限: プレビュー期間中のアクセスは特別なレート制限下で管理され、Spark経路での使用は標準モデルのレート制限にカウントされません。 狙いはコーディングをインタラクティブに感じさせること—アシスタントがその場で編集を適用し、短いテストを実行し、ユーザーの目の前で反復できるペアプログラミングのような体験を実現します。
なぜアーキテクチャが重要か:Cerebras + 低レイテンシ提供 OpenAIはCerebrasと連携し、GPT-5.3-Codex-Spark をWafer Scale Engine 3 上で提供しています。これは低レイテンシ・高スループット推論に最適化された、推論専用アクセラレータです。多くのクラウドモデルで用いられる一般的なGPUベースの提供経路とは異なり、Cerebrasハードウェアはレイテンシ優先の経路を提供し、リアルタイムなインタラクティビティに適したトークン速度を実現します。OpenAIはコスト効率のよい大規模推論と学習には引き続きGPUを活用し、レイテンシが優先の際はCerebrasがそれを補完します。
またOpenAIは推論スタックとクライアント/サーバーパイプラインの一部を再設計してオーバーヘッドを削減しました。具体的には、永続的なWebSocket接続、ストリーミングの改善、トークンごとのオーバーヘッド削減、セッションの高速起動です。引用されている改善には、クライアント/サーバーの往復オーバーヘッドの80%削減 、トークン単位のオーバーヘッド30%削減 、WebSocket/Responsesパイプライン最適化による最初のトークンまでの時間50%削減 などが含まれます。体感されるインタラクティビティにおいては、生のトークン/秒と同様に、これらのシステム面の改善も重要です。
ベンチマークと実運用でのパフォーマンス OpenAIは、GPT-5.3-Codex-Spark がエージェント型ソフトウェアエンジニアリング系ベンチマーク (SWE-Bench Pro、Terminal-Bench 2.0)で強力な性能 を示し、より大きなCodexモデルと比べてごく短時間でタスクを完了すると報告しています。独立したレポートや業界記事では、ワークロード特性に依存しつつ、Sparkのスピード改善が従来のCodexスナップショットに対してスループットで概ね約10〜15倍 、最初のトークンまでの時間も大幅に短縮されたとされています。
Cerebras WSE-3ハードウェア上で**>1,000トークン/秒**(OpenAI)。
128kトークン のコンテキストウィンドウ(OpenAI)。パイプライン全体でのレイテンシ削減測定値:往復−80%オーバーヘッド、トークンごと−30%オーバーヘッド、最初のトークンまで−50%(OpenAI)。
ベンチマークでの挙動:SWE-Bench ProやTerminal-Bench 2.0において、GPT-5.3-Codex-Spark は競争力のある精度を維持しながら、はるかに短時間でタスクを完了。OpenAIはインタラクティブなワークフローにおいて時間(所要時間)を第一級の指標として強調しています。
注意:一般公開された第三者のパフォーマンス分析では、速度にはトレードオフが伴うことが示されています。多段の推論や高い自律性が必要なタスクでは、より大きなCodex派生(あるいは最先端モデル)が絶対的な完了品質で依然として上回る場合があります。インタラクティビティ を最優先する場面でSparkを使用してください。
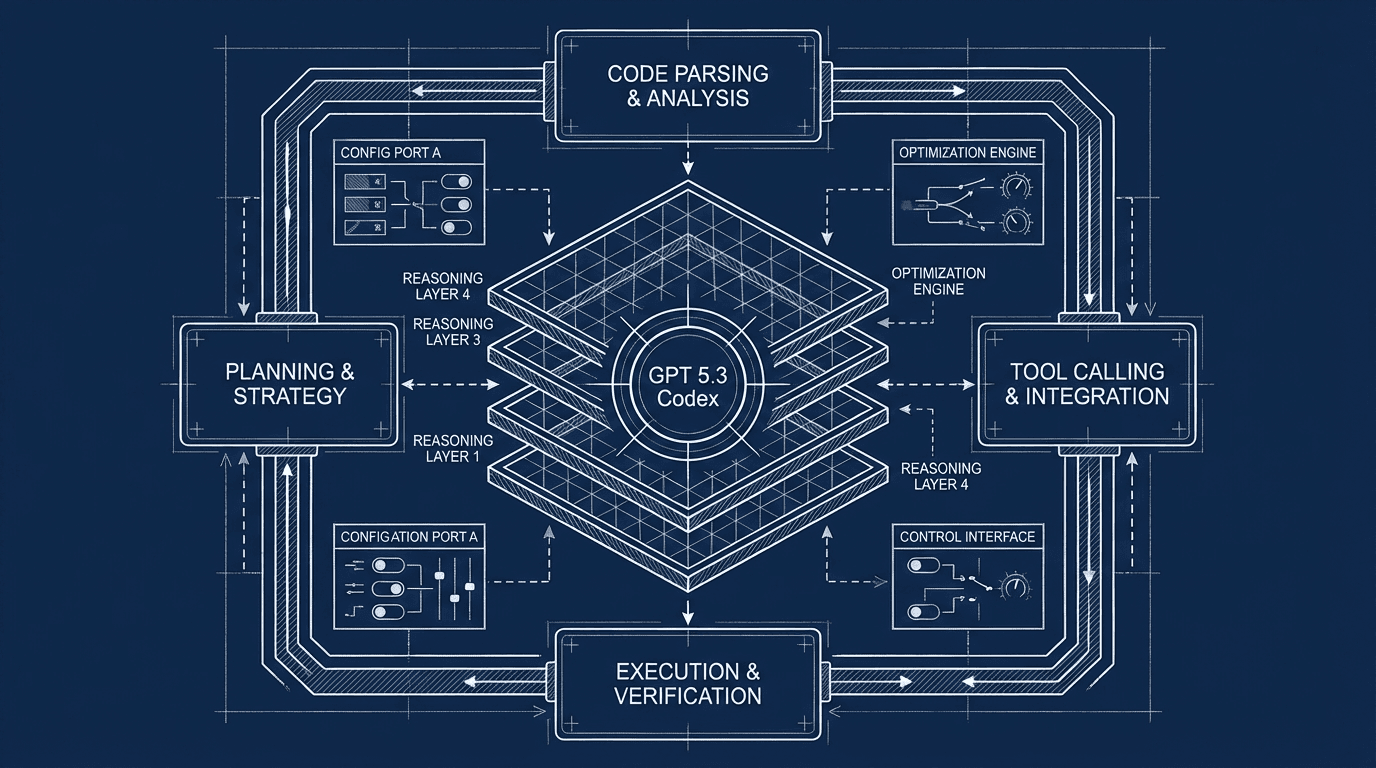
GPT-5.3-Codex-Spark と GPT-5.3-Codex の違い(実務的な差分)
コンテキストと能力
コンテキストウィンドウ: GPT-5.3-Codex(メインラインのモデル)は非常に大きなコンテキストウィンドウをサポートしています(OpenAIのドキュメントではCodexファミリーで最大400,000 トークンと大きな最大出力許容量が記載)。GPT-5.3-Codex-Spark は研究プレビューで128kコンテキストウィンドウ から開始—依然として非常に大きいものの、最大構成よりは小さめです。デフォルトのふるまい: Sparkは応答を簡潔に保ち、長いテストスイートを自律的に走らせるのではなく、あくまで狙いを絞った編集 を行うようにチューニングされています。この控えめな冗長性は、低レイテンシのインタラクティブUXのための意図的な設計です。
レイテンシ vs スループットのトレードオフ メインのCodexモデルはスループットと能力のバランスを最適化しており、長時間走るエージェント型タスクに最適です。Sparkはレイテンシ最優先 の対話に向けて(最初のトークンまでの時間の短縮と高いトークン/秒)チューニングされており、その代償としてより小型のモデル派生となっています。実務では、Spark ≈「反復的な開発ワークフロー向けの即時応答」、Codex ≈「深い計画+ツールオーケストレーション」です。
提供形態とレート制限 Sparkは当初、Codexアプリ、CLI、VS Code拡張、および設計パートナーに限定されたAPIアクセスで利用可能です。専用ハードウェア上で動作し、プレビューがゲートされているため、高負荷時には独立のレート制限と特別なキューイングポリシーが適用されます。
選び方
ワークフローがレイテンシに敏感 (小さな編集が多い、インタラクティブなUI調整など)な場合、ベンチマークスコアがやや下がってもSparkの方が生産性が高いことがよくあります。正確性/堅牢性を最優先 (複雑なデバッグ、多段のエージェント自動化など)の場合は、フルのGPT-5.3-Codex(またはそれ以上)の派生を優先し、探索段階ではSparkを高速アシスタントとして活用してください。本番戦略: ハイブリッドなチェイニングが一般的です—低コスト/低レイテンシのステップにSparkを用い、その後、洗練した成果物を高能力モデルに渡して検証・テスト・最終化します。長時間走る自律エージェント、深い調査タスク、もしくは 最高の推論能力と最大のコンテキストウィンドウが必要なワークフローでは、メインのGPT-5.3-Codexモデルを選びましょう。Sparkは代替ではなく補完的な位置づけです。
クイックスタート:Codex CLI と VS Code で GPT-5.3-Codex-Spark を使う 以下は、すぐに使い始められる最小限の実用例です。ChatGPT Proアカウントまたは設計パートナーのAPIキーがあり、Codexツールが最新であることを前提とします。
Codex CLI:インタラクティブなターミナルセッション(例) ドキュメントに従ってCLIをインストール/更新し、次を実行します:
# Install (macOS via Homebrew example)brew install openai/codex/codex || brew upgrade codex# Start an interactive Codex session with a model hintcodex --model gpt-5.3-codex-spark
起動後、Codexがリポジトリをインデックスし、次のような自然言語コマンドを入力できます:
> Add unit tests for utils/serialize.py that cover edge cases> Refactor user authentication to use async/await and keep behavior identical
CLIのUIは編集やアクションをストリーミングします。GPT-5.3-Codex-Spark の低レイテンシにより、編集がほぼ瞬時に現れます。フラグや構成(MCPサーバー、サンドボックス化、承認)についてはCodex CLIリファレンスを参照してください。
VS Code拡張:インライン支援と高速編集
Codex 拡張機能をインストール(OpenAIドキュメントのマーケットプレイスから)。プロジェクトを開き、Codexのコマンドパレット項目(例:「このファイルのリファクタリングをCodexに依頼」)を実行します。
モデルとしてGPT-5.3-Codex-Spark を選択(表示されている場合)。拡張機能はストリーミング経路を使用するため、編集はエディタ内にインタラクティブに表示され、承認/却下できます。
この拡張機能はCodex App ServerおよびModel Context Protocol (MCP) と統合されており、サンドボックスを維持しながら、コンテキストやワークスペース内のファイルをモデルで利用可能にします。
コードサンプル:Responses の WebSocket モードで GPT-5.3-Codex-Spark を統合 設計パートナー、またはSparkを含むAPIプランを利用している場合、最も高性能な統合パターンは永続的なWebSocket (Responses APIのWebSocketモード)です。WebSocketモードはターンごとのオーバーヘッドを削減し、エージェント型ワークロード向けに接続を温存します。
注意: Sparkは低レイテンシのインタラクティブ利用向けに最適化されています。最高の応答性のため、Realtime/WebSocketエンドポイント、または対応箇所ではResponsesのstream:trueを優先してください。APIは v1/responses、v1/realtime、その他のモデル向けに v1/chat/completions をサポートしています。
以下は websockets を用いた簡潔なPython 例で、概念的なフローを示します(キー/URLを差し替え、公式SDKに合わせて調整してください)。初回プロンプトを送信し、トークンを段階的にストリーム受信する方法を示しています。このパターンはリアルタイムワークフローに関するOpenAIのWebSocketガイドラインに合致します。
# pip install websocketsimport asyncioimport jsonimport websocketsimport osOPENAI_API_KEY = os.environ.get("OPENAI_API_KEY")WEBSOCKET_URL = "wss://api.openai.com/v1/responses?model=gpt-5.3-codex-spark"async def run_codex_spark(): headers = [ ("Authorization", f"Bearer {OPENAI_API_KEY}"), ("OpenAI-Beta", "realtime=v1"), ] async with websockets.connect(WEBSOCKET_URL, extra_headers=headers) as ws: # Create a response with a prompt asking for a code edit initial_payload = { "type": "response.create", "input": [ {"role": "user", "content": "Refactor function process_items to be async and add unit tests."} ], # optional: store=false for privacy, previous_response_id for multi-turn "metadata": {"source": "my-ide-integration"} } await ws.send(json.dumps(initial_payload)) print("Sent request, streaming tokens...") # Listen for server events async for message in ws: data = json.loads(message) # The server will send incremental events with partial tokens and finalization. event_type = data.get("type") if event_type == "delta": # partial token token = data["delta"].get("content") if token: print(token, end="", flush=True) elif event_type == "response.created": print("\n--- response created ---") break elif event_type == "response.error": print("Error:", data.get("error")) breakif __name__ == "__main__": asyncio.run(run_codex_spark())
previous_response_id を使用して、完全なコンテキストを再送せずに会話を継続(WebSocketモードは差分更新をサポート)。繰り返しのインタラクティブ編集に備えて接続を温存(再接続のオーバーヘッドを回避)。エージェント型対話には永続的なWebSocketセッションが推奨されます。
再接続/バックオフや部分応答の適切なハンドリングを実装—コミュニティの報告では、まれにWebSocket切断やHTTPSトランスポートへのフォールバックが発生するため、堅牢なリトライロジックを組み込みましょう。
実運用ユースケース:Sparkが活きる場面
1) ライブ補完&ペアプログラミング Sparkの>1,000トークン/秒というスループットにより、IDEプラグインはコードコンテキストを送り、ほぼ即時に補完を受け取れます(関数のインライン生成、ライブなリファクタ提案、タイピング中にテストのひな型を生成、など)。
2) インタラクティブなコード編集(変換&自動PRパッチ) リネーム、API変更、ファイル内ロジックのパッチといった小さく的確な編集は、Sparkのミニマルな作業スタイルと高速なフィードバックで恩恵を受けます。素早くdiffを生成し、プレビューして、即座のループで変更を受け入れる/洗練できます。
3) ストリーミング痕跡付きの支援的デバッグ Sparkはトークンを高速にストリームできるため、人間が読める診断ステップを出力しながらコマンドを流し、段階的な応答を受け取るデバッグアシスタントの運用が現実的になります。
4) ライブチュータリング&コーディング面接 ペアプログラミングやライブコーディング面接を提供するプラットフォームでは、Codex-Sparkの低レイテンシにより、人のペアに近い反応速度が得られます。
それでも大きなCodexを使うべき場面 長時間走る自律エージェント、深い調査タスク、または最高の推論能力と最大のコンテキストウィンドウが必要なワークフローでは、メインのGPT-5.3-Codexモデルを選んでください。Sparkは代替ではなく補完的です。
プロンプトパターン&エンジニアリングのコツ(Spark向け)
プロンプトは短く集中させる Sparkは的確な編集 を出力することを意図しているため、最小限の変更を明示的に要求するプロンプトが最も良く機能します:
Prompt: "Lightweight edit: reduce complexity of `find_duplicates` to O(n). Return only the updated function and one pytest unit test. Don't add commentary."
段階的な対話を使う 多段タスクをマイクロステップに分割(Sparkで足場を組み、その後より大きなモデルで検証/洗練)します。例:
Sparkに型付けと小さな関数のリファクタを依頼する。
Sparkにユニットテストを素早く実行(または生成)させる。
テスト+実装をフルCodexに渡し、完全なテスト実行、デバッグ、最終パッチ作成を行う。
プロンプトに「ガードレール」を入れる Sparkはレイテンシ志向であるため、精度が重要な場合は制約を明確に指定します:
「この関数のみを変更し、外部APIは変更しないこと」
「外部依存関係を追加しないこと」
「パッチはunified diff形式で返すこと」
これらの制約はスコープを絞り、Sparkが「的確な編集」モードに留まるのに役立ちます。
実践例:パイプラインでSparkと大規模モデルを組み合わせる 堅牢な設計パターンは**「速い内側ループ+重量級の外側ループ」**です。
高速ループ(Codex-Spark): インタラクティブな編集、関数の足場作り、ユニットテスト生成。ミリ秒〜秒で応答し、開発者のIDEで即時の生産性を提供。重量級ループ(GPT-5.3-Codex / GPT-5.4 Thinking): 統合テスト、アーキテクチャレビュー、セキュリティ分析、長時間のエージェントジョブ。ここではスループットが優先され、バックグラウンドジョブとして実行。
開発者がVS Codeでリファクタ要求 → Codex-Sparkが素早い編集を提案(ストリーミング、承認/却下)。
CIでは、GPT-5.3-Codex(またはGPT-5.4 Thinking)エージェントがテストマトリクスを実行し、セキュリティスキャンを行い、次のスプリント向けの設計レベルの変更を提案。
このパターンにより、即時のフィードバックを得つつ、より計算集約的な高品質チェックを非同期ジョブで担保できます。
まとめ GPT-5.3-Codex-Sparkは、ソフトウェアエンジニアリングにおける真にインタラクティブなAI支援への重要な一歩です。単なる「生成が速い」ではなく、異なるインタラクションモデルです。開発者がタイプしている間に流れるような、瞬時のAIフィードバックが価値の源泉である製品においては、Spark(あるいはSpark型の低レイテンシ経路)が期待値とワークフローを変えるでしょう。
Sparkに似た低レイテンシモデルを探している場合は、CometAPIをチェックしてください。500以上のモデルを提供しており、小型・低レイテンシのモデルも多数。単一のプロバイダ設定だけで、いつでも切り替えられます。
AIに関するヒント、ガイド、ニュースをもっと知りたい方は、VK 、X 、Discord をフォローしてください!