GLM-5.3 Flash는 대부분의 프로덕션 워크로드에서 더 나은 기본 선택지입니다. 네이티브 비주얼 입력과 1M 토큰 컨텍스트를 제공하며, 표준 리스트 가격이 크게 낮습니다. GLM-5.3는 단위 비용보다 최대 코딩 심도, 까다로운 장기 추론, 사이버보안 성능이 더 중요할 때 더 강력한 선택입니다.
이는 소형 vs 대형 모델의 이야기가 아닙니다. Flash는 새로운 멀티모달 베이스에서 학습된 320B 총/18B 활성 MoE로, 하이브리드 스파스 및 선형 어텐션을 채택합니다. 플래그십은 744B 총/40B 활성 MoE이며, GLM-5.3의 향상은 GLM-5.2 베이스에 대한 스케일된 포스트 트레이닝에서 비롯됩니다.
Key Takeaways
멀티모달 코딩, 문서 이해, 브라우저 또는 GUI 에이전트, 대량 자동화, 비용 민감 애플리케이션에는 Flash를 선택하세요.
가장 어려운 리포지토리 규모의 엔지니어링 작업, 더 깊은 도구 보조 추론, 방어적 보안 연구에는 플래그십을 선택하세요.
Z.ai는 Flash를 GLM-5 시리즈 최초의 네이티브 멀티모달 모델로 포지셔닝합니다. 총 320B 파라미터, 활성 18B 파라미터를 갖지만, “Flash”를 “작음”으로 받아들여서는 안 됩니다. 전체 체크포인트는 여전히 매우 큰 모델이며, 효율성은 더 작은 전문가 하위 집합을 활성화하고 어텐션 스택을 재설계함으로써 나옵니다.
베이스 모델은 30조 토큰 멀티모달 코퍼스에서 학습되었습니다. 네이티브 비전이 코딩 루프에 통합되어 스크린샷, 렌더링된 인터페이스, 차트, 페이지 레이아웃 및 기타 시각적 피드백을 확인하고 다음 액션을 정제하기 전에 이를 반영할 수 있습니다.
이는 아키텍처 수준 비교이며, 종단간 지연이 동일한 배율로 줄어든다는 보장은 아닙니다. 실제 API 속도는 하드웨어, 양자화, 배칭, 추론 길이, 서빙 소프트웨어, 제공자 부하 등에도 좌우됩니다.
GLM-5.3-Flash 하이브리드 어텐션 아키텍처 및 롱 컨텍스트 연산/캐시 비교.
출처: Z.ai 공식 아키텍처 문서
Benchmark Performance: Where Each Model Wins
가장 깔끔한 비교는 벤더 보고 작업 벤치마크와 독립 API 측정치를 분리하는 것입니다. 벤치마크 이름이 같더라도 하니스 버전, 도구 구성, 컨텍스트 관리, 추론 노력은 다를 수 있습니다. 아래 표는 플래그십 평가와 Flash 평가에서 가장 일치하는 값을 사용하며, 작은 차이는 방향성으로만 봅니다.
Benchmark
GLM-5.3 Flash
GLM-5.3
Higher score
What it tests
Terminal-Bench 2.1
84.3
88.2
GLM-5.3
터미널 및 에이전트 코딩
DeepSWE v1.1
63.4
66.9
GLM-5.3
소프트웨어 엔지니어링
NL2Repo
56.3
58.0
GLM-5.3
리포지토리 생성
Toolathlon Verified
78.4
73.0
Flash
도구 사용
AutomationBench
48.8
48.2
근소한 차 / Flash
컴퓨터 사용 자동화
Agents’ Last Exam
26.3
28.5
GLM-5.3
장기 에이전트 추론
HLE with tools
55.3
62.5
GLM-5.3
어려운 도구 보조 추론
GDPval-AA v2
1773 Elo
1769 Elo
근소한 차 / Flash
전문 지식 작업
출처: 플래그십 평가 및 Flash 평가. 평가 설정이 다를 수 있으므로 방향성 비교로 보세요.
Coding and Repository Engineering
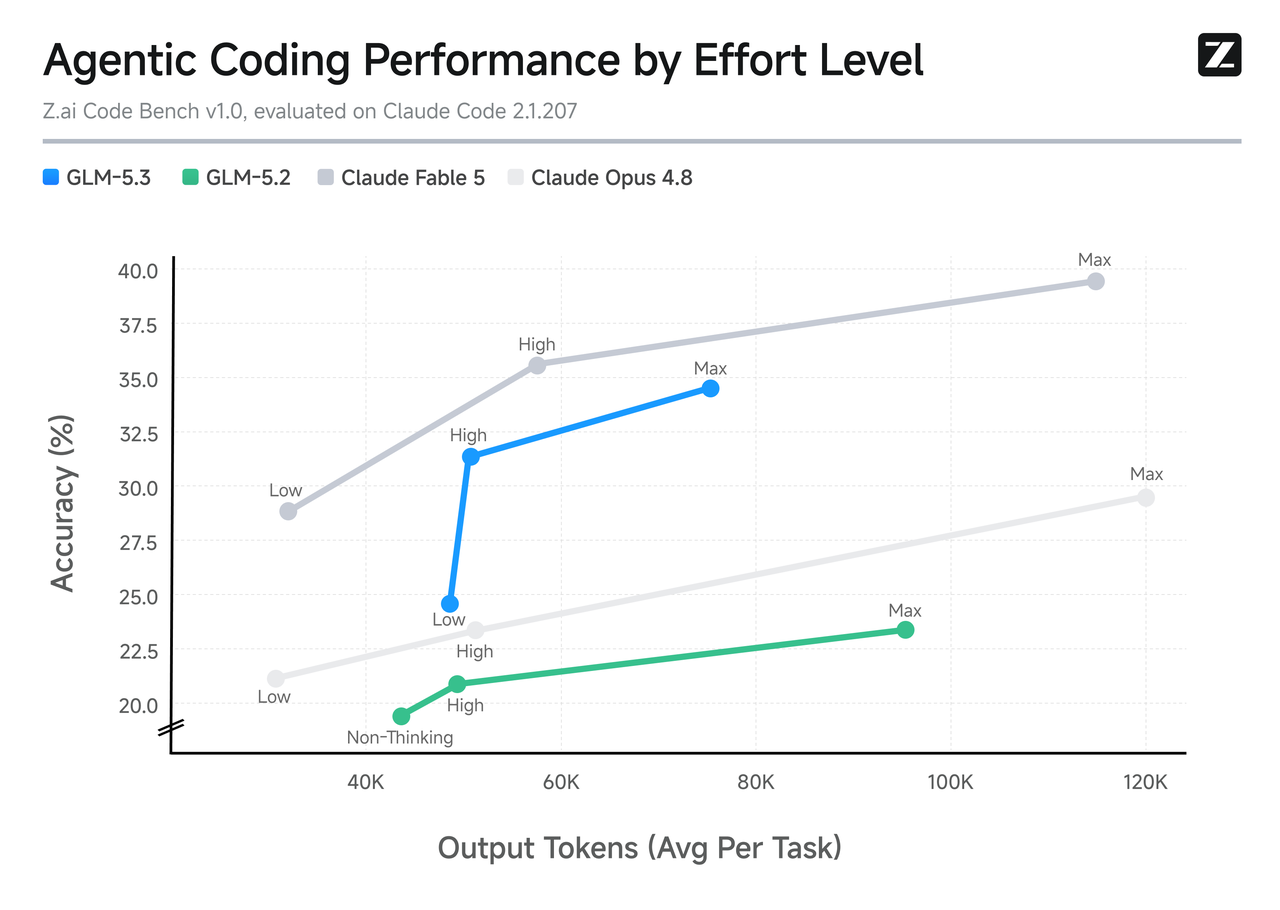
플래그십은 더 높은 성능 상한을 갖습니다. DeepSWE에서 Flash를 3.5포인트, NL2Repo에서 1.7포인트 앞섭니다. Z.ai Code Bench v1.0에서 두 모델 모두 Claude Code 2.1.207로 평가했을 때 플래그십은 최대 노력에서 34.5%, Flash는 29.0%를 기록해 5.5포인트 차이를 보였습니다.
그럼에도 Flash는 일상적인 리포지토리 유지보수, 테스트 생성, 디버깅, 리팩토링, 대량 코딩 에이전트의 1차 시험 모델로 충분히 경쟁력이 있습니다. 가장 어려운 작업이나 실패 경로만 플래그십으로 승격하세요.
Z.ai의 GLM-5.3-Flash 및 기타 코딩/에이전트 모델 6개 벤치마크 평가.
출처: Z.ai 공식 Flash 문서
GLM-5.3의 추론 노력 수준별 에이전트 코딩 정확도와 출력 토큰 사용량.
출처: Z.ai 공식 플래그십 문서
Tool Use, Automation, and Knowledge Work
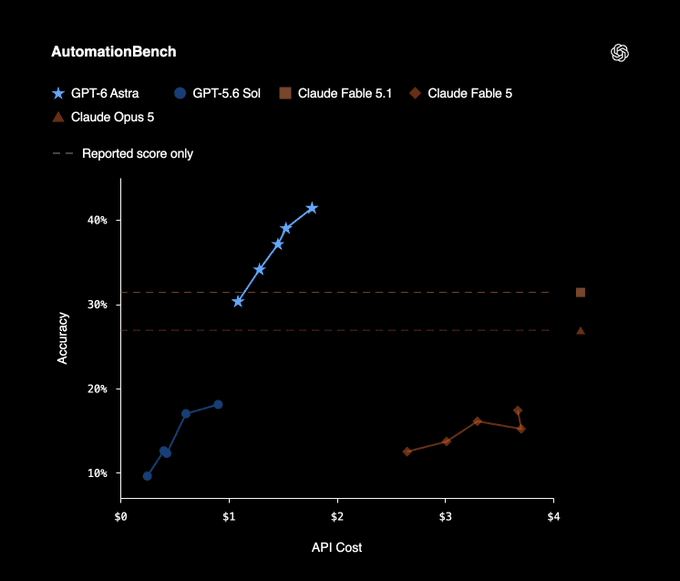
Flash가 항상 약한 것은 아닙니다. Toolathlon Verified에서 78.4로 플래그십의 73.0을 앞섰고, AutomationBench에서도 48.8 대 48.2로 근소하게 앞섭니다. GDPval-AA v2에서는 사실상 동점입니다. 이는 작업이 하나의 극히 어려운 추론 체인보다는 많은 저비용 요청에 걸친 도구 조정의 안정성에 더 중점을 둘 때 Flash가 특히 매력적임을 의미합니다.
Independent Intelligence, Speed, and Latency
Independent measurement
GLM-5.3 Flash
GLM-5.3 (max)
Result
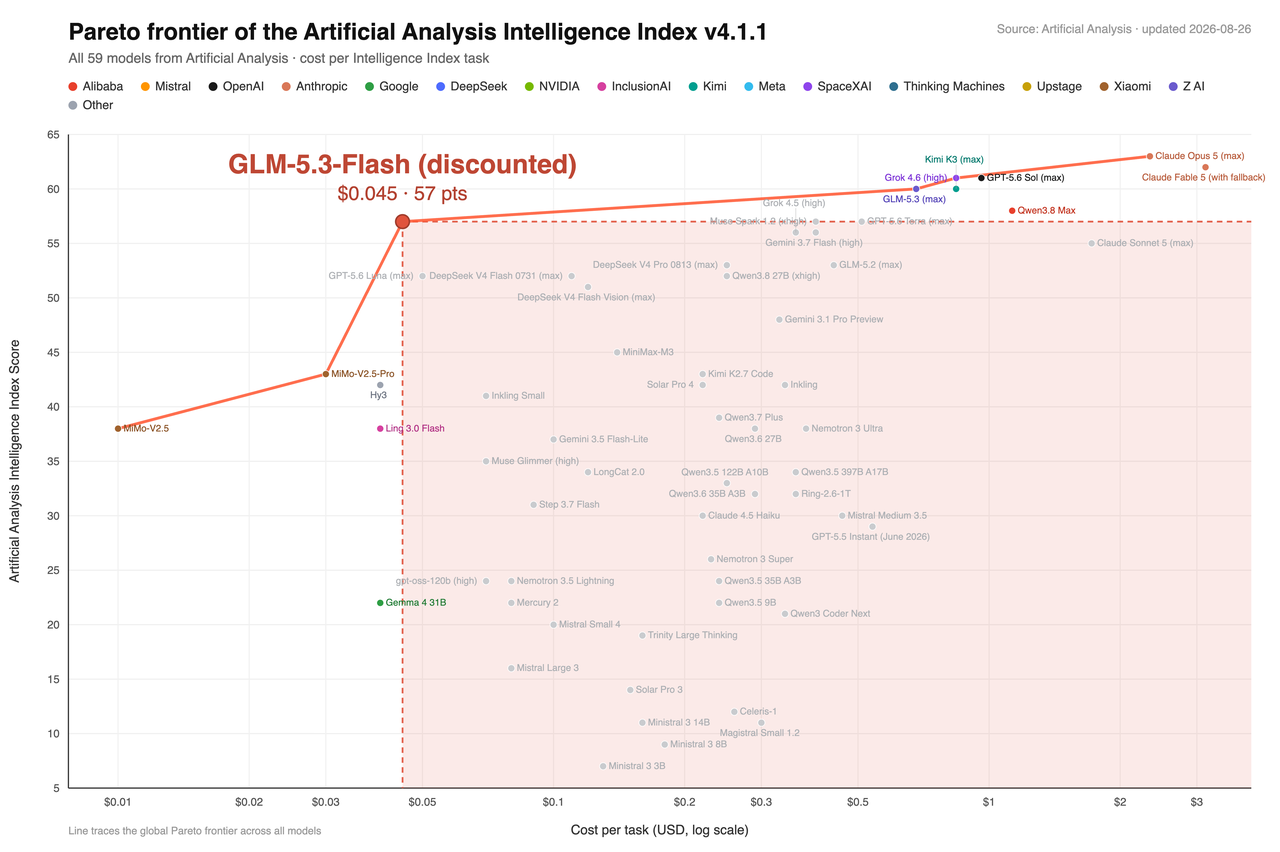
Artificial Analysis Intelligence Index
57
60
GLM-5.3
Output speed
50.2 tokens/s
76.6 tokens/s
GLM-5.3
Time to first token
1.49 s
1.61 s
Flash
Context window
1M
1M
동점
Blended price in AA comparison
$0.10 / 1M tokens
$0.90 / 1M tokens
Flash
출처: Artificial Analysis 매칭 API 비교.
독립 결과는 “Flash가 더 빠르다”는 가정에 중요한 보정을 추가합니다. Flash가 약간 더 빨리 응답을 시작하지만, 테스트된 플래그십 엔드포인트는 출력이 시작되면 더 빠르게 토큰을 생성했습니다. 이러한 측정치는 제공자별 스냅샷로, 모델의 불변 속성이 아닙니다.
Z.ai 공식 Flash 문서에 재현된 Artificial Analysis 비용–지능 프런티어.
출처: Z.ai 공식 Flash 문서
Multimodality: Flash Has the Clear Advantage
Flash는 비주얼 입력을 받아 이를 에이전트 워크플로에 통합합니다. 스크린샷, 페이지 이미지, 차트, 인터페이스 상태, 화면 녹화 및 지원 파일을 확인한 뒤, 코딩이나 도구 사용 시 시각적 증거를 활용할 수 있습니다. 플래그십은 현재 텍스트 전용 입력을 지원합니다.
프런트엔드 및 디자인-투-코드: Flash는 참조 스크린샷을 검사하고 렌더링된 구현을 검증할 수 있습니다.
문서 및 오피스 워크플로: 페이지 구조, 차트, 레이아웃, 이미지 배치를 추론할 수 있습니다.
브라우저 및 컴퓨터 사용: Flash는 비주얼 상태를 도구 호출과 반복적 수정과 결합할 수 있습니다.
텍스트 전용 리포지토리 작업: 입력이 코드와 텍스트이며 최대 추론 심도가 필요한 경우 플래그십이 여전히 우선입니다.
Long Context and Reasoning Controls
GLM-5.3 Flash는 1M 토큰 컨텍스트와 최대 128K 출력 토큰을 지원하며, GLM-5.3도 동일한 한계를 제공합니다. 두 모델 모두 추론을 항상 활성화하고 low, high, max 노력 수준을 허용합니다. Z.ai는 어려운 코딩과 벤치마크 재현에는 max를 권장합니다.
따라서 컨텍스트 용량은 주요 차별 요소가 아닙니다. 차이는 긴 시퀀스를 얼마나 경제적으로 처리하는지, 그리고 가장 어려운 작업에 얼마나 많은 추론 용량을 투입할 수 있는지입니다. Flash는 아키텍처적으로 롱 컨텍스트에서 더 저렴하고, 플래그십은 더 강한 품질 상한을 갖습니다.
Flash는 플래그십보다 서비스 제공이 쉬우나, 소비자 GPU로도 가능한 모델은 아닙니다. 320B 체크포인트, 멀티모달 구성 요소, KV 캐시, 1M 컨텍스트는 여전히 상당한 인프라를 요구합니다. 데이터 통제, 맞춤 서빙, 높은 지속 활용률이 운영 비용을 상쇄할 때 셀프 호스팅이 가장 매력적입니다.
Which Model Should You Choose?
Choose GLM-5.3 Flash if?
이미지, 스크린샷, 차트, 문서, 브라우저, GUI 이해가 필요하다면
대량 코딩 에이전트, 리서치 워크플로, 비즈니스 자동화를 운영한다면
최저 토큰 비용으로 강력한 도구 사용성과 지식 작업 성능을 원한다면
1M 컨텍스트가 필요하지만 모든 요청에 플래그십 비용을 원치 않는다면
셀프 호스팅을 계획하고 320B/18B가 744B/40B보다 현실적이라면
Choose GLM-5.3 if?
가장 어려운 리포지토리 규모 코딩 또는 장기 엔지니어링 작업을 해결한다면
평가가 낮은 단위 비용보다 더 깊은 추론을 보상한다면
DeepSWE, HLE with tools, Agents’ Last Exam에서 더 강한 결과가 필요하다면
승인된 방어 보안 또는 취약점 발굴 워크플로를 구축한다면
더 높은 성공률이 대략 한 자릿수 배의 토큰 프리미엄을 상쇄할 수 있다면
Decision Matrix by Use Case
Workload
Recommended starting model
Why
대량 채팅 및 자동화
GLM-5.3 Flash
훨씬 낮은 비용; 강력한 도구 사용성
비주얼 코딩 및 UI 디버깅
GLM-5.3 Flash
네이티브 비주얼 입력
문서, 차트, 오피스 분석
GLM-5.3 Flash
멀티모달 프로페셔널 워크플로
일상 리포지토리 유지보수
Start with Flash
실패 또는 비정상 난도 작업만 승격
어려운 리포지토리 규모 엔지니어링
GLM-5.3
더 높은 코딩 성능 상한
도구 기반 장기 리서치
GLM-5.3
HLE-with-tools에서 더 강함
방어 보안 및 취약점 발굴
GLM-5.3
전용 사이버 훈련과 벤치마크
비용 민감 셀프 호스팅
GLM-5.3 Flash
더 작은 활성/총 파라미터 풋프린트
불확실한 혼합 워크로드
Hybrid routing
Flash 기본; 플래그십으로 승격
A Better Production Strategy: Route, Do Not Replace
대부분의 팀에 가장 강력한 설계는 배타적 선택이 아닙니다. Flash를 기본 라우트로 사용하고, 복잡도 높음, 검증 실패, 보안 민감, 또는 경제적 가치가 플래그십 프리미엄을 정당화하는 작업만 승격하세요.
비주얼, 일상, 대량 작업은 Flash로 보냅니다.
승인율, 토큰, 지연, 도구 실패, 인간 개입을 측정합니다.
실패하거나 고위험 텍스트 작업은 플래그십으로 승격합니다.
보안 민감 작업은 추가 승인과 샌드박스 통제를 통해 라우팅합니다.
벤치마크 순위나 가격이 아닌 승인 결과당 비용을 최적화합니다.
How to Test Both Models Through CometAPI
CometAPI는 동일한 OpenAI 호환 베이스 URL 뒤에 GLM-5.3 Flash 라우트와 GLM-5.3 라우트를 제공합니다. API 키를 생성한 후 동일한 텍스트 작업을 두 모델 ID로 실행하세요. 공정한 테스트를 위해 프롬프트, 추론 노력, 도구 정의, 최대 출력, 승인 루브릭을 동일하게 유지하세요.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
멀티모달 평가를 위해서는 라이브 Flash 라우트 문서에서 지원되는 이미지 콘텐츠 스키마를 확인하세요. 플래그십 비교는 비주얼 입력을 받지 않으므로 텍스트 전용 등가를 사용해야 합니다.
Limitations of This Comparison
일부 코딩 및 에이전트 점수는 벤더 보고치입니다. 독립 재현은 다른 도구, 프롬프트, 추론 설정을 사용할 수 있습니다.
매칭된 벤치마크 이름이 항상 동일한 하니스 버전이나 컨텍스트 관리 전략을 보장하지는 않습니다.
어텐션 연산 및 KV 캐시의 아키텍처 수준 감소는 API 지연을 직접 예측하지 않습니다.
가격, 프로모션, 모델 가용성, 속도 제한, 라우트 기능은 변할 수 있으므로 배포 전 라이브 모델 페이지를 확인하세요.
오픈 가중치라 해도 전체 컨텍스트에서 두 체크포인트 모두 셀프 호스팅이 저렴하지는 않습니다.
사이버보안 역량은 이중 용도이므로 승인, 샌드박싱, 로깅, 전문가 검토, 책임 있는 공개가 필요합니다.
Conclusion
GLM-5.3 Flash는 실용적인 기본 선택입니다. 긴 컨텍스트를 유지하고 네이티브 비전을 추가하며, 도구 사용과 전문 작업에서 강력한 성능을 보이고, 경제성을 변화시켜 훨씬 더 폭넓은 배포를 가능하게 합니다. GLM-5.3는 전문 승격 모델로서 더 비싸고 텍스트 전용이지만, 가장 어려운 코딩, 추론, 사이버보안 작업에서 더 강합니다.
최종 평결은 워크로드 기반입니다. Flash로 시작하고 실제 승인율을 측정하며, 플래그십의 추가 추론 용량이 충분히 더 많은 성공 결과를 만들어 프리미엄을 정당화할 때만 라우팅하세요.
Frequently Asked Questions
Is GLM-5.3 Flash better than GLM-5.3?
항상 그렇지는 않습니다. Flash는 가격, 멀티모달리티, 일부 도구/자동화 벤치마크에서 더 낫습니다. 플래그십은 가장 어려운 코딩, 도구 보조 추론, 사이버보안 워크로드에서 더 강합니다.
Is GLM-5.3 Flash a small model?
아닙니다. 총 320B 파라미터에 토큰당 18B를 활성화합니다. 744B/40B 플래그십보다 효율적이지만, 셀프 호스팅에는 여전히 상당한 하드웨어가 필요합니다.
Which model is cheaper?
Flash가 압도적으로 저렴합니다. Z.ai의 표준 리스트 가격은 플래그십의 약 10분의 1이며, 현재 CometAPI 라우트에서는 프로모션 기간 동안 격차가 더 큽니다.
Which model is faster?
지표와 제공자에 따라 다릅니다. Artificial Analysis는 Flash의 첫 토큰 시간이 약간 더 낮고, 플래그십의 출력 속도가 더 높다고 측정했습니다.
Which model supports images?
Flash는 네이티브 비주얼 입력을 지원합니다. 플래그십은 현재 텍스트 전용 입력을 지원합니다.
Do both models support a 1M-token context?
예. Flash는 1M 컨텍스트와 최대 128K 출력을 지원하며, 플래그십도 동일합니다.
Which model is better for coding?
일상적이거나 대량 코딩 에이전트에는 Flash를, 가장 어려운 리포지토리 규모 엔지니어링 작업이나 실패 비용이 가격 차이를 상회하는 경우에는 플래그십을 사용하세요.
Which model is better for cybersecurity?
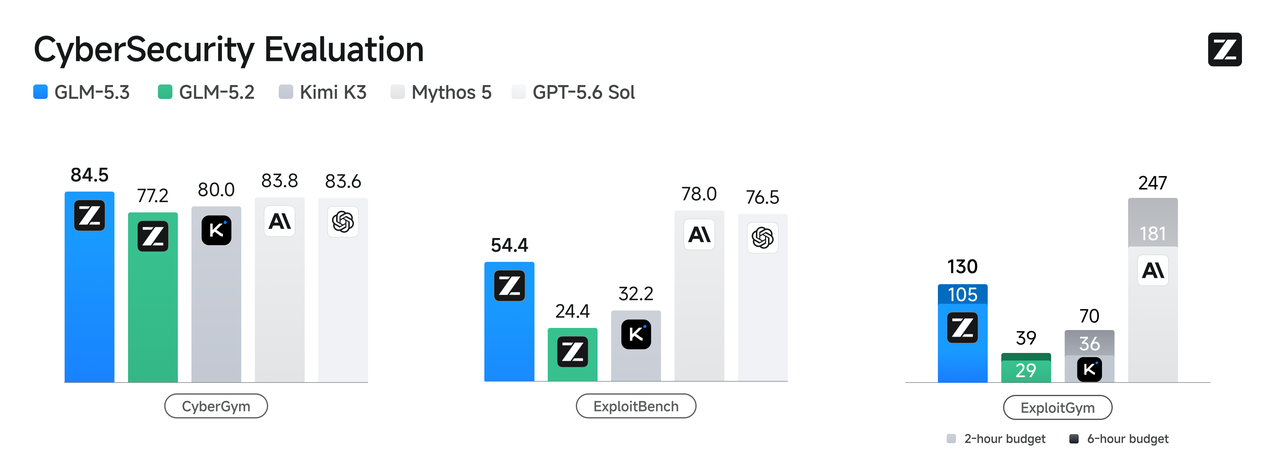
플래그십입니다. Z.ai가 취약점 발굴과 익스플로잇 체인 추론을 위해 특별히 학습 및 평가했습니다. 승인되고 통제된 환경에서만 사용하세요.
Can both models be self-hosted?
예. Z.ai 리포지토리는 다운로드 가능한 체크포인트와 지원 서빙 프레임워크를 제공합니다. 다만 두 모델 모두 큰 인프라 프로젝트입니다.
What is the best deployment strategy?
Flash를 기본 라우트로 사용하고, 어렵거나 실패했거나 보안 민감한 텍스트 작업만 플래그십으로 승격하세요. 승인 결과당 비용을 측정하세요.