
TL;DR
이미 OpenAI Responses 도구를 사용 중이거나 명시적 추론 노력 단계가 필요하다면 GPT-6.1 Sol부터 시작하십시오; 잘 정의된 코딩 반복과 템플릿 중심의 전문 산출물에는 Claude Sonnet 5.5를 테스트하십시오. 이는 평가 우선순위이며, 검증된 품질 순위가 아닙니다. 둘 다 입력 $2/M, 출력 $10/M, 기본 캐시 읽기 $0.10/M에서 시작합니다. 대략 1M 컨텍스트와 128K 표준 최대 출력에서, 실질적 차이는 기본 캐시 읽기 할인보다 통합, 작업 동작, 캐시 보존, 롱 컨텍스트 과금에 있습니다.
핵심 절충은 작업 동작과 과금 조건입니다. GPT-6.1 Sol은 다섯 가지 노력 수준을 사용하며 도구 호출에 Responses가 필요합니다; Sonnet 5.5는 적응형 사고를 사용합니다. 입력 토큰이 272K를 초과하면 GPT-6.1 Sol은 전체 요청에 더 높은 요율을 적용합니다. 여기서 검토된 출처는 정확히 일치하는 버전 간 벤치마크 승자를 확립하지 않으므로, 승인 기준을 충족하면서 전체 워크플로 비용이 가장 낮은 모델을 선택하십시오.
Key Takeaways
- 동일한 기본 요금: 두 모델 모두 입력 $2/M, 출력 $10/M, 캐시 읽기 $0.10/M를 부과합니다. 캐시 쓰기, 보존 기간, 롱 컨텍스트 구간, 실제 청구 사용량을 비교하십시오.
- 컨텍스트는 근접: 1.05M 대 1M 토큰; 둘 다 128K 표준 최대 출력 지원.
- 통합의 차이: GPT-6.1 Sol은 도구 호출에 Responses가 필요하며 none 또는 minimal 노력은 허용하지 않습니다; Sonnet 5.5는 적응형 사고와 모델별 도구 제약을 사용합니다.
- 증거는 버전별로 유지: GPT-6 Sol 점수를 GPT-6.1 Sol 결과로 재라벨링할 수 없습니다.
- 완료된 작업으로 선택: 품질, 지연, 재시도, 캐시 쓰기·읽기, 도구 비용, 인간 수정량을 측정하십시오.
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
| Decision factor / specification | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Provider | OpenAI | Anthropic |
| Release date | September 29, 2026 | September 28, 2026 |
| Model ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Context / standard maximum output | 1,050,000 / 128,000 tokens | 1,000,000 / 128,000 tokens |
| Input → output | Text and images → text | Text and images → text |
| Reasoning controls | low, medium, high, xhigh, max; medium default | Adaptive thinking; high default on Claude Platform |
| Default effort | medium | high on Claude Platform |
| Knowledge cutoff | April 30, 2026 | June 2026 |
| Official base input / output per 1M tokens | $2 / $10; Standard requests with up to 272K input tokens | $2 / $10 |
| Official base cache reads per 1M tokens | $0.10 | $0.10 |
| Official base cache writes per 1M tokens | $2.50 | $2.50 for 5 minutes; $4.00 for 1 hour |
| Long-context billing | Above 272K input: $4 input, $0.20 cache read, $5 cache write, $15 output per 1M; applies to the full Standard request | No equivalent surcharge stated in the cited model overview |
| Primary positioning | Complex coding, computer use, and professional work | Fast coding iteration and professional workflows |
| Test first when | You already use Responses tools or need explicit effort controls | Your work centers on coding, documents, slides, or spreadsheets |
| Evidence and decision limit | Documented capabilities; no matched exact-version numerical winner established here | Published coding and knowledge-work results; not a controlled win over GPT-6.1 Sol |
GPT-6.1 Sol Overview
GPT-6.1 Sol은 복잡한 코딩, 컴퓨터 사용, 전문 업무를 위한 OpenAI의 2026년 9월 29일 Sol 릴리스입니다. OpenAI는 이를 더 낮은 비용으로 Astra에 가까운 성능으로 설명하지만, 해당 포지셔닝은 귀하의 작업에서 검증되어야 합니다. 큰 컨텍스트와 조정 가능한 추론은 리포지토리 에이전트와 다단계 전문 워크플로의 후보가 됩니다.
운영 제약도 포지셔닝만큼 중요합니다: 기본 노력 수준은 medium이며, 낮은 설정은 low이고, 도구 호출에는 Responses가 필요합니다. no-reasoning 경로 또는 Chat Completions 도구에 기반한 워크플로는 이 모델을 신뢰성 있게 사용하기 전에 마이그레이션 작업이 필요합니다.
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5는 잘 범위가 정의된 일상 코딩, 에이전트, 전문 업무를 위한 Anthropic의 2026년 9월 28일 릴리스입니다. 모델 개요는 적응형 사고, Claude Platform에서 높은 기본 노력, 텍스트·이미지 입력, 128K 표준 최대 출력을 문서화합니다. Anthropic은 버그 수정, 명료한 문서, 세련된 슬라이드, 효율적인 반복을 강조합니다.
개발 팀에겐 Sonnet이 반복적인 구현과 리뷰 사이클에 유용한 후보가 됩니다. 사무 워크플로에서는 초안 품질과 템플릿 준수 여부를 평가하십시오. 제공자의 속도 주장은 Sonnet 5.5를 Sonnet 5와 비교한 것으로, GPT-6.1 Sol 대비 속도 우위를 확립하지는 않습니다.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
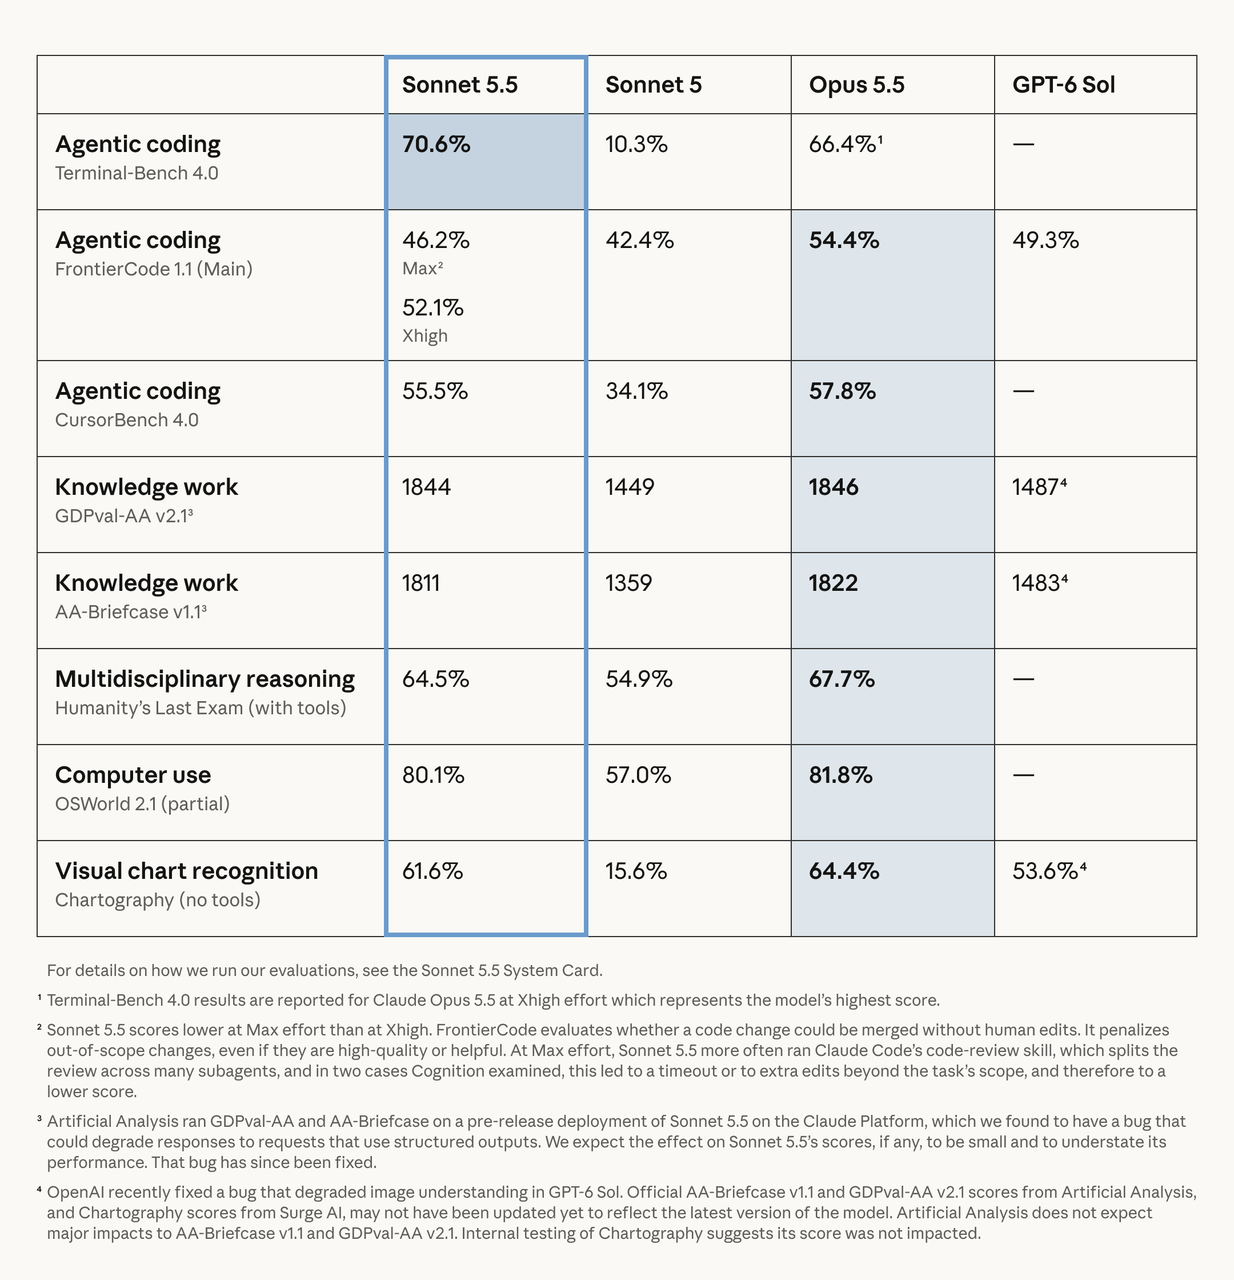
Anthropic의 Sonnet 5.5 출시 결과는 유용한 작업 부하 신호를 제공합니다. 비교에는 구형 GPT-6 Sol이 포함되므로, 그 OpenAI 열 값은 아래의 현재 모델 표에서 제외했습니다. “Not established”는 인용된 출처가 이 비교를 위한 정확히 일치하는 버전 점수를 지원하지 않음을 의미하며, 성능이 0임을 의미하지는 않습니다.
| Benchmark / conditions | GPT-6.1 Sol | Claude Sonnet 5.5 | What it measures |
|---|---|---|---|
| Terminal-Bench 4.0 | Not established here | 70.6% | 터미널 코딩 작업 |
| FrontierCode 1.1 Main | Not established here | 52.1% Xhigh; 46.2% Max | 병합 가능한 저장소 변경 |
| CursorBench 4.0 | Not established here | 55.5% | 에이전트형 개발(Cursor 작업) |
| GDPval-AA v2.1 | Not established here | 1844 | 전문 지식 업무 |
| AA-Briefcase v1.1 | Not established here | 1811 | 장기 지식 업무 |
| Humanity’s Last Exam, tools | Not established here | 64.5% | 다학제 추론 |
| OSWorld 2.1, partial | Not established here | 80.1% | 컴퓨터 사용 부분 보상 |
| Chartography, no tools | Not established here | 61.6% | 시각 차트 인식 |
시험 조건: 노력 수준과 에이전트 하니스는 코딩 결과에 영향을 줍니다. GDPval-AA와 AA-Briefcase는 Artificial Analysis 평가이며, Chartography 결과는 Surge AI에서 나왔습니다. Anthropic은 사전 배포 Sonnet에서 구조화된 출력 버그가 이후 수정되었고, 이로 인해 전문 업무 결과가 다소 과소평가되었을 수 있음을 언급합니다. 공지의 System Card 링크에서 시험 환경과 전체 방법론을 확인하십시오; 서로 다른 지표를 하나의 전체 순위로 결합하지 마십시오.
아래의 원본 Anthropic 이미지는 평가 각주를 포함합니다. GPT-6 Sol 열은 역사적 맥락일 뿐이며 GPT-6.1 Sol 성능을 보고하지 않습니다.
Agentic Coding and Software Engineering
Sonnet 5.5는 터미널 코딩, 병합 가능한 코드 변경, IDE 스타일 에이전트 작업에 대한 증거를 보고했습니다. GPT-6.1 Sol은 복잡한 코딩이 문서화되어 있으며 OpenAI 도구 생태계와 통합됩니다. 제품 포지셔닝이나 전작의 점수만으로 현재 코딩 승자를 확립할 수는 없습니다. 유용한 평가를 위해서는 회귀 테스트가 있는 실제 변경을 선택하고, 검토자에게 범위, 유지보수성, 병합 준비도를 평가하도록 요청하십시오.
Knowledge Work, Reasoning, Math, and Science
Sonnet의 GDPval-AA와 AA-Briefcase 결과는 보고서, 분석, 사무 산출물을 합리적 평가 대상으로 만듭니다. GPT-6.1 Sol도 전문 업무를 목표로 하지만, 여기서 사용된 출처는 이들 모델 간 일치 비교를 제공하지 않습니다. 자체 문서, 스프레드시트, 프레젠테이션 템플릿을 사용하십시오. 고급 수학과 과학 관련 주장은 일반 추론 제어에서의 외삽이 아니라 과제별 증거가 필요합니다.
Computer Use, Browser Automation, and Multimodal Workflows
두 모델 모두 이미지를 입력으로 받아 스크린샷 디버깅과 시각 분석을 지원합니다. Sonnet의 OSWorld와 Chartography 결과는 해당 평가에 대한 증거입니다. GPT-6.1 Sol은 Responses 도구를 통해 컴퓨터 사용을 문서화합니다. 전체 워크플로를 테스트하십시오: 탐색 정확성, 실패한 도구 호출 이후 복구, 출력 정확성, 완료까지의 시간. 텍스트·이미지 입력만으로 동일한 컴퓨터 사용 통합이 보장되지는 않습니다.
Independent Evaluation and Evidence Quality
제공자 발표 표는 제3자 결과를 포함할 수 있지만, 단일 통제 실험이 되지는 않습니다. 독립 비교에서는 정확한 모델 ID, 배포 날짜, 노력 수준, 도구, 보호장치, 타임아웃, 재시도 정책, 스톱 규칙을 기록하십시오. 집계 지능 지수, 코딩 성공률, 부분 보상 기반 컴퓨터 사용 점수는 서로 다른 질문에 답합니다. 검토된 출처는 이 정확한 쌍에 대한 완전한 일치 독립 결과 집합을 확립하지 않습니다.
GPT-6.1 Sol vs Claude Sonnet 5.5: Cost
Official API Pricing
| Pricing metric | GPT-6.1 Sol official rates | Claude Sonnet 5.5 official rates |
|---|---|---|
| Input / 1M tokens, base Standard | $2.00 | $2.00 |
| Output / 1M tokens, base Standard | $10.00 | $10.00 |
| Cache read / 1M tokens, base | $0.10 | $0.10 |
| Cache write / 1M tokens, base | $2.50 | $2.50 for 5m; $4.00 for 1h |
| Batch processing | 50% below Standard | 50% input/output discount |
| Input above 272K, Standard full request | $4 input / $0.20 cache read / $5 cache write / $15 output | No equivalent surcharge stated in the cited overview |
모든 요율은 백만 토큰(USD) 기준입니다. GPT-6.1 Sol 기본 캐시 읽기는 $0.10/M이고 Sonnet 5.5 캐시 읽기도 $0.10/M입니다. Sol의 272K 초과 입력 조건은 초과분만이 아니라 전체 표준 요청에 대해 요율을 올립니다. 캐시 쓰기, 보존, 롱 컨텍스트 구간, 지역 처리, 서비스 등급을 비교하십시오; 기본 읽기 가격만으로는 어느 모델도 우위를 갖지 않습니다.
Cost per Completed Task
Cost per accepted result = total cost across all attempted tasks / number of accepted results. 총 비용에는 청구된 신규 입력, 캐시 읽기와 쓰기, 출력(적용되는 경우 청구된 추론 토큰 포함), 유료 도구 호출, 인간 리뷰 또는 수정이 포함됩니다. 재시도 비용은 중복 청구가 아니라 실제 사용량을 통해 집계됩니다.
기본 요율로 전부 청구되는 1M 캐시 읽기 토큰의 경우, 두 모델 모두 $0.10입니다; 기본 읽기 가격 차이는 $0.00입니다. 이는 요율 예시이지, 기본 구간에서 가격이 책정된 1M 입력 토큰 Sol 요청을 의미하지는 않습니다. 실제 세션 비용에는 신규 입력, 캐시 쓰기, 출력, 도구, 재시도가 포함됩니다. 적용 가능한 컨텍스트 구간에서 콜드와 웜 세션을 비교하고 승인된 결과율과 함께 청구 사용량을 보고하십시오.
CometAPI Pricing
| Published CometAPI tier | GPT-6.1 Sol API in CometAPI | Claude Sonnet 5.5 API in CometAPI |
|---|---|---|
| Base input / output per 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Base discount vs provider | 20% | 20% |
| GPT long-context input / output | $3.20 / $12.00 | Check current route-specific terms |
| GPT cache reads, base / long | $0.08 / $0.16 | Not specified in the cited basic pricing table |
이는 본 개정에서 확인한 게시된 모델 라우트 가격이며, 제공자 요율과는 별개입니다. GPT-6.1 Sol의 CometAPI 가격은 숏·롱 컨텍스트를 구분합니다. 인용된 Sonnet 기본 표는 입력과 출력만 나열하므로 동일한 게이트웨이 캐시 정책을 가정할 근거는 되지 않습니다. 프로덕션 추정 전에 선택한 라우트의 최신 과금 조건을 확인하십시오.
How Do Context Windows, Speed, and Technical Specs Compare?
GPT-6.1 Sol은 1.05M 토큰을 지원하고, Claude Sonnet 5.5는 1M 토큰을 지원합니다. 명목상 차이는 약 5%에 불과하므로 컨텍스트 용량만으로 대부분의 배포를 좌우하진 않을 것입니다.
GPT-6.1 Sol의 노력 단계는 low, medium, high, xhigh, max이며 기본은 medium입니다. Sonnet 5.5는 적응형 사고를 사용하며 Claude Platform의 기본은 high입니다. 이러한 이름이 동일한 추론 예산을 의미하진 않습니다. 동일한 품질 요구에서 최초 토큰까지의 시간, 출력 처리량, 도구 루프 지연, 종단 간 완료 시간을 별도로 측정하십시오.
Anthropic은 Sonnet 5.5가 Sonnet 5 대비 출력 생성이 30% 이상 빠르다고 보고합니다. 이는 전작 비교로 취급하십시오. 본 문서의 증거는 GPT-6.1 Sol의 보편적 지연 시간을 확립하지 않으며, 현행 모델 간 직접 속도 승자도 확립하지 않습니다. 대화형 작업에서는 최대 설정이 최적 배포 설정이라고 가정하지 말고 동일한 승인 규정에 대해 낮은 노력 설정을 테스트하십시오.
What Matters for Safety, Alignment, and Deployment?
배포 결정은 문서화된 모델 동작과 애플리케이션 제어를 구분해야 합니다. 모델 비교만으로 조직의 데이터 처리 또는 접근 요구를 충족하는 배포를 확립할 수는 없습니다. 실제로 사용하는 제공자 또는 게이트웨이를 평가하십시오. 요청 로깅, 데이터 레지던시, 도구 권한, 실패 처리 등을 포함합니다.
- Reasoning migration: GPT-6.1 Sol은 none 또는 minimal을 지원하지 않습니다. OpenAI의 마이그레이션 가이드는 도구 호출 워크플로를 Responses로 안내합니다.
- Claude tool behavior: Sonnet 5.5의 호환성 변경에는 지원되지 않는 강제 도구 모드와 대화에 묶인 thinking 블록이 포함됩니다. 롤아웃 전에 이러한 경로를 테스트하십시오.
- Operational controls: 에이전트에는 작업에 필요한 도구만 부여하고, 실패한 호출을 기록하며, 중대한 외부 작업에는 인간 검토를 유지하십시오. 이는 애플리케이션 설계 선택이지 어느 모델의 측정된 이점이 아닙니다.
GPT-6.1 Sol vs Claude Sonnet 5.5: Which Should You Choose?
Responses 도구를 이미 사용하거나 예측 가능한 노력 단계를 원한다면 GPT-6.1 Sol을 먼저 테스트하십시오. 잘 범위가 정의된 코딩 반복, 슬라이드, 스프레드시트, 문서 워크플로에서는 보고된 증거가 작업과 일치하는 Sonnet 5.5를 테스트하십시오. 캐시 프리픽스 세션에서는 둘 다 테스트하십시오: 기본 캐시 읽기 요율은 동일하지만, 쓰기 비용, 보존 기간, 롱 컨텍스트 구간, 작업 성공률은 총 청구액을 바꿀 수 있습니다. 대표 평가가 유용한 품질, 비용, 지연 차이를 확립한 후에만 업무를 라우팅하십시오.
Workload-Based Selection
| Workload | Starting point | What to verify |
|---|---|---|
| Existing OpenAI Responses agent | GPT-6.1 Sol | 도구 호환성과 노력 수준 변화 |
| Coding iteration / bug fixing | Sonnet 5.5, then compare Sol | 병합 준비도, 지연과 재시도 |
| Slides / spreadsheets / reports | Sonnet 5.5, then compare Sol | 템플릿 준수와 인간 편집 시간 |
| Stable cached-prefix sessions | Both; equal base cache-read rates | 히트율, 쓰기, 컨텍스트 구간과 승인 품질 |
| Full requests above 272K input | Both | 실제 롱 컨텍스트 청구와 검색 품질 |
| Computer / browser automation | Both | 복구, 작업 완료, 권한 |
| Math / scientific analysis | Both on task-specific tests | 검증 가능한 정답과의 일치 |
| Cost-sensitive production | Both | 승인된 결과당 총 비용 |
프로덕션 비교는 주변 시스템을 일정하게 유지해야 합니다. 동일한 프롬프트, 리포지토리 또는 문서, 도구 권한, 타임아웃, 재시도 정책, 출력 승인 규정을 사용하십시오.
신규 입력, 캐시 쓰기와 읽기, 출력 사용량, 유료 도구 호출, 재시도, 인간 검토 시간, 작업 성공, 종단 간 지연을 기록하십시오. 더 저렴한 첫 응답이 더 비싼 승인 결과를 만들 수도 있습니다.
How Can You Access GPT-6.1 Sol and Claude Sonnet 5.5?
개발자는 문서화된 모델 라우트를 통해 CometAPI의 GPT-6.1 Sol API와 CometAPI의 Claude Sonnet 5.5 API에 접근할 수 있습니다. API 키를 생성하고 안전하게 저장한 뒤, 프로덕션 전에 모델 접근과 라우트별 과금을 확인하십시오.
GPT-6.1 Sol Access
Sol의 경우 도구 호출이 필요하면 문서화된 Responses 라우트를 사용하십시오. gpt-6.1-sol과 지원되는 노력 수준을 선택하고, 기본은 medium입니다. 작업 입력을 전달하고 필요한 도구만 구성한 다음, 반환된 텍스트, 도구 호출, 오류, 사용량을 검증하십시오. 모든 OpenAI 옵션이 사용 가능하다고 가정하지 말고 제공자별 기능에 대한 게이트웨이 지원을 확인하십시오.
Claude Sonnet 5.5 Access
Sonnet의 경우 호환 인터페이스에서 claude-sonnet-5-5를 선택하고 대화 메시지로 작업을 전송하며 적절한 출력 예산을 설정하십시오. 해당 라우트가 기본 thinking과 도구 매개변수를 어떻게 처리하는지 확인하십시오; OpenAI의 reasoning 필드가 Claude 옵션과 자동으로 상호 호환되는 것은 아닙니다. 에이전트 배포 전에 대화 연속성과 오류 처리를 검증하십시오.
엔드포인트 체크는 연결성만 검증하며, 비교 성능을 보장하지 않습니다. 평가에서는 프롬프트, 실효 출력과 추론 예산, 도구, 재시도, 타임아웃, 승인 기준을 정렬한 뒤, 승인된 작업, 지연, 총 청구 비용을 비교하십시오.
Conclusion
GPT-6.1 Sol과 Claude Sonnet 5.5는 동일한 기본 입력, 출력, 캐시 읽기 요율을 공유하며, 유사한 컨텍스트 용량을 갖습니다. Sol은 기존 Responses 에이전트와 명시적 노력 제어에 자연스러운 후보입니다. Sonnet의 적응형 사고와 보고된 코딩·전문 업무 결과는 일상 산출물에 유용한 후보가 됩니다. 캐시 중심 워크플로에서는 전체 세션 비교가 필요합니다: 동일한 기본 읽기 요율은 쓰기, 보존, 롱 컨텍스트, 승인된 작업 비용까지 동일함을 보장하지 않습니다.
품질, 지연, 비용 요구 내에서 실제 작업을 완료하는 모델을 선택하십시오. 전작 점수는 현행 모델 증거와 분리하고, 워크로드가 사용하는 컨텍스트 구간 가격을 반영하며, 두 라우트를 비교한 뒤 기본값을 채택하십시오.
FAQ
Can GPT-6.1 Sol and Sonnet 5.5 share one tool schema?
공통 JSON 도구 정의는 출발점이 될 수 있지만, 엔드포인트 지원, 강제 도구 동작, thinking 블록, 응답 처리가 다릅니다. 각 모델의 도구 호출을 인자, 실패 경로, 대화 연속성에 대한 계약 테스트로 검증하십시오. 텍스트 요청이 성공했다고 해서 에이전트 호환성을 가정하지 말고, 지원되지 않는 옵션은 모델별 어댑터를 유지하십시오.
How should reasoning effort be matched across both models?
동일한 이름의 설정을 동일한 컴퓨트 예산으로 취급하지 마십시오. 승인 규정과 비용 한도 또는 지연 목표를 정의한 뒤, 각 모델에 대해 노력 설정을 스윕하십시오. 재시도와 인간 수정을 포함해 동일한 운영 제약을 충족하는 최적 구성을 비교하십시오. 두 모델의 최고 설정만 비교하지 마십시오.
When should a 1M-context workflow use retrieval instead?
작업이 큰 코퍼스의 작은, 식별 가능한 일부만 필요하고 검색 테스트에서 관련 자료가 일관되게 회수되는 경우 검색을 사용하십시오. 증거가 분산되어 있거나 파일 간 관계가 중요한 경우 전체 컨텍스트 요청을 테스트하십시오. 답변 정확성, 인용 범위, 입력 비용, 지연을 비교하십시오; 큰 컨텍스트 한도만으로 전체 창을 채우는 것이 경제적이거나 신뢰할 수 있다는 근거가 되지 않습니다.
How can teams avoid a misleading cache-cost comparison?
콜드 캐시와 웜 캐시 실행을 별도로 측정하고, 캐시 쓰기뿐 아니라 읽기도 기록하며, 올바른 보존 창과 롱 컨텍스트 구간을 적용하십시오. 공유 프리픽스를 안정적으로 유지하고, 할인된 단일 요청이 아니라 반복되는 현실적 세션을 비교하십시오. 히트율과 총 청구 사용량을 보고하여 겉보기 절약이 재현 가능하도록 하십시오.
What should trigger a new GPT-6.1 Sol vs Sonnet 5.5 evaluation?
배포 업데이트, 제공자 버그 수정, 라우팅 변경, 도구 또는 프롬프트 변경, 실질적 가격 개정 후에는 해당 작업 모음을 재실행하십시오. 평가 날짜, 모델 ID, 엔드포인트, 노력 수준, 하니스 버전을 기록하십시오. 이전 실행을 기준선으로 보존하여 품질 또는 지연 변화를 주변 시스템 변경과 혼동하지 마십시오.