로컬에서 Qwen3.8-Max를 실행하는 것은 이제 가능하지만, “Qwen 3.8 Max 로컬”이라는 표현에는 중요한 주의가 필요합니다. Alibaba의 관리형 Max 제품과 다운로드 가능한 체크포인트는 밀접하게 관련되어 있지만 동일한 제품은 아닙니다.
Qwen은 2026년 8월 초에 관리형 Max 서비스를 먼저 출시했으며, 2026년 8월 12일에 Qwen3.8-2.4T-A95B를 오픈 웨이트로 공개했습니다(https://github.com/QwenLM/Qwen3.8). 이 체크포인트가 실제로 여러분이 자체 인프라에 배포하는 모델입니다.
이 문서는 게이밍 PC에서 Ollama로 돌리는 평범한 튜토리얼이 아닙니다. 비양자화 체크포인트는 2.4조 매개변수의 Mixture-of-Experts 모델이며, 현재 vLLM 레시피는 BF16 가중치 크기를 4.45 TiB로 산정합니다. 프로덕션 지향 4비트 부동소수점 변형도 가중치만 약 1.3–1.5 TiB를 차지합니다.
완전한 Qwen 3.8 Max급 자체 호스팅은 데이터센터급 배포입니다. 실무적인 프로덕션 시작점은 이며, H200 배포는 더 많은 GPU가 필요합니다. 일반 워크스테이션이라면 Qwen3.8-27B를 사용하세요.
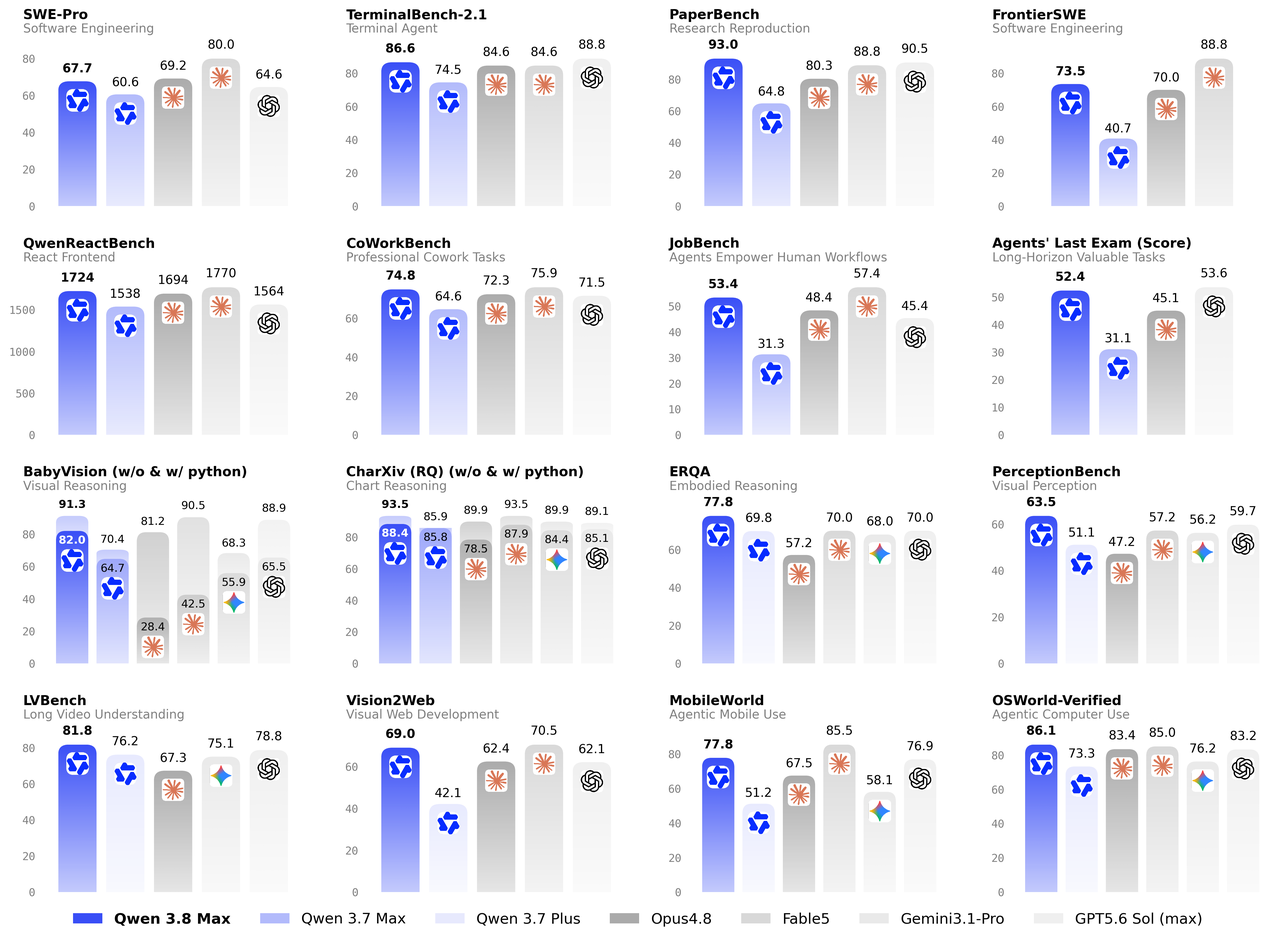
이 하위집합에서 Qwen3.7-Max 대비 가장 큰 향상은 PaperBench와 FrontierSWE입니다. Qwen3.8-Max는 SWE-bench Pro와 PaperBench에서 GPT-5.6 Sol을 능가하며, Terminal Bench 2.1에서는 GPT-5.6 Sol이 앞섭니다. 배포 결정을 위해서는 이를 역량 맥락으로 보되, 아래의 메모리 및 서빙 처리량 측정치가 운영 관점에서 더 중요합니다.
벤치마크 테이블은 보편적 순위표가 아닙니다. 하니스, 타임아웃, 컨텍스트 한도, 도구 접근, 양자화 여부가 결과를 바꿀 수 있습니다. 실제로 사용할 체크포인트, 정밀도, 서빙 엔진, 프롬프트 분포로 벤치마크하세요.
로컬 배포에 필요한 Qwen3.8 하드웨어는?
Qwen3.8-2.4T-A95B의 GPU 요구사항
이것이 핵심 배포 질문입니다. 현재 vLLM Qwen3.8 레시피는 체크포인트 용량과 런타임 헤드룸을 고려한 현실적인 GPU 수를 공개합니다. 이는 단순히 파라미터 수에서 VRAM을 추정하는 것보다 유용합니다.
Precision
Weight footprint
B300 (268 GB)
MI355X (288 GB)
H200 (141 GB)
Best fit
BF16
4.45 TiB
24 GPUs
24 GPUs
48 GPUs
Maximum fidelity / research
FP8
2.27 TiB
16 GPUs
16 GPUs
32 GPUs
High-fidelity production
MXFP4
1.45 TiB
—
8 GPUs
16 GPUs
Practical AMD deployment
NVFP4 W4A4
1.32 TiB
8 GPUs
—
16 GPUs
Practical NVIDIA deployment
대부분의 자체 호스팅 수요가 있는 조직에서는 FP4가 실질적인 시작점입니다. NVIDIA 측의 대표 구성은 8× B300에서의 NVFP4 W4A4이며, AMD 측의 대응 경로는 8× MI355X에서의 MXFP4입니다.
8× H200 서버로는 이러한 권장 풀모델 배포에 충분하지 않습니다. 공식 레시피는 H200에 대해 FP4는 16개, FP8은 32개, BF16은 48개의 GPU를 제시합니다.
Qwen3.8-27B의 VRAM 요구사항
Qwen3.8-27B는 실질적인 워크스테이션급 대안입니다. 순수 가중치 메모리는 BF16에서 약 54 GB, FP8에서 27 GB, 4비트 정밀도에서 13.5 GB 정도입니다. 런타임 오버헤드와 KV 캐시로 실제 요구량은 늘어나며, 특히 긴 컨텍스트에서 그렇습니다.
Precision
Approximate weight memory
Practical deployment guidance
BF16
~54 GB
컨텍스트와 서빙 오버헤드에 따라 64–80 GB GPU 권장.
FP8 / INT8
~27 GB
40–48 GB GPU가 더 실용적인 런타임 헤드룸을 제공합니다.
4-bit
~13.5 GB
중간 컨텍스트 길이라면 20–24 GB 소비자 GPU에서도 가능할 수 있습니다.
이 수치는 파라미터 수에서 도출한 계획용 추정치입니다. 프로덕션 하드웨어를 사이징하기 전, 실제 체크포인트, 양자화 형식, 서빙 엔진, 컨텍스트 길이, KV 캐시 설정을 확인하세요.
Qwen3.8을 소비자용 GPU에서 실행할 수 있나요?
풀사이즈 Qwen3.8-2.4T-A95B는 공격적으로 양자화하더라도 일반 소비자 GPU에서는 현실적이지 않습니다. 커뮤니티 프로젝트에서 4대의 DGX Spark 시스템에 걸쳐 397 GB UD-Q1_0의 극단적 압축 빌드를 시연하긴 했지만, 이는 품질 민감 서빙의 기준선이 아니라 실험적 극한 양자화 경로입니다.
워크스테이션이나 홈랩에는 2026년 8월 14일에 오픈 웨이트로 공개된 Qwen3.8-27B가 더 적합합니다. 호스팅 난이도가 몇 자릿수 낮으며, “로컬”이 한 대의 워크스테이션을 의미한다면 이 모델이 올바른 선택입니다.
Qwen 3.8 Max 설치 전 준비 사항
설치 명령을 실행하기 전에 인프라를 설계하세요. Linux, 호환 가속기 스택, 체크포인트를 위한 충분한 로컬/공유 스토리지, 고대역폭 GPU 인터커넥트, 노드를 넘나드는 경우 분산 추론을 위한 네트워크가 필요합니다. vLLM 레시피는 현재 vLLM nightly와 Transformers 5.4.0 이상을 권장합니다.
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
높은 동시성에서는 Qwen3.8이 512개의 라우팅 익스퍼트를 가지므로 Expert 병렬 레이아웃의 이점을 봅니다. vLLM은 FP8 EP에서 GPU당 최대 3,200 total tok/s, 최적화된 NVFP4 DEP16 구성에서 GPU당 최대 4,300 total tok/s를 보고합니다.
VRAM과 동시성 균형을 위해 --max-model-len 설정
--max-model-len을 워크로드가 진짜로 요구하는 최장 시퀀스에 맞추세요. 더 큰 값은 더 많은 KV 캐시를 예약해 메모리 압박을 높이고, 모델 가중치가 이미 맞더라도 동시 요청 수를 줄일 수 있습니다.
모델이 광고하는 최대 컨텍스트 대신, 실제 프로덕션 백분위에 기반해 시작하세요. 프로덕션에서 사용할 동일한 정밀도, 배치 패턴, 서빙 엔진으로 부하 테스트한 뒤, 실제 요청이 더 긴 컨텍스트를 필요로 할 때만 상향하세요.
Qwen 3.8 Max 로컬 배포 vs. API
오픈 웨이트라고 해서 자동으로 로컬 추론이 경제적이 되는 것은 아닙니다. 올바른 선택은 활용도, 데이터 레지던시, 인력, 가용성 목표, 그리고 관리형 모델의 멀티모달 기능이 실제로 필요한지 여부에 달려 있습니다.
Dimension
Self-hosted Qwen3.8-2.4T-A95B
Qwen3.8-Max via CometAPI
Infrastructure
다중 GPU 서버 또는 클러스터
GPU 인프라 불필요
Input modality
Text
Text, image, video
Context
262K 기본; ~1.01M로 확장 가능
관리형 1M
Data control
최대
클라우드 API
Operations
모니터링, 업그레이드, HA를 직접 책임
제공자 관리
Best fit
데이터 레지던시, 지속적 활용, 인프라 팀 보유
대부분의 앱 팀, 가변 워크로드
이미 적합한 가속기를 보유하고 있고 활용도가 지속적으로 높다면 자체 호스팅이 타당할 수 있습니다. 이 모델만을 위해 클러스터를 새로 구매해야 한다면, 보통은 CometAPI의 Qwen3.8-Max가 마찰이 더 적은 경로입니다. 기존 API 가이드는 관리형 통합을, 가격 가이드는 비용 모델링을 다루므로, 본 문서는 로컬 배포에 집중합니다.
Qwen 3.8 로컬 배포의 흔한 문제
시작 중 서버가 GPU 메모리 부족으로 종료됨
캐시 이슈라면 먼저 --max-model-len을 줄이세요. 가중치 자체가 맞지 않는다면 컨텍스트 축소로 근본 원인은 해결되지 않습니다. 검증된 더 낮은 정밀도 체크포인트로 전환하거나 GPU를 추가하세요.
텐서 병렬화 크기 오류로 실패함
Qwen3.8에는 풀어텐션 레이어에 64개의 어텐션 헤드가 있으므로, vLLM은 TP가 64를 나눠야 한다고 요구합니다. 간단한 TP 크기는 1, 2, 4, 8, 16, 32입니다. 단순 합산 VRAM만으로 토폴로지를 정할 수 없습니다.
서버 시작에 시간이 오래 걸림
수 TB의 가중치 로딩과 커널 JIT에는 수분이 걸릴 수 있습니다. VLLM_ENGINE_READY_TIMEOUT_S를 늘리고, 짧은 시작 시간을 가정하기보다 실제 추론 엔드포인트를 프로빙하세요.
로컬 모델이 이미지를 처리하지 못함
그렇습니다. Qwen3.8-2.4T-A95B 오픈 체크포인트는 텍스트 전용입니다. 이 제한은 Qwen3.8-2.4T-A95B에 특화된 것입니다. Qwen3.8-27B는 별도의 비전 프로젝션 파일을 로드하면 시각 입력을 지원합니다.
1M 컨텍스트로 처리량이 급감함
--max-model-len을 워크로드가 실제로 필요로 하는 최대 길이로 줄이세요. 지원되는 최대 컨텍스트 창이 최적의 프로덕션 설정을 의미하지는 않습니다. 워크로드 요구, KV 캐시 사용, 동시성의 균형을 맞춘 컨텍스트 한도를 선택하세요.
Ollama나 LM Studio로 Qwen 3.8 Max를 실행할 수 있나요?
에코시스템은 라마.cpp 스타일 추론을 위해 강하게 양자화된 Qwen3.8 가중치를 패키징할 수 있지만, 이를 일반 데스크톱의 정상적인 Ollama 워크플로와 혼동해서는 안 됩니다. 수백 GB를 차지하는 양자화 빌드는 여전히 수백 GB의 접근 가능한 메모리를 필요로 하며, 품질과 성능에서 상당한 트레이드오프를 수반합니다.
일반적인 로컬 개발에는 Qwen3.8-27B가 적절한 대상입니다. 극단적인 커뮤니티 양자화로 비정상적 하드웨어에서 기술적으로 부팅 가능하더라도, 2.4T 풀모델은 서버/클러스터 모델로 취급해야 합니다.
어떤 배포 방법을 선택해야 하나요?
NVIDIA Blackwell에서는 8× B300 NVFP4 배포가 현재 가장 깔끔한 풀모델 시작점입니다. AMD에서는 8× MI355X의 MXFP4가 대응되는 실용적 구성입니다. 체크포인트 출처와 품질을 인프라 규모보다 우선한다면 FP8을, 최대 충실도가 다중 랙급 메모리 요구를 정당화할 때만 BF16을 사용하세요.
워크스테이션에는 Qwen3.8-27B를 사용하세요. GPU 클러스터 운영 없이 Max 기능이 필요한 애플리케이션 팀이라면 관리형 CometAPI의 Qwen3.8-Max 모델을 사용하세요.
결론
Qwen3.8-Max는 초기 API 출시 이후 중요한 경계를 넘어섰습니다. 이제 조직이 자체 인프라에서 완전히 운영할 수 있는 2.4T 오픈 체크포인트가 등장했습니다.
하지만 오픈 웨이트가 곧 소비자 하드웨어를 의미하는 것은 아닙니다. 4.45 TiB의 BF16 풋프린트, 2.27 TiB FP8 체크포인트, 1.3–1.5 TiB FP4 변형은 Qwen3.8-2.4T-A95B를 가장 인프라 집약적인 오픈 모델 중 하나로 만듭니다. 실무적 측면에서는 vLLM과 SGLang이 이미 아키텍처를 지원하고, FP4 덕분에 1노드 8× B300 또는 8× MI355X 배포가 가능하다는 점이 장점입니다.
데이터 통제, 지속적 활용, 인프라 소유가 클러스터를 정당화할 때 자체 호스팅을 선택하세요. 그렇지 않다면 관리형 Max API를 사용하거나, 한 대 워크스테이션에서 강력한 Qwen 모델이 필요하다면 Qwen3.8-27B를 사용하세요.