TL;DR
MiMo-V2.6는 Xiaomi의 새로운 오픈 가중치, 네이티브 멀티모달, 에이전트 지향 추론 모델 패밀리이다. MiMo-V2.6-Pro는 총 1.02조 파라미터의 희소 MoE 설계를 사용하며 토큰당 약 420억 파라미터가 활성화되고, MiMo-V2.6-Flash는 총 3,090억 파라미터에 토큰당 약 150억 파라미터가 활성화된다. 두 모델 모두 100만 토큰 컨텍스트 윈도우와 텍스트, 이미지, 비디오, 오디오를 포함한 멀티모달 입력을 지원한다.
Key Takeaways
- MiMo-V2.6-Pro는 토큰당 약 420억 활성 파라미터를 갖는 1.02조 파라미터의 희소 MoE 모델이며, Flash는 총 3,090억/활성 약 150억 파라미터를 사용한다.
- 두 모델 모두 100만 토큰 컨텍스트 윈도우, 멀티모달 입력, 그리고 Xiaomi API를 통한 최대 12.8만 출력 토큰을 지원한다.
- 이 패밀리는 추론, 도구 사용, 웹 검색, 구조화된 출력, 장기 지평 에이전트 워크플로를 위해 설계되었다.
- Xiaomi는 V2.6을 코딩, 일반 에이전트, 비주얼 작업, 사이버보안 환경에 걸친 혼합 강화학습으로 학습했다고 밝혔다.
- 공식 결과는 Pro가 더 높은 역량, Flash가 더 낮은 비용의 대량 처리 옵션임을 시사하지만, 워크로드별 평가가 여전히 필요하다.
What Is Xiaomi MiMo-V2.6?
MiMo-V2.6는 Xiaomi의 MiMo 모델 패밀리 최신 세대이다. 초점은 더 나은 답변을 생성하는 데 그치지 않고 장기적인 일련의 행동을 실행하는 데 있다: 환경을 점검하고, 도구를 호출하며, 결과를 관찰하고, 오류를 수정하며, 목표가 완료될 때까지 계속한다. Xiaomi는 이 릴리스를 Recursive Self-Improvement (RSI)로 표현하는데, 이는 모델이 반복적으로 환경을 탐색하고, 더 풍부한 보상 신호를 받고, 궤적을 비교하며, 더 효과적인 전략을 학습하는 강화학습 루프를 의미한다. 이는 모델이 자율적으로 자신의 후속 모델을 재작성하고 학습한다는 의미로 해석되어서는 안 된다.
Pro vs Flash vs UltraSpeed: 무엇이 다른가
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positioning | 플래그십 추론 | 대량/가성비 | 저지연 플래그십 |
| Total parameters | 1.02T | 309B | 동일 Pro 모델 |
| Active parameters | 42B | 15B | 동일 Pro 역량 |
| Architecture | 희소 MoE | 희소 MoE | Pro 서빙 모드 |
| Context | 1M | 1M | 1M |
| Max output | 128K | 128K | 128K |
| Text / image / video / audio input | Yes | Yes | Yes |
| Deep reasoning / tool calling | Yes | Yes | Yes |
| Structured output / context caching | Yes | Yes | Yes |
| Main advantage | 최대 역량 | 비용 효율 | 최대 20배 빠른 서빙 |
MiMo-V2.6-Pro 또는 Flash: 어느 것을 써야 하나?
실용적인 선택: 어려운 장기 지평 엔지니어링, 연구, 사이버보안, 고가치 에이전트 작업에는 MiMo-V2.6-Pro를, 대량 자동화, 문서 및 멀티모달 처리, 비용 민감한 반복 호출에는 MiMo-V2.6-Flash를, Pro 수준의 추론이 필요하지만 지연이 지배적인 상황에는 MiMo-V2.6-Pro-UltraSpeed를 선택하라. UltraSpeed는 별도의 역량 모델이 아니라 서빙 계층이며, 표준 Pro 대비 최대 20배의 출력 속도를 표방한다.
How Does Xiaomi MiMo-V2.6 Work?
희소 Mixture-of-Experts 아키텍처
MiMo-V2.6는 매 토큰마다 전체 파라미터를 활성화하지 않는다. 플래그십 Pro 체크포인트는 총 1.02조 파라미터를 포함하지만, 토큰당 활성화되는 파라미터는 약 420억 수준이다. Xiaomi의 모델 카드에 따르면 70개의 Transformer 레이어, 384개의 라우팅된 전문가, 동시에 8개의 전문가가 활성화된다고 한다. Flash는 총 3,090억/활성 150억으로 상당히 더 작으며, 48개의 Transformer 레이어와 256명의 라우팅된 전문가를 갖는다.
| Architecture specification | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Total parameters | 1.02T | 309B |
| Activated parameters | 42B | 15B |
| Transformer layers | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Routed experts | 384 | 256 |
| Experts activated | 8 | 8 |
| Maximum context | 1M | 1M |
| MiMo ViT | 681M params | 681M params |
| AudioTokenizer | 308M params | 308M params |
| Audio patch encoder | 127M params | 127M params |
| Speculative decoder | 5 layers | 5 layers |
이 아키텍처는 슬라이딩-윈도우 어텐션과 글로벌 어텐션 레이어를 결합하고, 5-레이어의 멀티-토큰-프리딕션 스페큘레이티브 디코더를 포함한다. 실질적 함의는 헤드라인 파라미터 수와 토큰당 연산량이 매우 다른 양이라는 점이다: 희소 라우팅은 매 토큰마다 모든 가중치에 대해 촘촘한 추론을 수행하지 않고도 큰 전문가 풀을 유지할 수 있게 한다.
네이티브 멀티모달 이해
MiMo-V2.6는 비주얼 인코딩을 위해 Xiaomi의 6.81억 파라미터 MiMo ViT를 사용하며, 전용 오디오 구성요소와 함께 동작한다. 이를 통해 동일한 에이전트가 텍스트 지시, 스크린샷, 사진, 비디오, 오디오를 처리할 수 있다. 컴퓨터 사용 에이전트의 경우, 네이티브 멀티모달리티는 인식과 의사결정이 분리된 사용자 지향 모델로 나뉘지 않고 동일한 추론 루프 내에서 일어날 수 있다는 점에서 중요하다.
Why Is Reinforcement Learning So Important to MiMo-V2.6?
Xiaomi는 Flash와 Pro 모두가 6일간의 공개 학습 실험에서 약 30회 RL 스텝과 약 75만 개의 궤적을 거쳤다고 보고한다. 보고된 학습 비용은 Flash 약 $850,000, Pro 약 $2.62 million이다. 각 업데이트는 1,568개의 학습 샘플을 사용했으며, 개별 학습 스텝은 대략 35억~37억 토큰에 도달했다. 작업 혼합은 코드, 일반 에이전트, 비주얼 작업, 사이버보안, 다수의 에이전트 하니스에 걸쳐 있었다.
이 RL 과정에서 Xiaomi는 샘플 외부 DeepSWE v1.1 점수가 Flash는 48.8에서 65.7로, Pro는 58.4에서 72.6으로 상승했다고 보고한다. 이 수치들은 라이브 RL 실험을 설명하는 것이며, 공개된 체크포인트의 모든 최종 벤치마크 점수와 혼동되어서는 안 된다. 평가 설정이 다를 수 있기 때문이다.
그룹 단위 에이전트 채점
에이전트 학습에서 이진 통과/실패 보상은 두 개의 성공 궤적 사이의 의미 있는 차이를 숨길 수 있다. 한 해법은 도구 호출 몇 번으로 신속히 끝낼 수 있고, 다른 해법은 수십 단계가 소요될 수 있다. 이에 Xiaomi는 Groupwise Reward Synthesis and Groupwise Advantage Redistribution을 그룹 내 궤적을 비교하고 더 깔끔한 해법으로 학습 신호를 재분배하는 메커니즘으로 설명한다. 목표는 과제 완료뿐 아니라 경로의 효율성까지 개선하는 것이다.
How Good Is Xiaomi MiMo-V2.6 on Agent Benchmarks?
V2.6에 대한 가장 강한 공개 증거는 전통적인 객관식 시험보다는 에이전트 벤치마크에 집중되어 있다. Xiaomi의 공식 차트는 Pro와 Flash를 MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol, Fable 5와 함께 코딩, 일반 에이전트, 사이버보안, 비주얼 에이전트 작업 전반에서 비교한다.
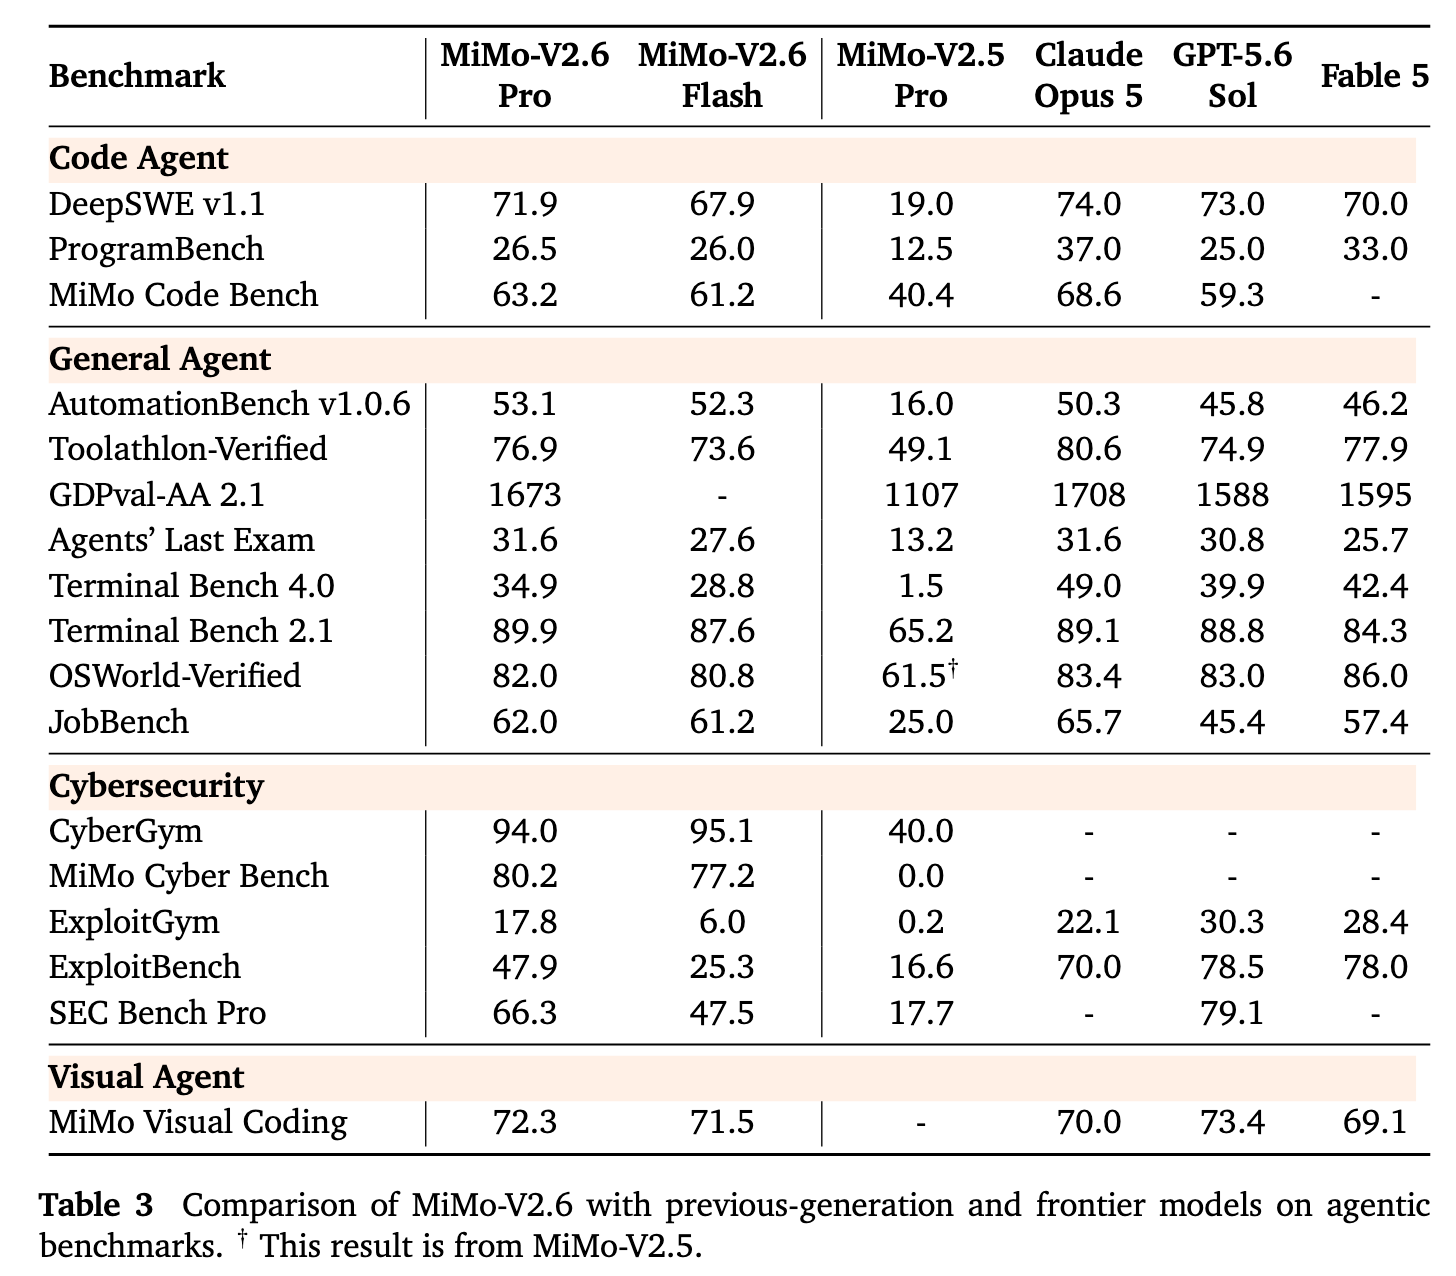
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Coding Progress
코딩 향상은 장기 실행에서 가장 뚜렷하다. 라이브 RL 런 동안 Xiaomi는 샘플 외부 DeepSWE v1.1이 Flash에서 48.8→65.7, Pro에서 58.4→72.6으로 개선되었다고 보고한다. 공개된 교차-모델 표에서는 Pro가 DeepSWE v1.1에서 71.9, MiMo Code Bench에서 63.2를 기록하고, Flash는 각각 67.9와 61.2를 기록한다. Pro가 모든 코딩 테스트에서 우승하지는 않는다—Claude Opus 5는 DeepSWE, ProgramBench, MiMo Code Bench에서 여전히 앞서 있다—그러나 V2.6는 경쟁적인 리포지토리 규모 성능을 오픈 가중치와 상당히 낮은 API 가격과 결합한다.
Reasoning and Agentic Progress
추론의 진전은 단일한 추상 지능 점수보다는 향상된 계획, 도구 사용, 복구로 이해하는 것이 더 적절하다. Pro는 Terminal Bench 2.1에서 89.9, AutomationBench에서 53.1, Toolathlon-Verified에서 76.9를 기록한다; Flash는 각각 87.6, 52.3, 73.6이다. Pro는 표에 제시된 Claude Opus 5와 GPT-5.6 Sol 결과를 Terminal Bench 2.1에서 약간 상회하며, 두 V2.6 모델 모두 AutomationBench에서 이 비교자들을 앞선다. Xiaomi는 그룹별 궤적 비교, 더 풍부한 채점기, 멀티 하니스 학습, 더 짧고 깔끔한 해법 경로를 선호하는 보상 신호에 개선의 공을 돌린다.
Knowledge and Research Progress
지식 집약적 진전은 전통적인 지식 시험보다는 에이전트 평가와 데모로 더 많이 뒷받침된다. Pro는 Agents' Last Exam에서 31.6으로 Claude Opus 5와 동일하며, JobBench에서 62.0에 도달한다. Xiaomi는 또한 문헌 및 특허 검색, 가설 생성, 계산적 스크리닝을 포함한 재료 연구 워크플로와 6,000줄을 초과하는 Lean 4 정형화 프로젝트를 보고한다. 이러한 사례는 더 강한 검색, 종합, 형식 추론, 도구 기반 지식 작업을 시사하지만, 보편적 지식 우월성의 독립적 증거로 간주되어서는 안 된다.
Overall: V2.6의 진전은 폭넓지만 고르지 않다. 장기 지평 코딩과 에이전트 실행에서의 개선 증거가 가장 강하며, 일반 추론과 지식에 대한 주장은 특정 벤치마크, 하니스, 데모에 묶여야 한다.
Benchmark note: 별도 언급이 없는 한, 아래 교차-모델 결과는 Xiaomi가 MiMo-V2.6 모델 카드에서 보고한 것이다. 점수는 벤치마크 버전, 에이전트 하니스, 도구 구성, 추론 예산, 평가 프로토콜에 따라 달라질 수 있으므로, 독립적으로 재현된 순위로 해석되어서는 안 된다.
MiMo-V2.6 vs MiMo-V2.5: 무엇이 달라졌나?
| Dimension | MiMo-V2.5 generation | MiMo-V2.6 breakthrough |
|---|---|---|
| Training focus | 강력한 멀티모달 에이전트, 긴 컨텍스트, 토큰 효율성 | 코드, 일반 에이전트, 비전, 사이버보안, 다중 하니스에 걸친 훨씬 큰 혼합 RL 프로그램 |
| Agent capability | V2.5-Pro는 어려운 장기 지평 작업을 목표 | Xiaomi는 V2.6-Flash가 자사 에이전트 벤치마크 모음에서 V2.5-Pro를 전반적으로 능가한다고 보고 |
| Learning efficiency | 이전 프로덕션 체크포인트 | 약 30회 RL 스텝 동안 약 75만 궤적; 학습 중 Flash 약 17포인트, Pro 약 14포인트의 샘플 외부 DeepSWE 상승 |
| Openness | 오픈 가중치와 생태계 지원 | 전체 RL 코드, 7,000+ 작업 환경, 학습 프레임워크, 경량 하니스, 9B 디스틸 체크포인트 추가 |
| Economics | 기존 V2.5 API 가격대 | 동일 공식 API 가격에서 더 높은 보고 지능, 역량-비용 프런티어를 바깥으로 이동 |
코딩 및 에이전트 실행
V2.5 대비 가장 뚜렷한 변화는 더 긴 컨텍스트 윈도우가 아니라 더 강한 에이전트 정책이다. Xiaomi는 V2.6-Flash가 자사 에이전트 벤치마크 모음 전반에서 V2.5-Pro를 능가한다고 보고한다. V2.6 학습 런 중 샘플 외부 DeepSWE v1.1은 Flash 48.8→65.7, Pro 58.4→72.6으로 개선되었다; 이 학습 런 점수는 위의 공개 모델 벤치마크 표와 직접적으로 상호 교환되지 않는다.
추론, 지식, 학습 폭
V2.6는 코드, 일반 에이전트, 비전, 사이버보안, 다중 하니스에 걸쳐 강화학습을 확장한다. Xiaomi는 약 30회 RL 스텝에 걸쳐 약 75만 궤적을 보고한다. 이는 더 넓은 계획, 도구 사용, 복구를 지원하지만, 그 자체로 모든 지식 또는 추론 벤치마크에서의 보편적 향상을 입증하지는 않는다; 일치하는 과제와 평가 설정을 비교하라.
마이그레이션과 개방성
이번 릴리스는 RL 코드, 7,000개 이상의 작업 환경, 학습 인프라, 9B 디스틸 체크포인트도 추가한다. 100만 토큰 컨텍스트와 멀티모달 입력은 V2.5에서 이어진 것으로, V2.6의 새로운 돌파구는 아니다.
따라서 실질적 변화는 새로운 컨텍스트 범위가 아니라—100만 컨텍스트와 완전한 멀티모달리티는 이미 V2.5에 있었다—훨씬 더 많은 강화학습 연산과 더 넓은 검증 가능한 환경으로 학습된 더 강한 에이전트 정책이다. Xiaomi는 V2.5와 V2.5-Pro 모델명이 2026년 10월 21일에 더 이상 작동하지 않는다고 발표했으므로, 신규 배포는 V2.6을 대상으로 하고 기존 배포는 마이그레이션 테스트를 계획해야 한다.
V2.6는 다른 프런티어 모델과 어떻게 비교되는가
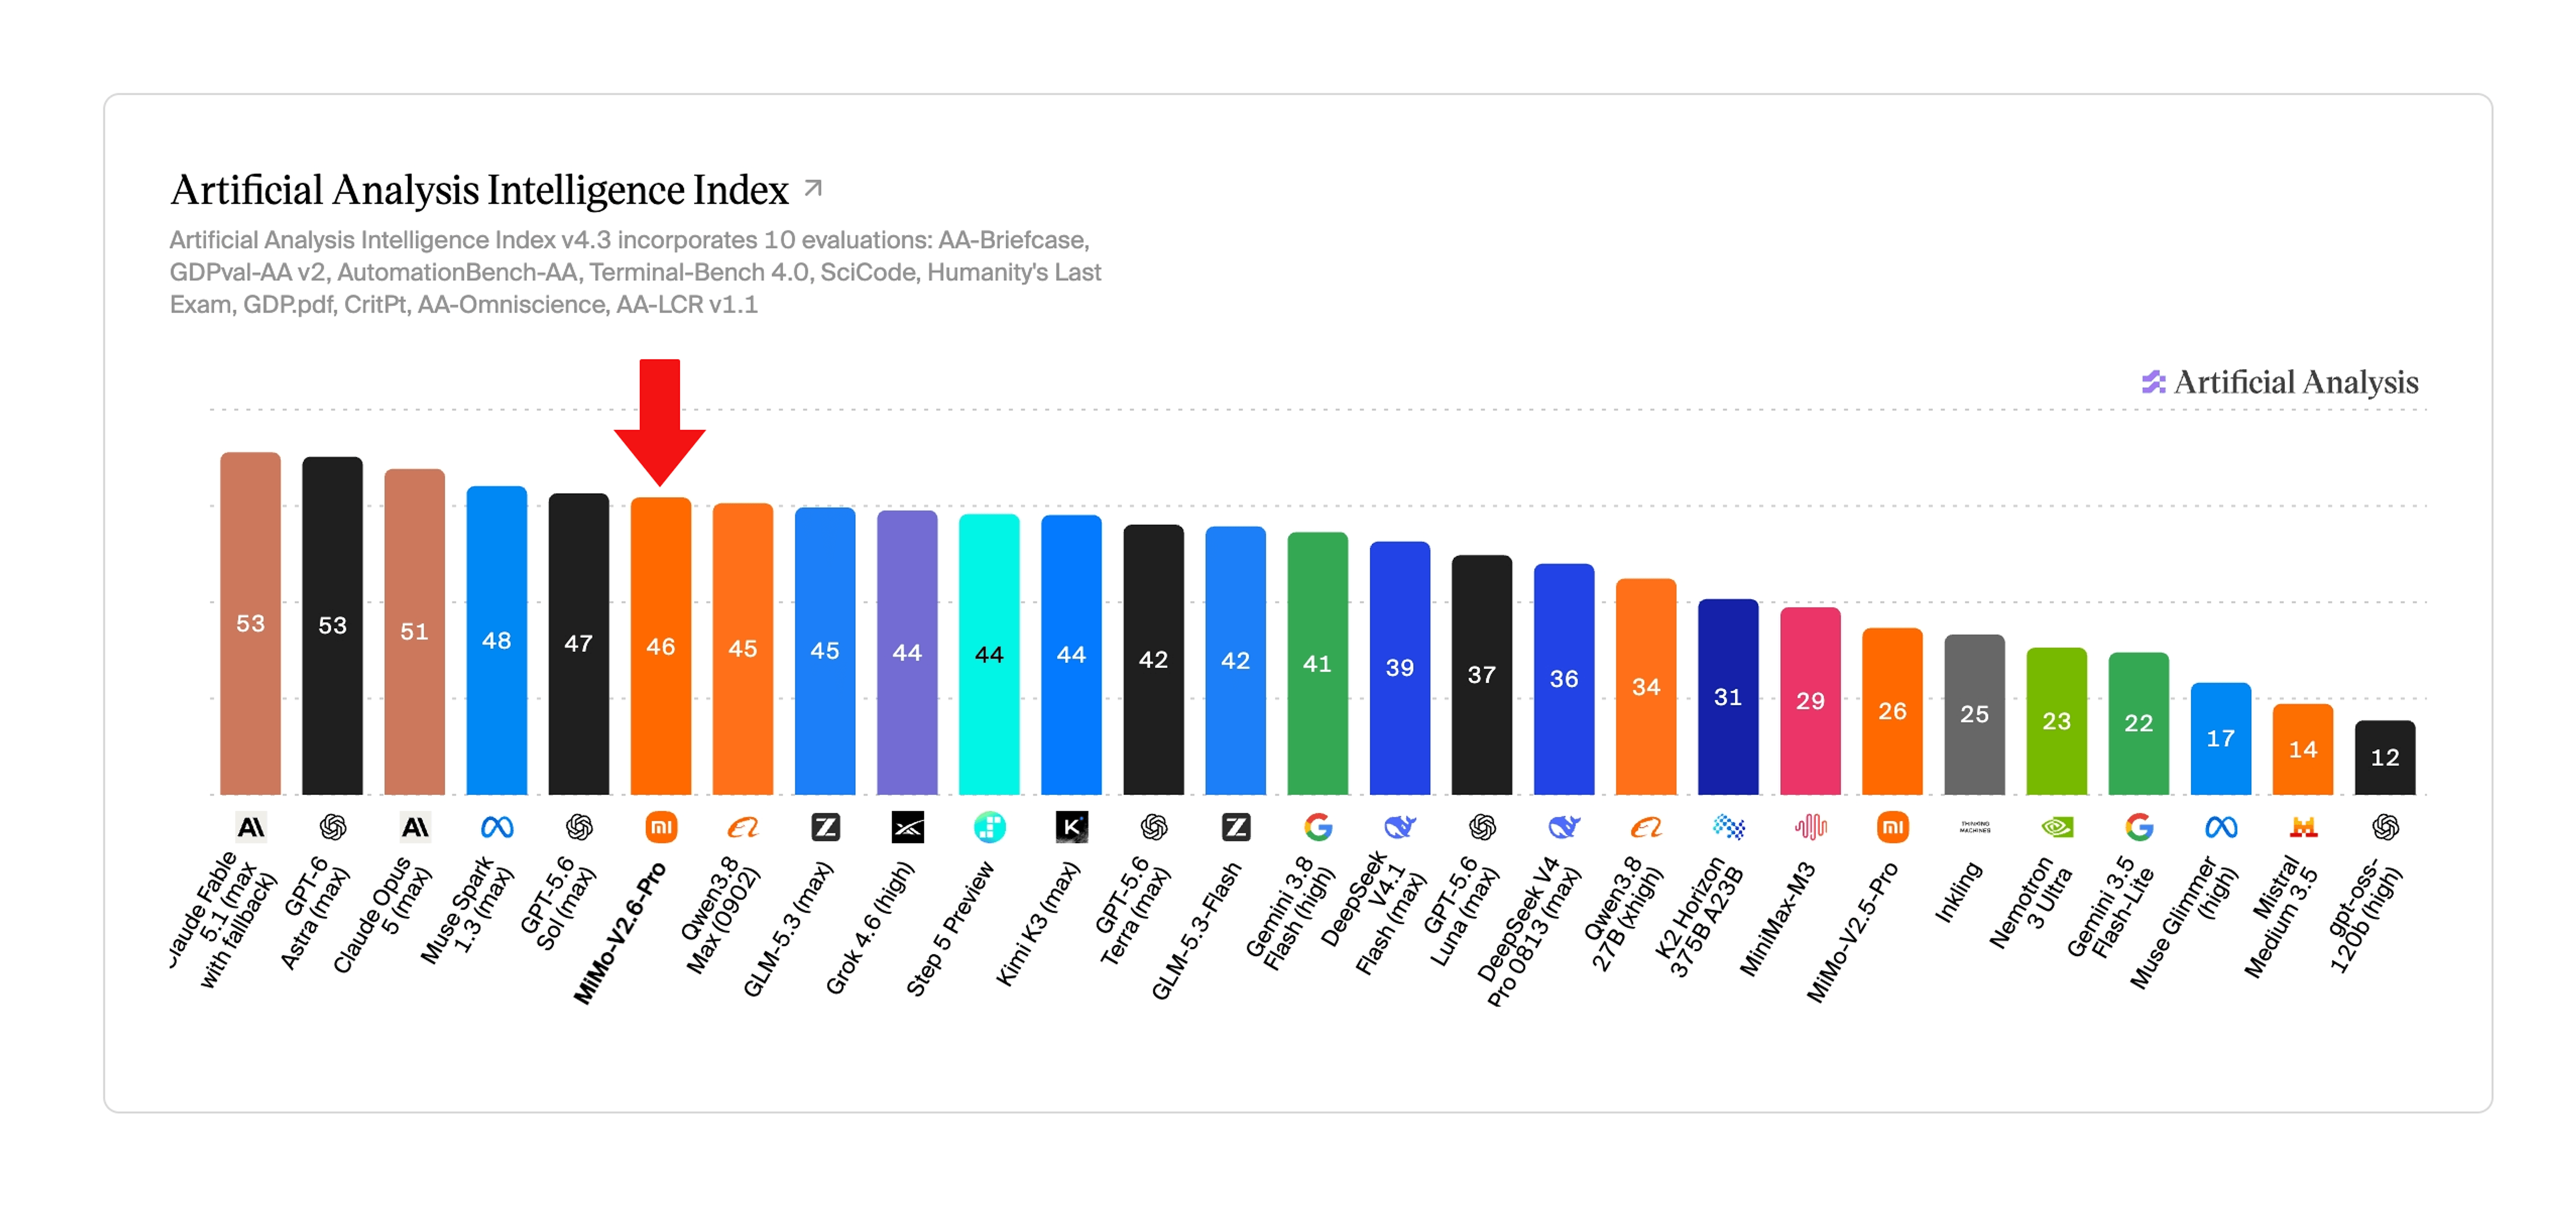
| Dimension | MiMo-V2.6-Pro | Closed frontier models | Other open-weight models |
|---|---|---|---|
| Weights | 오픈 가중치 | 대개 비공개 | 모델별 상이 |
| Verified MiMo context | 100만 토큰 | 각 공식 모델 페이지 확인 | 각 공식 모델 카드 확인 |
| Verified MiMo modalities | 텍스트, 이미지, 비디오, 오디오 | 제공자별 의존 | 모델별, 체크포인트별 |
| Agent-focused RL | 강한 릴리스 강조 | 모델/시스템에 따라 다름 | 모델 및 체크포인트에 따라 다름 |
| Self-hosting | 가능, 상당한 인프라 필요 | 일반적으로 불가 | 오픈 체크포인트의 경우 종종 가능 |
| Primary MiMo advantage | 오픈 가중치, 네이티브 멀티모달리티, 낮은 API 비용 | 제공자 생태계와 관리형 툴링 | 라이선스, 규모, 배포 스택에 따라 다름 |
최신 비교 세트를 위해, 장시간 에이전트 코딩에는 Claude Opus 5.5, 가장 어려운 자율 작업에는 Claude Fable 5.1, GPT-6 Sol, Gemini 4 Pro와 MiMo-V2.6를 비교하라. 모델 가용성과 가격은 동적이므로, 프로덕션 비교는 라이브 카탈로그와 일치된 프롬프트, 도구, 노력 예산, 승인 기준을 사용해야 한다.
What Can Xiaomi MiMo-V2.6 Actually Do?
코딩 및 소프트웨어 엔지니어링 에이전트
MiMo-V2.6는 리포지토리 점검, 코드 수정, 터미널 도구 사용, 테스트 실행, 실패 진단, 목표 충족까지 계속하는 장기 소프트웨어 엔지니어링 궤적을 위해 설계되었다. DeepSWE, Terminal Bench, AutomationBench, Toolathlon 결과는 Xiaomi가 단순 코드 완성보다 실행 최적화에 초점을 맞추고 있음을 시사한다. 실무 워크로드에는 코딩 에이전트, 자동 디버깅, 리포지토리 리팩터링, CI 이슈 해결, 다중 도구 엔지니어링 워크플로가 포함된다.
컴퓨터 사용
Xiaomi는 명시적으로 Computer Use Agent (CUA)를 시연한다. 이 모델은 그래픽 인터페이스를 해석하고, 정보를 검색하며, 콘텐츠를 편집하고, 데이터를 처리하고, 결과를 점검하고, 문제를 진단하며, 시각적 피드백에 기반해 이후 행동을 변경할 수 있다. 이 워크플로에서 모델 출력은 종종 최종 산출물이 아니며, 대신 다음 소프트웨어 또는 브라우저 행동을 결정할 수 있다.
3D 세계와 Blender 워크플로
"Vibe World" 개념 하에, MiMo-V2.6는 텍스트, 이미지, 비디오 참조를 받아 3D 요청을 장면 구성, 상호작용 프로그래밍, 시각적 검증 작업으로 분해할 수 있다. Xiaomi는 또한 모델이 Blender를 제어해 설명이나 참조 이미지로부터 3D 객체와 장면을 생성하는 것을 시연한다. 이는 바이브 코딩을 애플리케이션 코드를 넘어 상호작용 환경으로 확장한다.
로보틱스 및 실체화 에이전트
Xiaomi는 다중 뷰 카메라 이미지와 Franka Panda 로봇 팔을 사용하는 실체화 시뮬레이션 환경에서 MiMo-V2.6를 시연한다. 예시 과제에는 물체 파지, 색상 매칭, 정밀 배치가 포함된다. 이는 V2.6가 보편적 로보틱스 기반 모델임을 입증하는 것은 아니지만, 네이티브 비전과 장기 지평 의사결정이 실체화 제어 루프에 연결될 수 있음을 보여준다.
과학 연구 및 형식적 추론
Xiaomi는 PFAS 흡착을 위한 금속-유기 골격(MOF)에 관해 문헌/특허 검색, 후보 제안, 계산 도구 호출을 포함해 MiMo-V2.6-Pro가 연구자들을 지원한 재료 과학 사례를 보고한다. 다른 실험에서는 모델이 Lean 4에서 "Period Three Implies Chaos"의 주요 정리를 정형화하는 데 도움을 주었다. Xiaomi는 6,000줄 이상의 Lean 코드 프로젝트가 미증명 플레이스홀더 없이 Lean 커널에 의해 검증되었다고 보고한다. 이러한 예시는 에이전트형 연구 워크플로의 시연으로 해석하는 것이 적절하며, 자율 과학적 발견의 증거로 취급되어서는 안 된다.
웹사이트, 프레젠테이션, 비디오, 음악
MiMo-V2.6는 프론트엔드 코딩, 디자인 워크플로, 슬라이드, SVG 자산, 비디오 파이프라인, 음악 제작 도구를 조율할 수 있다. Xiaomi는 V2.6 자체가 모든 이미지, 비디오, 오디오 생성기를 대체한다고 주장하기보다는, MiMo-V2.5-TTS를 통한 내레이션을 포함해 특화된 미디어 시스템과의 오케스트레이션을 시연한다. 따라서 이 모델은 창작 제작 오케스트레이터로 자연스럽게 맞는다.
본 섹션의 사용 사례는 Xiaomi의 데모이며, 모든 배포에서 동일 결과가 재현된다는 독립적 증거가 아니다. 프로덕션 팀은 자체 도구, 권한, 실패 복구, 평가 기준으로 모델을 테스트해야 한다.
How Much Does Xiaomi MiMo-V2.6 Cost?
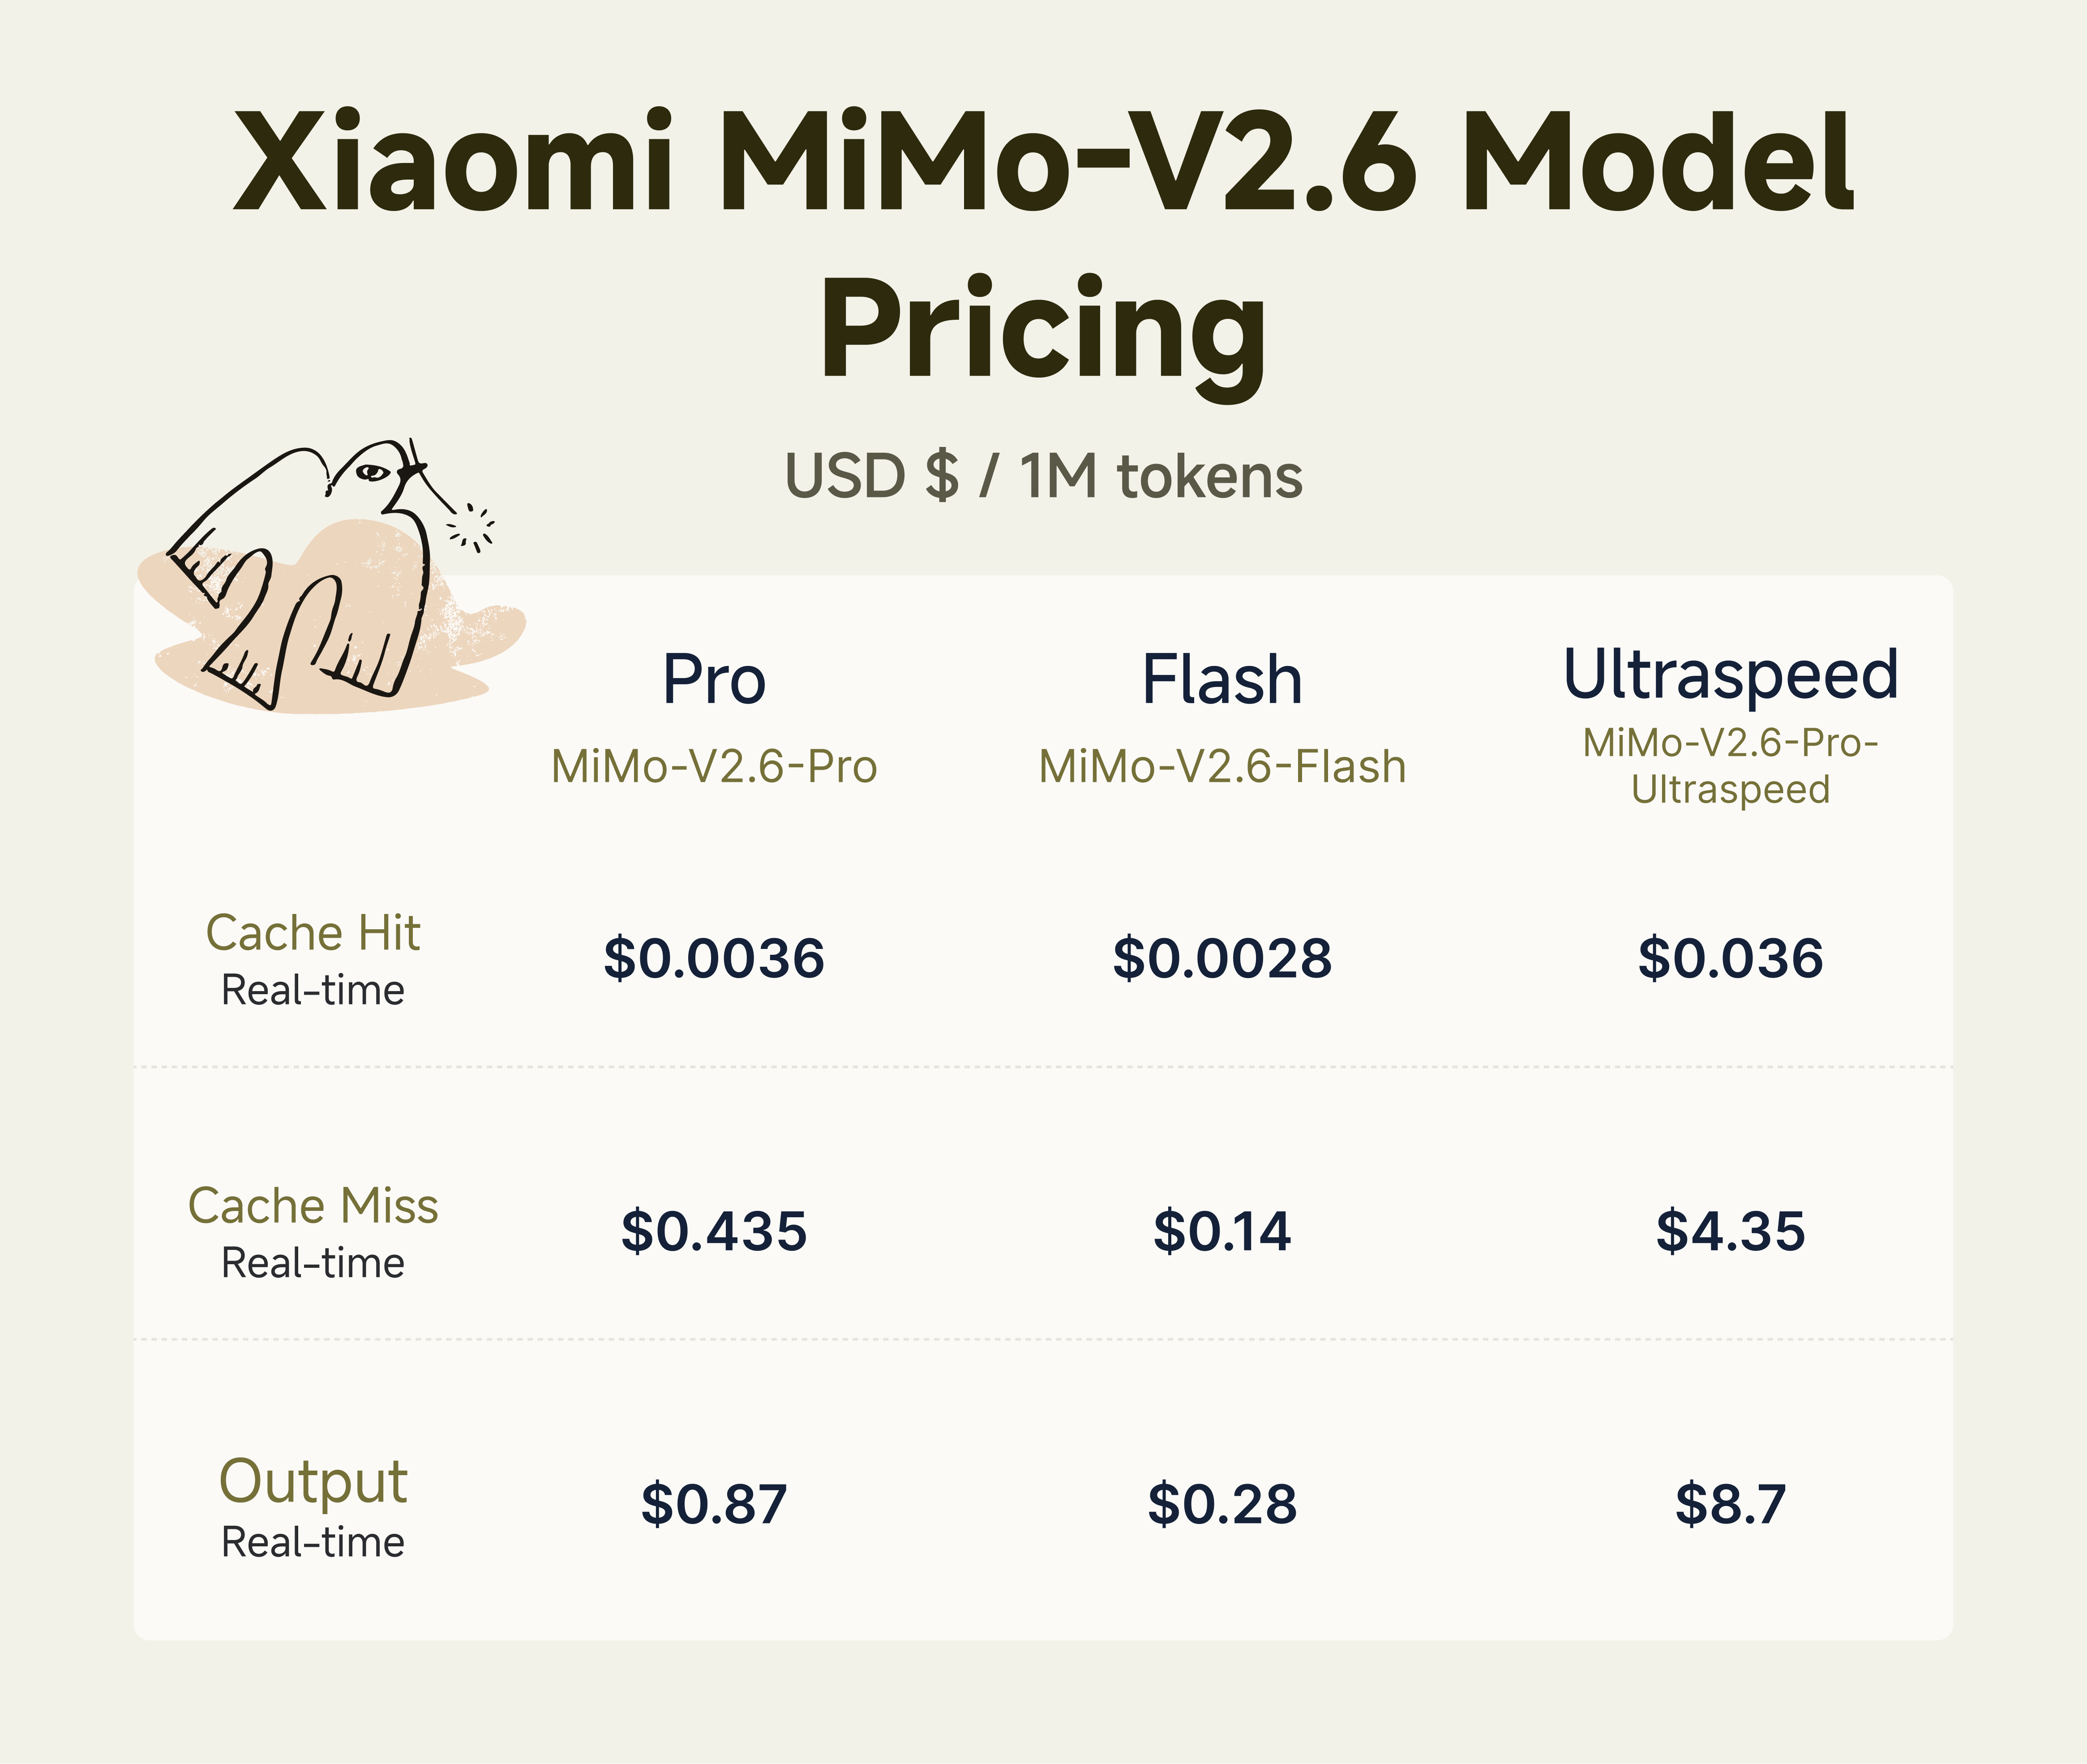
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Cached input / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Uncached input / 1M tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M tokens | $0.87 | $0.28 | $8.70 |
Xiaomi는 V2.6 API 가격을 V2.5 세대와 대체로 동일 수준으로 유지한다. Flash는 대량 워크로드에 특히 주목할 만하다: 공식 Xiaomi 가격은 미캐시 입력 100만 토큰당 $0.14, 출력 100만 토큰당 $0.28을 보여준다.
CometAPI 가격 및 제공 현황
| CometAPI route | Input / 1M | Output / 1M | Catalog status |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | 사용 가능; 공식 미캐시 요율 대비 20% 낮음 |
| mimo-v2.6-pro | $0.348 | $0.6960 | 사용 가능; 공식 미캐시 요율 대비 20% 낮음 |
| mimo-v2.6-flash | $0.112 | $0.2240 | 사용 가능; 공식 미캐시 요율 대비 20% 낮음 |
How Can Developers Access Xiaomi MiMo-V2.6?
Xiaomi는 OpenAI 호환 API를 통해 모델을 제공하며, 공식 모델 페이지에서 Anthropic 프로토콜과의 호환성을 문서화한다. 공식 식별자는 mimo-v2.6-pro, mimo-v2.6-flash, mimo-v2.6-pro-ultraspeed이다. Xiaomi는 도구 호출, 구조화된 출력, 스트리밍, 추론 제어, 컨텍스트 캐싱, 웹 검색을 문서화한다. OpenAI 호환 인터페이스는 enabled 또는 disabled와 같은 thinking.type 값을 사용하며, V2.6 모델에서 딥 씽킹은 기본적으로 활성화되어 있다.
개발자 접근 경로는 세 가지가 실용적이다. 첫째, 상당한 서빙 요구사항을 전제로 Pro 또는 Flash 오픈 가중치 체크포인트를 다운로드하여 셀프-호스팅 통합을 한다. 둘째, Xiaomi 키와 문서화된 엔드포인트로 Xiaomi의 관리형 API를 사용한다. 셋째, 지원되는 CometAPI 라우트를 CometAPI 키와 베이스 URL로 사용한다; 이는 멀티 모델 평가와 청구를 단순화할 수 있다. Claude Code와 같은 코딩 어시스턴트는 해당 라우트와 모델이 지원되는 경우 Anthropic 호환 라우트를 사용할 수 있지만, 호환성은 가정하지 말고 테스트해야 한다.
CometAPI를 통한 MiMo-V2.6 접근
CometAPI는 지원 모델을 위한 통합 엔드포인트와 청구 레이어를 제공한다. 주요 운영상의 이점은 마이그레이션의 단순성이다: 팀은 익숙한 SDK를 유지하면서 베이스 URL과 모델 ID만 변경하고, 동일 계정에서 MiMo를 다른 프런티어 모델과 비교하며, 사용량, 가격, 가용성 확인을 중앙화할 수 있다. 이는 멀티 모델 라우팅, 폴백 전략, 통합 인보이스, 동일 프롬프트를 제공자 간에 사용해야 하는 평가에 유용하다.
CometAPI는 플랫폼 레벨에서 세 가지 텍스트 요청 형식을 문서화한다: OpenAI Chat Completions, Anthropic Messages, OpenAI Responses. 호환 SDK의 경우, 마이그레이션은 일반적으로 애플리케이션 전체를 재작성하기보다 베이스 URL, API 키, 모델 ID를 변경하는 것을 의미한다. 엔드포인트와 파라미터 지원은 모델에 따라 다를 수 있으므로, 세 가지 형식 모두가 작동한다고 주장하기 전에 정확한 MiMo-V2.6 변형과 요청 형식을 테스트하라.
2026년 9월 23일 기준으로, MiMo-V2.6-Pro-UltraSpeed는 입력/출력 가격이 명시된 사용 가능한 카탈로그 라우트를 가진다. 전용 Pro와 Flash 페이지는 카탈로그 스냅샷에서 Coming soon을 표시하지만, API-health 패널은 Available이라고 표시한다. 이를 확인된 프로덕션 가용성 또는 가격이 아닌 불일치한 페이지 신호로 취급하라. 배포 전에 라이브 카탈로그, 대시보드, 테스트 요청을 확인하라.
다음 예시는 CometAPI가 공개한 Anthropic-SDK 패턴을 따르며 현재 명시된 UltraSpeed 라우트를 호출한다. API 키는 환경 변수에 저장하라.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: '이 프로젝트를 분석하고 다음 구현 단계들을 제안해 주세요.' }],
});
Is Xiaomi MiMo-V2.6 Open Source?
Xiaomi는 모델 가중치, 기술 자료, RL 리소스, 학습 환경, 관련 인프라를 공개했다. 이 릴리스에는 소프트웨어 엔지니어링, 취약성 재현, 지식 집약 작업, 웹 디자인/개발에 걸친 7,000개 이상의 RL 작업 환경이 포함된다. 또한 연구자들이 훨씬 작은 규모에서 RL 파이프라인을 연구할 수 있도록 MiMo-V2.6-Distill-Qwen-9B도 공개했다.
공식 모델 카드: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
What Are the Limitations of Xiaomi MiMo-V2.6?
조 단위 파라미터라는 헤드라인은 V2.6가 폐쇄형 프런티어 시스템보다 보편적으로 더 강하다는 증거로 간주되어서는 안 된다. Xiaomi의 자체 벤치마크 표도 혼합된 그림을 보여준다: Claude Opus 5는 일부 코딩, 도구 사용, OS 벤치마크에서 여전히 앞서 있으며, GPT-5.6 Sol도 일부 테스트에서 선도한다. 따라서 워크로드별 평가가 포괄적 승자 라벨보다 더 의미 있다.
Pro 전체 체크포인트 셀프-호스팅 또한 인프라 집약적 작업이다. 오픈 가중치가 쉬운 워크스테이션 배포를 의미하지는 않는다. 또한 여러 헤드라인 데모—연구, 실체화 제어, 3D 세계, 비디오 제작—는 외부 도구와 에이전트 하니스에 의존한다. MiMo-V2.6는 단독 챗 모델이 아니라 시스템 내 모델로 평가되어야 한다.
Why Does Xiaomi MiMo-V2.6 Matter?
MiMo-V2.6는 세 가지 중요한 방향을 결합한다: 매우 큰 희소 MoE 모델, 네이티브 멀티모달리티, 실제 에이전트 환경에 대한 강화학습. 1.02조 파라미터 수치가 주목을 끌지만, 더 중대한 설계 선택은 Xiaomi가 반복적 환경 상호작용, 궤적 채점, 도구 사용, 자기 교정에 투자했다는 점이다.
이 접근이 계속 확장된다면, 오픈 모델은 더 이상 정적 지식의 양으로만 차별화되지 않고, 얼마나 효과적으로 행동하고, 평가하고, 복구하며, 긴 작업을 완료하는지로 차별화될 수 있다. 따라서 MiMo-V2.6는 단순히 또 하나의 조-파라미터 챗봇이 아니라 오픈 에이전트 지향 기반 모델로 이해하는 것이 가장 적절하다.
Conclusion
MiMo-V2.6는 네이티브 텍스트, 이미지, 비디오, 오디오 입력을 긴 컨텍스트, 희소 MoE 추론, 실제 에이전트 환경 전반의 강화학습과 결합한 의미 있는 오픈 가중치 릴리스이다. Pro는 어려운 장기 지평 작업에 더 적합하고, Flash는 대량 및 비용 민감 워크로드를 겨냥하며, UltraSpeed는 훨씬 높은 API 가격과 맞바꾸어 지연을 낮춘다.
이 모델 패밀리는 공급업체 보고 에이전트 벤치마크에서 경쟁력이 있지만, 모든 평가를 선도하지는 않으며 폐쇄형 프런티어 모델의 보편적 대체로 취급되어서는 안 된다. 가장 신뢰할 수 있는 도입 경로는 의도한 프로덕션 워크플로의 정확한 도구, 지연 목표, 실패 모드, 비용 프로파일에 대해 MiMo-V2.6를 테스트하는 것이다.
FAQ
MiMo-V2.6를 프로덕션에 도입하기 전에 팀이 무엇을 테스트해야 하나?
모델만이 아니라 전체 시스템을 테스트하라. 과제 완료, 도구 호출 정확도, 실패한 행동에서의 복구, 지연, 토큰 소비, 컨텍스트 관리, 권한 경계를 측정하라. 에이전트 벤치마크는 방향성을 제공하지만, 내부 평가는 실제 리포지토리, 브라우저, 문서, 연구 워크플로를 반영해야 한다.
희소 아키텍처임에도 MiMo-V2.6-Pro 셀프-호스팅이 어려운 이유는?
희소 활성화는 촘촘한 조-파라미터 모델 대비 토큰당 연산을 줄이지만, 전체 체크포인트는 여전히 매우 큰 메모리와 분산 서빙 발자국을 가진다. 프로덕션 배포는 다노드 추론, 전문가 병렬화, 특수화 커널, 신중한 용량 계획을 요구할 수 있다.
Xiaomi의 교차-모델 벤치마크 표를 개발자는 어떻게 해석해야 하나?
공급업체 보고 증거로 취급하되, 독립적으로 재현된 보편적 순위로 보지 말라. 결과는 에이전트 하니스, 추론 예산, 도구, 환경 이미지, 샘플링 방법, 벤치마크 버전에 따라 달라질 수 있다. 다수 과제에서의 추세를 비교하고, 가장 관련 있는 워크로드를 내부적으로 재현하라.
언제 MiMo-V2.6-Flash가 Pro보다 더 나은 선택인가?
콜 볼륨과 비용이 지배적일 때 Flash가 더 강한 기본값이다. 특히 문서 처리, 멀티모달 분석, 반복적 에이전트 스텝에 적합하다. 더 어려운 추론이나 장기 실행이 더 큰 비즈니스 가치를 제공할 때는 더 높은 가격을 정당화할 수 있는 Pro가 더 적절하다.
100만 토큰 컨텍스트 윈도우가 검색이나 프롬프트 관리의 필요를 없애는가?
아니다. 더 큰 윈도우는 용량을 늘리지만, 불필요한 히스토리를 보내면 지연과 비용이 증가하고 관련 증거를 희석할 수 있다. 검색, 요약, 구조화된 메모리, 컨텍스트 가지치기는 신뢰할 수 있는 프로덕션 에이전트에 여전히 중요하다.