
DeepSeek V4.1 Flash menggantikan cerita beta jangka pendek dengan keluaran produksi berasaskan pengiraan asimetri, multimodaliti natif, penanda aras agen yang lebih kukuh, dan harga API yang jauh lebih rendah.
TL;DR
DeepSeek V4.1 Flash kini merupakan API rasmi dan model open-weight, bukan lagi endpoint beta yang akan tamat tempoh. DeepSeek menyatakan ia ialah model Mixture-of-Experts dengan 552B parameter yang menggunakan seni bina baharu Causal-Encoder-Decoder. Hanya 8B parameter diaktifkan semasa memproses input, manakala 16B diaktifkan semasa penjanaan output. Reka bentuk asimetri ini bertujuan mengurangkan penggunaan pengiraan pada prompt panjang tanpa melemahkan peringkat penjanaan autoregresif.
Nama model API produksi ialah deepseek-flash. Ia menyokong tetingkap konteks 1M token, sehingga 384K token output, mod berfikir dan tanpa berfikir, output JSON, panggilan alat, Responses API, API serasi Anthropic, dan input visi natif. Jadual penanda aras rasmi DeepSeek menunjukkan peningkatan ketara berbanding V4 Flash 0731 dan V4 Pro 0813 dalam tugasan pengaturcaraan, agen, keselamatan siber, dan multimodal.
Perubahan harga sama penting. Pada waktu puncak, V4.1 Flash berharga $0.006 bagi sejuta token input cache-hit, $0.30 bagi sejuta token input cache-miss, dan $1.20 bagi sejuta token output. Kadar luar waktu puncak adalah separuh daripada jumlah tersebut.
Perkara Utama
- DeepSeek V4.1 Flash ialah model yang telah dikeluarkan dengan berat terbuka; pengenal sementara
deepseek-v4.1-flash-expires-on-0910bukan lagi rujukan produksi yang betul. - Reka bentuk MoE 552B-nya mengaktifkan 8B parameter untuk input dan 16B untuk output, mewujudkan profil kecekapan yang berbeza daripada seni bina V4 Flash 284B jumlah/13B aktif.
- Multimodaliti natif adalah sebahagian daripada model utama dan bukannya cabang Vision Exp berasingan.
- Perbandingan rasmi menunjukkan V4.1 Flash mendahului V4 Pro 0813 pada kebanyakan penanda aras agen dan pengaturcaraan terpilih, walaupun ia tidak mendahului setiap penanda aras pengetahuan atau terminal berbanding semua pesaing peringkat hadapan.
- Global KV cache turun kepada 890 bait setiap token, kira-kira 3.9 kali lebih kecil daripada V4 Flash dan lebih kurang satu per empat daripada jejak terdahulunya.
- Harga API waktu puncak ialah $0.006 untuk input cache-hit, $0.30 untuk input cache-miss, dan $1.20 untuk output bagi setiap sejuta token; harga luar waktu puncak adalah 50% lebih rendah.
Apa Itu DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash ialah model asas DeepSeek pada September 2026 yang berfokuskan kecekapan untuk penaakulan, pengaturcaraan, agen, dan pemahaman multimodal. pengumuman rasmi menerangkannya sebagai model MoE 552B parameter yang meningkatkan keupayaan sambil mengurangkan pengiraan dan memori yang diperlukan untuk pemprosesan input.
Perubahan utama ialah seni bina. V4 Flash sebelumnya menggunakan bajet parameter aktif yang sama sepanjang inferens. V4.1 Flash memisahkan beban kerja input dan output: 8B parameter aktif semasa mengekod prompt dan 16B parameter aktif semasa menjana jawapan. DeepSeek menamakan reka bentuk ini Causal-Encoder-Decoder.
| Date | Status | Model ID |
|---|---|---|
| Sep 8 | Limited beta | deepseek-v4.1-flash-expires-on-0910 |
| Sep 10 | Production release | deepseek-flash |
Spesifikasi DeepSeek V4.1 Flash:
| Specification | DeepSeek V4.1 Flash |
|---|---|
| Release status | Keluaran API rasmi dan model open-weight |
| Architecture | Mixture-of-Experts dengan struktur Causal-Encoder-Decoder |
| Total parameters | 552B |
| Activated parameters | 8B untuk input; 16B untuk output |
| Context window | 1M token |
| Maximum output | 384K token |
| Input modalities | Teks dan imej |
| Output modality | Teks |
| Production API model name | deepseek-flash |
| Thinking modes | Mod berfikir dan tanpa berfikir |
| API features | Output JSON, panggilan alat, Responses API, Anthropic API, prefix completion, FIM completion |
| Open weights | Dikeluarkan di Hugging Face |
Bagaimana DeepSeek V4.1 Flash Berfungsi: Causal-Encoder-Decoder
Model bahasa tradisional jenis decoder-only menggunakan timbunan besar yang pada asasnya sama untuk pemprosesan prompt dan penjanaan token. DeepSeek V4.1 Flash memperuntukkan kapasiti aktif yang berbeza kepada peringkat tersebut.
Semasa peringkat input, model memproses prompt dengan jejak aktif 8B. Peringkat ini boleh memeriksa konteks teks atau imej yang dibekalkan dengan cekap kerana jawapan penuh belum dijana. Semasa peringkat output, model mengaktifkan 16B parameter dan meneruskan penjanaan token kausal satu demi satu. Reka bentuk ini oleh itu menjimatkan pengiraan pada pengekodan prompt sambil mengekalkan lebih banyak kapasiti aktif untuk penaakulan dan penjanaan respons.
DeepSeek belum menerbitkan setiap butiran pelaksanaan dalam pengumuman, jadi penerangan yang paling selamat ialah berfungsi: seni bina adalah asimetri, peringkat input dan output menggunakan bajet parameter aktif yang berbeza, dan sistem yang terhasil mengurangkan memori inferens serta kos.
Pengurangan KV Cache
Keputusan memori boleh diukur. DeepSeek melaporkan 890 bait global KV cache per token untuk V4.1 Flash, berbanding 3,514 bait untuk V4 Flash, 48,068 bait untuk V3.2, dan 389,120 bait untuk V1. Angka V4.1 adalah kira-kira 3.9 kali lebih kecil daripada V4 Flash.
Bagi agen konteks panjang, ini penting melepasi satu penanda aras. KV cache yang lebih kecil mengurangkan tekanan memori jalur lebar tinggi semasa permintaan aktif dan mengurangkan jumlah keadaan yang perlu dipindahkan ke storan yang lebih perlahan. DeepSeek berkata V4.1 Flash memerlukan kira-kira satu per empat kapasiti HBM dan satu per lapan kapasiti SSD berbanding model sebelumnya untuk beban kerja cache yang setara.
Ciri-ciri DeepSeek V4.1 Flash
Input Multimodal Natif
V4.1 Flash menerima imej sebagai sebahagian daripada API model utama. Ini menggantikan pemisahan sebelumnya antara V4 Flash berasaskan teks sahaja dan endpoint V4 Flash Vision eksperimen. Pembangun kini boleh membina aliran kerja pemahaman dokumen, analisis carta, interpretasi tangkapan skrin, dan agen visual menggunakan keluarga model produksi yang sama.
Penaakulan Konteks Panjang
Spesifikasi API rasmi mengekalkan tetingkap konteks 1M token dan membenarkan sehingga 384K token output. Ini menjadikan model sesuai untuk pengaturcaraan skala repositori, analisis multi-dokumen, sesi agen yang berjalan lama, dan aliran kerja yang perlu mengekalkan sejarah alat yang besar.
Ciri API Produksi
Model menyokong mod berfikir dan tanpa berfikir, output JSON berstruktur, panggilan alat, Responses API, antara muka serasi Anthropic, chat-prefix completion, dan FIM completion dalam mod tanpa berfikir. Keupayaan ini menjadikan V4.1 Flash pengganti produksi langsung bagi banyak beban kerja agen dan pengaturcaraan V4 Flash.
Berat Model Terbuka
DeepSeek telah mengeluarkan berat model V4.1 Flash dan laporan teknikal. Keluaran ini meningkatkan kebolehulangan, tetapi model kekal sangat besar: pengumuman DeepSeek meminta organisasi yang berminat dalam pelaksanaan besar untuk merancang kira-kira 2,000 GPU ditambah kluster storan.
Prestasi Penanda Aras DeepSeek V4.1 Flash
Keputusan rasmi mengubah penilaian awal bahawa V4.1 tidak mempunyai bukti penanda aras. DeepSeek kini menyediakan jadual luas meliputi pengetahuan, matematik, pengaturcaraan, agen terminal, keselamatan siber, automasi, dan tugasan agen multimodal.
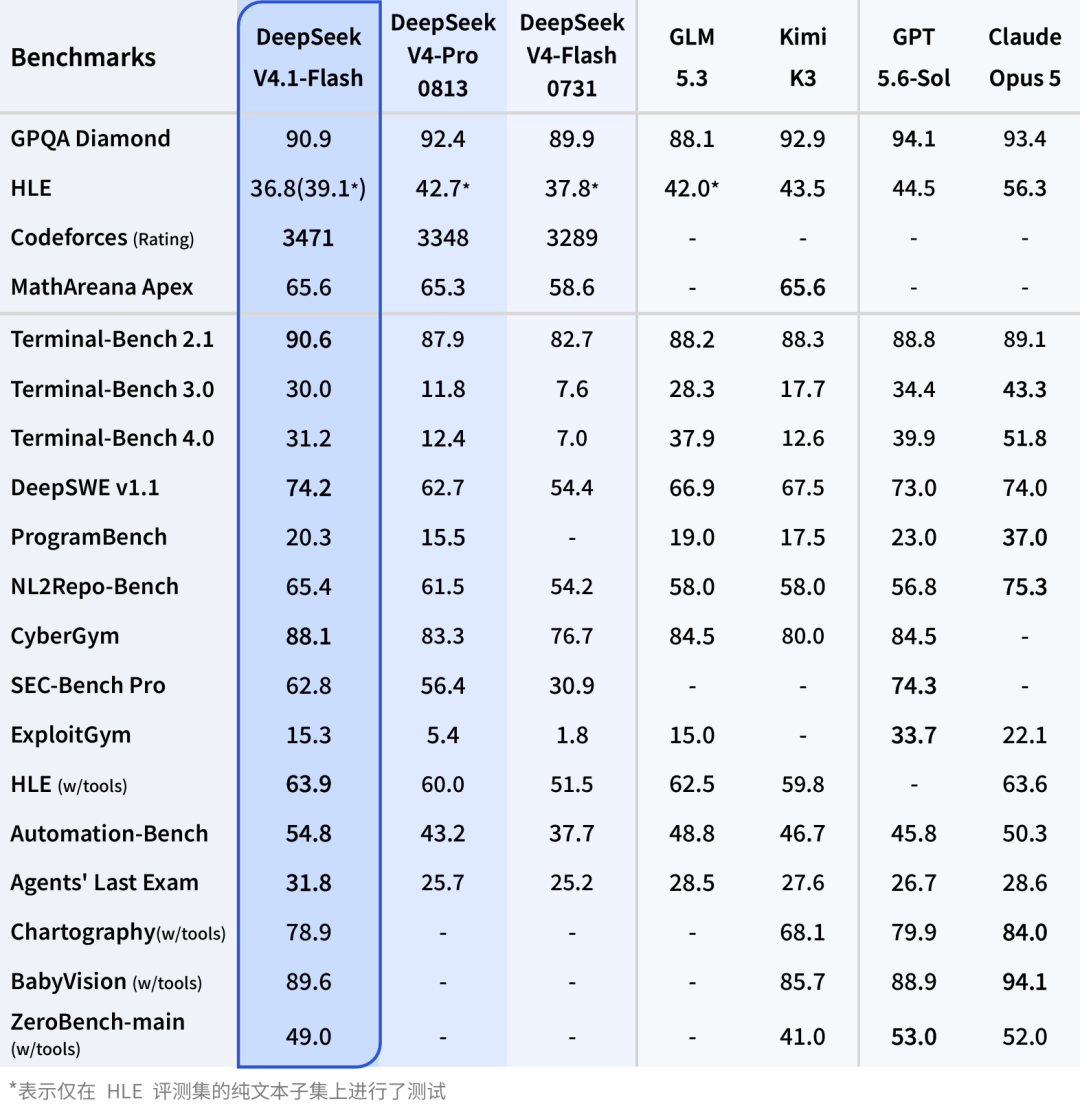
| Benchmark | DeepSeek V4.1 Flash | V4 Pro 0813 | V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
Merentasi lapan penanda aras terpilih ini, V4.1 Flash mengatasi V4 Pro 0813 pada tujuh ujian dan mengatasi V4 Flash 0731 pada semua lapan. Peningkatan terbesar muncul dalam kejuruteraan perisian dan agen: DeepSWE meningkat sebanyak 11.5 mata berbanding V4 Pro dan 19.8 berbanding V4 Flash, manakala Automation-Bench bertambah 11.6 dan 17.1 mata masing-masing.
Keputusan masih memerlukan tafsiran yang teliti. V4.1 Flash berada di bawah V4 Pro pada GPQA Diamond, dan carta rasmi penuh menunjukkan bahawa Claude Opus 5 dan GPT-5.6 Sol kekal mendahului pada Terminal-Bench 3.0. Kesimpulan berguna ialah V4.1 Flash memperbaiki keseimbangan kecekapan-keupayaan DeepSeek secara material; jadual penanda aras tidak membuktikan kepimpinan universal merentasi setiap tugasan.
Harga API DeepSeek V4.1 Flash
DeepSeek menggunakan pengebilan waktu puncak dan luar waktu puncak. Waktu puncak ialah 01:00–04:00 dan 06:00–10:00 UTC, Isnin hingga Jumaat; semua tempoh lain, termasuk hujung minggu, menggunakan kadar luar waktu puncak. dokumentasi harga semasa menyatakan bahawa harga luar waktu puncak adalah separuh daripada harga waktu puncak.
| Price per 1M tokens | V4.1 Flash luar waktu puncak | V4.1 Flash waktu puncak | V4 Pro 0813 luar waktu puncak | V4 Pro 0813 waktu puncak |
|---|---|---|---|---|
| Cache-hit input | $0.003 | $0.006 | $0.022 | $0.044 |
| Cache-miss input | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
Penjimatan adalah besar. Untuk beban kerja menggunakan 100 juta token input cache-miss dan 10 juta token output, V4.1 Flash berharga kira-kira $21 luar waktu puncak atau $42 pada waktu puncak. Campuran token yang sama pada kadar V4 Pro 0813 yang diterbitkan berharga kira-kira $85.80 luar waktu puncak atau $171.60 pada waktu puncak. V4.1 Flash adalah kira-kira 75.5% lebih murah dalam contoh ini.
Caching prompt memperkukuh kelebihan untuk agen yang berulang kali menggunakan semula arahan sistem, konteks repositori, atau dokumen. Kadar cache-hit V4.1 adalah 50 kali lebih rendah daripada kadar cache-miss pada kedua-dua tempoh pengebilan.
DeepSeek V4.1 Flash vs V4 Flash vs V4 Pro
| Dimension | DeepSeek V4.1 Flash | DeepSeek V4 Flash | DeepSeek V4 Pro |
|---|---|---|---|
| Total parameters | 552B | 284B | 1.6T |
| Activated parameters | 8B input / 16B output | 13B | 49B |
| Architecture focus | Kecekapan input/output asimetri | V4 MoE ringan | Kapasiti maksimum V4 |
| Native vision | Ya | Varian Vision Exp berasingan | Tidak |
| Context window | 1M | 1M | 1M |
| Maximum output | 384K | 384K | 384K |
| API status on DeepSeek | Model produksi semasa | Bersara; nama legasi menghala ke V4.1 Flash | Dijadualkan menghala ke V4.1 Flash mulai 14 September 2026 |
| Best fit | Agen umum, pengaturcaraan, visi, throughput tinggi | Keserasian migrasi sahaja | Beban kerja Pro sedia ada semasa peralihan |
V4.1 Flash lebih besar dari segi jumlah parameter daripada V4 Flash tetapi boleh lebih murah untuk dilayan kerana peringkat inputnya hanya mengaktifkan 8B parameter dan menggunakan KV cache yang jauh lebih kecil. Berbanding V4 Pro, ia mengaktifkan jauh lebih sedikit parameter sambil mengatasi Pro pada kebanyakan penanda aras agen dan pengaturcaraan yang dipilih di atas.
Akses API dan Migrasi
Nama model produksi DeepSeek ialah deepseek-flash. Aplikasi sedia ada boleh mengekalkan base URL serasi OpenAI https://api.deepseek.com atau base URL serasi Anthropic https://api.deepseek.com/anthropic.
- Kemas kini nama model kepada
deepseek-flash. - Kekalkan base URL DeepSeek dan kaedah pengesahan sedia ada.
- Uji semula mod berfikir, panggilan alat, input visi, latensi, dan penggunaan token dengan prompt produksi.
- Pantau alias legasi:
deepseek-v4-flashdandeepseek-v4-flash-vision-expkini menghala ke V4.1 Flash, manakaladeepseek-v4-prodijadualkan menghala ke V4.1 Flash mulai 14 September 2026 sehingga keluaran V4.1 Pro pada masa hadapan.
Untuk pengguna CometAPI, API DeepSeek V4.1 dalam CometAPI kini tersedia secara langsung bersama API DeepSeek V4 Flash sedia ada. Sebelum menukar trafik produksi, sahkan nama model akhir, harga, dan pemetaan alias dalam papan pemuka CometAPI, kerana pembekal pihak ketiga mungkin berbeza daripada penamaan dan kadar bil rasmi DeepSeek.
Siapa Patut Menggunakan DeepSeek V4.1 Flash?
V4.1 Flash sangat sesuai untuk agen pengaturcaraan, analisis repositori, automasi terminal, aliran kerja dokumen multimodal, pembantu konteks panjang, dan sistem volum tinggi yang menggunakan alat. Peningkatan penanda arasnya tertumpu pada beban kerja yang paling mendapat manfaat daripada memori cache yang lebih rendah dan harga token yang lebih rendah.
Pasukan yang sudah menggunakan V4 Flash harus menganggapnya sebagai calon migrasi langsung. Pasukan yang menggunakan V4 Pro harus menguji dengan teliti, tetapi data penanda aras dan harga DeepSeek sendiri kini menjadikan V4.1 Flash sebagai lalai yang lebih ekonomi untuk banyak beban kerja kelas Pro.
Hos kendiri ialah keputusan yang berbeza. Berat terbuka tidak menjadikan model 552B ringan. Organisasi harus membandingkan kos pelaksanaan GPU dan storan besar dengan penggunaan API hos sebelum komited kepada inferens tempatan.
Had dan Soalan Terbuka
- Keputusan penanda aras datang daripada persediaan penilaian rasmi DeepSeek; replika bebas diperlukan untuk mengukur prestasi merentasi harness dan persekitaran alat yang berbeza.
- Sokongan multimodal natif disahkan, tetapi pasukan aplikasi harus mengesahkan format imej yang disokong, perakaunan token, dan tingkah laku visi terhadap API langsung.
- Alias model legasi kini menukar model di sebalik nama sedia ada, yang boleh mengubah output tanpa perubahan kod aplikasi.
- V4.1 Flash mengurangkan keperluan infrastruktur berbanding model DeepSeek sebelumnya, tetapi pelaksanaan berat terbukanya masih memerlukan pengiraan dan storan yang besar.
- Endpoint V4.1 khusus CometAPI dan harga akhir harus disahkan dalam konsol langsung sebelum kegunaan produksi.
Kesimpulan Akhir
DeepSeek V4.1 Flash ialah kemas kini besar pada seni bina dan produk. Model MoE 552B ini menggabungkan peringkat input aktif 8B, peringkat output aktif 16B, visi natif, tetingkap konteks 1M token, dan KV cache yang dimampatkan dengan ketara. Pilihan reka bentuk tersebut diterjemahkan kepada penanda aras pengaturcaraan dan agen rasmi yang lebih kukuh pada harga API yang jauh lebih rendah berbanding V4 Pro 0813.
Perubahan paling praktikal ialah penyatuan. V4.1 Flash membawa teks, visi, penaakulan, penggunaan alat, dan operasi konteks panjang ke dalam satu nama model produksi. Untuk kebanyakan integrasi DeepSeek baharu, deepseek-flash kini titik permulaan yang logik; V4 Pro menjadi perbandingan migrasi dan bukan pilihan automatik untuk kerja sukar.
Soalan Lazim
Adakah DeepSeek V4.1 Flash telah dikeluarkan secara rasmi?
Ya. Ia tersedia melalui API DeepSeek dengan nama model deepseek-flash, dan DeepSeek telah mengeluarkan berat terbuka dan laporan teknikal.
Adakah pengenal model beta V4.1 sementara masih diperlukan?
Tidak. deepseek-v4.1-flash-expires-on-0910 ialah pengenal beta jangka pendek. Aplikasi produksi harus menggunakan deepseek-flash.
Berapa banyak parameter yang dimiliki DeepSeek V4.1 Flash?
Model ini mempunyai 552B jumlah parameter. Ia mengaktifkan 8B parameter semasa pemprosesan input dan 16B semasa penjanaan output.
Adakah DeepSeek V4.1 Flash menyokong imej?
Ya. Input visi adalah natif kepada model produksi, jadi endpoint V4 Flash Vision Exp berasingan tidak lagi diperlukan.
Adakah V4.1 Flash lebih baik daripada V4 Pro?
Ia mendahului V4 Pro 0813 pada kebanyakan perbandingan pengaturcaraan, agen, automasi, dan keselamatan siber yang diterbitkan DeepSeek, tetapi V4 Pro kekal mendahului pada GPQA Diamond. Pasukan harus menilai kedua-duanya terhadap prompt sendiri sebelum migrasi.
Berapakah kos API?
Pada waktu puncak, kadar per sejuta token ialah $0.006 untuk input cache-hit, $0.30 untuk input cache-miss, dan $1.20 untuk output. Kadar luar waktu puncak adalah separuh daripada harga tersebut.
Apa yang berlaku kepada nama model V4 lama?
Nama legasi deepseek-v4-flash dan deepseek-v4-flash-vision-exp menghala ke V4.1 Flash. DeepSeek berkata deepseek-v4-pro juga akan menghala ke V4.1 Flash mulai 14 September 2026 sehingga V4.1 Pro dikeluarkan.
Bolehkah saya menggunakan DeepSeek V4.1 Flash melalui CometAPI?
Ya. CometAPI kini menawarkan endpoint API DeepSeek V4.1 secara langsung. Sebelum menghantar trafik produksi, sahkan nama model tepat, harga, dan ciri yang disokong dalam konsol CometAPI, kerana pembekal pihak ketiga mungkin menggunakan konvensyen penamaan atau kadar bil yang berbeza daripada API rasmi DeepSeek.