
TL;DR
DeepSeek-V4.1-Flash ialah model Flash multimodal semasa yang disediakan oleh DeepSeek API dengan ID model deepseek-flash. Ia menyokong konteks 1M token, output sehingga 384K, dan input imej; mengikut panduan Vision semasa, setiap imej menggunakan maksimum 1024 token selepas penukaran saiz automatik.
Kekuatan utamanya kekal pada visi berorientasikan ejen: memeriksa tangkapan skrin, carta, antara muka, dan dokumen berasaskan imej sebelum meneruskan dengan kod atau alat. Keputusan penanda aras kemudian dalam artikel ini tergolong dalam pelancaran Vision-Exp yang telah ditamatkan dan harus dibaca sebagai bukti sejarah yang dilaporkan vendor—bukan sebagai penanda aras baharu DeepSeek-V4.1-Flash.
CometAPI buat masa ini mengekalkan deepseek-v4-flash-vision-exp sebagai ID model dalam katalog, manakala API langsung DeepSeek mengesyorkan deepseek-flash dan melayan permintaan dengan DeepSeek-V4.1-Flash. Mulakan dengan permintaan teks + imej, kemudian nilai laluan tepat pada tangkapan skrin dan tugasan visual anda sendiri.
Key Takeaways
- Laluan semasa: DeepSeek-V4.1-Flash ialah model Flash multimodal aktif. Nama
deepseek-v4-flash-vision-expyang telah ditamatkan kekal diterima hanya sebagai alias keserasian pada API DeepSeek. - Ruang kerja teks besar: konteks 1M token dan output sehingga 384K menyokong dokumen panjang, repositori kod, sejarah alat, dan imej dalam satu perbualan.
- Perakaunan imej semasa: DeepSeek menukar saiz setiap imej secara automatik dan mengehadkannya pada 1024 token input. Imej di bawah kira-kira 544×544 jumlah piksel diskalakan naik; imej lebih besar diskalakan ke arah kira-kira 1300×1300 jumlah piksel.
- Fokus visi ejen: perbandingan rasmi menekankan aliran kerja tangkapan skrin, carta, pelayar, pengkodan, dan alat visual berbanding penjanaan imej.
- Sokongan antara muka luas: DeepSeek mendokumenkan antara muka API yang disokong: Chat Completions, Anthropic-compatible Messages, dan Responses API. Contoh CometAPI di bawah menggunakan Chat Completions.
- Berhati-hati untuk produksi: alias laluan, penukaran saiz imej automatik, dan keputusan penanda aras yang sensitif terhadap perisian pengikat masih menjadikan pengujian khusus beban kerja sebagai keperluan.
What Is DeepSeek-V4-Flash-Vision?
Dokumentasi semasa DeepSeek mengenal pasti deepseek-flash sebagai DeepSeek-V4.1-Flash, dengan input teks dan imej serta output teks. Model Vision-Exp yang terdahulu telah ditamatkan; nama model legasinya ialah alias keserasian yang dirutekan ke model Flash semasa.
Kes penggunaan sasaran ialah agensi multimodal. Ejen visual boleh memeriksa aplikasi yang dihasilkan, mengenal pasti butang atau kegagalan susun atur, berfikir tentang tindakan seterusnya, memanggil alat, dan kemudian meneliti tangkapan skrin seterusnya. Corak yang sama digunakan untuk analisis carta, jaminan kualiti visual, pengekstrakan dokumen, automasi pelayar, dan ejen pengkodan yang perlu membandingkan rujukan reka bentuk dengan halaman yang dipaparkan.
Nota penamaan: untuk API langsung DeepSeek, gunakan deepseek-flash; ketika ini ia memetakan kepada DeepSeek-V4.1-Flash. Nama legasi deepseek-v4-flash dan deepseek-v4-flash-vision-exp masih diterima oleh DeepSeek, tetapi model yang bersesuaian telah ditamatkan dan permintaan dilayan oleh DeepSeek-V4.1-Flash. CometAPI terus mendedahkan deepseek-v4-flash-vision-exp sebagai laluan katalognya sendiri.
Technical Specifications
| Spesifikasi (dok rasmi) | Nilai semasa |
|---|---|
| ID model rasmi | deepseek-flash |
| Status | Laluan API Flash multimodal aktif; model Vision-Exp legasi ditamatkan |
| Input / output | Input teks + imej; output teks |
| Tetingkap konteks | 1,048,576 token (1M) |
| Output maksimum | Sehingga 384K token |
| Penyenaraian checkpoint Vision-Exp legasi | 305B parameter pada repositori rasmi Hugging Face |
| Tulang belakang teks Vision-Exp legasi | 43 lapisan; saiz tersembunyi 4,096; 64 ketua perhatian |
| Perutean MoE Vision-Exp legasi | 256 pakar dirutekan; 6 dipilih per token; 1 pakar dikongsi |
| Pengekod visi Vision-Exp legasi | 32 lapisan; lebar 1,024; 16 kepala; saiz tampalan 14 |
| Perwakilan imej | Maksimum 1024 token imej per imej pada DeepSeek API semasa |
| Format imej | JPEG, PNG, GIF, WebP |
| Kaedah input imej | URL data Base64, URL luaran, file_id DeepSeek Files API |
| Gaya API | Chat Completions, Anthropic-compatible Messages, Responses |
| Mod penaakulan | Thinking dan non-thinking; tahap usaha low, high, max |
| Lesen | MIT untuk repositori model rasmi |
Medan seni bina di atas datang daripada konfigurasi rasmi. Antara muka repositori menyenaraikan checkpoint 305B parameter, tetapi DeepSeek tidak menerbitkan secara berasingan kiraan parameter diaktifkan untuk keseluruhan model visi. Adalah lebih selamat melaporkan nilai repositori berbanding mengandaikan bahawa kiraan diaktifkan V4-Flash berasaskan teks dipindahkan tanpa perubahan selepas menambah timbunan visual.
How DeepSeek-V4-Flash-Vision-Exp's Legacy Architecture Works
V4-Flash Text Backbone
Bahagian bahasa mengekalkan tema reka bentuk V4 yang menjadikan kerja ejen konteks panjang praktikal. Repositori rasmi mendokumentasikan komponen seni bina V4: perutean Mixture-of-Experts jarang, perhatian DFlash, Hyper-Connections, dan DSpark. Ini menjadikan keluaran lebih boleh diperiksa berbanding model hanya-API walaupun penggunaan setempat kekal menuntut pada skala ini.
Vision Encoder and Aligner
Untuk checkpoint Vision-Exp yang telah ditamatkan, konfigurasi yang diterbitkan menggunakan pengekod visual 32 lapisan, saiz tampalan 14, lebar visi 1,024, 16 kepala perhatian visual, dan perwakilan imej 384 token. Butiran seni bina ini menerangkan checkpoint sejarah dan tidak sepatutnya dianggap mendokumenkan timbunan pelayan DeepSeek-V4.1-Flash semasa.
Current 1024-Token Image Limit
Peraturan tokenisasi visi semasa DeepSeek menskalakan imej di bawah kira-kira 544×544 jumlah piksel ke atas dan imej yang lebih besar ke bawah sambil mengekalkan nisbah aspek. Input besar ditukar saiz ke arah kawasan piksel sekitar imej 1300×1300, menghasilkan had atas 1024 token per imej. Imej 2000×2000 dan 5000×5000 oleh itu menggunakan bilangan token imej yang sama selepas penukaran saiz.
Implikasi praktikal: pangkas kawasan yang mengandungi label kecil, kod, atau kawalan UI sebelum menghantar imej. Resolusi sumber lebih tinggi sahaja tidak mengatasi siling 1024 token semasa.
Legacy Vision-Exp Benchmark Performance
Penilaian kad model rasmi DeepSeek membandingkan model visi dengan DeepSeek-V4-Flash-0731 dan Claude Opus 4.8 merentas tugasan ejen teks dan ejen multimodal. Model visi secara amnya bertambah baik berbanding model Flash hanya-teks sambil kekal bersaing dengan, tetapi tidak seragam mengatasi, pesaing berorientasi keupayaan.
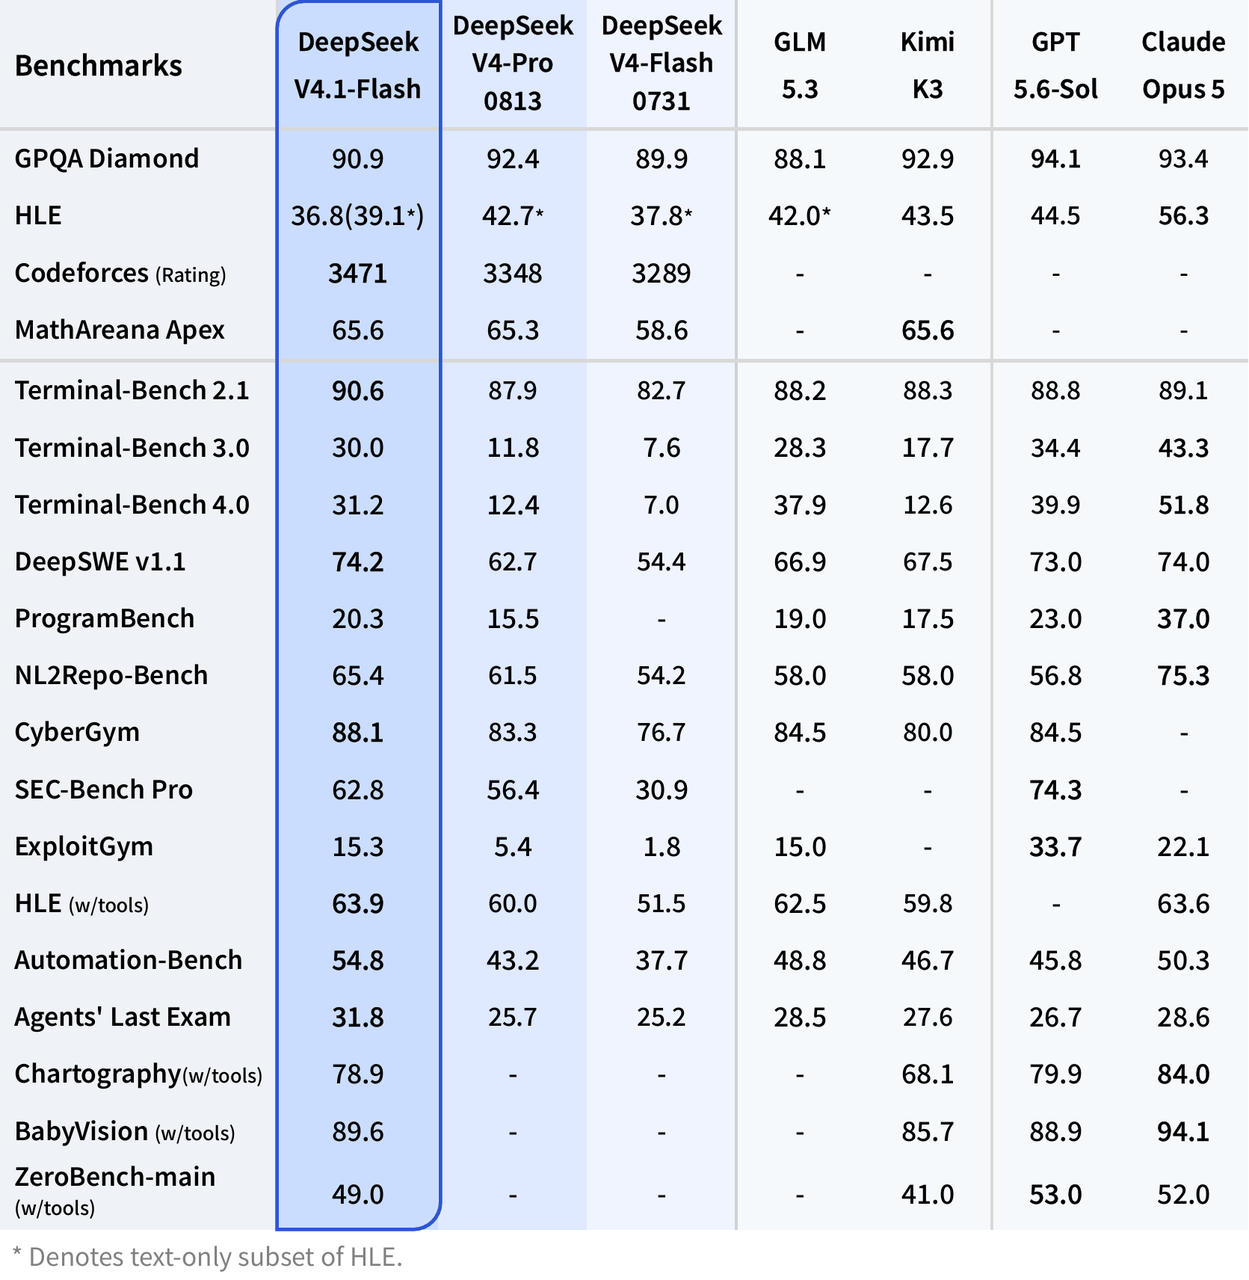
Perbandingan penanda aras rasmi untuk penilaian ejen teks dan multimodal. Sumber: keluaran rasmi DeepSeek
| Penanda aras rasmi | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | - | 65.0 |
| ZeroBench (Pass@5) | 35.0 | - | 34.0 |
* Dalam ApexBench dan Agents' Last Exam, V4-Flash hanya-teks mengabaikan elemen multimodal dalam input. DeepSeek menilai tugasan ejen teksnya dengan DeepSeek Harness mod minimal, usaha penaakulan maksimum, suhu 1.0, dan top_p 0.95.
Nota penanda aras: ini ialah keputusan pelancaran yang dilaporkan DeepSeek, bukan pengulangan bebas. Skor ejen sangat sensitif terhadap perisian pengikat, definisi alat, bajet token, dan dasar cuba semula, jadi ia harus dianggap sebagai bukti berarah.
What the Benchmark Results Mean
Keputusan paling jelas ialah peningkatan berbanding V4-Flash hanya-teks apabila bukti visual penting. ApexBench meningkat daripada 26.2 kepada 36.5, dan model visi menambah keputusan Chartography dan ZeroBench yang kompetitif yang tidak dilaporkan oleh model hanya-teks. Model ini juga bertambah baik pada beberapa tugasan ejen teks, termasuk Terminal Bench 2.1, NL2Repo, DeepSWE, Toolathlon-Verified, dan DSBench-Hard, walaupun Cybergym sedikit lebih rendah.
Berbanding Opus 4.8, hasilnya bercampur. Vision-Exp lebih tinggi pada DeepSWE, Agents' Last Exam, dan ZeroBench dalam jadual ini, manakala model pesaing lebih tinggi pada Terminal Bench, NL2Repo, Cybergym, Toolathlon, DSBench-Hard, ApexBench, dan Chartography. Dakwaan penanda aras multimodal DeepSeek oleh itu bersifat berarah dan bukannya bukti kesetaraan umum merentas setiap dimensi visi, penaakulan, atau kebolehpercayaan.
DeepSeek-V4.1-Flash vs DeepSeek-V4-Flash-Vision-Exp vs Claude Opus 4.8 vs Gemini 3.7 Flash
| Dimensi | DeepSeek Vision-Exp | DeepSeek V4 Flash | Claude Opus 4.8 | Gemini 3.7 Flash |
|---|---|---|---|---|
| Status | Eksperimental | Beta awam / laluan Flash semasa | Umumnya tersedia | Umumnya tersedia |
| Modaliti input | Teks, imej | Teks | Teks, imej, dokumen | Teks, imej, video, audio, PDF |
| Output | Teks | Teks | Teks / data berstruktur / kod | Teks |
| Konteks | 1M | 1M | Sehingga 1M bergantung platform | 1,048,576 |
| Output maksimum | 384K | 384K | 128K | 65,536 |
| Kekuatan utama | Ejen visual kos rendah | Ejen teks ber-throughput tinggi | Ejen kompleks autonomi tinggi | Kuda kerja multimodal yang luas |
| Ujian pertama terbaik | Tangkapan skrin, carta, UI, pengkodan visual | Pengkodan dan automasi teks | Tugasan jarak jauh paling sukar | Media kaya dan aliran kerja alat Google |
Pilih Vision-Exp apabila persepsi imej perlu ditambah kepada gelung ejen kos rendah. Pilih V4 Flash apabila setiap input adalah teks dan throughput lebih penting daripada pemahaman visual. Opus 4.8 kekal sebagai pilihan berorientasikan keupayaan dalam perbandingan DeepSeek sendiri, manakala Gemini 3.7 Flash ialah alternatif multimodal yang lebih luas apabila video, audio, PDF, dan alat asli Google penting.
What Can DeepSeek-V4-Flash-Vision Do?
- Tangkapan skrin ke kod dan semakan UI - bandingkan halaman yang dipaparkan dengan reka bentuk, kenal pasti masalah susun atur atau kebolehaksesan, dan jana panduan pelaksanaan.
- Ejen pelayar visual - gunakan tangkapan skrin sebagai pemerhatian apabila data DOM atau pokok kebolehaksesan tidak lengkap, kemudian pilih tindakan alat seterusnya.
- Analisis carta dan papan pemuka - terangkan aliran, kenal pasti anomali, dan sambungkan metrik yang kelihatan kepada aliran kerja teks atau alat yang lebih besar.
- Pemahaman dokumen berasaskan imej - ekstrak maklumat daripada borang diimbas, rajah, slaid, jadual, dan tangkapan skrin sebelum pemprosesan berstruktur.
- Ejen pengkodan multimodal - gabungkan kod sumber, tangkapan skrin pepijat, keadaan IDE, dan output dipaparkan dalam satu gelung nyahpepijat.
- Jaminan kualiti visual - bandingkan tangkapan skrin produk merentas peranti, kesan elemen yang hilang, dan jana laporan kecacatan berstruktur.
- Perbandingan berbilang imej - nilai jujukan tangkapan skrin atau reka bentuk alternatif dalam satu permintaan, tertakluk pada saiz permintaan dan had bilangan imej.
Contoh ejen visual rasmi dari halaman pelancaran DeepSeek (GIF beranimasi dalam Word). Sumber: keluaran rasmi DeepSeek
Pricing and Availability
DeepSeek mengira token imej bersama token input teks. Jadual harga rasminya menggunakan kadar puncak dan luar puncak, manakala halaman model CometAPI menerbitkan satu harga laluan semasa. Nombor tidak seharusnya digabungkan menjadi satu harga generik kerana laluan termurah berubah dengan tetingkap masa DeepSeek.
| Laluan / sumber | Input cache-hit | Input cache-miss | Output | Keadaan |
|---|---|---|---|---|
| DeepSeek rasmi - luar puncak | $0.003 | $0.15 | $0.60 | Semua jam di luar tetingkap puncak, termasuk hujung minggu dan cuti umum China |
| DeepSeek rasmi - puncak | $0.006 | $0.30 | $1.20 | 01:00-04:00 dan 06:00-10:00 UTC, Isnin-Jumaat, tidak termasuk cuti umum China |
| CometAPI laluan semasa | Tidak disenaraikan berasingan | $0.352 | $1.056 | Harga laluan bersatu semasa |
Semua harga ialah USD bagi setiap 1M token. Kadar Flash semasa DeepSeek ialah $0.003/$0.15/$0.60 luar puncak dan $0.006/$0.30/$1.20 puncak untuk input cache-hit, input cache-miss, dan output masing-masing. CometAPI ketika ini menyenaraikan $0.352 per 1M token input dan kira-kira $1.06 per 1M token output untuk laluan keserasiannya. Imej menggunakan maksimum 1024 token input setiap satu pada API semasa DeepSeek; sentiasa semak semula harga laluan langsung sebelum penggunaan produksi.
Nota harga: harga model boleh berubah. Kekalkan angka harga dipautkan kepada halaman harga langsung dan semak semula serta-merta sebelum penerbitan atau pelancaran produksi.
How to Use DeepSeek-V4-Flash-Vision with CometAPI
CometAPI ketika ini menyenaraikan deepseek-v4-flash-vision-exp melalui titik akhir OpenAI-serasi /v1/chat/completions, jadi contoh CometAPI mengekalkan ID katalog tersebut. Untuk API langsung DeepSeek, gunakan deepseek-flash sebaliknya.
Step 1: Create an API Key
- Cipta atau log masuk ke akaun CometAPI.
- Buka API token console dan cipta kunci.
- Simpan dalam pembolehubah persekitaran COMETAPI_KEY. Jangan letakkan kunci produksi dalam kod sisi klien atau komit ke kawalan sumber.
export COMETAPI_KEY="your-cometapi-key"
Step 2: Send a Base64 Image with cURL
Base64 berguna untuk fail setempat dan kerja sisi pelayan di mana imej sudah berada dalam memori. Gantikan pemegang tempat dengan bait imej yang dikodkan, tanpa menambah ruang atau pemisah baris.
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-v4-flash-vision-exp",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "Read this dashboard and return the three most important findings."
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "data:image/png;base64,<BASE64_DATA>"
            }
          }
        ]
      }
    ],
    "max_tokens": 1200
  }'
Step 3: Analyze a Local Image with Python
OpenAI Python SDK boleh memanggil CometAPI dengan menukar URL asas. Gunakan extra_body untuk kawalan thinking khusus DeepSeek apabila SDK anda tidak mendedahkannya secara langsung.
import base64
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

with open("dashboard.png", "rb") as image_file:
    encoded = base64.b64encode(image_file.read()).decode("utf-8")

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": (
                        "Analyze the chart. Return JSON with keys: trend, "
                        "anomalies, evidence, and confidence."
                    ),
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{encoded}"
                    },
                },
            ],
        }
    ],
    max_tokens=1500,
    extra_body={
        "thinking": {"type": "enabled"},
        "reasoning_effort": "high",
    },
)

print(response.choices[0].message.content)
Step 4: Use a Public Image URL with JavaScript
URL imej mengekalkan permintaan JSON kecil, tetapi URL mesti boleh dicapai secara umum oleh model huluan. Elakkan pautan sementara, peribadi, atau dilindungi pengesahan kecuali aplikasi anda terlebih dahulu menukar imej kepada Base64.
const response = await fetch(
  "https://api.cometapi.com/v1/chat/completions",
  {
    method: "POST",
    headers: {
      Authorization: `Bearer ${process.env.COMETAPI_KEY}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      model: "deepseek-v4-flash-vision-exp",
      messages: [
        {
          role: "user",
          content: [
            {
              type: "text",
              text: "Identify the UI issue and propose a concrete CSS fix.",
            },
            {
              type: "image_url",
              image_url: {
                url: "https://example.com/screenshot.png",
              },
            },
          ],
        },
      ],
      max_tokens: 1200,
    }),
  }
);

if (!response.ok) {
  throw new Error(`CometAPI request failed: ${response.status}`);
}

const data = await response.json();
console.log(data.choices[0].message.content);
Step 5: Send Multiple Images
Letakkan berbilang blok image_url dalam mesej pengguna yang sama dan beritahu model cara melabelkannya. Label yang jelas mengurangkan rujukan silang imej secara tidak sengaja.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": "Compare Image A and Image B. List every visible regression."
        },
        {
          "type": "image_url",
          "image_url": {"url": "https://example.com/image-a.png"}
        },
        {
          "type": "image_url",
          "image_url": {"url": "https://example.com/image-b.png"}
        }
      ]
    }
  ],
  "max_tokens": 1800
}
Input Methods and Limits
| Had | Nilai rasmi DeepSeek |
|---|---|
| Format yang disokong | JPEG, PNG, GIF, WebP |
| Panjang URL luaran | Sehingga 8,192 aksara |
| Badan permintaan | 48 MiB |
| Satu imej melalui Base64 / URL | 32 MiB |
| Satu imej melalui DeepSeek Files API | 64 MiB |
| Maksimum imej per permintaan | 600 |
| Jumlah saiz imej | 64 MiB tanpa file_id; sehingga 200 MiB termasuk file_id |
| Dimensi maksimum | 8,192 px per sisi; 4,096 px apabila permintaan mempunyai 15+ imej |
| Peranan mesej imej | Hanya mesej pengguna |
API rasmi DeepSeek juga menyokong rujukan imej file_id boleh guna semula melalui Files API. Laluan pantas CometAPI yang didokumenkan di sini menggunakan blok image_url dengan sama ada URL awam atau URL data Base64. Sahkan muat naik fail khusus penyedia dan passthrough file_id sebelum bergantung pada aliran kerja itu melalui laluan pengagregatan.
How to Prompt the Model Effectively
Prompt ejen visual yang boleh dipercayai harus menyatakan apakah imej itu, bukti apa yang perlu diperiksa, tindakan apa yang perlu diambil, dan kontrak output apa yang perlu diikuti. Prompt kabur seperti describe this image memberi terlalu banyak kebebasan dan menyukarkan pengesahan hasil.
- Konteks - kenal pasti tangkapan skrin, carta, dokumen, atau antara muka dan peranannya dalam aliran kerja.
- Tugasan - nyatakan keputusan, diagnosis, perbandingan, atau pengekstrakan yang penting.
- Bukti - minta bukti yang kelihatan, label, koordinat, nilai, atau teks UI yang dipetik.
- Kekangan - larang andaian yang tidak disokong dan beritahu model cara mengendalikan butiran yang tidak boleh dibaca.
- Output - tentukan kunci JSON, senarai semak, tahap keterukan, atau struktur boleh semak mesin yang lain.
You are reviewing a web application screenshot.

Task: identify layout, accessibility, and state-consistency defects.
Evidence: cite the visible element, label, position, or color that supports each finding.
Constraints: do not infer hidden DOM state; mark unreadable text as uncertain.
Output: return JSON with arrays named critical, major, minor, and follow_up_checks.
Production Best Practices
- Pangkas sebelum memuat naik apabila teks kecil atau kawalan penting; siling token imej bermakna latar tidak relevan memakan resolusi visual yang terhad.
- Uji tahap thinking berbanding mendayakan max untuk setiap permintaan. OCR ringkas atau pengelasan biasanya memerlukan penaakulan yang lebih rendah daripada diagnosis UI berbilang langkah.
- Wajibkan bukti dalam setiap penemuan berstruktur. Ini menjadikan dakwaan visual yang dihalusinasi lebih mudah ditolak secara automatik.
- Pisahkan persepsi daripada tindakan dalam automasi berisiko tinggi. Biarkan model menerangkan keadaan, sahkannya, kemudian benarkan lapisan alat terkawal untuk bertindak.
- Lindungi URL imej kerana URL awam boleh mendedahkan tangkapan skrin sensitif. Lebih suka Base64 sisi pelayan untuk data peribadi dan gunakan dasar pengekalan anda sendiri.
- Penanda aras hujung ke hujung dengan tangkapan skrin, prompt, alat, cuba semula, dan kriteria kejayaan yang sama digunakan dalam produksi.
- Jejak perubahan eksperimental dengan memasang prompt dan data penilaian. Titik akhir -exp boleh mengubah tingkah laku lebih pantas daripada model ketersediaan umum yang matang.
- Log ID permintaan dan kegagalan supaya ralat penyedia, ralat model, dan ralat penghuraian aplikasi boleh dibezakan.
Limitations
Had paling penting ialah ketelusan laluan: nama Vision-Exp legasi mungkin masih diterima walaupun permintaan dilayan oleh DeepSeek-V4.1-Flash. Log penyedia, ID model yang diminta, metadata model yang dikembalikan, dan ID permintaan; gunakan gerbang penilaian eksplisit sebelum memberikan tindakan autonomi. Skor pelancaran sejarah bukan pengganti untuk pengujian boleh ulang pada laluan yang dimaksudkan.
Had kedua ialah butiran visual. Penukaran saiz automatik dan siling 1024 token imej semasa menjadikan kos boleh diramal tetapi masih boleh menindas teks kecil, tanda carta halus, atau elemen antara muka yang padat. Pangkas, petakan, atau zum rantau yang berkaitan dan simpan imej asal untuk semakan manusia.
Model hanya mengembalikan teks. Ia boleh menganalisis imej dan mencadangkan kod atau tindakan berstruktur, tetapi ia tidak menjana atau mengedit imej. Ia juga menerima imej hanya dalam mesej pengguna, dan dokumentasi rasmi menyatakan bahawa kandungan imej dalam mesej sistem atau pembantu memulangkan ralat 400.
Akhirnya, penggunaan setempat adalah berat infrastruktur. Repositori rasmi menyenaraikan model 305B parameter dan menyediakan kod rujukan inferens dan bukannya runtime ringan sedia guna. Bagi kebanyakan pasukan, penilaian API terurus ialah titik permulaan yang praktikal.
Common Errors and Fixes
| Gejala | Punca berkemungkinan | Cadangan pembaikan |
|---|---|---|
| 400: model does not support image | ID model salah | Guna deepseek-v4-flash-vision-exp |
| 400 for message content | Imej diletakkan dalam mesej sistem atau pembantu | Alihkan blok imej ke dalam mesej pengguna |
| Kegagalan muat turun imej | URL peribadi, tamat tempoh, atau perlahan | Guna Base64 atau URL awam yang stabil |
| Butiran halus terlepas | Penskalaan turun automatik / siling 384 token | Pangkas atau petakan rantau yang berkaitan |
| Kos tidak dijangka tinggi | Output panjang, cuba semula, atau giliran berulang | Hadkan max_tokens dan log penggunaan per giliran |
| Hasil ejen tidak konsisten | Variasi perisian pengikat atau keadaan alat | Tetapkan prompt, alat, cuba semula, dan rubrik penilaian |
FAQ
Is DeepSeek-V4-Flash-Vision the same as DeepSeek-V4-Flash?
Tidak. Vision-Exp menambah input imej asli dan latihan multimodal. Laluan Flash hanya-teks tidak menyediakan keupayaan persepsi visual yang sama.
What model ID should I use?
Guna deepseek-flash pada API langsung DeepSeek. Pada CometAPI, guna ID katalog deepseek-v4-flash-vision-exp selagi laluan itu tersedia.
Can it analyze multiple images?
Ya. DeepSeek mendokumenkan sehingga 600 imej per permintaan, tertakluk kepada had saiz permintaan dan dimensi. Had praktikal mungkin lebih rendah dalam aplikasi kerana kependaman dan kejelasan prompt merosot apabila set imej bertambah.
How many tokens does an image use?
Pada API semasa DeepSeek, imej ditukar saiz dan ditukar kepada token dengan maksimum 1024 token per imej. Berbilang imej dikira secara berasingan.
Does it support image generation?
Tidak. Ia menerima teks dan imej dan mengembalikan teks.
Is it ready for production?
Ya, tetapi hanya selepas penilaian khusus laluan. Guna pemantauan, fallback, ujian penerimaan khusus tugas, dan log laluan model kerana alias legasi boleh diselesaikan kepada DeepSeek-V4.1-Flash.
Should I use CometAPI or DeepSeek's direct API?
CometAPI berguna apabila satu kunci, satu lapisan pengebilan, dan pertukaran model yang mudah penting. Akses langsung DeepSeek mungkin lebih baik apabila anda memerlukan ciri khusus penyedia seperti semantik rasmi Files API atau harga luar puncak. Uji kedua-dua laluan terhadap beban kerja yang sama.
Conclusion
DeepSeek-V4.1-Flash kini ialah laluan Flash multimodal aktif pada API DeepSeek. Konteks 1M, siling output 384K, sokongan pelbagai antara muka, dan siling 1024 token per imej menjadikannya menarik untuk pemahaman tangkapan skrin, analisis carta, pengkodan visual, dan automasi pelayar atau GUI. Seni bina Vision-Exp dan penanda aras pelancaran dalam artikel ini dikekalkan sebagai konteks sejarah.
Keputusan harus kekal didorong oleh beban kerja. Bukti penanda aras awam untuk model Vision-Exp yang telah ditamatkan adalah terutamanya laporan vendor, alias laluan semasa boleh mengaburi model mana yang melayan permintaan, dan penukaran saiz imej masih boleh mengehadkan tugasan butiran halus. Uji laluan penyedia yang tepat pada imej perwakilan, ukur kos tugas berjaya dan bukannya harga token semata-mata, dan kekalkan fallback sehingga laluan terbukti boleh dipercayai dalam perisian pengikat produksi anda.