
Cara terpantas untuk menggunakan API GLM-5.3 Flash ialah memanggil model melalui endpoint chat-completions serasi OpenAI milik CometAPI. Butiran sambungan disatukan dalam jadual spesifikasi API di bawah; simpan kunci API di pelayan.
• Jawab dahulu: cipta kunci CometAPI, pasang SDK yang serasi OpenAI, hantar permintaan POST ke /v1/chat/completions, kemudian tambah penstriman, visi, output JSON, atau alat hanya selepas permintaan asas berjaya.
Apakah itu API GLM-5.3 Flash?
GLM-5.3 Flash ialah model multimodal asli berkecekapan tinggi daripada keluarga GLM-5 oleh Z.ai. Ia menawarkan penaakulan, konteks panjang, pemahaman visual, dan keupayaan berorientasikan agen melalui chat API. Model ini mengandungi 320B parameter keseluruhan tetapi mengaktifkan 18B setiap token; seni bina itu penting untuk kos, namun pemaju mengalaminya terutamanya sebagai model yang boleh kekal aktif merentasi prompt panjang dan panggilan alat berulang.
Panduan ini sengaja mengekalkan liputan seni bina dan penanda aras secara ringkas. Artikel tinjauan model pendamping telah menerangkan reka bentuk perhatian hibrid, pemberat terbuka, matriks penanda aras pelancaran lengkap, latar belakang harga, dan perbandingan keluarga model. Di sini, fokusnya ialah tingkah laku integrasi dan keputusan produksi.
Spesifikasi API Yang Mempengaruhi Integrasi
| Spesifikasi API | Nilai | Maksud praktikal |
|---|---|---|
| URL Asas | https://api.cometapi.com/v1 | Konfigurasikan ini sekali dalam klien sisi pelayan. |
| Endpoint | POST /v1/chat/completions | Gunakan laluan chat-completions serasi OpenAI. |
| SDK serasi | Klien Python dan JavaScript serasi OpenAI | Guna semula corak klien biasa dengan URL asas CometAPI. |
| Pengesahan | Kunci API Bearer | Simpan kunci dalam pembolehubah persekitaran sisi pelayan atau pengurus rahsia. |
| Kod model | glm-5.3-flash | Gunakan nilai ini tepat dalam badan permintaan. |
| Tetingkap konteks | 1,048,576 token | Sesuai untuk repositori besar, pek dokumen, dan sejarah agen yang panjang. |
| Output maksimum | Sehingga 131,072 token | Tetapkan had lebih rendah khusus aplikasi untuk mengawal kos dan kependaman. |
| Input asli | Teks, imej, video, fail | Sokongan hos-laluan boleh berbeza; sahkan laluan CometAPI tepat sebelum bergantung pada setiap mod. |
| Output | Teks | Model mentafsir media tetapi tidak terus menghasilkan imej atau video. |
| Penaakulan | low, high, max | Gunakan tahap usaha untuk menukar kependaman dan penggunaan token bagi kedalaman. |
| Pemikiran | Sentiasa didayakan | Jangan hantar parameter untuk cuba mematikan pemikiran. |
| Ciri pembangun | Penstriman, panggilan fungsi, caching, output berstruktur | Berguna untuk aplikasi interaktif, agen, dan saluran paip boleh baca mesin. |
• Keupayaan model dan keupayaan gerbang tidak sama. Anggap halaman model CometAPI langsung dan skema API sebagai kontrak untuk laluan yang anda panggil, khususnya untuk video, fail, JSON Schema ketat, dan medan pemikiran khusus penyedia.
Konteks Prestasi Ringkas
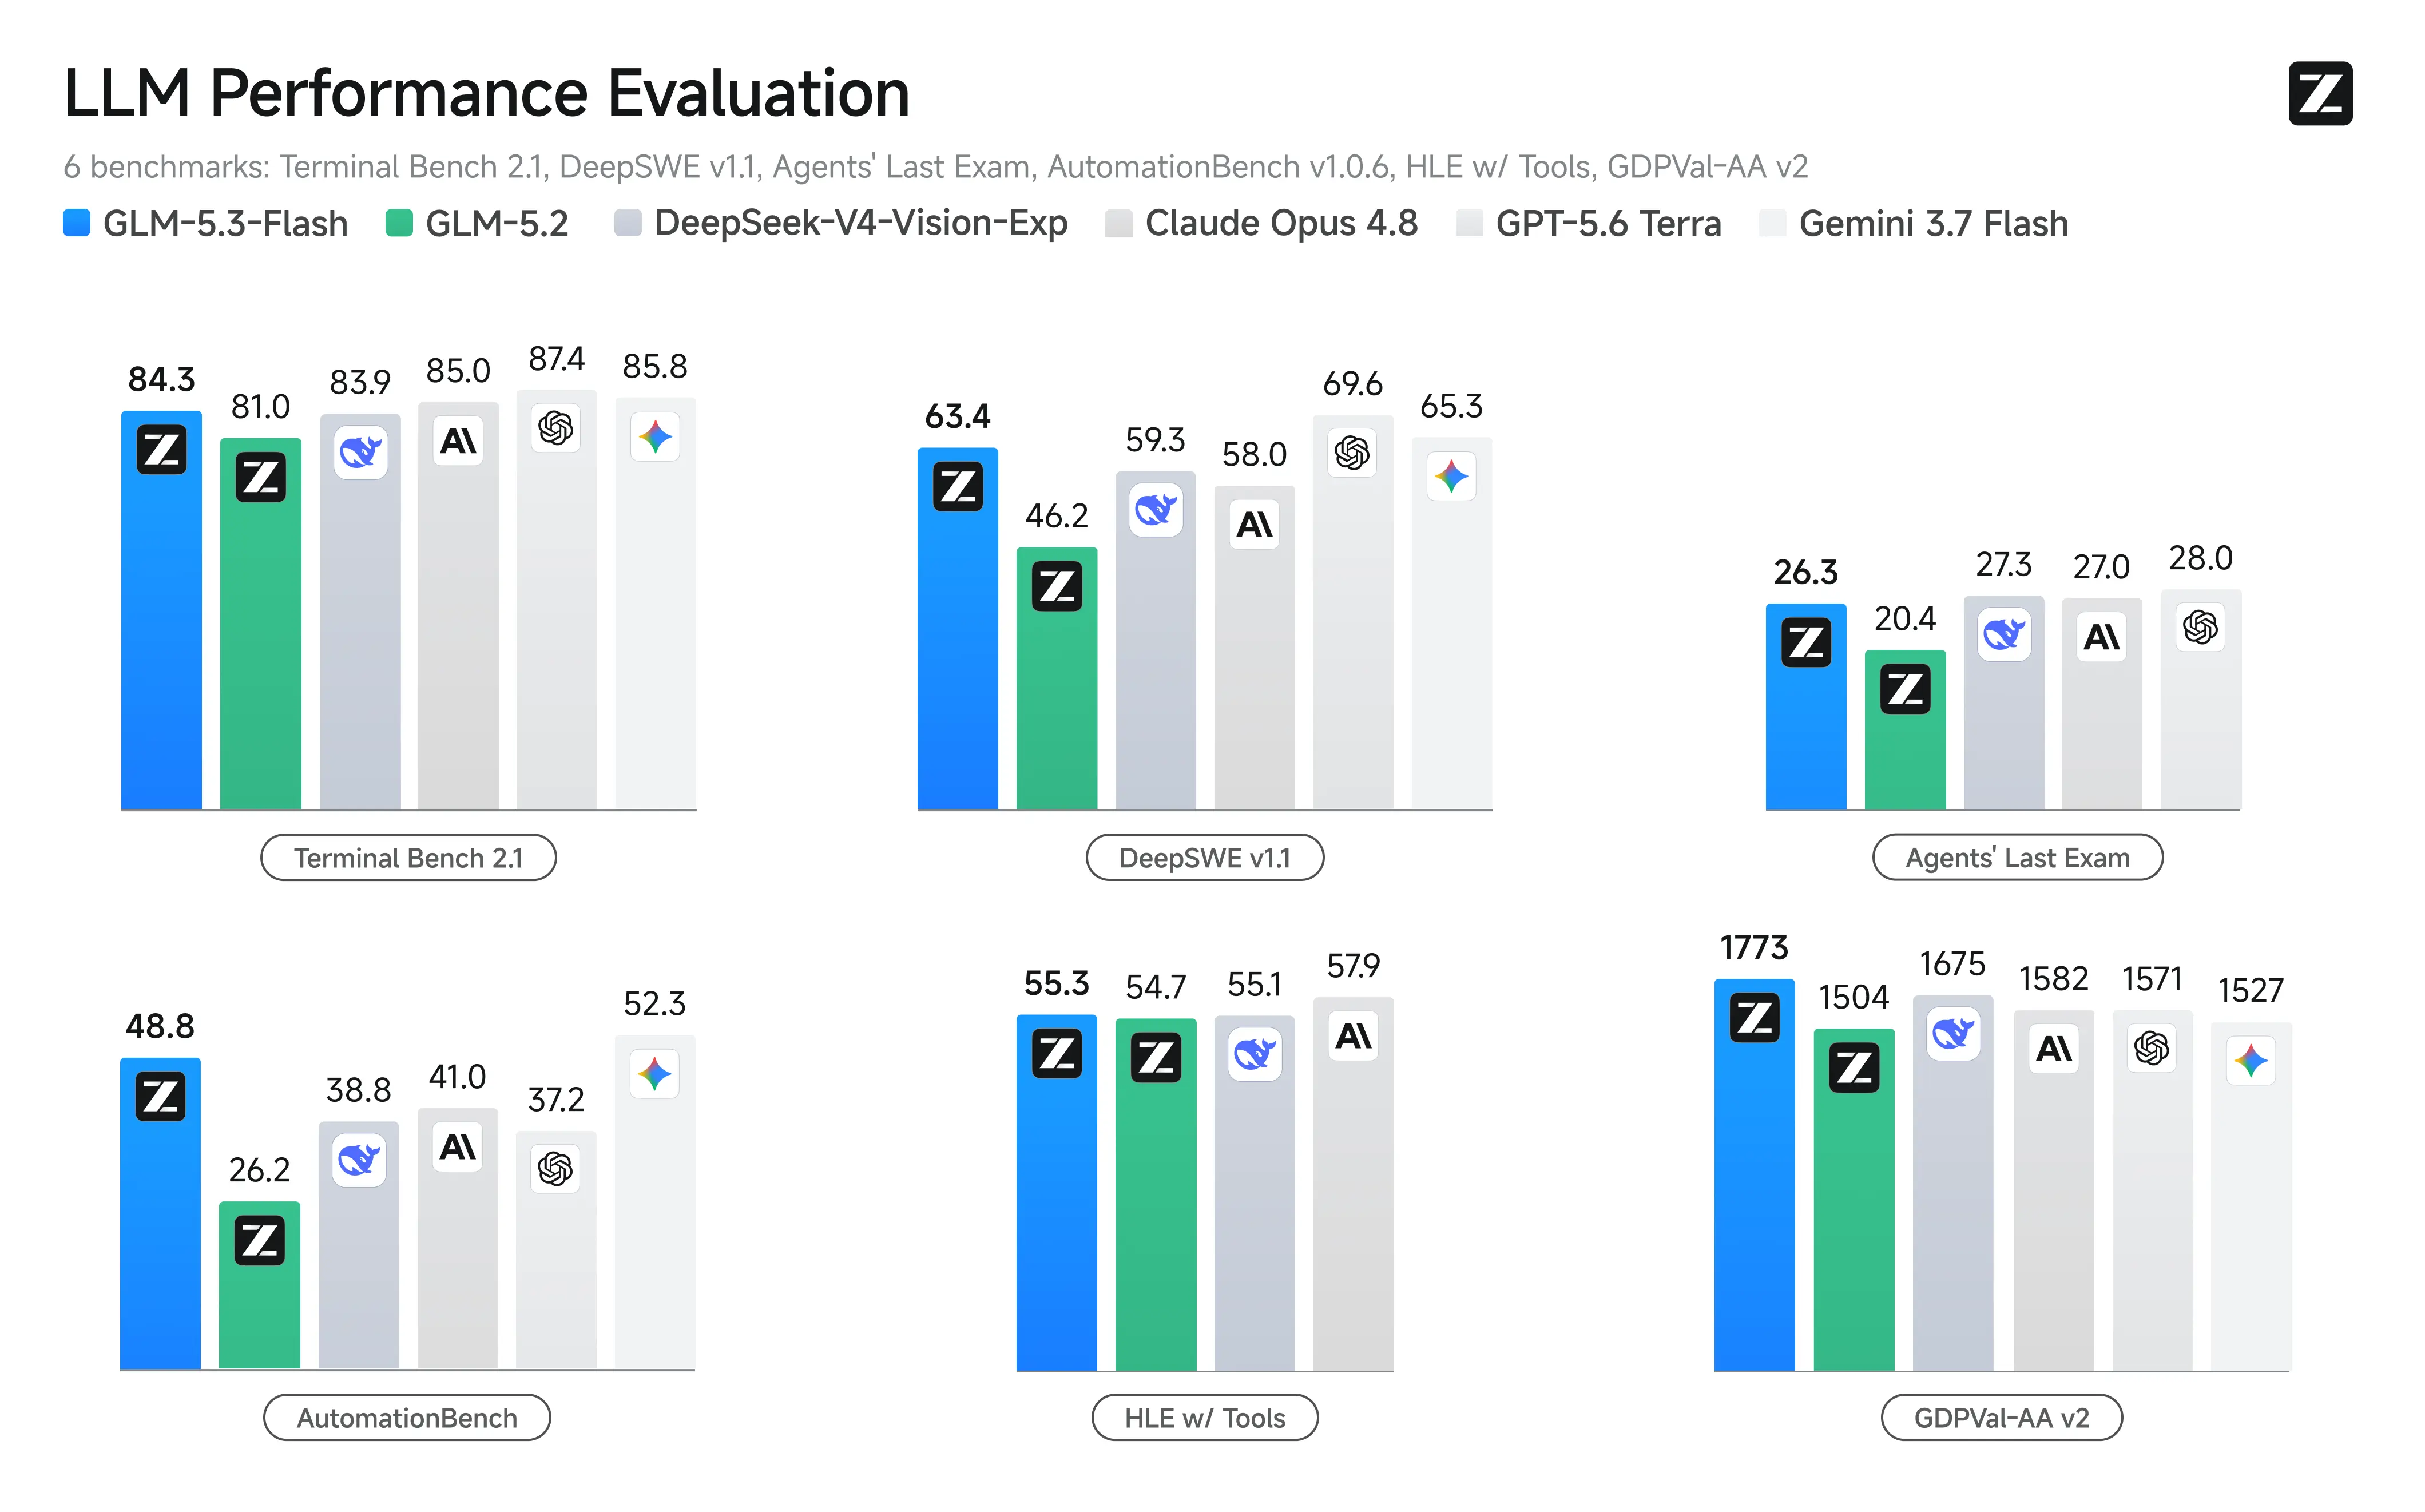
Z.ai melaporkan keputusan pelancaran yang kukuh pada tugasan yang penting untuk pembina API: kerja terminal, kejuruteraan perisian, penggunaan alat, dan automasi. Ini ialah skor yang dilaporkan vendor dengan harness dan dasar alat tertentu, jadi ia membantu mengenal pasti kekuatan berkemungkinan berbanding menubuhkan kedudukan sejagat.
| Penanda aras | GLM-5.3 Flash | Apakah yang disarankan untuk beban kerja API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Sangat sesuai untuk agen pengekodan berpacukan terminal. |
| DeepSWE v1.1 | 63.4 | Menjanjikan untuk kejuruteraan perisian skala repositori. |
| Toolathlon Verified | 78.4 | Isyarat pemilihan dan penggunaan alat yang kukuh. |
| AutomationBench | 48.8 | Automasi berbilang langkah yang dipertingkat berbanding pendahulu. |
Implikasi praktikalnya lebih sempit daripada jadual penanda aras: GLM-5.3 Flash ialah calon yang kuat apabila aliran kerja menggabungkan konteks panjang dengan alat atau maklum balas visual. Untuk perbandingan model yang lengkap, gunakan tinjauan model sedia ada dan bukannya mengulanginya di sini.
• Sumber: • Grafik penanda aras rasmi Z.ai
Grafik penanda aras rasmi membandingkan prestasi GLM-5.3 Flash merentas model dan tetapan usaha. Untuk panduan API ini, ia memberikan konteks prestasi ringkas dan bukannya mengulangi matriks pelancaran lengkap. Aplikasi masih perlu mengukur kejayaan tugasan, kependaman hujung ke hujung, dan jumlah penggunaan token pada prompt sendiri.
Mengapa Menggunakan GLM-5.3 Flash Melalui CometAPI?
CometAPI mendedahkan GLM-5.3 Flash melalui antara muka serasi OpenAI. Ini membolehkan pasukan menggunakan semula corak SDK biasa, memusatkan kelayakan dan pengebilan, serta menukar model tanpa membina semula keseluruhan lapisan permintaan.
• Satu corak integrasi. Klien asas yang sama boleh memanggil model yang disokong berbeza dengan menukar ID model.
• Keterlihatan penggunaan berpusat. Pasukan boleh menyemak penggunaan dan kos tanpa menyelenggara papan pemuka berasingan untuk setiap penyedia.
• Penilaian lebih pantas. Satu harness permintaan boleh membandingkan kualiti respons, kependaman, dan ralat merentas model calon.
• Reka bentuk fallback lebih ringkas. Aplikasi boleh mengekalkan logik cuba semula dan perutusan dalam satu lapisan gerbang.
• Harga laluan tersenarai lebih rendah. Halaman model semasa menyenaraikan $0.06 per juta token input dan $0.20 per juta token output; sahkan halaman langsung sebelum membuat bajet.
Sebelum Anda Bermula
Anda memerlukan akaun CometAPI, kunci API, dan salah satu persekitaran tempatan berikut:
• Python 3.9 atau lebih baharu dengan pip
• Node.js 18 atau lebih baharu dengan npm
• cURL untuk ujian baris arahan minimum
• Jangan sekali-kali meletakkan kunci CometAPI produksi dalam JavaScript pelayar, aplikasi mudah alih, repositori awam, tangkapan skrin, atau log sisi klien. Panggil CometAPI dari pelayan yang dipercayai dan simpan kunci dalam pembolehubah persekitaran atau pengurus rahsia.
Cara Menggunakan API GLM-5.3 Flash dengan CometAPI
Langkah 1: Cipta Kunci API CometAPI
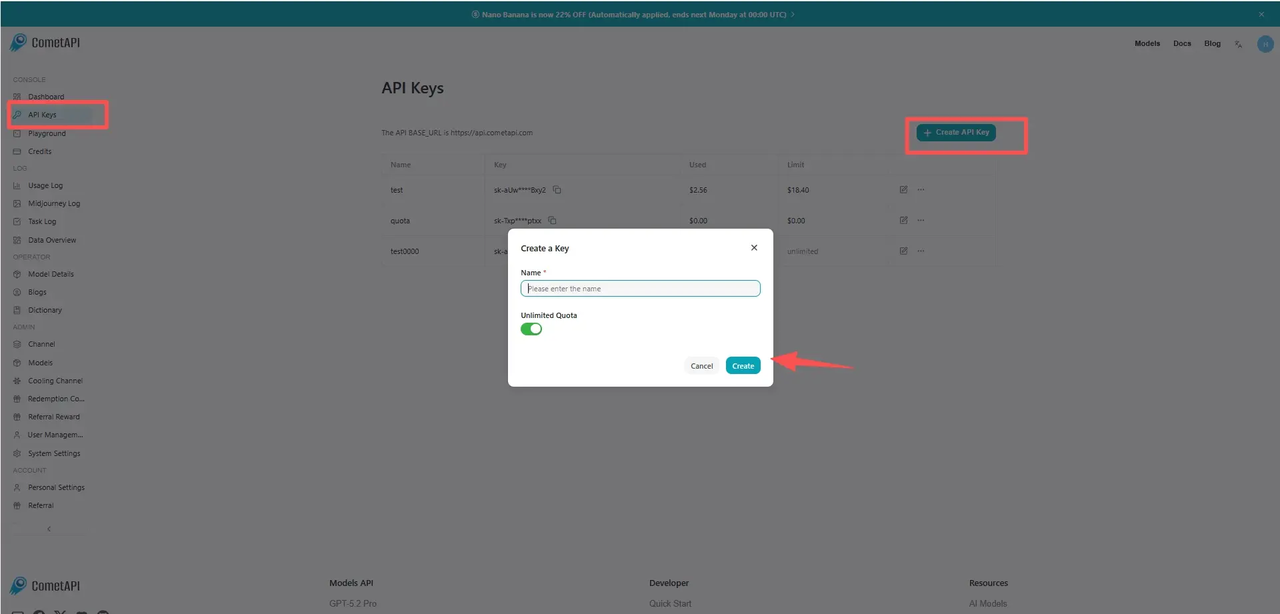
Daftar masuk ke CometAPI, buka konsol kunci API, cipta kunci, dan salin sekali ke aliran kerja pengurusan rahsia anda. Gunakan kunci berasingan untuk pembangunan dan produksi supaya anda boleh memutar atau membatalkan satu persekitaran tanpa mengganggu yang lain.
• Sumber: • Imej panduan kunci API rasmi CometAPI
Langkah 2: Simpan Kunci sebagai Pembolehubah Persekitaran
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Untuk produksi, gantikan sejarah shell dengan rahsia deployment, rahsia kontena, atau kubah terurus.

### Langkah 3: Pasang SDK Serasi OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Langkah 4: Hantar Permintaan Pertama dengan cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "Anda ialah pembantu teknikal yang tepat."
      },
      {
        "role": "user",
        "content": "Terangkan tiga kegunaan praktikal bagi tetingkap konteks satu juta token."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Respons yang berjaya mengandungi mesej pembantu di bawah choices[0].message.content serta metadata penggunaan apabila laluan memulangkannya. Mulakan dengan permintaan kecil ini sebelum menambah parameter pilihan.

### Langkah 5: Panggil API daripada Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Anda ialah pembantu teknikal yang tepat.",
        },
        {
            "role": "user",
            "content": "Semak rancangan migrasi ini dan senaraikan lima risiko teratas.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Langkah 6: Panggil API daripada JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "Anda ialah pembantu teknikal yang tepat." },
    { role: "user", content: "Drafkan senarai semak pelancaran selamat untuk API ini." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Cara Mengawal Usaha Penaakulan

[Dokumentasi model rasmi](https://docs.z.ai/guides/vlm/glm-5.3-flash) menyokong [usaha penaakulan low, high, dan max](https://docs.z.ai/guides/vlm/glm-5.3-flash). [Pemikiran kekal didayakan](https://docs.z.ai/guides/vlm/glm-5.3-flash); tetapan usaha mengubah jumlah bajet penaakulan yang boleh digunakan model.

| Usaha | Beban kerja permulaan yang baik                  | Pertukaran                                             |
| ----- | ------------------------------------------------- | ------------------------------------------------------ |
| low   | Pengelasan, penulisan semula, pengekstrakan ringkas | Kependaman lebih rendah dan penggunaan token output kurang; kedalaman lebih rendah. |
| high  | Semakan kod, perancangan, analisis dokumen        | Lalai seimbang untuk banyak tugasan produksi.         |
| max   | Nyahpepijat kompleks, agen alat, penaakulan sukar | Kedalaman tertinggi; berpotensi lebih tinggi kependaman dan kos. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Kenal pasti mod kegagalan tersembunyi dalam rancangan pelancaran teragih ini.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

• Jika SDK terpasang mendedahkan reasoning_effort sebagai argumen kelas pertama, anda boleh lalukannya terus. Jika laluan CometAPI menolak medan khusus penyedia, keluarkan ia dan gunakan lalai laluan. Jangan cuba mematikan pemikiran.

## Cara Menstrim Respons

Penstriman berguna untuk sembang, pembantu pengekodan, dan analisis panjang kerana ia membolehkan antara muka memaparkan output sebaik sahaja ia tiba. Ia tidak mengurangkan jumlah token yang dijana, jadi kekalkan had output dan kawalan kos yang sama.

### Penstriman Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Cipta rancangan migrasi pangkalan data berperingkat."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Penstriman JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Cipta rancangan migrasi pangkalan data berperingkat." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Tangani pembatalan. Hentikan pembacaan strim apabila klien terputus dan batalkan kerja huluan apabila disokong.

• Penimbal dengan selamat. Jangan anggap setiap cebisan mengandungi satu perkataan penuh, token JSON, atau objek panggilan alat yang lengkap.

• Rekod penggunaan akhir. Penggunaan mungkin hanya muncul dalam acara terakhir atau metadata khusus laluan.

## Cara Menghantar Imej

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) menerima kandungan visual melalui blok image_url dalam messages[].content[]. Dokumentasi rasmi mengesyorkan URL imej yang boleh dicapai atau Data URL Base64. Halaman model CometAPI mengenal pasti keupayaan imej-ke-teks, namun aplikasi masih perlu menguji format, saiz fail, dan tingkah laku laluan sebelum produksi.

### Analisis URL Imej

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Semak papan pemuka ini. Kenal pasti isu kebolehgunaan, "
                        "metrik yang mengelirukan, dan kemungkinan risiko kualiti data."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Hantar Imej Tempatan sebagai Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Ekstrak tajuk carta, paksi, dan aliran utama.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Potong ruang putih yang tidak relevan sebelum mengekod imej.

• Skala turun imej yang jauh lebih besar daripada maklumat yang diperiksa.

• Tanyakan soalan visual yang khusus dan bukannya meminta penerangan umum.

• Jangan anggap URL halaman web awam adalah URL imej langsung.

• Uji tertib berbilang imej kerana setiap imej hendaklah dirujuk dengan jelas dalam prompt.

## Cara Meminta JSON Berstruktur

Output berstruktur berguna apabila komponen seterusnya ialah kod dan bukannya pembaca manusia. Gunakan skema yang sempit, sahkan hasilnya, dan kekalkan fallback untuk laluan yang tidak mendedahkan JSON Schema ketat dalam bentuk yang sama.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Hanya pulangkan JSON yang sah.",
        },
        {
            "role": "user",
            "content": (
                "Ekstrak 'equipment', 'severity', 'observed symptom', dan 'next action' "
                "daripada laporan ini: Feeder 12 menunjukkan lonjakan arus sifar-juzuk berulang "
                "selepas hujan; periksa penebatan dan bandingkan bahagian bersebelahan."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Mod JSON tidak menghapuskan keperluan untuk pengesahan. Semak medan wajib, jenis, nilai dibenarkan, dan panjang maksimum sebelum menyimpan hasil atau mencetuskan sistem lain.

## Cara Menggunakan Panggilan Fungsi

Panggilan fungsi membolehkan model memutuskan bila ia memerlukan data luaran, manakala kod aplikasi kekal bertanggungjawab untuk kebenaran dan pelaksanaan. Corak yang selamat ialah: model mencadangkan panggilan alat, pelayan mengesahkannya, pelayan menjalankan alat, dan model menerima hasilnya.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Hanya pulangkan JSON yang sah.",
        },
        {
            "role": "user",
            "content": (
                "Ekstrak 'equipment', 'severity', 'observed symptom', dan 'next action' "
                "daripada laporan ini: Feeder 12 menunjukkan lonjakan arus sifar-juzuk berulang "
                "selepas hujan; periksa penebatan dan bandingkan bahagian bersebelahan."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Sahkan argumen. Anggap JSON panggilan alat sebagai input tidak dipercayai.

• Kuatkuasakan kebenaran. Model tidak memutuskan apa yang pengguna semasa dibenarkan lakukan.

• Asingkan alat baca dan tulis. Minta pengesahan untuk tindakan merosakkan atau yang kelihatan ke luar.

• Hadkan inventori alat. Dedahkan hanya alat yang relevan dengan aliran kerja semasa.

• Hadkan gelung. Tetapkan maksimum pusingan alat, jumlah token, masa berlalu, dan kos.

## Parameter API [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Parameter              | Tujuan                             | Panduan praktikal                                        |
| ---------------------- | ---------------------------------- | -------------------------------------------------------- |
| model                  | Memilih laluan model               | Gunakan glm-5.3-flash.                                   |
| messages               | Perbualan dan input multimodal     | Kekalkan tertib peranan yang sah; kekalkan mesej alat diperlukan. |
| max_completion_tokens  | Menghadkan output yang dijana      | Tetapkan mengikut aliran kerja dan bukan bergantung pada maksimum model. |
| temperature            | Tingkah laku pensampelan           | Syor rasmi ialah 1.                                      |
| top_p                  | Pensampelan nucleus                | Syor rasmi ialah 0.95.                                   |
| reasoning_effort       | Bajet penaakulan                   | Gunakan low, high, atau max; sokongan laluan perlu diuji. |
| stream                 | Output berperingkat                | Gunakan true untuk respons interaktif.                   |
| tools                  | Definisi fungsi                    | Kekalkan skema sempit dan sahkan setiap panggilan.       |
| tool_choice            | Mengawal pemilihan alat            | Mulakan dengan auto kecuali aliran kerja memerlukan alat. |
| response_format        | Meminta output boleh baca mesin    | Sahkan sokongan dan JSON yang dipulangkan.               |

## Z.ai Direct API vs CometAPI

Kedua-dua laluan boleh sesuai. Keputusan kebanyakannya tentang pemilikan integrasi, keluasan model, pengebilan, dan seberapa pantas aplikasi memerlukan ciri asli penyedia.

| Dimensi        | Z.ai Direct API                               | CometAPI                                             | Hasil praktikal                                                 |
| -------------- | --------------------------------------------- | ---------------------------------------------------- | --------------------------------------------------------------- |
| Akaun dan kunci| Akaun dan kunci Z.ai                          | Akaun dan kunci CometAPI                             | Kunci tidak boleh saling diganti.                               |
| Corak SDK      | Serasi OpenAI                                 | Serasi OpenAI                                        | Banyak kod klien boleh digunakan semula.                        |
| Liputan model  | Keluarga model Z.ai                           | Pelbagai penyedia dan keluarga model                 | CometAPI berguna untuk perutusan dan perbandingan.              |
| Ciri asli      | Akses terawal kepada tingkah laku khusus penyedia | Bergantung pada pendedahan gerbang dan pass-through  | Uji medan lanjutan pada laluan terpilih.                        |
| Pengebilan     | Khusus penyedia                               | Dipusatkan merentas model disokong                   | Pengebilan bersepadu boleh memudahkan operasi berbilang model.  |
| Reka bentuk fallback | Memerlukan integrasi penyedia lain      | Boleh kekal dalam satu lapisan gerbang               | CometAPI boleh mengurangkan geseran pertukaran.                 |
| Kesuaian terbaik| Komitmen mendalam kepada keupayaan asli Z.ai | Akses bersepadu, penilaian, dan perutusan produksi   | Pilih berdasarkan seni bina sistem, bukan pemenang generik.     |

Gunakan API langsung apabila parameter atau ciri produk asli penyedia yang terbaharu adalah penting. Gunakan CometAPI apabila satu klien, pengebilan bersepadu, dan keupayaan membanding atau menggantikan model lebih penting. Untuk produksi, jalankan suite ujian wakil yang sama terhadap laluan tepat yang anda rancang untuk dilancarkan.

## Anggaran Kos dan Peruntukan Token

Halaman model CometAPI semasa menyenaraikan [$0.06 per juta token input](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) dan [$0.20 per juta token output](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). Pada kadar tersebut, anggaran kos permintaan ialah:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Beban kerja             | Token input | Token output | Anggaran kos |
| ----------------------- | ----------- | ------------ | ------------ |
| Soalan pendek           | 2,000       | 400          | $0.00020     |
| Semakan kod             | 50,000      | 4,000        | $0.00380     |
| Analisis dokumen besar  | 250,000     | 10,000       | $0.01700     |
| Larian agen panjang     | 800,000     | 30,000       | $0.05400     |

• Harga sensitif masa. Sahkan kadar input, input cache, dan output langsung sebelum penerbitan atau bajet produksi. Penaakulan dan gelung alat boleh meningkatkan output bil dan input berulang, jadi anggar aliran kerja lengkap dan bukannya satu jawapan kelihatan.

## Amalan Terbaik API GLM-5.3 Flash untuk Produksi

### Kawalan Kos dan Kependaman

#### Had output

Tetapan generasi penanda aras dan had API produksi adalah berbeza. Penilaian HLE yang disebut menggunakan panjang generasi maksimum 163,840 token, manakala beberapa penilaian menggunakan output 64K; tiada tetapan ini membuktikan bahawa setiap laluan API hos boleh memulangkan lebih daripada 100,000 token. Tetapkan had daripada skema laluan langsung dan bajet aliran kerja. Gunakan had kecil untuk pengelasan dan pengekstrakan, had sederhana untuk analisis, dan had lebih besar hanya untuk tugasan bentuk panjang atau agen yang eksplisit.

**Kawalan konteks**

Tetingkap satu juta token ialah kapasiti, bukan sasaran. Dapatkan fail berkaitan, alih keluar log pendua, letakkan arahan stabil berhampiran permulaan, dan ukur sama ada konteks tambahan meningkatkan kejayaan tugasan.

### Keadaan dan Kebolehpercayaan

#### Kekalkan keadaan

Simpan mesej pembantu lengkap yang diperlukan untuk pusingan seterusnya, termasuk panggilan alat dan medan khusus laluan yang telah disahkan aplikasi anda. Menggugurkan sejarah berstruktur boleh memecahkan gelung alat berbilang langkah walaupun teks yang kelihatan kelihatan lengkap.

#### Cuba semula secara terpilih

• Cuba semula ralat sementara 429, 500, 502, 503, dan tamat masa rangkaian dengan backoff eksponen dan jitter.

• Jangan membuta tuli cuba semula ralat pengesahan, parameter tidak sah, atau permintaan bersaiz berlebihan.

• Lampirkan ID permintaan aplikasi supaya kerja pendua boleh dikenali.

• Gunakan kawalan idempotensi di sekitar operasi tulis luaran, walaupun permintaan model itu sendiri dicuba semula.

### Keselamatan dan Pengesahan

#### Sahkan output boleh baca mesin

Pengesahan skema, semakan nilai dibenarkan, had panjang, dan peraturan domain perlu berada di antara model dan setiap pangkalan data, baris gilir, atau API luaran. Objek JSON yang sah secara sintaksis masih boleh tidak lengkap atau tidak selamat.

#### Benarkan panggilan alat

Anggap panggilan alat yang dicadangkan model sebagai permintaan tidak dipercayai: sahkan argumen, kuatkuasakan kebenaran pengguna, asingkan operasi baca dan tulis, dan minta pengesahan untuk tindakan merosakkan.

### Kebolehcerapan dan Fallback

#### Ukur aliran kerja

• Kejayaan tugasan atau kadar penerimaan manusia

• Masa ke token pertama dan jumlah kependaman

• Token input, input cache, penaakulan, dan output

• Kiraan panggilan alat dan kadar kegagalan alat

• Cuba semula, had kadar, dan ralat penyedia

• Kos per tugasan siap dan bukan hanya kos per panggilan API

#### Reka bentuk fallback

Pilih fallback mengikut beban kerja, bukan reputasi. Fallback teks sahaja mungkin boleh diterima untuk pengekstrakan dokumen tetapi gagal untuk tugasan berasaskan tangkapan skrin. Tentukan input dan skema alat yang boleh dibawa, parameter yang mesti dikeluarkan, dan bila pengguna harus melihat ralat boleh pulih dan bukannya pertukaran model automatik.

## Ralat Biasa dan Penyelesaian Masalah

| Gejala                 | Punca berkemungkinan                                              | Apa yang perlu diperiksa                                                             |
| ---------------------- | ----------------------------------------------------------------- | ------------------------------------------------------------------------------------ |
| 401 Unauthorized       | Kunci hilang, tidak terbentuk, atau dibatalkan                    | Sahkan pengepala Authorization dan pembolehubah persekitaran sisi pelayan.          |
| 404 atau model tidak ditemui | ID model salah atau laluan tidak tersedia                    | Gunakan glm-5.3-flash dan sahkan ketersediaan pada halaman model langsung.          |
| 429 Rate Limit         | Kuota permintaan atau token melebihi                              | Kurangkan, kurangkan serentak, semak had akaun, dan cuba semula dengan jitter.      |
| Parameter tidak disokong | Medan khusus penyedia tidak didedahkan oleh gerbang             | Keluarkan medan pilihan, kemudian tambah semula satu demi satu.                     |
| Panjang konteks melebihi | Prompt ditambah output diminta melebihi had laluan              | Potong, dapatkan semula, ringkaskan, atau rendahkan max_completion_tokens.          |
| Imej tidak sah         | URL tidak boleh diakses, format tidak disokong, atau Base64 rosak | Uji URL imej HTTPS langsung dan betulkan awalan MIME.                                |
| JSON strim rosak       | Cebisan dihurai sebagai objek lengkap                             | Penimbal strim dan huraikan hanya selepas payload JSON lengkap diterima.            |
| Gelung alat tidak berakhir | Tiada bajet langkah atau hasil alat mengelirukan               | Hadkan pusingan, perbaiki penerangan alat, dan pulangkan ralat alat yang jelas.     |

## Bilakah Anda Patut Menggunakan API GLM-5.3 Flash?

### Kesesuaian Baik

• Pemahaman kod skala repositori dan semakan berbilang fail

• Pengekodan visual, analisis tangkapan skrin, dan QA antara muka

• Pek dokumen panjang dan sintesis bersandarkan bukti

• Agen menggunakan alat dengan perancangan dan pengesahan berulang

• Aliran kerja volum tinggi di mana kos token mempengaruhi ekonomi unit

• Aplikasi yang mendapat manfaat daripada menukar atau membanding model melalui satu gerbang

### Gunakan Laluan atau Model Lain Apabila

• Produk memerlukan output imej atau video dan bukannya output teks.

• Tugasan ialah pengelasan kecil berisiko rendah yang boleh ditangani model lebih kecil dengan boleh dipercayai.

• Ciri asli penyedia adalah mandatori tetapi tidak didedahkan pada laluan gerbang.

• Aliran kerja tidak boleh menanggung pemikiran sentiasa aktif atau profil kependaman berkaitannya.

• Aplikasi belum menguji model pada alat, data, dan kes kegagalan sendiri.

## Soalan Lazim (FAQ)

###

### Apakah yang patut saya sahkan pada laluan CometAPI tepat sebelum pelancaran?

Sahkan ketersediaan model, format multimodal diterima, output maksimum, medan penaakulan, tingkah laku output berstruktur, had kadar, dan harga semasa dengan permintaan yang mewakili.

### Metrik manakah yang patut dikesan oleh penilaian produksi?

Jejaki kejayaan tugasan, masa ke token pertama, jumlah kependaman, token input dan output, kegagalan panggilan alat, kadar cuba semula, dan kos per aliran kerja yang disiapkan, bukan hanya kos per panggilan API.

### Bagaimana saya patut memilih antara Z.ai langsung dan CometAPI?

Gunakan Z.ai langsung apabila akses segera kepada tingkah laku asli penyedia adalah penting. Gunakan CometAPI apabila pengesahan bersepadu, pengebilan, perbandingan model, dan fallback peringkat gerbang lebih penting.

### Apakah yang menjadikan fallback selamat?

Fallback yang selamat menerima mod input yang sama, mengekalkan skema alat yang diperlukan, mengalih keluar parameter yang tidak disokong, kekal dalam sempadan kebenaran tugas, dan gagal dengan jelas apabila tingkah laku tidak dapat dikekalkan.

## Kesimpulan

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) paling berguna melalui API apabila konteks panjang, input visual, penaakulan, dan penggunaan alat adalah sebahagian daripada satu aliran kerja. Integrasi CometAPI asas adalah kecil: satu kunci sisi pelayan, satu klien serasi OpenAI, ID model [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/), dan endpoint chat-completions. Kualiti produksi datang daripada segala-galanya di sekeliling permintaan itu: prompt berlingkup, had output, pengesahan skema, kebenaran alat, cuba semula, kebolehcerapan, dan penilaian khusus beban kerja.

Mulakan dengan panggilan teks pendek, tambah satu keupayaan lanjutan pada satu masa, dan uji keseluruhan perjalanan pengguna sebelum skala. Sahkan halaman model [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) langsung untuk ketersediaan semasa, tingkah laku laluan yang disokong, dan harga.

## Metadata SEO

**Meta title:** Cara Menggunakan API GLM-5.3 Flash: Panduan Pembangun

**Meta description:** Ketahui cara menggunakan API GLM-5.3 Flash dengan CometAPI, termasuk contoh Python dan JavaScript, visi, penstriman, alat, output JSON, dan amalan terbaik.

**Keywords:** GLM-5.3 Flash API, cara menggunakan GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, tutorial API GLM, API multimodal, API penaakulan

**URL slug:** how-to-use-glm-5-3-flash-api