
TL;DR
API GPT-6 Astra dalam CometAPI paling sesuai untuk aliran kerja sukar yang kaya alat, di mana kualiti penyempurnaan lebih penting daripada harga token terendah. Model ini menyokong tetingkap konteks 1,050,000 token, 128,000 token output, input imej, output berstruktur, penstriman, pemanggilan fungsi, dan lima tahap penaakulan. Mulakan dengan Responses API, penaakulan medium, set alat yang minimum, serta penilaian yang mengukur kos per tugasan diterima. Kadar token asas semasa CometAPI adalah 20% lebih rendah berbanding kadar OpenAI yang sepadan.
Perkara Utama
- Astra dioptimumkan untuk kerja hujung-ke-hujung yang sukar, termasuk pengaturcaraan, penggunaan komputer, penyelidikan, dan automasi profesional.
- Gunakan Responses API untuk integrasi baharu berasaskan alat.
- Pilih tahap penaakulan terendah yang lulus penilaian beban kerja anda;
nonetidak disokong. - Kekalkan prompt di bawah ambang konteks panjang 272K bila boleh, kerana jadual harga lebih tinggi akan digunakan pada keseluruhan permintaan.
- Penilaian awam menunjukkan skor lebih tinggi dan kos API per tugasan yang lebih rendah dalam beberapa beban kerja sukar, tetapi penghalaan produksi harus berdasarkan kadar tugasan diterima anda sendiri.
Panduan Pantas API GPT-6 Astra
- Cipta kunci CometAPI dan simpan dalam pemboleh ubah persekitaran.
- Pasang SDK OpenAI.
- Hantar permintaan Responses API dengan
model="gpt-6-astra". - Tambah kontrak output ketat dan sahkan hasilnya.
- Sambungkan hanya alat yang diperlukan oleh aliran kerja.
- Uji integrasi pada tugasan representatif sebelum produksi.
Apakah GPT-6 Astra API?
Model OpenAI paling berkeupayaan untuk kerja hujung-ke-hujung paling sukar ini direka untuk penaakulan kompleks, pengaturcaraan, penggunaan komputer, penyelidikan, dan penciptaan dokumen. Dalam aplikasi API, nilai Astra datang daripada mengekalkan niat sepanjang aliran kerja panjang, memanggil alat, mentafsir hasil, dan meneruskan sehingga kriteria penyiapan aplikasi dipenuhi.
Spesifikasi GPT-6 Astra API
| Spesifikasi OpenAI | GPT-6 Astra |
|---|---|
| ID model | gpt-6-astra |
| Tetingkap konteks | 1,050,000 token |
| Output maksimum | 128,000 token |
| Tarikh potongan pengetahuan | April 30, 2026 |
| Input dan output | Input teks dan imej; output teks |
| Usaha penaakulan | low, medium, high, xhigh, max |
| Ciri disokong | Penstriman, pemanggilan fungsi, output berstruktur |
| Alat Responses API | Carian web, carian fail, penjanaan imej, jurubahasa kod, shell dihoskan, Apply Patch, penggunaan komputer, MCP, dan carian alat |
| Penalaan halus | Tidak disokong |
Cabaran integrasi ialah orkestrasi: sediakan konteks yang betul, jalankan alat yang diminta, periksa hasilnya, dan hentikan apabila kriteria penyiapan aplikasi dipenuhi.
GPT-6 Astra API vs GPT-5.6 Sol: Apa Yang Baharu?
Panduan model terkini OpenAI menerangkan Astra sebagai lebih kuat untuk aliran kerja berbilang langkah yang sukar sambil kerap menggunakan lebih sedikit token output. Ia juga menambah kawalan penting untuk ejen jangka panjang: pemanggilan alat tak segerak, pengemudian pertengahan giliran, perubahan penaakulan sepanjang perbualan, dan pemantauan ketidakselarasan.
| Dimensi | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Peranan utama | Kerja hujung-ke-hujung paling sukar | Kerja profesional kompleks pada kos token lebih rendah |
| Konteks / output maks | 1.05M / 128K | 1.05M / 128K |
| Tarikh potongan pengetahuan | April 30, 2026 | February 16, 2026 |
| Pemanggilan alat tak segerak | Disokong | Guna koordinasi hasil alat konvensional |
| Pengemudian pertengahan giliran | Disokong melalui Responses WebSocket | Guna giliran seterusnya atau mula semula diurus aplikasi |
| Ubah penaakulan sepanjang perbualan | configuration_update dalam aliran serasi | Tetapkan usaha pada aras permintaan |
| Penaakulan none | Tidak disokong | Disokong |
| Input / output OpenAI Standard | $10 / $50 per 1M | $4 / $20 per 1M |
| Peranan penghalaan terbaik | Eskalasi untuk kerja berkerumitan tinggi | Lalai untuk trafik kompleks yang lebih luas |
Peningkatan ini bukan pengganti menyeluruh. Gunakan Sol apabila ia boleh menyelesaikan tugasan dengan boleh dipercayai; halakan ke Astra apabila kedalaman alat, konteks panjang, cubaan semula, atau pembetulan manusia menjadikan model lebih murah itu lebih mahal dalam praktik.
Mengapa Menggunakan GPT-6 Astra Melalui CometAPI?
GPT-6 Astra dalam CometAPI menggunakan laluan /v1/responses serasi OpenAI. Kadar $8/M input dan $40/M output untuk konteks pendek adalah 20% lebih rendah daripada kadar OpenAI Standard $10/M dan $50/M yang sepadan.
Integrasi SDK OpenAI sedia ada boleh mengekalkan perpustakaan klien sambil menukar kunci, base_url, dan ID model. Gunakan gerbang yang sama apabila menghala kerja yang sesuai ke GPT-5.6 Sol.
Langkah 1: Dapatkan Kunci API CometAPI
Cipta kunci dalam papan pemuka CometAPI dan simpan di luar kod sumber. Gunakan pengurus rahsia penggunaan dalam produksi.
export COMETAPI_KEY="your_api_key"
$env:COMETAPI_KEY = "your_api_key"
Langkah 2: Pasang SDK OpenAI
Pasang SDK terkini untuk bahasa aplikasi anda.
python -m pip install -U openai
npm install openai
Langkah 3: Hantar Permintaan Pertama Anda
Gunakan /v1/responses untuk integrasi baharu, terutamanya apabila aliran kerja akan menambah alat atau output berstruktur.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=120.0,
    max_retries=2,
)

response = client.responses.create(
    model="gpt-6-astra",
    input="Give three practical ways to reduce API latency.",
    reasoning={"effort": "medium"},
)

if response.status != "completed":
    raise RuntimeError(f"Unexpected status: {response.status}")

print(response.output_text)
Langkah 4: Uji Sebelum Produksi
Jalankan tugasan representatif melalui kedua-dua laluan calon dan laluan sandaran. Rekod kadar tugasan diterima, latensi, cubaan semula, token input dan output, kegagalan alat, dan masa pembetulan manusia. Naik taraf Astra hanya apabila hasilnya memperbaiki ekonomi penyiapan sebenar aliran kerja.
Jangan anggap prompt demo yang berjaya sebagai pengesahan produksi. Sertakan input samar, kegagalan alat, data hilang, dan permintaan jangka panjang dalam set ujian.
Cara Memilih Usaha Penaakulan
Tahap penaakulan yang disokong ialah low, medium, high, xhigh, dan max. Gunakan tahap terendah yang secara konsisten memenuhi kriteria penerimaan anda.
| Usaha | Titik permulaan praktikal |
|---|---|
| low | Pengelasan, penulisan semula, dan pengekstrakan mudah |
| medium | Pembangunan umum, analisis, dan kebanyakan penilaian awal |
| high | Penyahpepijatan kompleks, seni bina, dan sintesis berbilang sumber |
| xhigh | Penyelidikan sukar dan kerja pengaturcaraan panjang berbilang tahap |
| max | Sebilangan kecil tugasan paling sukar selepas penilaian |
Cara Menggunakan Input Imej
Gunakan URL imej yang boleh diakses atau fail muat naik yang disokong. Gabungkan imej dengan tugasan pemeriksaan khusus dan bukan permintaan penerangan umum.
vision = client.responses.create(
    model="gpt-6-astra",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "Identify one UI defect and propose a fix."},
            {"type": "input_image", "image_url": os.environ["SCREENSHOT_URL"]}
        ]
    }]
)

print(vision.output_text)
Cara Menggunakan Output Berstruktur dan Menstrim Respons
Output berstruktur menyediakan kontrak boleh dibaca mesin; penstriman meningkatkan kebolehrasaan responsif. Mereka menyelesaikan masalah berbeza dan boleh digunakan bersama. Peristiwa kitar hayat dan delta teks harus dikendalikan secara berasingan.
stream = client.responses.create(
    model="gpt-6-astra",
    input="Create a deployment checklist.",
    stream=True,
)

completed = False
for event in stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="", flush=True)
    elif event.type == "response.completed":
        completed = True
    elif event.type in {"response.failed", "response.incomplete", "error"}:
        raise RuntimeError(event.type)

if not completed:
    raise RuntimeError("Stream closed before completion")
Cara Mengekalkan Perbualan Berkeadaan
Untuk sejarah mudah alih, hantar semula input pengguna dan item output model yang diperlukan oleh giliran seterusnya. Di tempat yang disokong penyedia, previous_response_id boleh merujuk kepada respons tersimpan sebaliknya.
history = [{"role": "user", "content": "Give three latency improvements."}]
history.extend(
    item.model_dump(exclude={"id"}, exclude_none=True)
    for item in response.output
)
history.append({"role": "user", "content": "Turn them into a checklist."})

follow_up = client.responses.create(
    model="gpt-6-astra",
    input=history,
)
print(follow_up.output_text)
Cara Menggunakan Pemanggilan Fungsi
Gelung fungsi lengkap mempunyai empat bahagian: takrif skema, terima panggilan alat, laksanakannya dalam aplikasi anda, dan kembalikan item function_call_output dengan call_id asal. Kekalkan kebenaran alat minimum dan sahkan setiap argumen sebelum pelaksanaan.
import json

history = [{"role": "user", "content": "Check order A-1042."}]
turn = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
history.extend(item.model_dump(exclude={"id"}, exclude_none=True) for item in turn.output)

for item in turn.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        tool_result = {"order_id": args["order_id"], "status": "shipped"}
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(tool_result),
        })

final = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
print(final.output_text)
Cara Menggunakan Pemanggilan Alat Tak Segerak
Pemanggilan alat tak segerak membolehkan Astra meneruskan kerja bebas sementara fungsi atau alat tersuai jangka panjang sedang menunggu. Tetapkan async: true dalam takrif alat, kekalkan call_id asal, dan kembalikan hasil apabila kerja luaran selesai. Aplikasi anda kekal bertanggungjawab untuk barisan kerja, dasar had masa, idempotensi, dan pemulihan.
Jangan serahkan kerja jangka panjang yang sama lagi hanya kerana tetingkap pengundian tamat. Simpan ID kerja dan sambung semula pengambilan.
Cara Meminta GPT-6 Astra API
Panduan prompt OpenAI menekankan inisiatif, keutamaan arahan, gaya, pendelegasian, dan pengesahan terkalibrasi. Prompt produksi yang berguna harus menyatakan tugasan, sumber yang ada, ujian penyiapan, sempadan, format yang dijangka, dan cara mengendalikan maklumat hilang.
| Komponen prompt | Apa yang perlu dinyatakan |
|---|---|
| Tugasan | Hasil konkrit yang perlu dihasilkan |
| Sumber | Fail, alat, data, dan konteks yang boleh digunakan |
| Ujian penyiapan | Syarat yang menjadikan kerja selesai |
| Sempadan | Tindakan yang dibenarkan, dilarang, atau memerlukan kelulusan |
| Gaya dan format | Panjang, struktur, nada, dan skema output |
| Ketidakpastian | Apa yang boleh disimpulkan dan apa yang mesti diperjelas |
| Pengesahan | Semakan yang diperlukan dan bila harus berhenti menguji |
Task: Review this API design and identify the three highest-impact migration risks.
Resources: Use the attached schema and deployment notes.
Completion test: Return three risks, evidence for each, and one acceptance test per risk.
Boundaries: Do not change production systems. Infer routine implementation details.
Clarification rule: Ask only if a missing requirement would materially change the result.
Style: Use concise prose and a final three-row table.
Verification: Check that every risk has an executable acceptance test.
Penanda Aras GPT-6 Astra: Skor Lebih Tinggi, Kurang Token
Penilaian awam paling berguna apabila kualiti dan ekonomi tugasan dibaca bersama. Skor penanda aras di bawah menunjukkan di mana peningkatan Astra besar; penjimatan yang dilaporkan ialah anggaran khusus konfigurasi, bukan jaminan untuk setiap beban kerja.
| Penilaian diterbitkan | Astra | Sol | Perbezaan |
|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | +23.3 mata |
| OSWorld 2.0 | 72.6% | 65.7% | +6.9 mata |
| Terminal-Bench 4.0 | 57.9% | 37.3% | +20.6 mata |
| MRCR v2, 512K-1M | 96.3% | 73.8% | +22.5 mata |
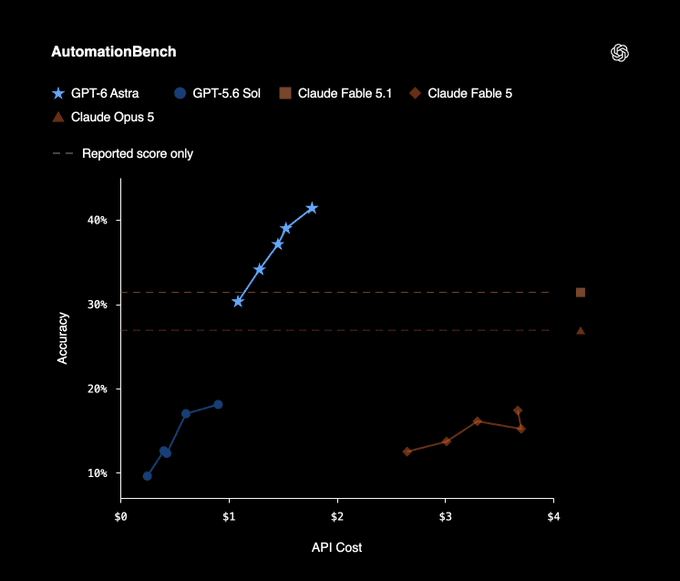
Carta AutomationBench rasmi OpenAI: ketepatan diplot terhadap anggaran kos API.
| Perbandingan kos per tugasan | Konfigurasi kualiti | Penjimatan kos API berbanding Sol |
|---|---|---|
| DeepSWE v1.1 | 74.1% vs 72.7%; konfigurasi skor tertinggi | Kira-kira 32% |
| Migrasi pangkalan data | 63.4% vs 42.7%; tetapan Astra kos lebih rendah | Kira-kira 38% |
| Terminal-Bench 4.0 | 57.9% vs 37.3%; konfigurasi dilaporkan | Kira-kira 9% |
Hubungan dengan harga adalah dua serampang. Pertama, lebih sedikit token output dan lebih sedikit cubaan gagal boleh menurunkan kos API dianggarkan per tugasan siap walaupun harga per token Astra lebih tinggi. Kedua, kadar yang disenaraikan CometAPI kini 20% lebih rendah daripada kadar penyedia yang sepadan. Kesan ini berasingan: jangan jumlahkan peratusan tersebut, dan jangan anggap penjimatan penanda aras akan berulang dalam produksi.
Harga GPT-6 Astra API
Harga diukur per sejuta token. Setelah input melebihi 272K token, jadual konteks panjang diterapkan pada keseluruhan permintaan.
| Harga semasa | Konteks pendek CometAPI | Konteks panjang CometAPI | OpenAI Standard |
|---|---|---|---|
| Input | $8 | $16 | $10 pendek / $20 panjang |
| Bacaan cache | $0.80 | $1.60 | $1 pendek / $2 panjang |
| Tulisan cache | $10 | $20 | $12.50 pendek / $25 panjang |
| Output | $40 | $60 | $50 pendek / $75 panjang |
Harga dan polisi gerbang boleh berubah. Sahkan konfigurasi harga langsung sebelum membuat bajet atau menyandikan kadar.
Cara Mengurangkan Kos API
- Kekalkan prefiks stabil mesra-cache. Letakkan arahan bersama dan skema alat sebelum kandungan khusus permintaan.
- Elakkan melintasi 272K tanpa sengaja. Ambil dan nyahpendua hanya konteks yang boleh mengubah jawapan.
- Gunakan tahap penaakulan terendah yang lulus. Eskalasi hanya apabila kadar penerimaan bertambah baik.
- Halakan trafik mudah ke tempat lain. Simpan Astra untuk kerja yang mendapat manfaat daripada kebolehsiapan hasilnya.
- Ukur kos per tugasan diterima. Sertakan cubaan semula, yuran alat, dan usaha semakan manusia yang dimonetisasi.
Cara Berpindah ke GPT-6 Astra
Apabila berpindah dari GPT-5.6 Sol, lakukan perubahan paling kecil yang serasi dan jalankan semula set penilaian yang sama.
- Tetapkan model kepada
gpt-6-astra. - Jika laluan lama menggunakan penaakulan
noneatauminimal, mulakan padalow. - Gunakan Responses untuk aliran kerja pemanggilan alat.
- Keluarkan parameter pensampelan yang tidak disokong:
temperature,top_p, dantop_logprobs; keluarkan juga Chat Completionslogprobs. - Uji semula output berstruktur, caching, penstriman, gelung alat, dan tingkah laku khusus penyedia.
- Bandingkan kadar tugasan diterima, latensi, cubaan semula, token, dan pembetulan manusia sebelum menukar laluan lalai.
prompt = "Review this API design and identify migration risks."

baseline = client.responses.create(
    model="gpt-5.6-sol",
    input=prompt,
)

candidate = client.responses.create(
    model="gpt-6-astra",
    input=prompt,
    reasoning={"effort": "medium"},
)
Bilakah Anda Patut Menggunakan GPT-6 Astra?
Gunakan Astra apabila kegagalan tugasan mahal dan aliran kerja menggabungkan penaakulan dengan alat, konteks panjang, atau pelaksanaan berbilang tahap.
- Penyahpepijatan skala repositori, migrasi, dan gelung uji-dan-cuba semula.
- Ejen pelayar atau penggunaan komputer.
- Penyelidikan mendalam merentasi pelbagai sumber dan alat.
- Analisis dokumen atau pangkalan kod yang sangat panjang.
- Aliran kerja saintifik dan teknikal yang menggunakan kod atau perisian luaran.
- Automasi profesional di mana larian gagal mencipta kos pemulihan yang bermakna.
Gunakan laluan lebih murah untuk penulisan semula ringkas, ringkasan pendek, pengelasan, dan pengekstrakan rutin apabila ia sudah memenuhi sasaran kualiti.
Ralat API Biasa
401 Ralat Pengesahan
Sahkan bahawa permintaan menghantar Authorization: Bearer <COMETAPI_KEY> dan proses membaca pemboleh ubah persekitaran yang betul.
400 Permintaan Tidak Sah
Periksa parameter pensampelan tidak disokong, skema tidak sah, atau nilai penaakulan tidak disokong seperti none.
404 Ralat Model atau Endpoint
Sahkan model="gpt-6-astra" dan laluan /v1/responses.
429 Had Kadar
Gunakan backoff eksponen dengan jitter dan kiraan cubaan semula terikat.
1 s -> 2 s -> 4 s -> 8 s -> capped retry window
5xx Ralat Pelayan
Cuba semula kegagalan pelayan sementara, tetapi jangan cuba semula permintaan 4xx yang cacat tanpa perubahan. Log pengenal permintaan tanpa menyimpan kandungan prompt sensitif secara tidak perlu.
Soalan Lazim
ID model apa yang patut saya guna?
Gunakan gpt-6-astra.
Patutkah saya guna Responses API atau Chat Completions?
Gunakan Responses untuk integrasi baharu, khususnya untuk alat, output berstruktur, penstriman, keadaan, dan aliran kerja ejen. Kekalkan Chat Completions hanya apabila keperluan keserasian membenarkannya.
Tahap penaakulan mana yang patut saya mulakan?
Mulakan dengan medium, kemudian nilai low untuk trafik rutin dan high atau ke atas untuk tugasan yang mendapat manfaat ketara daripada penaakulan lebih mendalam.
Bolehkah Astra menerima imej?
Ya. Ia menerima input teks dan imej serta mengembalikan output teks.
Adakah laluan CometAPI sentiasa 20% lebih murah per tugasan siap?
Tidak. Kadar token yang disenaraikan adalah 20% lebih rendah daripada kadar penyedia yang sepadan, tetapi jumlah kos tugasan juga bergantung pada saiz konteks, panjang output, panggilan alat, cubaan semula, dan usaha semakan.
Patutkah Astra menggantikan Sol di mana-mana?
Tidak. Sol kekal pilihan kos lebih rendah untuk banyak beban kerja terhad. Gunakan Astra apabila pelaksanaan lebih kukuh, kebolehpercayaan konteks panjang, atau lebih sedikit cubaan gagal mengubah ekonomi keseluruhan.
Kesimpulan
Astra paling bernilai apabila panggilan API hanyalah satu langkah dalam aliran kerja sukar dan bukannya titik akhir. Konteks panjang, lima tahap penaakulan, output berstruktur, penstriman, pemanggilan fungsi, dan kawalan ejen baharu memberi pembangun lebih banyak cara membawa kerja kompleks ke penyempurnaan.
Mulakan dengan Responses, penaakulan medium, kriteria penyiapan yang jelas, dan akses alat minimum yang diperlukan. Ukur kadar tugasan diterima dan kos per tugasan diterima, kemudian tingkatkan penaakulan atau halakan lebih banyak trafik ke Astra hanya apabila bukti menyokongnya.