
Jawab dahulu
GPT-6 Astra ialah model perdana baharu OpenAI untuk kerja hujung-ke-hujung yang sukar. OpenAI mengeluarkan GPT-6 Astra pada 3 September 2026, memposisikannya pada penaakulan kompleks, penggunaan komputer, pengkodan, penyelidikan, kerja saintifik, dan penciptaan artifak profesional. Model API ini mempunyai tetingkap konteks 1.05M token dan keluaran maksimum 128K, menerima input teks dan imej, serta menyokong usaha penaakulan daripada rendah hingga maks. Harga API Standard bermula pada $10 input / $50 output per juta token. Perubahan praktikal paling penting bukan lonjakan seragam pada setiap penanda aras kecerdasan umum: keuntungan terbesar Astra muncul dalam pelaksanaan agenik, penggunaan komputer, pengambilan konteks panjang, aliran kerja pengkodan, sains, dan keselamatan siber.
Ini penting kerana artikel CometAPI yang lama GPT-6 Is Coming Soon — What Will It Look Like? sememangnya bersifat spekulatif. Kini Astra telah diumumkan, panduan ini memfokuskan pada tingkah laku model yang telah disahkan, pertukaran penanda aras, ekonomi API, dan di mana model ini sebenarnya pilihan yang lebih baik berbanding alternatif frontier yang lebih murah.
Apakah GPT-6 Astra?
GPT-6 Astra ialah penerus kepada model perdana GPT-5.6 Sol oleh OpenAI. OpenAI menerangkan Astra sebagai model paling berkeupayaan untuk kerja hujung-ke-hujung paling sukar, dengan penekanan pada aliran kerja yang memerlukan model untuk membuat penaakulan, menggunakan alat, berinteraksi dengan perisian, menyemak semula kerja perantaraan, dan membawa sesuatu tugas daripada permintaan awal hingga hasil siap. Pemposisian itu penting: Astra bukan sekadar model sembang yang lebih besar. Ia direka untuk bertindak sebagai enjin penaakulan dalam agen yang bekerja merentas pelayar, terminal, dokumen, hamparan, persekitaran pembangunan, dan perisian perusahaan.
Catatan pelancaran menonjolkan keputusan canggih merentas penggunaan komputer, pelayaran, kejuruteraan perisian, keselamatan siber, sains, dan kerja profesional. Ia melaporkan 97.6% / 99.9% / 100% pada FrontierMath Tier 4, ARC-AGI-3, dan ExploitBench masing-masing. Skor utama itu menonjol, tetapi ia tidak harus ditafsirkan sebagai “Astra memenangi setiap penanda aras.” Pada Artificial Analysis Intelligence Index yang digunakan dalam jadual perbandingan OpenAI sendiri, Astra memperoleh 61.2 manakala Claude Fable 5.1 memperoleh 65.7. Oleh itu, keluaran ini lebih wajar difahami sebagai lonjakan dalam pelaksanaan dan kerja agenik, bukannya sapuan bersih semua ukuran kecerdasan.
Apa yang Berubah Berbanding GPT-5.6 Sol?
Penggunaan komputer menjadi keupayaan kelas pertama
Keuntungan generasi paling jelas Astra ialah penggunaan komputer. Pada OSWorld 2.0, OpenAI melaporkan 72.6% untuk Astra berbanding 65.7% untuk GPT-5.6 Sol. Dalam simulasi kependaman yang sama, Astra menyiapkan tugas dalam kira-kira 40 minit berbanding kira-kira 75 minit untuk Sol, pengurangan sekitar 47%. Digabungkan dengan harness Codex yang dikemas kini, OpenAI melaporkan penyempurnaan 1.9× lebih pantas pada Mind2Web. Perkara praktikalnya bukan sekadar Astra boleh “melihat” skrin; ia boleh mengekalkan tugas perisian berbilang langkah yang koheren lebih lama sambil membuat lebih sedikit lencongan yang mahal.
Penciptaan artifak profesional lebih bersepadu dan teliti
OpenAI secara eksplisit melatih Astra untuk aliran kerja profesional yang berakhir dengan artifak yang boleh digunakan dan bukannya prosa mentah. Bahan pelancaran menerangkan prestasi yang lebih kukuh pada dokumen, hamparan, pembentangan, analisis data, kerja reka bentuk, dan pematuhan templat. Astra juga lebih baik kekal berorientasikan apabila keperluan berubah di pertengahan tugas, jadi mesej pengarahan kurang cenderung menimpa matlamat asal. Ini amat berguna dalam agen perusahaan jangka panjang, di mana arahan baharu sering tiba selepas aliran kerja sudah bermula.
Sesi panjang mengekalkan lebih banyak konteks kerja yang berguna
Untuk sesi pengkodan panjang, Astra memperkenalkan cara baharu untuk Codex mengekalkan dan mendapatkan semula nota selepas konteks aktif dipenuhi. Pendekatan terdahulu sangat bergantung pada pemampatan, yang boleh mengabaikan mengapa sesuatu pembaikan gagal atau kekangan mana yang telah diuji. OpenAI menyatakan Astra boleh menyimpan nota merentasi tetingkap konteks, meningkatkan kesinambungan semasa proses refactor besar dan sesi nyahpepijat.
Usaha penaakulan kini meluas hingga maks
Pembangun boleh memilih usaha penaakulan rendah, sederhana, tinggi, xhigh, atau maks. Ini mewujudkan lengkung kualiti-kos yang lebih lebar berbanding menganggap Astra sebagai satu titik operasi tetap. Panduan model rasmi mengesyorkan memilih usaha terendah yang memenuhi sasaran eval anda, kerana ekonomi terbaik model selalunya datang daripada kecekapan token dan bukannya sentiasa berjalan pada penaakulan maksimum.
Prestasi Penanda Aras GPT-6 Astra
OpenAI menerbitkan perbandingan luas yang merangkumi penggunaan komputer, kerja profesional, pengkodan, penaakulan akademik, kesihatan, keselamatan siber, konteks panjang, dan perataan (alignment). Cara paling berguna untuk membaca jadual ialah memisahkan “kecerdasan umum” daripada “keupayaan menyiapkan kerja menggunakan alat.” Astra hanya sedikit di atas Sol pada Artificial Analysis Intelligence Index dalam jadual OpenAI, namun ia jauh di hadapan pada beberapa penanda aras agenik dan operasi.
| Penanda aras | GPT-6 Astra | GPT-5.6 Sol | Apa yang dicadangkan oleh delta |
|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | Lonjakan besar dalam aliran kerja perniagaan E2E |
| OSWorld 2.0 | 72.6% | 65.7% | Interaksi komputer dan penyelesaian tugas lebih baik |
| Terminal-Bench 4.0 | 57.9% | 37.3% | Lonjakan besar dalam pengkodan berasaskan terminal |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | Peningkatan besar dalam aliran kerja sains guna alat |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | Penaakulan matematik peringkat frontier lebih kukuh |
| ExploitBench | 100.0% | 78.5% | Keupayaan keselamatan siber kelas kritikal |
| SRE-Bench, one attempt | 88.0% | 55.9% | Kejuruteraan songsang/SRE jauh lebih kuat |
| MRCR v2, 512K-1M | 96.3% | 73.8% | Pengambilan konteks sangat panjang bertambah baik |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | Kecerdasan umum pada asasnya setara vs Sol |
Pola ini amat jelas. Kelebihan Astra paling besar apabila penanda aras memerlukan interaksi berterusan dengan alat atau persekitaran. AutomationBench meningkat daripada 18.1% kepada 41.4%; Terminal-Bench Science meningkat daripada 22.4% kepada 64.6%; dan MRCR konteks panjang bertambah daripada 73.8% kepada 96.3% dalam jalur 512K–1M. Sebaliknya, Artificial Analysis Intelligence Index bergerak dari 60.9 ke 61.2. Inilah sebabnya menerangkan Astra sebagai “2.5× lebih mahal tetapi sedikit lebih pintar” terlepas proposisi nilai sebenar produk.
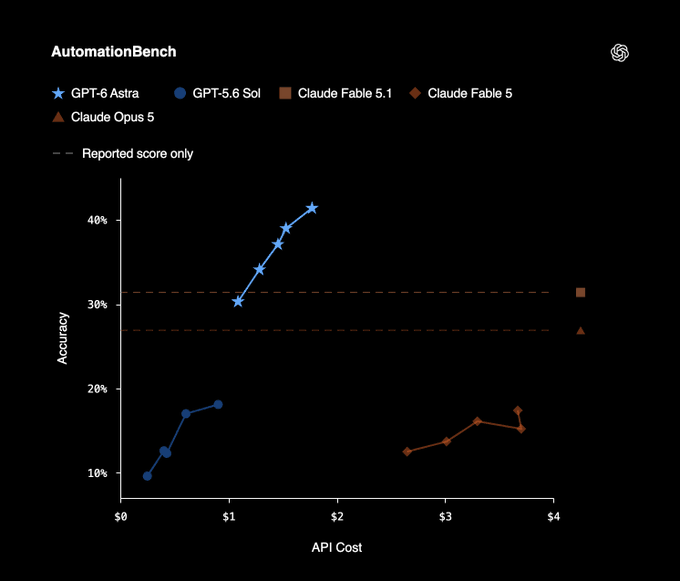
Sumber: OpenAI AutomationBench chart (imej asal, tidak digubah semula)
Penanda Aras Bebas: Adakah GPT-6 Astra Satu Lompatan Generasi?
Ujian bebas menambah semakan realiti yang penting. Artificial Analysis melaporkan skor Intelligence Index sebanyak 61, sama dengan GPT-5.6 Sol pada usaha maks. Pada masa yang sama, Astra bertambah baik dengan ketara pada Coding Agent Index dan menggunakan jauh lebih sedikit token dalam pengkodan agenik. Artificial Analysis mengukur kira-kira pengurangan penggunaan token tiga kali ganda berbanding GPT-5.6 Sol pada usaha maks dalam harness Codex mereka, membolehkan Astra mendapat skor lebih tinggi pada kira-kira kos yang sama per tugas agen pengkodan.
Ekonomi kelihatan kurang memihak pada kecerdasan umum. Astra menggunakan kira-kira 10% lebih sedikit token output daripada Sol dalam Intelligence Index pada usaha maks, tetapi peningkatan harga per-token 2.5× mendominasi keuntungan kecekapan tersebut; Artificial Analysis menganggarkan Astra sekitar 75% lebih mahal per tugas pada usaha maks. Ia juga melaporkan pengurangan kadar halusinasi 92% ke 51% pada AA-Omniscience sambil ketepatan meningkat empat mata.
Kesimpulan yang berguna adalah khusus beban kerja: GPT-6 Astra kelihatan paling generasi di mana agen mesti bertindak, beriterasi, menggunakan alat, dan menyiapkan kerja yang rumit. Bagi penaakulan biasa atau penjanaan teks volum tinggi, premium harga jauh lebih sukar untuk dipulihkan.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Perbandingan pemilihan model yang praktikal harus merangkumi keupayaan, multimodaliti, konteks, pelaksanaan agenik, dan harga. Model di bawah tidak boleh ditukar ganti: Astra dioptimumkan untuk pelaksanaan hujung-ke-hujung yang sukar, Claude Fable 5.1 mendahului beberapa ukuran kecerdasan umum, dan Gemini 3.8 Flash menawarkan harga token yang jauh lebih rendah dengan modaliti input asli yang lebih luas.
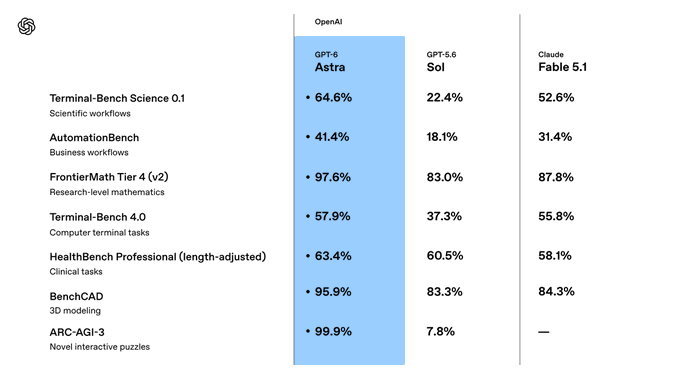
| Metrik | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Tetingkap konteks | 1.05M | 1.05M | 1M | 1.048M |
| Keluaran maks | 128K | 128K | 128K | 65.5K |
| Modaliti input | Teks, imej | Teks, imej | Teks, imej/PDF | Teks, imej, audio, video, PDF |
| AA Intelligence Index | 61.2 | 60.9 | 65.7 | 58.7 |
| AutomationBench | 41.4% | 18.1% | 31.4% | — |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 19.1% |
| DeepSWE 1.1 | 74.1% | 72.7% | 67.4% | 73.8% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | — |
| HLE with tools | 57.2% | — | 65.0% | — |
| HealthBench Professional | 63.4% | 60.5% | 58.1% | 52.1% |
| Harga input standard rasmi | $10/M | $4/M | $10/M | $0.75/M |
| Harga output standard rasmi | $50/M | $20/M | $50/M | $3.75/M |
Bila GPT-6 Astra ialah pilihan yang lebih baik
Pilih Astra apabila tugas menjadi mahal kerana manusia perlu menyelamatkan larian agen yang gagal: perubahan kod yang panjang, automasi pelayar/desktop, penyelidikan mendalam yang merentas alat, penciptaan artifak teknikal, atau aliran kerja saintifik dan operasi yang kompleks. Preminya paling mudah dibenarkan apabila lebih sedikit percubaan semula, lebih sedikit pembetulan manual, dan penggunaan token output yang lebih rendah lebih penting daripada harga per-token mentah.
Bila Claude Fable 5.1 ialah pilihan yang lebih baik
Claude Fable 5.1 kekal sebagai pesaing frontier yang serius. Dalam jadual pelancaran OpenAI sendiri, ia memperoleh 65.7 pada Artificial Analysis Intelligence Index berbanding 61.2 untuk Astra, dan 65.0 pada Humanity’s Last Exam dengan alat berbanding 57.2 untuk Astra. Ini bermakna Astra tidak harus dipasarkan sebagai pemenang kecerdasan universal. Jika set penilaian anda menyerupai penaakulan bentuk panjang lebih daripada pelaksanaan penggunaan komputer, Claude Fable 5.1 mungkin masih lebih sesuai.
Bila Gemini 3.8 Flash ialah pilihan yang lebih baik
Gemini 3.8 Flash menyasarkan titik berbeza pada frontier. Ia menyokong input teks, imej, audio, video, dan PDF dengan tetingkap konteks kira-kira 1M token, manakala harga pengenalan rasmi jauh di bawah Astra. Untuk pengekstrakan multimodal volum tinggi, pemahaman video/audio, agen rutin, atau beban kerja di mana ekonomi token $10/$50 sukar dibenarkan, Gemini 3.8 Flash selalunya pilihan pengeluaran yang lebih ekonomik.
Mengapa Penarafan Keselamatan Siber GPT-6 Astra Penting
Astra ialah model OpenAI pertama yang dikerahkan secara meluas mencapai ambang keupayaan keselamatan siber Kritikal di bawah Preparedness Framework syarikat. OpenAI menyatakan model ini boleh mengenal pasti kelemahan keselamatan yang tidak diketahui sebelum ini dan membangunkan strategi eksploitasi merentas sistem yang dikeraskan apabila diberi alat dan akses yang betul. Dalam penilaian pelancaran, Astra mendapat 100% pada ExploitBench, 42.4% pada ExploitGym, dan 88.0% pada SRE-Bench dalam satu percubaan.
Keupayaan itu hadir dengan kawalan pengedaran yang lebih ketat. OpenAI menyatakan perlindungan pengeluaran mungkin memperlahankan, menjeda, atau menghentikan kerja yang sah, terutamanya dalam konteks siber berisiko lebih tinggi. ChatGPT atau Codex mungkin meminta pengguna menyemak tindakan sebelum meneruskan, manakala tugas API boleh berhenti. Pengedaran lalai Astra juga menolak lebih banyak permintaan penciptaan eksploit lanjutan; program Daybreak OpenAI menyediakan akses berasingan yang ditapis untuk beberapa aliran kerja defensif.
Kad sistem mendokumenkan pertukaran keboleh-pantauan: Astra sejajar (aligned) keseluruhannya lebih baik daripada Sol, tetapi penaakulan bertulisnya boleh menjadi lebih sukar dipantau di bawah keadaan penilaian adversarial. Oleh itu, OpenAI mengedarkan pemantauan misalignment yang lebih luas di sekitar inferens Astra yang menggunakan alat. Pasukan perusahaan harus menganggap kebenaran agen, sempadan kelulusan, log audit, dan akses alat keistimewaan minimum sebagai sebahagian daripada seni bina model dan bukan tambahan pilihan.
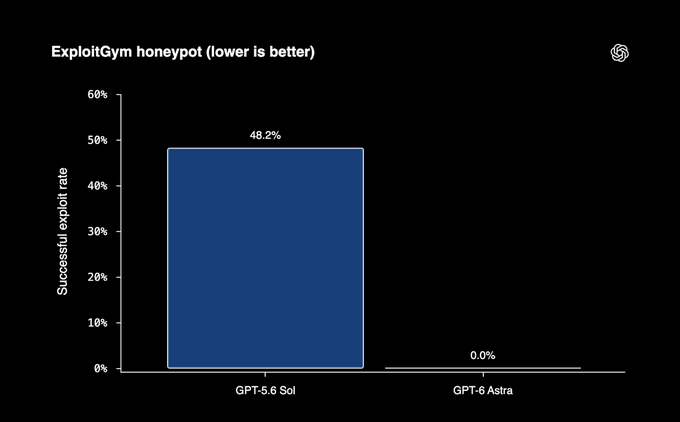
Sumber: OpenAI official ExploitGym honeypot safety chart (imej rasmi, tidak digubah semula)
Harga GPT-6 Astra
Halaman harga API semasa OpenAI memisahkan permintaan konteks pendek dan konteks panjang. Untuk pemprosesan Standard, kadar konteks pendek ialah $10 input, $1 input cache, $12.50 cache write, dan $50 output per juta token. Permintaan melebihi 272K token input menggunakan jadual konteks panjang: $20 input, $2 input cache, $25 cache write, dan $75 output per juta token.
| Pemprosesan / konteks | Input | Input cache / cache write | Output |
|---|---|---|---|
| Standard, konteks pendek | $10/M | $1/M / $12.50/M | $50/M |
| Standard, konteks panjang (>272K input) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, konteks pendek | $5/M | $0.50/M / $6.25/M | $25/M |
| Batch / Flex, konteks panjang | $10/M | $1/M / $12.50/M | $37.50/M |
| Mod pantas, konteks pendek | $20/M | $2/M / $25/M | $100/M |
| Mod pantas, konteks panjang | $40/M | $4/M / $50/M | $150/M |
Dibandingkan dengan GPT-5.6 Sol, harga token Standard konteks pendek Astra adalah 2.5× lebih tinggi ($10/$50 berbanding $4/$20). Premium itu tidak secara automatik bermakna kos tugas siap 2.5× lebih tinggi. Pada pengkodan agenik, OpenAI dan Artificial Analysis kedua-duanya melaporkan penggunaan token output yang lebih rendah untuk Astra dalam beberapa konfigurasi. Unit yang betul untuk penilaian oleh itu ialah kos per tugas yang berjaya, bukan kos per token semata-mata.
Cara Mengakses GPT-6 Astra
OpenAI memulakan pengeluaran berperingkat pada 3 September 2026. Astra dijadualkan mencapai pengguna ChatGPT Plus, Pro, Business, dan Enterprise, OpenAI API, dan AWS dalam beberapa hari berikutnya. Pentadbir perusahaan boleh mengaktifkan Astra per ruang kerja, dan akses dimatikan secara lalai semasa pelancaran.
Panggil GPT-6 Astra dengan OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Semak seni bina repositori ini. Kenal pasti isu reka bentuk "
        "berisiko tertinggi, jelaskan buktinya, dan cadangkan pelan migrasi."
    ),
)

print(response.output_text)
ID model ialah gpt-6-astra. Untuk aliran kerja berat alat, Responses API ialah titik permulaan semula jadi kerana Astra menyokong pemanggilan fungsi, output berstruktur, carian web, carian fail, jurubahasa kod, shell dihoskan, apply patch, penggunaan komputer, MCP, dan carian alat. Penalaan halus (fine-tuning) pada masa ini tidak disokong.
Kes Penggunaan GPT-6 Astra di Dunia Sebenar
Pembangunan permainan dan aliran kerja perisian visual
Playco menguji Astra dalam Playbot, IDE berkuasa AI yang berfungsi terus dalam Unity dan Godot. OpenAI melaporkan 50% lebih sedikit pembetulan manual berbanding model sebelumnya, dan tiga prototaip bertema dibina daripada asas grey-box tunggal. Contoh ini penting kerana tugas memerlukan lebih daripada penjanaan kod sumber: model mesti membuat penaakulan tentang susun atur spatial, bermain permainan, menguji perubahan, mengenal pasti pepijat, dan beriterasi dalam persekitaran visual.
Semakan dokumen undang-undang dan kewangan
OpenAI memposisikan Astra untuk aliran kerja profesional berbilang langkah yang menghasilkan dokumen, hamparan, dan analisis yang digilap. Dalam semakan undang-undang dan kewangan, nilai praktikalnya ialah mengekalkan keadaan tugas merentasi banyak fail, semak silang bukti, dan mengembalikan artifak siap dan bukannya satu jawapan terpencil. Pengesahan pakar, kawalan kelulusan, dan akses data keistimewaan minimum kekal perlu.
Agen kejuruteraan jangka panjang
Gabungan Terminal-Bench, DeepSWE, migrasi pangkalan data, penggunaan komputer, dan keputusan konteks panjang menjadikan Astra sangat relevan untuk kejuruteraan skala repositori. Corak pengedaran yang berguna ialah memberi Astra persekitaran pembangunan terhad, isu atau matlamat migrasi, ujian, dan akses alat; kemudian menilai kejayaan pada kualiti tugas yang digabungkan, bilangan iterasi gagal, masa semakan manusia, dan jumlah kos. Ini ialah metrik pengeluaran yang lebih baik daripada satu skor penanda aras pengkodan.
Batasan GPT-6 Astra
- Harga token premium. Astra menelan kos 2.5× GPT-5.6 Sol per token pada harga Standard konteks pendek, jadi sembang rutin, klasifikasi, pengekstrakan, dan draf ringkas selalunya tidak ekonomik.
- Konteks panjang mempunyai caj tambahan. Permintaan dengan lebih daripada 272K token input bergerak ke kadar lebih tinggi untuk keseluruhan permintaan, jadi “konteks 1.05M” tidak harus ditafsirkan sebagai memori harga rata.
- Tiada input audio atau video asli pada model. Astra menerima teks dan imej serta mengeluarkan teks; Gemini 3.8 Flash lebih fleksibel apabila pemahaman audio/video asli adalah teras beban kerja.
- Tiada penalaan halus. Halaman model rasmi kini menyenaraikan penalaan halus sebagai tidak disokong, jadi penyesuaian bergantung pada prompt, alat, pengambilan, dan reka bentuk aliran kerja.
- Perlindungan siber boleh mengganggu aliran kerja. OpenAI secara jelas memberi amaran bahawa semakan keselamatan tambahan boleh menjeda atau menghentikan kerja yang sah dalam konteks berisiko lebih tinggi.
- Bukan pemenang penanda aras universal. Claude Fable 5.1 mendahului Astra pada Artificial Analysis Intelligence Index dan angka HLE-with-tools yang disertakan dalam perbandingan pelancaran OpenAI.
Soalan Lazim
Adakah GPT-6 Astra dikeluarkan secara rasmi?
Ya. OpenAI memulakan pengeluaran pada 3 September 2026. Ketersediaan diagihkan mengikut organisasi, pelan berbayar ChatGPT, akses API, dan AWS dan bukannya muncul untuk setiap akaun pada masa yang sama.
Apakah tetingkap konteks GPT-6 Astra?
Halaman model rasmi menyenaraikan tetingkap konteks 1.05M token dan keluaran maksimum 128K token. Permintaan melebihi 272K token input menggunakan jadual harga konteks panjang.
Berapakah kos GPT-6 Astra?
Harga Standard konteks pendek ialah $10 input / $50 output per juta token, dengan $1 input cache dan $12.50 cache write. Konteks panjang, Batch/Flex, dan mod Pantas mempunyai kadar berbeza, jadi anggaran pengeluaran harus menggunakan tier yang sepadan dengan permintaan sebenar.
Adakah GPT-6 Astra lebih baik daripada Claude Fable 5.1?
Ia bergantung pada beban kerja. Astra mendahului pada beberapa penilaian penggunaan komputer, agen pengkodan, sains, keselamatan siber, dan kerja profesional, manakala Claude Fable 5.1 mendahului Astra pada Artificial Analysis Intelligence Index dan HLE dengan alat dalam perbandingan yang diterbitkan OpenAI. Gunakan eval agen/tugas anda sendiri dan jangan menganggap satu model menguasai setiap kategori.
Adakah GPT-6 Astra ialah AGI?
Halaman produk rasmi OpenAI menerangkan Astra sebagai generasi baharu kecerdasan dan model paling berkeupayaan yang dikerahkan secara meluas, tetapi mereka tidak mentakrifkan produk itu sendiri sebagai “AGI.” Ketepuan penanda aras pada sesetengah tugas tidak bersamaan dengan definisi AGI universal yang dipersetujui.
Kesimpulan
GPT-6 Astra paling baik difahami sebagai model frontier berfokus pelaksanaan. Bukti kemajuannya yang paling kuat bukanlah pergerakan kecil 60.9-ke-61.2 berbanding GPT-5.6 Sol pada Artificial Analysis Intelligence Index; ia adalah peningkatan yang jauh lebih besar dalam penggunaan komputer, pengkodan agenik, aliran kerja saintifik, pengambilan konteks panjang, penyempurnaan tugas profesional, dan keselamatan siber. Tetingkap konteks 1.05M dan tumpukan alat yang mendalam memberikan pembangun lebih ruang untuk membina agen yang kekal berguna melebihi satu respons.
Pertukaran yang wujud ialah harga. Harga Standard $10/$50 adalah premium, permintaan konteks panjang lebih mahal, dan ujian bebas menunjukkan Astra boleh menjadi lebih mahal dengan ketara daripada Sol pada beban kerja kecerdasan umum. Model ini memperoleh premium tersebut apabila kadar penyempurnaan yang lebih baik dan pembetulan manusia yang lebih rendah mengatasi kos token. Untuk beban kerja yang lebih ringkas atau volum tinggi, GPT-5.6, Claude Fable 5.1 dan terutamanya Gemini 3.8 Flash kekal sebagai alternatif yang relevan bukannya pendahulu yang lapuk.