
Qwen3.8-Flash diterangkan: konteks 1M, reka bentuk MoE 6B aktif, penanda aras pengaturcaraan dan multimodal, harga-prestasi, perbandingan, dan akses CometAPI.
TL;DR Model Qwen3.8-Flash daripada Alibaba ialah model produksi untuk kerja pengaturcaraan volum tinggi, agen, konteks panjang, dan tugas multimodal. Ia menyokong konteks terhos 1M token dan menggabungkan keputusan penanda aras yang kukuh dengan harga API yang rendah. Rakan sepadan wajaran terbuka, Qwen3.8-Flash-Next, tersedia untuk penilaian dan penyebaran setempat.
Intipati Utama
- Penamaan produksi vs. wajaran terbuka: Qwen3.8-Flash ialah model produksi terhos; Qwen3.8-Flash-Next ialah keluaran seni bina berwajaran terbuka yang digunakan untuk menerbitkan butiran model dan penanda aras.
- Pengaktifan sangat jarang: 125B parameter utama + 51B embedding N-gram, dengan hanya 6B parameter aktif setiap token.
- Konteks panjang: 262K konteks asli untuk model terbuka, boleh dilanjutkan ke 1M dengan YaRN; laluan produksi QwenCloud mendedahkan konteks 1M secara lalai.
- Pengaturcaraan agen yang kukuh: Qwen melaporkan 62.5 pada SWE-bench Pro, 73.9 pada CoWorkBench, 73.5 pada Toolathlon Verified, dan 91.9 pada LiveCodeBench v6.
- Kekuatan multimodal: Qwen melaporkan 84.5 pada AndroidWorld, 88.5 pada RealWorldQA, dan 90.6 pada MathVision tanpa jurubahasa kod.
- Kecekapan: QSA mencapai sehingga 7.6x pecutan kernel prefill dan 4.9x decode pada 1M token, dan Qwen melaporkan 8.6x throughput prefill 1M token lebih tinggi daripada Qwen3.7-Plus di bawah tetapan penyajian kadar kena cache awalan tinggi.
- Harga: Alibaba Cloud kini menyenaraikan US$0.15/M input dan US$0.47/M output untuk penyebaran antarabangsa; CometAPI menyenaraikan US$0.12/M input dan US$0.376/M output.
Imej pelancaran rasmi Qwen3.8-Flash — sumber Alibaba/Qwen
Apakah Qwen3.8-Flash?
Qwen3.8-Flash ialah model produksi berorientasikan kecekapan oleh Alibaba Qwen untuk pengaturcaraan, agen, kerja pengetahuan berkonteks panjang, dan tugas multimodal. Model ini diumumkan bersama rakan sepadan wajaran terbuka yang dipanggil Qwen3.8-Flash-Next. Alibaba menerangkannya sebagai model MoE multimodal berwajaran terbuka yang dioptimumkan untuk keupayaan, kependaman, dan kos, serta menyatakan seni bina ini ialah pratonton awal idea yang ditujukan untuk Qwen4.
Label “Flash” adalah penting. Qwen3.8-Max ialah tier perdana yang lebih besar untuk keupayaan maksimum, manakala Qwen3.8-Flash dibina untuk menyampaikan sebahagian besar prestasi pengaturcaraan dan agen yang berguna dengan komput aktif yang jauh lebih rendah. Keluaran ini mengaktifkan 6B parameter setiap token, berbanding jejak aktif yang jauh lebih besar dalam sistem MoE perdana.
Model produksi disajikan di bawah ID model qwen3.8-flash. QwenCloud menyokong API Chat Completions dan Responses yang serasi OpenAI serta antara muka serasi Anthropic, yang menjadikan model ini mudah diintegrasikan ke dalam timbunan agen dan pengaturcaraan sedia ada.
Qwen3.8-Flash vs. Qwen3.8-Flash-Next: Apakah Perbezaannya?
Qwen3.8-Flash-Next ialah keluaran model berwajaran terbuka. Ia mendedahkan seni bina, wajaran model, panduan penyebaran, dan set penanda aras. Wajaran tersedia di Hugging Face dan ModelScope. Model terbuka menyokong konteks asli 262,144 token dan boleh dilanjutkan ke 1M dengan YaRN.
Qwen3.8-Flash ialah versi API produksi. Dalam keluaran rasmi, Alibaba menyatakan versi produksi menggunakan konteks 1M secara lalai dan menyertakan alat terbina dalam rasmi. Dalam amalan, pembangun yang menilai model terhos harus menggunakan kelakuan API dan harga Qwen3.8-Flash, manakala keluaran Flash-Next ialah sumber awam terbaik untuk butiran seni bina dan penanda aras.
Spesifikasi Qwen3.8-Flash
| Spesifikasi | Qwen3.8-Flash / Flash-Next |
|---|---|
| Penyedia | Alibaba Qwen |
| ID model produksi | qwen3.8-flash |
| Model wajaran terbuka | Qwen3.8-Flash-Next |
| Seni bina | MoE Multimodal; perhatian hibrid GDN + QSA |
| Parameter utama | 125B |
| Parameter diaktifkan | 6B setiap token |
| Parameter embedding N-gram | 51B |
| Konteks asli model terbuka | 262,144 token |
| Konteks diperluas / terhos | Sehingga 1,000,000 token |
| Modaliti input produksi | Teks + imej didokumen dalam contoh integrasi rasmi |
| Modaliti wajaran terbuka | Teks + visi; dikeluarkan sebagai multimodal |
| Kawalan penaakulan | low / medium / xhigh dalam contoh QwenCloud |
| Panggilan alat selari | Disokong dalam konfigurasi model Codex rasmi |
| Wajaran terbuka | Ya, untuk Qwen3.8-Flash-Next |
| Tarikh pelancaran | Tetingkap pelepasan 26–27 Ogos 2026 |
Nombor kecekapan utama ialah 6B parameter diaktifkan setiap token. Tambahan 51B parameter embedding N-gram ialah kapasiti berasaskan carian; Qwen menyatakan bahawa ia tidak memasuki bajet pendaraban matriks per token dengan cara yang sama seperti wajaran transformer.
Apa yang Baharu dalam Seni Bina Qwen3.8-Flash?
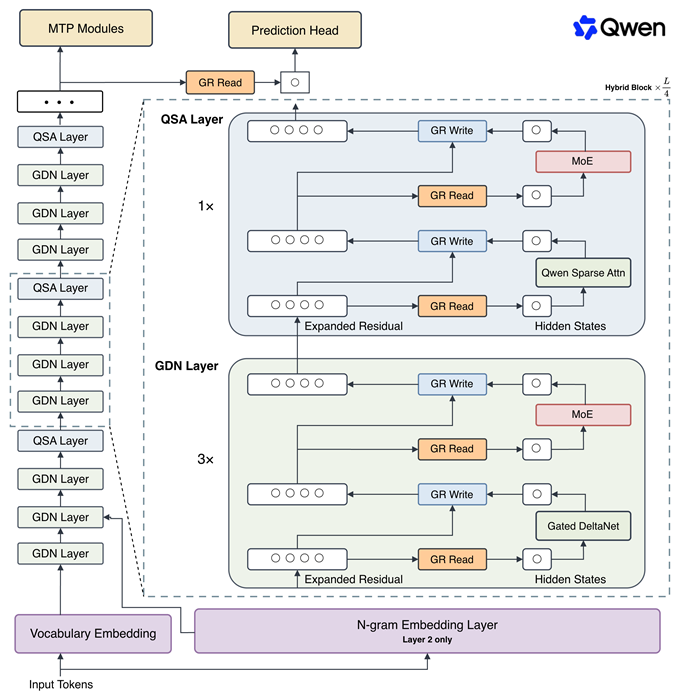
Rajah seni bina rasmi Qwen — Qwen3.8-Flash-Next
1. GDN + Qwen Sparse Attention (QSA)
Model ini mencampurkan dua mekanisme. Tiga daripada setiap empat lapisan menggunakan Gated DeltaNet (GDN) untuk memampatkan maklumat sejarah ke dalam keadaan bersaiz tetap, manakala baki satu lapisan menggunakan perhatian global untuk capaian tepat. Lapisan perhatian global kemudiannya menggunakan Qwen Sparse Attention untuk mengurangkan jumlah konteks yang mesti diproses secara langsung.
Matlamat praktikalnya mudah: GDN mengendalikan memori murah, manakala QSA membelanjakan perhatian penuh hanya di tempat capaian semula penting. Ini amat berharga untuk aplikasi konteks panjang di mana perhatian penuh biasa menjadi mahal dari segi komput dan trafik cache KV.
2. Gated Residual dengan Empat Laluan Maklumat
Gated Residual melebarkan aliran residual menjadi empat cabang selari. Gerbang unsur demi unsur dinamik mengawal berapa banyak maklumat dibaca daripada dan ditulis ke setiap cabang. Ini memberi maklumat awal lebih banyak cara untuk bertahan dalam rangkaian dalam tanpa sentiasa dicampur ke dalam satu aliran. Qwen juga menyatakan keadaan residual boleh disimpan dalam FP8 untuk mengurangkan trafik memori.
3. Embedding N-gram Menambah Kapasiti Tanpa Komput Berkadar
Qwen menambah 51B parameter embedding N-gram yang dicapai menggunakan konteks token setempat. Tidak seperti wajaran transformer biasa, parameter ini diambil melalui operasi carian dan boleh dipindahkan ke memori hos dengan prapengambilan tak segerak. Reka bentuk ini memperluas kapasiti model sambil mengekalkan aritmetik per token rendah.
4. Pengoptimum Muon dan Reka Bentuk Latihan Bersama
Qwen melatih model dengan pengoptimum Muon untuk wajaran peta linear 2D teras sambil mengekalkan AdamW untuk embedding, peruter, dan parameter pangkat rendah terpilih. Pasukan ini juga menyesuaikan semula undang‑undang penskalaan untuk seni bina baharu dan melaporkan bahawa pemanasan saiz kelompok tidak perlu, mengelakkan 18.8% langkah pengoptimum tambahan dalam eksperimennya.
5. MoE Ultra-jarang dan Ramalan Berbilang Token
Model mengekalkan kolam pakar yang besar tetapi merutekan hanya sebilangan kecil pakar setiap token. Ia juga menggunakan ramalan berbilang token, yang membantu penyahkodan spekulatif dengan meningkatkan kadar penerimaan sambil menambah baik rangka belakang semasa latihan. Secara bersama, pilihan ini mengukuhkan objektif reka bentuk yang sama: lebih banyak kapasiti dan throughput tanpa membayar komput peringkat perdana pada setiap token.
Prestasi Penanda Aras Qwen3.8-Flash
Penanda Aras Pengaturcaraan
Alibaba menerbitkan set penanda aras di bawah Qwen3.8-Flash-Next, rakan sepadan berwajaran terbuka bagi Qwen3.8-Flash produksi. Jadual berikut menggunakan skor keluaran yang dilaporkan Qwen dan memfokuskan pada rakan setanding yang juga tersedia melalui CometAPI.
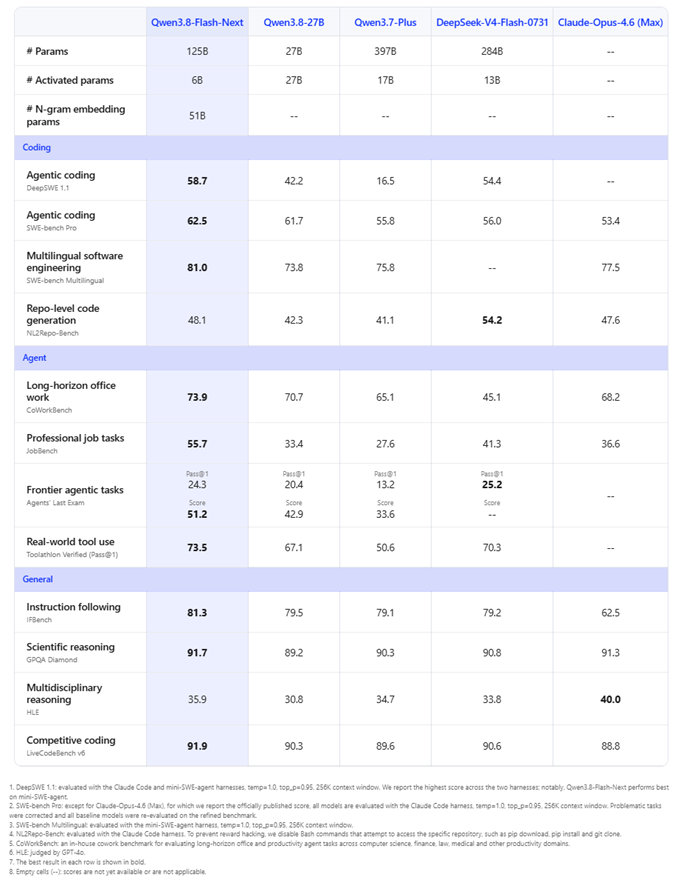
Carta penanda aras bahasa rasmi Qwen
| Penanda aras | Qwen3.8-Flash | DeepSeek V4 Flash | Claude Opus 4.6 |
|---|---|---|---|
| DeepSWE 1.1 | 58.7 | 54.4 | — |
| SWE-bench Pro | 62.5 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | — | 77.5 |
| NL2Repo-Bench | 48.1 | 54.2 | 47.6 |
| CoWorkBench | 73.9 | 45.1 | 68.2 |
| JobBench | 55.7 | 41.3 | 36.6 |
| Toolathlon Verified | 73.5 | 70.3 | — |
| IFBench | 81.3 | 79.2 | 62.5 |
| GPQA Diamond | 91.7 | 90.8 | 91.3 |
| HLE | 35.9 | 33.8 | 40.0 |
| LiveCodeBench v6 | 91.9 | 90.6 | 88.8 |
Keputusan pengaturcaraan: Qwen3.8-Flash mendahului rakan setanding terpilih pada SWE-bench Pro (62.5), SWE-bench Multilingual (81.0), dan LiveCodeBench v6 (91.9). Pengecualian utama ialah NL2Repo-Bench, di mana DeepSeek V4 Flash mencatat 54.2 berbanding 48.1.
Keputusan agen: Qwen3.8-Flash mencatat 73.9 pada CoWorkBench dan 55.7 pada JobBench, jauh di atas rakan setanding terpilih dalam jadual keluaran Qwen. Ia juga mengatasi DeepSeek V4 Flash pada Toolathlon Verified, 73.5 berbanding 70.3.
Keputusan penaakulan: Bidang ini lebih sengit. Qwen3.8-Flash mencatat 91.7 pada GPQA Diamond, hampir dengan Claude Opus 4.6 pada 91.3 dan DeepSeek V4 Flash pada 90.8. Pada HLE, Claude Opus 4.6 mendahului dengan 40.0 berbanding 35.9 Qwen.
Penanda Aras Multimodal
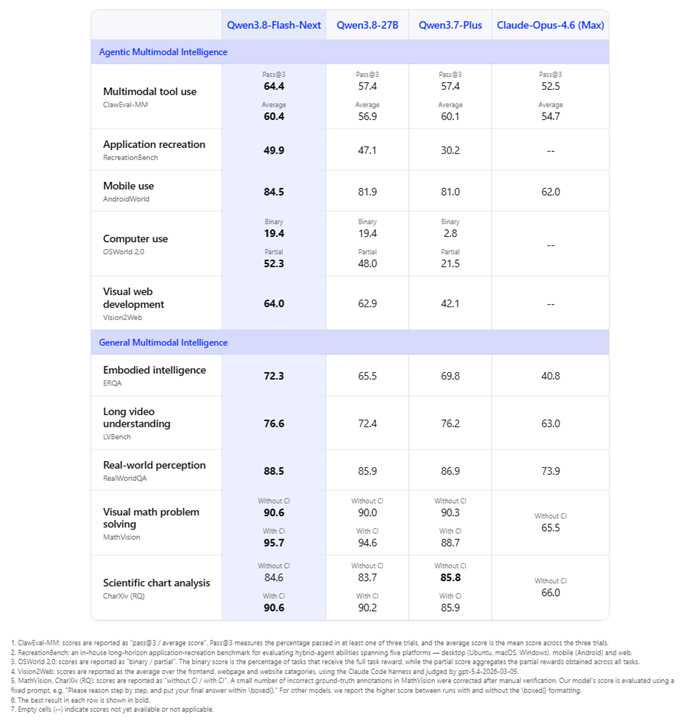
Carta penanda aras visi-bahasa rasmi Qwen
| Penanda aras | Qwen3.8-Flash | Claude Opus 4.6 |
|---|---|---|
| ClawEval-MM (Pass@3 / Avg) | 64.4 / 60.4 | 52.5 / 54.7 |
| AndroidWorld | 84.5 | 62.0 |
| ERQA | 72.3 | 40.8 |
| LVBench | 76.6 | 63.0 |
| RealWorldQA | 88.5 | 73.9 |
| MathVision (tanpa CI / dengan CI) | 90.6 / 95.7 | 65.5 / — |
| CharXiv RQ (tanpa CI / dengan CI) | 84.6 / 90.6 | 66.0 / — |
Keputusan multimodal keluaran ialah antara hujah terkuat untuk Qwen3.8-Flash. Qwen melaporkan 84.5 pada AndroidWorld, 88.5 pada RealWorldQA, dan 90.6 pada MathVision tanpa jurubahasa kod. Skor ini mencadangkan model ini ditujukan untuk agen yang mesti membaca skrin, memahami keadaan visual, dan terus bertindak dan bukannya hanya menjawab soalan imej.
Nota penanda aras: Ini ialah keputusan keluaran yang dilaporkan vendor, bukan ujian makmal neutral bersemuka. Beberapa penanda aras menggunakan harness atau konfigurasi alat berbeza, dan sesetengahnya dalaman. Anggap angka sebagai bukti berarah, kemudian sahkan model pada prompt, alat, sasaran kependaman, dan kriteria penerimaan anda sendiri.
Mengapa Qwen3.8-Flash Pantas dan Cekap Kos
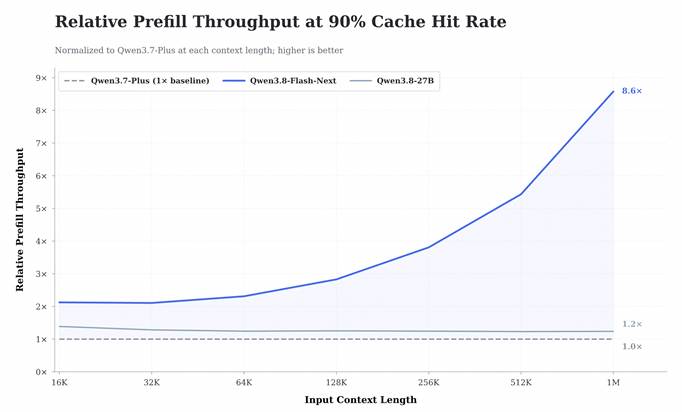
Carta kecekapan konteks panjang rasmi Qwen
Pada konteks 1M token, Qwen melaporkan sehingga 7.6x lebih pantas prefill dan 4.9x lebih pantas decode untuk kernel perhatian QSA. Dalam eksperimen penyajian dengan kadar kena cache awalan 90%, Qwen3.8-Flash-Next mencapai 8.6x throughput prefill Qwen3.7-Plus.
Kisah sistem yang lebih besar ialah komput aktif. Model utama 125B biasanya kedengaran besar, tetapi hanya 6B parameter diaktifkan setiap token. Jejak aktif itu kurang daripada separuh 13B parameter aktif yang dilaporkan untuk DeepSeek V4 Flash dan jauh di bawah kira-kira 95B parameter aktif yang dilaporkan untuk Qwen3.8-Max. Kiraan parameter tidak diterjemahkan secara linear kepada kelajuan, tetapi reka bentuk memberikan Qwen3.8-Flash sasaran kecekapan yang jelas.
Alibaba juga melaporkan bahawa latihan memerlukan kira-kira satu per sembilan sumber Qwen3.7-Plus sambil meningkatkan prestasi pengaturcaraan dan tugas pejabat. Secara berasingan, mod QwenWork Standard yang dikuasakan oleh model ini dilaporkan mengurangkan penggunaan token setiap tugas sebanyak 75% dan kira-kira menggandakan kelajuan penjanaan berbanding mod sebelumnya. Nombor peringkat produk itu tidak harus dianggap sebagai jaminan kependaman API sejagat, tetapi ia menunjukkan bagaimana Alibaba menjangka model ini digunakan.
Harga Qwen3.8-Flash
Pengumuman pelancaran Alibaba menyenaraikan harga QwenCloud pada $0.16 setiap sejuta token input dan $0.47 setiap sejuta token output. Harga mungkin berbeza mengikut wilayah, permukaan produk, cache, atau kemas kini kemudian, jadi pasukan produksi harus sentiasa menyemak halaman penyedia langsung sebelum menganggar beban kerja besar.
Pada masa artikel ini disediakan, CometAPI menyenaraikan Qwen3.8-Flash pada $0.12 setiap sejuta token input dan kira-kira $0.376 setiap sejuta token output. Halaman model CometAPI melabelkannya sebagai diskaun 20% berbanding harga rujukan yang disenaraikan.
| Laluan | Input / 1M token | Output / 1M token | Contoh: 10M input + 2M output |
|---|---|---|---|
| Kadar pelancaran QwenCloud | $0.16 | $0.47 | $2.54 |
| Kadar tersenarai CometAPI | $0.12 | ~$0.376 | ~$1.95 |
Untuk beban kerja dengan 10 juta token input dan 2 juta token output, aritmetik kadar pelancaran ialah kira-kira $2.54 di QwenCloud berbanding kira-kira $1.95 pada kadar CometAPI yang tersenarai kini. Bil agen sebenar boleh lebih tinggi kerana panggilan alat, percubaan semula, penaakulan panjang, konteks berulang, dan perkhidmatan luaran menambah kos. Bandingkan kos per hasil diterima dan bukannya harga token sahaja.
Qwen3.8-Flash vs. Qwen3.8-Max vs DeepSeek V4 Flash
| Dimensi | Qwen3.8-Flash | Qwen3.8-Max | Gemini 3.7 Flash | DeepSeek V4 Flash |
|---|---|---|---|---|
| Kedudukan | Model produksi berkecekapan dahulu | Model perdana Qwen | Model Flash tulang belakang Google | MoE teks berkecekapan dahulu |
| Jumlah / parameter aktif | 125B + 51B carian / 6B | 2.4T / ~95B | Tidak didedahkan | 284B / 13B |
| Konteks | 1M terhos | 1M | 1,048,576 | 1M |
| Multimodal | Teks + visi didokumen | Teks + imej + video | Teks + imej + video + audio + PDF | Fokus teks |
| Kawalan penaakulan | low / medium / xhigh | Penaakulan lanjutan / mod pantas | low / medium / high | Non-think / Think / Think Max |
| Harga input CometAPI | US$0.12/M | US$1.60/M | US$0.60/M | US$0.176/M |
| Harga penyedia rasmi (input / output) | US$0.15 / US$0.47 (Alibaba Cloud antarabangsa) | US$2 / US$6 (Alibaba Cloud antarabangsa) | US$0.75 / US$3.75 hingga 31 Dis. 2026 | Kemuncak: US$0.44 / US$1.32; luar kemuncak: US$0.22 / US$0.66 |
| Kesesuaian terbaik | Pengaturcaraan volum tinggi, agen, cowork | Tugas Qwen paling sukar, autonomi jangka panjang | Ekosistem alat Google, agen multimodal luas | Penaakulan teks dan pengaturcaraan throughput tinggi |
Di Mana Qwen3.8-Flash Menang
- Kecekapan komput aktif: 6B parameter diaktifkan amat kecil bagi model yang mencatat skor pengaturcaraan agen dan multimodal yang kukuh.
- Nilai ekosistem Qwen: Qwen3.8-Flash jauh lebih murah daripada Qwen3.8-Max untuk beban kerja yang tidak memerlukan tier perdana.
- Keseimbangan agen + pejabat: Keluaran ini luar biasa kuat pada CoWorkBench, JobBench, Toolathlon, SWE-bench Pro, dan tugas agen multimodal dan bukannya hanya QA akademik.
- Laluan wajaran terbuka: Qwen3.8-Flash-Next menyediakan wajaran untuk pasukan yang memerlukan penyebaran setempat, penilaian bebas, atau talaan lanjut.
Di Mana Model Lain Mungkin Lebih Baik
- Guna Qwen3.8-Max untuk keupayaan puncak Qwen. Tier Max mempunyai bajet komput aktif jauh lebih besar dan direka untuk kerja jangka panjang paling sukar.
- Guna Gemini 3.7 Flash apabila sokongan modaliti input yang luas penting. Model Flash Google merangkumi audio, video, PDF, dan integrasi alat Google yang mendalam.
- Guna DeepSeek V4 Flash apabila kecekapan berfokuskan teks menjadi keutamaan. Ia menang pada NL2Repo-Bench dalam perbandingan Qwen dan kekal sebagai alternatif pengaturcaraan berfokus kos yang kukuh.
- Guna Claude Opus 4.6 apabila penaakulan premium dan kematangan aliran kerja perusahaan membenarkan harga. Dalam jadual keluaran Qwen, ia masih mendahului HLE dan kekal amat kompetitif pada GPQA.
Kes Penggunaan Terbaik untuk Qwen3.8-Flash
Agen Pengaturcaraan dan Kerja Repositori
Qwen3.8-Flash sesuai untuk penyelesaian isu, penstrukturan semula, semakan kod, navigasi repositori, penjanaan ujian, nyahpepijat, dan gelung pengaturcaraan dipacu alat. Keputusan LiveCodeBench dan SWE-bench Pro yang tinggi mencadangkan ia bukan sekadar model sembang kependaman rendah; ia direka untuk kerja perisian berbilang langkah.
Kerja Pengetahuan Perusahaan Berkonteks Panjang
Konteks produksi 1M token boleh memuatkan koleksi dokumen besar, pangkalan kod, log, transkrip mesyuarat, atau sejarah agen jangka panjang. Keputusan CoWorkBench dan JobBench menjadikan model ini amat menarik untuk sintesis dokumen, aliran kerja hamparan/slaid, sokongan penyelidikan, semakan pematuhan, dan analisis operasi.
Agen Multimodal
Skor AndroidWorld, RealWorldQA, ERQA, dan MathVision menunjukkan ke arah agen yang mesti memahami tangkapan skrin, dokumen visual, antara muka, diagram, dan imej dunia sebenar sebagai sebahagian daripada aliran kerja. Ini menjadikan model relevan untuk agen pelayar, ujian UI, QA visual, agen dokumen, dan automasi sedar skrin.
Perutean Volum Tinggi
Memandangkan Qwen3.8-Flash jauh lebih murah daripada model perdana, seni bina praktikal ialah merutekan kebanyakan trafik produksi ke Flash dan meningkatkan hanya permintaan yang samar, berisiko tinggi, atau sangat sukar ke Qwen3.8-Max atau model premium lain. Gerbang bersatu seperti CometAPI memudahkan corak perutean ini kerana aplikasi boleh menukar penyedia di belakang satu kontrak API.
Had dan Perhatian
- Penanda aras dilaporkan sendiri. Ada yang menggunakan harness terpilih Qwen, tugas dalaman, atau tetapan berkemampuan alat. Pengesahan bebas masih penting.
- Bukan setiap penanda aras adalah kemenangan. DeepSeek V4 Flash mendahului NL2Repo-Bench dalam perbandingan rasmi, dan Claude Opus 4.6 mendahului HLE.
- Penggunaan komputer kekal sukar secara mutlak. Keluaran melaporkan skor binari OSWorld 2.0 sebanyak 19.4 walaupun prestasi kredit separa jauh lebih tinggi.
- Tingkah laku terhos dan wajaran terbuka boleh berbeza. Prompt sistem, alat, pengurusan konteks, pengkuantuman, timbunan penyajian, dan kemas kini penyedia boleh mengubah hasil dunia sebenar daripada set penanda aras Flash-Next yang diterbitkan.
- Harga adalah dinamik. Pengumuman pelancaran dan halaman agregator semasa boleh menunjukkan harga rujukan yang sedikit berbeza. Gunakan harga titik akhir langsung semasa membuat belanjawan.
Cara Menggunakan API Qwen3.8-Flash dengan CometAPI
CometAPI mendedahkan Qwen3.8-Flash melalui titik akhir serasi OpenAI, jadi integrasi SDK OpenAI sedia ada biasanya boleh bertukar dengan menukar kunci API, URL asas, dan ID model.
Mengapa Guna CometAPI untuk Qwen3.8-Flash?
CometAPI memberi pembangun titik akhir API bersatu untuk menguji Qwen3.8-Flash bersama model lain tanpa menyelenggara integrasi penyedia berasingan. Ini amat berguna untuk perbandingan penanda aras, perutean sandaran, dan pemilihan model berasaskan kos.
- Cipta kunci API CometAPI. Jana kunci dalam papan pemuka CometAPI dan simpan dalam pembolehubah persekitaran dan bukannya kod sumber.
- Guna URL asas bersatu. Tetapkan URL asas SDK kepada
https://api.cometapi.com/v1. - Pilih model. Guna qwen3.8-flash sebagai ID model.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[
        {"role": "system", "content": "You are a precise coding assistant."},
        {"role": "user", "content": "Review this API design and identify reliability risks."},
    ],
)

print(response.choices[0].message.content)
cURL
curl "https://api.cometapi.com/v1/chat/completions" \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-flash",
    "messages": [
      {"role": "user", "content": "Summarize the main risks in this migration plan."}
    ]
  }'
Untuk produksi, tambah pengendalian tamat masa, dasar cubaan semula, had token, pengesahan output berstruktur, dan telemetri perutean model. Jika aliran kerja anda bersifat agen, jejak kegagalan panggilan alat dan kadar tugas diterima selain kependaman model mentah.
Soalan Lazim (FAQ)
Adakah Qwen3.8-Flash sumber terbuka?
Laluan Qwen3.8-Flash produksi ialah API terhos. Rakan sepadan berwajaran terbukanya, Qwen3.8-Flash-Next, mempunyai wajaran yang dikeluarkan di Hugging Face dan ModelScope. “Wajaran terbuka” ialah istilah yang lebih tepat kerana hak penggunaan bergantung pada lesen model.
Apakah tetingkap konteks Qwen3.8-Flash?
Model terbuka menyokong 262,144 token secara asli dan boleh dilanjutkan ke 1,000,000 token dengan YaRN. Alibaba menyatakan perkhidmatan Qwen3.8-Flash produksi menggunakan konteks 1M token secara lalai.
Berapa banyak parameter yang Qwen3.8-Flash ada?
Keluaran mempunyai model utama 125B parameter, 51B parameter embedding N-gram, dan 6B parameter diaktifkan setiap token. Kiraan aktif yang rendah adalah teras kepada reka bentuk kecekapannya.
Adakah Qwen3.8-Flash menyokong imej?
Ya. Keluaran adalah multimodal, timbunan penyebaran berwajaran terbuka menyokong teks dan visi, dan contoh integrasi rasmi menyenaraikan input teks dan imej untuk model terhos. Permukaan khusus penyedia mungkin mendedahkan gabungan modaliti berbeza, jadi semak halaman keupayaan API semasa sebelum penyebaran.
Adakah Qwen3.8-Flash lebih baik daripada Qwen3.8-Max?
Tidak secara universal. Qwen3.8-Flash ialah pilihan lebih baik apabila kependaman, komput aktif, dan harga penting. Qwen3.8-Max ialah pilihan perdana untuk tugas jangka panjang paling sukar dan bernilai tinggi. Sistem perutean boleh menggunakan kedua-duanya.
Berapa kos Qwen3.8-Flash?
Alibaba mengumumkan $0.16/M token input dan $0.47/M token output untuk QwenCloud pada pelancaran. CometAPI kini menyenaraikan kira-kira $0.12/M input dan $0.376/M output. Semak harga langsung kerana kadar penyedia dan agregator boleh berubah.
Kesimpulan
Qwen3.8-Flash ialah salah satu contoh paling jelas peralihan semasa daripada “model lebih besar” kepada “ekonomi sistem lebih baik.” Tulang belakang utama 125B kelihatan besar di atas kertas, tetapi model ini mengaktifkan hanya 6B parameter setiap token dan menambah kapasiti melalui embedding N-gram gaya carian. QSA, Gated Residual, perutean MoE ultra-jarang, dan reka bentuk penyajian berorientasikan konteks panjang semuanya menolak ke arah yang sama: menyampaikan keupayaan pengaturcaraan agen dan multimodal tanpa kos inferens peringkat perdana.
Keputusan keluaran amat meyakinkan untuk kejuruteraan perisian, agen pejabat, penggunaan alat, dan aliran kerja visual. Pada masa yang sama, model ini tidak unggul secara seragam: DeepSeek V4 Flash menang sekurang-kurangnya satu penanda aras penjanaan repo dalam jadual Qwen sendiri, Claude Opus 4.6 kekal lebih kuat pada HLE, dan Qwen3.8-Max masih tier Qwen berkeupayaan lebih tinggi.
Bagi pembangun, langkah praktikal seterusnya ialah menilai Qwen3.8-Flash pada tugas sebenar dan membandingkan kos per hasil diterima berbanding Gemini 3.7 Flash, DeepSeek V4 Flash, dan model premium dalam timbunan perutean anda. CometAPI menyediakan satu antara muka serasi OpenAI untuk jenis pengujian dan penyebaran berbilang model itu.