
TL;DR
Claude Opus 5.5 is een sterke startkeuze omdat het aanzienlijk lagere tokenprijzen biedt en Fable 5.1 evenaart of overtreft op meerdere gepubliceerde evaluaties, met $4 per miljoen inputtokens en $20 per miljoen outputtokens, vergeleken met Fable 5.1 op $10 en $50.
Fable 5.1 blijft relevant wanneer een taak uitzonderlijk moeilijk is, lang duurt, duur is om te herhalen of zonder nauw toezicht moet draaien. De praktische regel is eenvoudig: begin met Opus 5.5, en schaal pas op wanneer representatieve productieproeven aantonen dat Fable 5.1 de faal-, correctie- of herstartkosten genoeg verlaagt om de premie te rechtvaardigen.
Claude Opus 5.5 vs Claude Fable 5.1 in één oogopslag
| Dimensie | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Releasedatum | 22 sep. 2026 | 1 sep. 2026 |
| API-model-ID | claude-opus-5-5 | claude-fable-5-1 |
| Context / max output | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache-read per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66,4% | 55,8% |
| FrontierCode v1.1 | 54,4% | 50,3% |
| CursorBench 4.0 | 57,8% | 51,8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-naar-Rust-migratie | 9,5 uur; 51% lagere taakkosten | 12 uur; basiskosten |
| Snelheidsoptie | Fast mode, tot 2,5× normale snelheid | Geen gelijkwaardige startmodus |
| Startpositie voor effort | Medium-georiënteerd | High |
| Beste standaardtoepassing | Dagelijkse frontier-coding, agents, begeleide productie en hoogvolume API-verkeer | Hoogste waarde, moeilijk, langdurig of onbewaakt autonoom werk |
| API-toegang | Anthropic API en compatibele providers, waaronder CometAPI | Anthropic API en compatibele providers, waaronder CometAPI |
Leeswijzer: Benchmarkcijfers zijn door Anthropic gerapporteerd en hangen af van effortniveau, harnas, waarborgen, taakrelease, aantal trials en standaardfout. Vergelijk ze alleen onder gematchte evaluatiecondities.
Belangrijkste punten
- De standaard input- en outputtarieven van Opus 5.5 liggen 60% onder die van Fable 5.1.
- Beide modellen ondersteunen een contextvenster van 1M tokens en tot 128K output, dus kosten, effortinstellingen en workloadfit zijn belangrijker dan de nominale contextgrootte.
- Door Anthropic gepubliceerde resultaten geven Opus 5.5 de voorkeur op veel codeer- en agentische evaluaties, maar benchmarkinstellingen beïnvloeden de uitkomst aanzienlijk.
- Onafhankelijke evaluatie ondersteunt de frontierpositie van Opus 5.5 met andere absolute scores, wat het belang van gematcht testen onderstreept.
- Voor de meeste begeleide productie is Opus 5.5 het sterkere startpunt. Fable 5.1 is een escalatielaag, niet de automatische standaard.
Wat is Claude Opus 5.5?
Claude Opus 5.5 is het eerste Claude 5.5-model van Anthropic. Het is gepositioneerd voor agentisch coderen, langlopende agents, professioneel kenniswerk, bedrijfsworkflows, financiële analyse, vision en computergebruik.
De API-model-ID is claude-opus-5-5. Adaptive thinking is altijd ingeschakeld, terwijl ontwikkelaars de redeneerintensiteit kunnen sturen via de effortinstellingen low, medium, high, xhigh en max. Anthropic biedt ook Fast mode, die tot 2,5 keer de normale snelheid kan draaien voor $8/M input en $40/M output.
Wat is Claude Fable 5.1?
Claude Fable 5.1 is gepositioneerd voor veeleisende, langlopende projecten zoals meeruur durend coderen, complexe research, browserinteractie, autonome agents en workflows over meerdere applicaties.
De API-model-ID is claude-fable-5-1. Het gebruikt adaptive thinking, start vanuit een hogere API-effortinstelling en is het best te behandelen als de premiumoptie wanneer de verwachte kosten van falen of herhaald opnieuw proberen hoger zijn dan de extra inferentiekosten.
Een vereenvoudigde lezing is dat Opus 5.5 vrijwel dezelfde bandbreedte biedt voor 40% van Fable’s standaard tokenprijs. Precies hier wordt een eenvoudige specificatietabel misleidend.
Vergelijking van code en benchmarks
Anthropic rapporteert Opus 5.5 vóór Fable 5.1 op Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 en Chartography.
Hoe benchmarkresultaten te interpreteren
Anthropic rapporteert Opus 5.5 vóór Fable 5.1 op Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 en Chartography. Deze cijfers zijn evaluatieresultaten, geen configuratie-onafhankelijke modelconstanten.
De meeste headlinecijfers voor Opus 5.5 gebruikten max effort, terwijl Terminal-Bench 4.0 xhigh effort gebruikte. Harnasontwerp, toolconfiguratie, waarborgen, aantal trials, standaardfout, fallbackgedrag en kostplafonds kunnen allemaal de uitkomst veranderen. Anthropic zelf waarschuwt dat benchmarkmarges de praktische kloof tussen frontiermodellen kunnen overdrijven.
Programmeersprestaties
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretatie |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | Gerapporteerde voorsprong van 10,6 punten voor terminal-agenttaken |
| FrontierCode v1.1 | 54,4% max; 54,6% medium | 50,3% | Medium-effort Opus 5.5 blijft competitief voor productie-economie |
| CursorBench 4.0 | 57,8% max; 52,5% medium | 51,8% | Medium-effort ligt iets boven het gerapporteerde Fable-resultaat |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Gerapporteerd voordeel op professioneel agentisch werk |
Deze cijfers zijn door Anthropic gerapporteerde benchmarkresultaten. De tabel moet gelezen worden in samenhang met de kanttekeningen over evaluatie-instellingen in de volgende secties en de officiële Claude Opus-modelpagina.
De eerste drie resultaten vallen op omdat ze het werkgebied bestrijken waar Claude commercieel steeds belangrijker wordt: software-engineeringagents. Terminal-Bench 4.0 toont een absoluut verschil van 10,6 procentpunten; FrontierCode toont 4,1 punten; CursorBench 4.0 toont 6 punten.
GDPval-AA, dat professioneel agentisch werk meet, meldt ook 1846 Elo voor Opus 5.5 versus 1735 voor Fable 5.1. Als dit het hele verhaal was, zou de producthiërarchie omgekeerd lijken. Zo simpel is het niet.
Onafhankelijke evaluatie
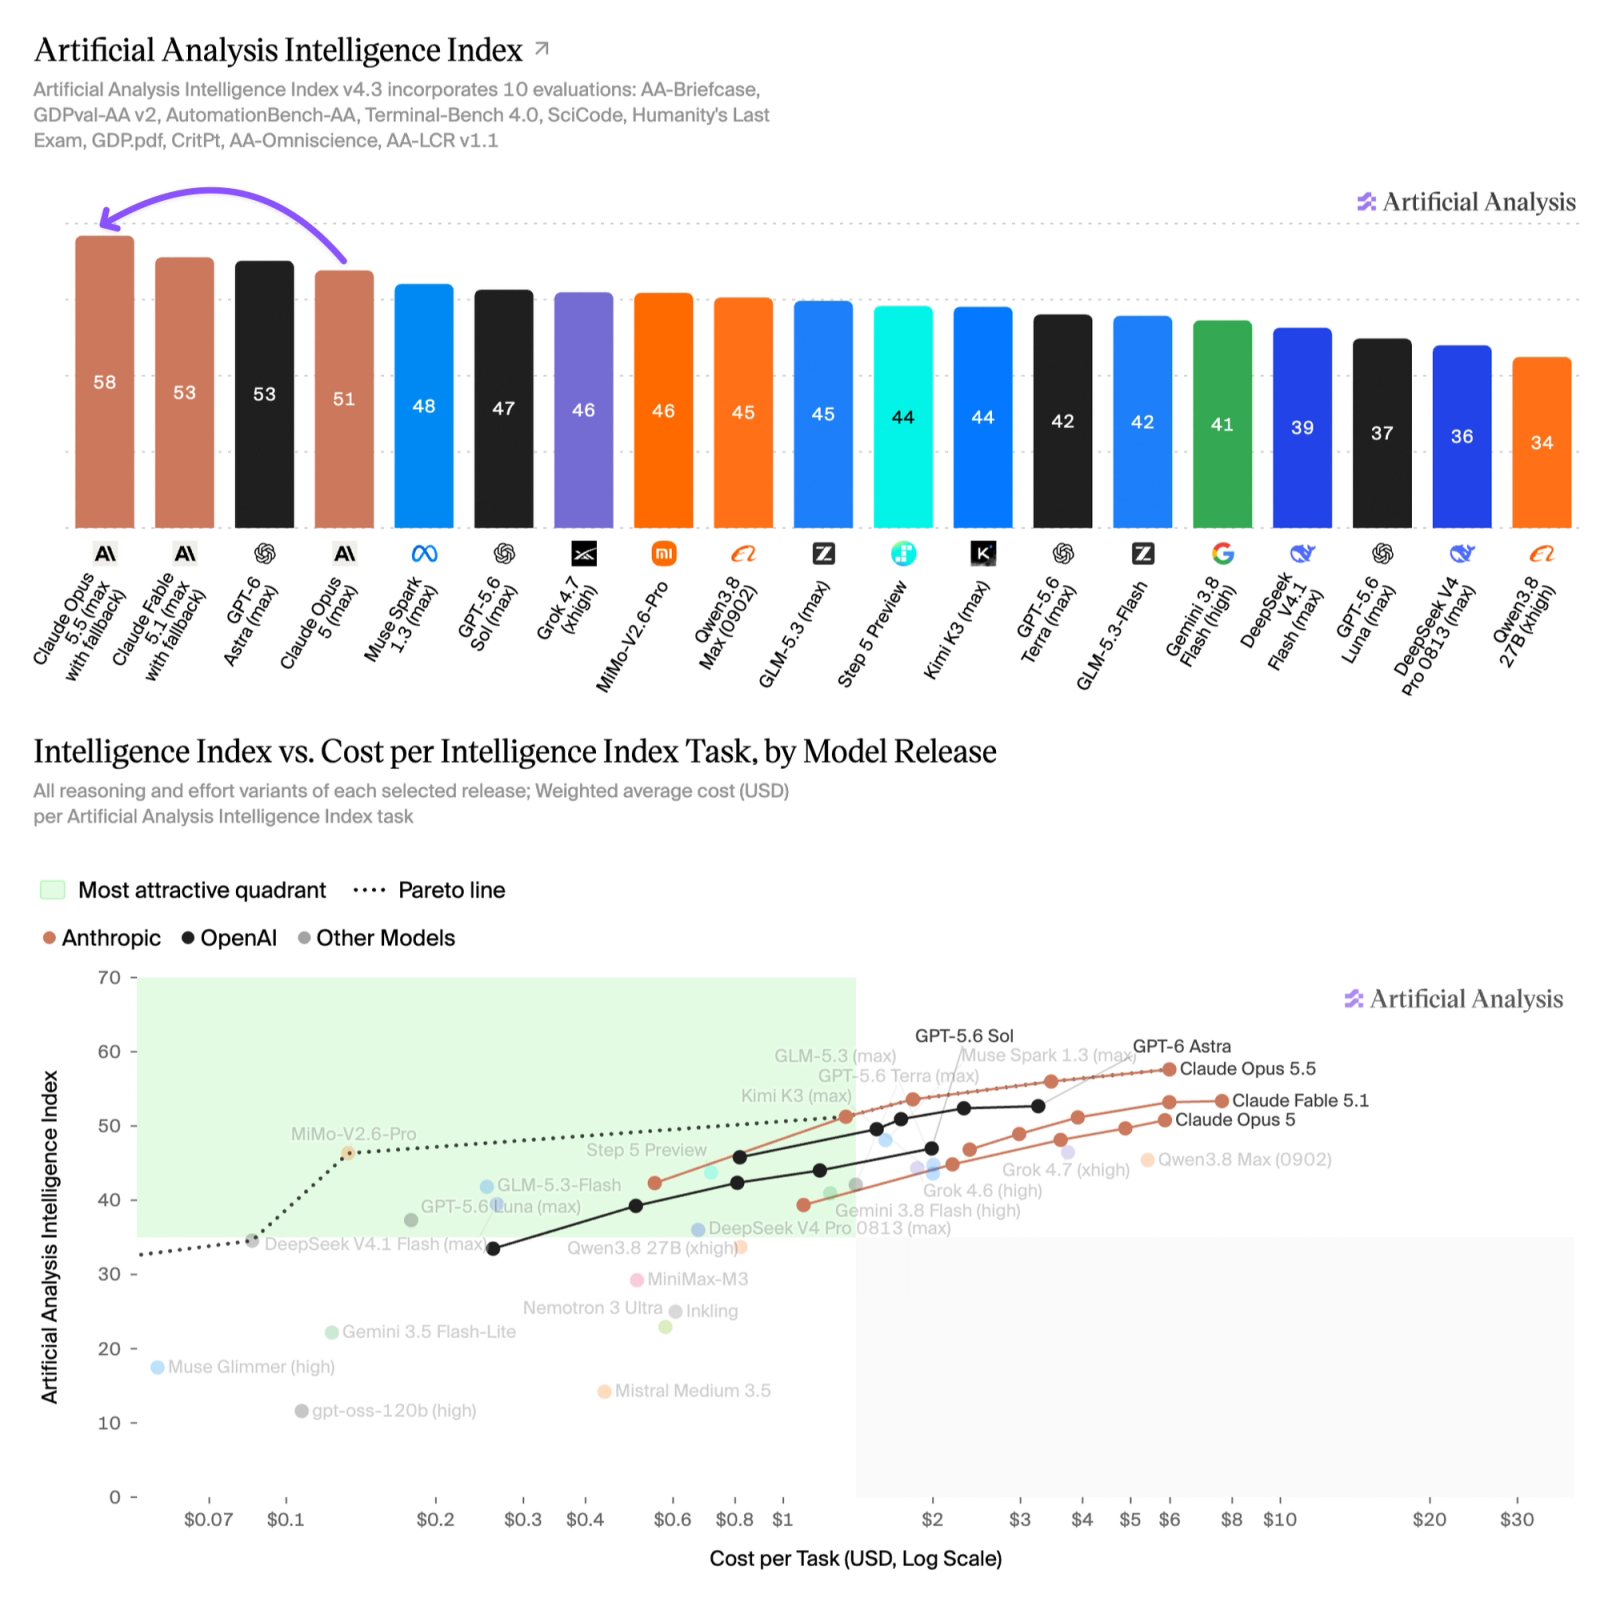
Artificial Analysis plaatste Opus 5.5 Max op 58 op de Intelligence Index en rapporteerde sterke resultaten op AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode en Humanity's Last Exam. Het Terminal-Bench 4.0-resultaat was 59,6%, lager dan de 66,4% van Anthropic, wat aantoont waarom teams het model, het effortniveau, het harnas, de tools, het aantal trials en het kostplafond moeten documenteren wanneer scores verschillen.
Vergelijking van prijs en kosten per voltooide taak
CometAPI biedt tokenprijzen die lager zijn dan de officiële tarieven, zodat ontwikkelaars dezelfde prestaties kunnen behalen als de officiële API met het standaardberichtformaat.
Token-prijzen
| Prijzen | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| Cache-write 5 min | $5 | $12.50 |
| Cache-write 1 uur | $8 | $20 |
| Cache-read | $0.20 | $0.25 |
| Batch input/output | 50% korting | 50% korting |
Stel dat een workload 10 miljoen verse inputtokens en 2 miljoen outputtokens verbruikt. Zonder cache-effecten:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Onder die aannames kost Opus 5.5 60% minder. Dit moet echter niet verward worden met Anthropic’s uitspraak dat Opus 5.5 ongeveer 40% goedkoper is om te draaien dan Opus 5.
Dat zijn twee totaal verschillende vergelijkingen. De 40%-figuur omvat zowel de lagere Opus-tierprijzen van Opus 5.5 als de verminderde tokenconsumptie per taak ten opzichte van Opus 5. De 60%-figuur komt rechtstreeks uit de vergelijking van de standaardprijzen van Opus 5.5 en Fable 5.1.
Kosten per voltooide taak
Een model-API verkoopt in feite geen tokens. Ontwikkelaars kopen voltooid werk.
Een codeteam geeft er niet om dat een model 6,2 miljoen tokens heeft verbruikt. Het gaat erom of het model de bug heeft verholpen, de migratie heeft voltooid, de test-suite heeft gehaald of de researchtaak heeft afgerond.
Anthropic maakt dit punt expliciet in de analyse What a task costs on Opus 5.5: twee modellen met vergelijkbare prijzen kunnen zeer verschillende taakkosten hebben als het ene meer beurten nodig heeft, meer context herleest, vaker opnieuw probeert of meer thinking-tokens genereert.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Dat laatste item wordt vaak over het hoofd gezien. Een goedkoper model dat twee keer faalt, kan duurder worden dan een duurder model dat de taak in één run voltooit. Evenzo kan een hoog effortniveau dat tien herhaalbeurten voorkomt de totale kosten juist verlagen.
Economische aspecten van prompt-caching
Cache-intensieve agents hergebruiken herhaaldelijk tooldefinities, repositorycontext, systeeminstructies, gespreksgeschiedenis en testoutput. Omdat de cache-readprijs $0.20/M is voor Opus 5.5 en $0.25/M voor Fable 5.1, is de kloof veel kleiner dan het verschil van $6/M in verse inputprijzen. Teams moeten daarom verse input, cache-reads, cache-writes, output, toolbeurten en retries apart bijhouden.
Economische aspecten per effortniveau
Potentieel wel. Artificial Analysis testte vijf Opus 5.5-effortinstellingen en vond een duidelijke curve tussen capaciteit en kosten.
| Opus 5.5-effort | Artificial Analysis Intelligence Index | Kosten per Index-taak |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Medium-effort is een verstandig startpunt voor routinematige codewijzigingen, bekende refactors en begeleid debuggen. High of xhigh kan gerechtvaardigd zijn bij ambigue systeemstoringen, nachtelijke migraties of taken waarbij een verkeerd plan veel herwerk veroorzaakt.
Vergelijking van veiligheid en betrouwbaarheid
Geen van beide modellen moet als veiliger worden bestempeld uitsluitend op basis van capaciteitsbenchmarks. Een verdedigbare vergelijking vereist gematchte prompts, tools, permissies, effortinstellingen, retrylimieten en acceptatiecriteria. Hogere capaciteit kan toevallige fouten verminderen, maar grotere autonomie en langere uitvoering vergroten ook de impact van een slecht plan, promptinjectie, onveilige toolaanroep of onopgemerkte drift.
| Veiligheidsdimensie | Praktische vergelijking | Controle in productie |
|---|---|---|
| Redeneren en effort | Opus 5.5 biedt meerdere effortniveaus, terwijl Fable 5.1 vanuit een hogere effortpositie start. Meer redeneren vervangt geen handhaving van beleid. | Leg de effortpolicy per workload vast en hertest het veiligheidsgedrag wanneer die verandert. |
| Langdurige autonomie | Fable 5.1 is gepositioneerd voor moeilijk, onbewaakt werk; Opus 5.5 ondersteunt ook agentische workflows. Risico groeit met duur, permissies en het aantal onomkeerbare acties. | Gebruik checkpoints, goedkeuringspoorten, tijd- en kostplafonds en automatische rollback- of uitschakelcondities. |
| Tool- en computergebruik | Beide modellen kunnen tools bedienen, dus de modelkeuze alleen beheerst niet de data-exposure of destructieve acties. | Pas least privilege toe, allowlists, sandboxing, scheiding van secrets en bevestiging vóór externe of onomkeerbare acties. |
| Evaluatie en auditability | Publieke benchmarkscores bewijzen geen weigeringskwaliteit, weerstand tegen promptinjectie of incidentpercentages in productie. | Log toolaanroepen en beleidsbeslissingen; meet unsafe-compliance rate, false refusals, injectiesucces, secret-lekkage, destructieve pogingen en herstelkwaliteit. |
Praktische veiligheidsregel: begin met de minst-privileged Opus 5.5-configuratie die aan de taak voldoet, en schaal pas op naar Fable 5.1 nadat dezelfde veiligheidsreeks slaagt. Voor workflows met hoge impact is menselijke goedkeuring vereist, ongeacht welk model hoger scoort op capaciteitsproeven.
- Voer adversariële prompt-injectie- en data-exfiltratietests uit met de echte productietoolset.
- Scheid lees-, schrijf-, publiceer-, verwijder- en financiële permissies in plaats van één brede toolrol te verlenen.
- Definieer rollback-triggers voor beleidschendingen, herhaalde toolfouten, onverwachte scope-uitbreiding en kostenoverschrijdingen.
- Hervalid eer na wijzigingen in model, systeemprompt, effort, tools, permissies of routing.
Hoe kies je tussen Opus 5.5 en Fable 5.1
| Workload | Aanbevolen startpunt | Escalatievoorwaarde |
|---|---|---|
| Dagelijks coderen en code review | Opus 5.5, medium effort | Schaal op alleen bij uitzonderlijk moeilijke of risicovolle cases |
| Featurewerk over meerdere files | Opus 5.5, medium of high | Gebruik Fable wanneer herhaalde planningsfouten de kosten domineren |
| Repository-brede migratie | Test eerst Opus 5.5 high of xhigh | Schaal op voor de moeilijkste onbewaakte projecten |
| Nachtelijke autonome runs | Opus 5.5 met strikte checkpoints | Geef de voorkeur aan Fable wanneer een verkeerde richting extreem kostbaar is |
| Hoogvolume API-verkeer | Opus 5.5 | Escaleer alleen de minderheid van taken die foutgevoelig is |
| Bestaande gevalideerde Fable-implementatie | Behoud de huidige implementatie tijdens testen | Schakel pas over nadat Opus dezelfde acceptatiedrempels haalt |
Een praktische productietest
Voer dezelfde representatieve taken, prompts, tools, effortpolicy, acceptatiecriteria en retrylimieten door beide modellen. Registreer acceptatiegraad, latency, verse en gecachete input, output- en thinking-tokens, toolaanroepen, retries, menselijke correcties en totale kosten per geaccepteerd resultaat. Neem routinetaken en moeilijke faalgevallen op.
Migratierichtlijnen voor bestaande Claude Opus 5-gebruikers
Bestaande Opus 5-gebruikers moeten Opus 5.5 testen als opvolger in plaats van aan te nemen dat een model-ID-swap risicoloos is. Vergelijk planningsdiepte, tool- aanroep patronen, antwoords lengte, naleving van formaat, latency, prompt-cachegedrag, herstel na mislukte toolaanroepen, veiligheidsrouting en kosten per voltooide taak. Houd rollbackcriteria en het bestaande model beschikbaar totdat Opus 5.5 productielijke acceptatietests doorstaat.
Bestaande Fable 5.1-gebruikers hebben geen generieke migratiesectie nodig. Zij moeten Opus 5.5 behandelen als een kandidaat-optimalisatie en het onder dezelfde productie-acceptatiecriteria evalueren alvorens een gevalideerde implementatie te wijzigen.
Toegang via CometAPI
Ontwikkelaars die een van beide modellen evalueren, kunnen de gerelateerde CometAPI-gidsen bekijken voor Claude Opus 5.5 en Claude Fable 5.1. Bevestig bij integratie via een compatibele API-provider de exacte model-ID, ondersteunde effortparameters, cachegedrag, snelheidslimieten, regionale beschikbaarheid en actuele prijs vóór productiedeploy.
Gebruik claude-opus-5-5 voor Opus 5.5 en claude-fable-5-1 voor Fable 5.1 waar die identifiers worden ondersteund. Vermijd om beide workloadklassen stilzwijgend via één vast effortniveau te routeren; modelselectie en effortpolicy moeten onafhankelijk worden geconfigureerd.
Python — Anthropic Messages API via CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Conclusie
Claude Opus 5.5 verschuift de praktische grens tussen het dagelijkse frontiermodel van Anthropic en de premium escalatielaag. Het is substantieel goedkoper bij standaard tokenprijzen, leidt veel gepubliceerde codeer- en agentische benchmarks, en biedt genoeg effortflexibiliteit om een breed productiebereik af te dekken.
Claude Fable 5.1 blijft relevant wanneer de taak moeilijk, hoogwaardig, langdurig of onbewaakt is en de kosten van falen zwaarder wegen dan de hogere inferentiekosten. Voor de meeste teams is het beste beleid: begin met Opus 5.5, meet uitkomsten per voltooide taak, en schaal selectief op.
Veelgestelde vragen
Hoe moeten teams een productie-A/B-test voor Opus 5.5 en Fable 5.1 ontwerpen?
Gebruik dezelfde representatieve taken, prompts, tools, effortpolicy, acceptatiecriteria en retrylimieten voor beide modellen. Registreer acceptatiegraad, latency, verse en gecachete input, output- en thinking-tokens, toolaanroepen, retries, menselijke correcties en totale kosten per geaccepteerd resultaat. Voer genoeg taken uit om zowel routinewerk als moeilijke faalgevallen te dekken.
Wanneer kan lagere tokenpricing er niet in slagen de totale taakkosten te verlagen?
Een lager geprijsd model kan alsnog meer kosten als het extra beurten nodig heeft, meer context herleest, meer thinking-tokens produceert of herhaaldelijk opnieuw moet proberen. Cachegedrag is ook belangrijk: de inputprijskloof verkleint in lange sessies die worden gedomineerd door cache-reads. Vergelijk kosten per voltooide taak in plaats van alleen de lijstprijs.
Wat moet worden gedocumenteerd wanneer benchmarkresultaten van elkaar afwijken?
Noteer het model, effortniveau, harnas, fallback- en veiligheidsinstellingen, aantal trials, taakrelease, standaardfout en kostplafond. Label elk resultaat als officieel of onafhankelijk en vermijd het combineren van scores uit ongematchte configuraties in één ranking.
Welke migratierisico’s moeten bestaande Fable 5.1-gebruikers monitoren?
Let op wijzigingen in planningsdiepte, tool-aanroep patronen, antwoords lengte, naleving van formaat, latency, prompt-cachegedrag, herstel bij toolfalen en veiligheidsrouting. Houd de bestaande implementatie beschikbaar tijdens evaluatie, stel rollbackcriteria vast en migreer pas nadat Opus 5.5 dezelfde acceptatiedrempels haalt op productielijke taken.
SEO-metagegevens
Metatitel: Claude Opus 5.5 vs Fable 5.1: Code, kosten en benchmarks
Metabeschrijving: Vergelijk Claude Opus 5.5 en Claude Fable 5.1 op codeerbenchmarks, API-prijzen, snelheid, caching, effortinstellingen, kosten per voltooide taak en workload-fit.
Trefwoorden: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude codeerbenchmarks, Claude API-prijzen, CometAPI, AI-codeermodellen
URL-slug: claude-opus-5-5-vs-claude-fable-5-1