
TL;DR
DeepSeek V4.1 Flash vervangt de eerdere V4 Flash-generatie door een causale encoder–decoder MoE-model met 552B parameters, native beeldbegrip, een contextvenster van 1M tokens en aanmerkelijk lagere bedieningskosten. In DeepSeek’s officiële vergelijking verbetert het de meeste benchmarks voor codering, terminal, security en agents ten opzichte van V4 Pro 0813, terwijl V4 Pro voorloopt op GPQA Diamond en HLE zonder tools.
De huidige API-prijskaart van DeepSeek vermeldt opnieuw deepseek-flash en deepseek-v4-pro als afzonderlijke routes, die respectievelijk V4.1 Flash en V4‑Pro‑0813 aanbieden. Ze hebben verschillende prijzen, gelijktijdigheidslimieten en ondersteuning voor vision. Nieuwe integraties moeten daarom de model-ID kiezen die bij de beoogde workload past in plaats van te vertrouwen op historisch aliasgedrag.
Belangrijkste punten
- V4.1 Flash en V4 Pro zijn momenteel afzonderlijke officiële API-keuzes: gebruik deepseek-flash voor V4.1 Flash en deepseek-v4-pro voor V4‑Pro‑0813.
- De grootste vergelijkbare winst zit in terminaltaken, codeeragents, automatisering en security-gerichte uitvoering—niet in elke benchmark voor gesloten-boekredeneren.
- V4.1 Flash is wezenlijk goedkoper dan de momenteel vermelde V4 Pro-route voor cache-hit input, cache-miss input en outputtokens.
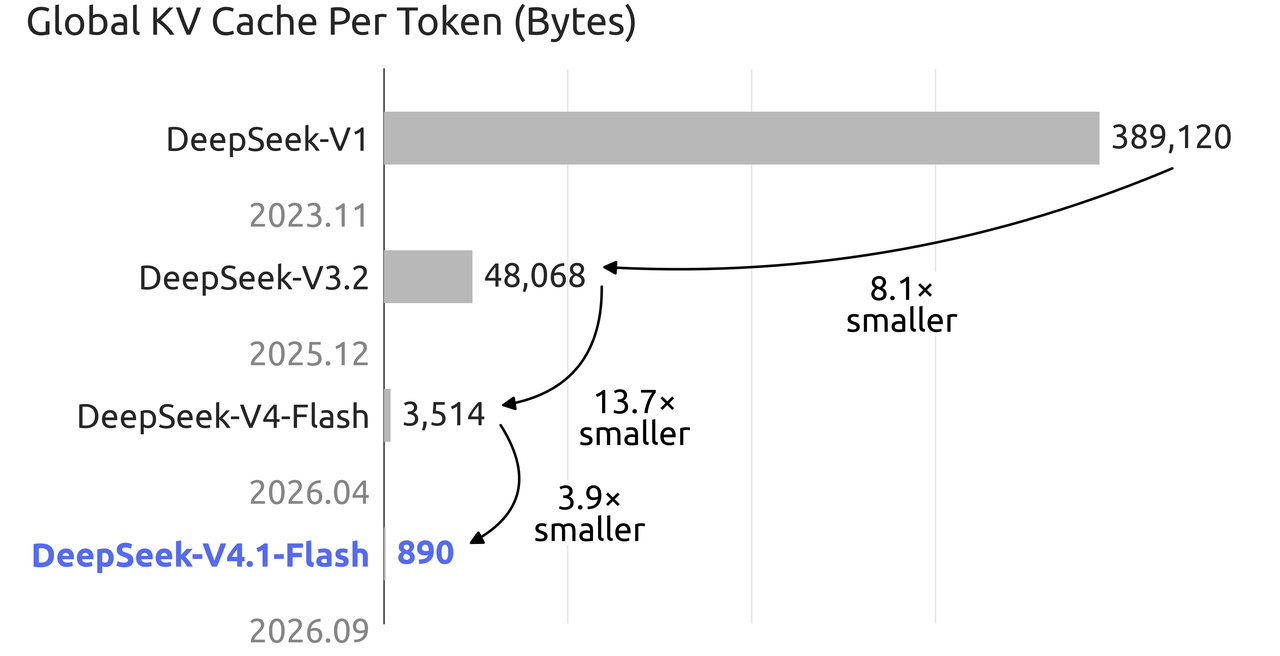
- V4.1 Flash voegt native vision toe, verhoogt de gedocumenteerde gelijktijdigheid van 500 naar 2,500 en verlaagt de globale KV-cacheopslag naar 890 bytes per token.
- Migratie moet expliciet zijn, ook al werken aliassen: werk model‑ID’s bij, valideer thinking- en non-thinking-gedrag, test tool-calls en beeldinvoer opnieuw, en monitor tokengebruik en latentie.
Huidige routeringsopmerking: de officiële prijspagina identificeert deepseek-v4-pro als V4‑Pro‑0813, los van V4.1 Flash.
Hoe vergelijken de specificaties van DeepSeek V4.1 Flash en V4 Pro?
De architectuur is veranderd van een zeer groot sparse MoE-ontwerp in V4 Pro naar een asymmetrisch causaal encoder–decoder-ontwerp in V4.1 Flash. Het nieuwere model activeert minder parameters voor inputverwerking dan voor outputgeneratie, wat helpt de prefill-kosten te verlagen terwijl de generatiecapaciteit sterk blijft.
| Specificatie | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Architectuur | Causaal encoder–decoder MoE | Sparse MoE |
| Totaal aantal parameters Backbone-parameters / aantal gewichten in repository | 552B backbone-parameters; Hugging Face vermeldt 763B modelgrootte | 1.6T backbone parameters; Hugging Face lists about 1.7T model size |
| Actieve parameters | 8B voor input; 16B voor output | 49B per token |
| Contextvenster | 1M tokens | 1M tokens |
| Maximale output | 384K tokens | 384K tokens |
| Thinking- en non-thinking-modi | Ondersteund | Ondersteund |
| Native beeldbegrip | Ondersteund | Niet ondersteund |
| Gedocumenteerde gelijktijdigheid | 2,500 | 500 in de huidige configuratie |
| Huidige officiële API-status | Actief als deepseek-flash | Actief als deepseek-v4-pro (V4‑Pro‑0813) |
Toelichting op parameteraantal: De modelkaart van DeepSeek’s V4.1 Flash beschrijft 552B backbone-parameters, terwijl de Hugging Face-repository een modelgrootte van 763B meldt. Deze cijfers beschrijven verschillende rekenmethodes en moeten niet als onderling uitwisselbare totalen worden gepresenteerd.
Toelichting op outputlengte: de V4.1 Flash-modelkaart raadt max_tokens ≥ 256K aan voor lokale inferentie, terwijl DeepSeek’s huidige API-prijspagina expliciet een maximumoutput van 384K voor beide API-modellen vermeldt. Een aanbevolen inferentie-instelling is niet hetzelfde als een door de API afgedwongen maximum.
Waarop verbetert DeepSeek V4.1 Flash ten opzichte van V4 Pro?
De officiële benchmarktabel van DeepSeek laat de duidelijkste verbeteringen zien bij workloads met veel uitvoering. De procentkolom hieronder is berekend op basis van de gepubliceerde scores; procentuele vergelijkingen zijn weggelaten wanneer de metriek een rating is of wanneer een eenvoudige procentuele vergelijking misleidend zou zijn.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Verschil | Interpretatie |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 punten; +3.1% | Betrouwbaardere terminaluitvoering |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 punten; +154.2% | Grote winst op moeilijkere terminaltaken |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 punten; +151.6% | Grote winst op nieuwere terminaltaken |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 punten; +18.3% | Sterker softwarewerk op repository-niveau |
| ProgramBench | 20.3 | 15.5 | +4.8 punten; +31.0% | Verbeterde programmasynthese |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 punten; +4.1% | Beter natuurlijketaal-naar-repository-werk |
| CyberGym | 88.1 | 83.3 | +4.8 punten; +5.8% | Sterkere uitvoering van cybertaken |
| HLE with tools | 63.9 | 60.0 | +3.9 punten; +6.5% | Betere tool-ondersteunde redenering |
| Automation-Bench | 54.8 | 43.2 | +11.6 punten; +26.9% | Materiële automatiseringswinst |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 punten; +23.7% | Sterker algemeen agentgedrag |
| Codeforces rating | 3,471 | 3,348 | +123 ratingpunten | Verbeterd competitief programmeren |
| GPQA Diamond | 90.9 | 92.4 | −1.5 punten | V4 Pro behoudt een voorsprong |
| HLE without tools | 36.8; 39.1 on text subset | 42.7 on text subset | −3.6 punten op vergelijkbare tekstsubset | V4 Pro behoudt een voorsprong |
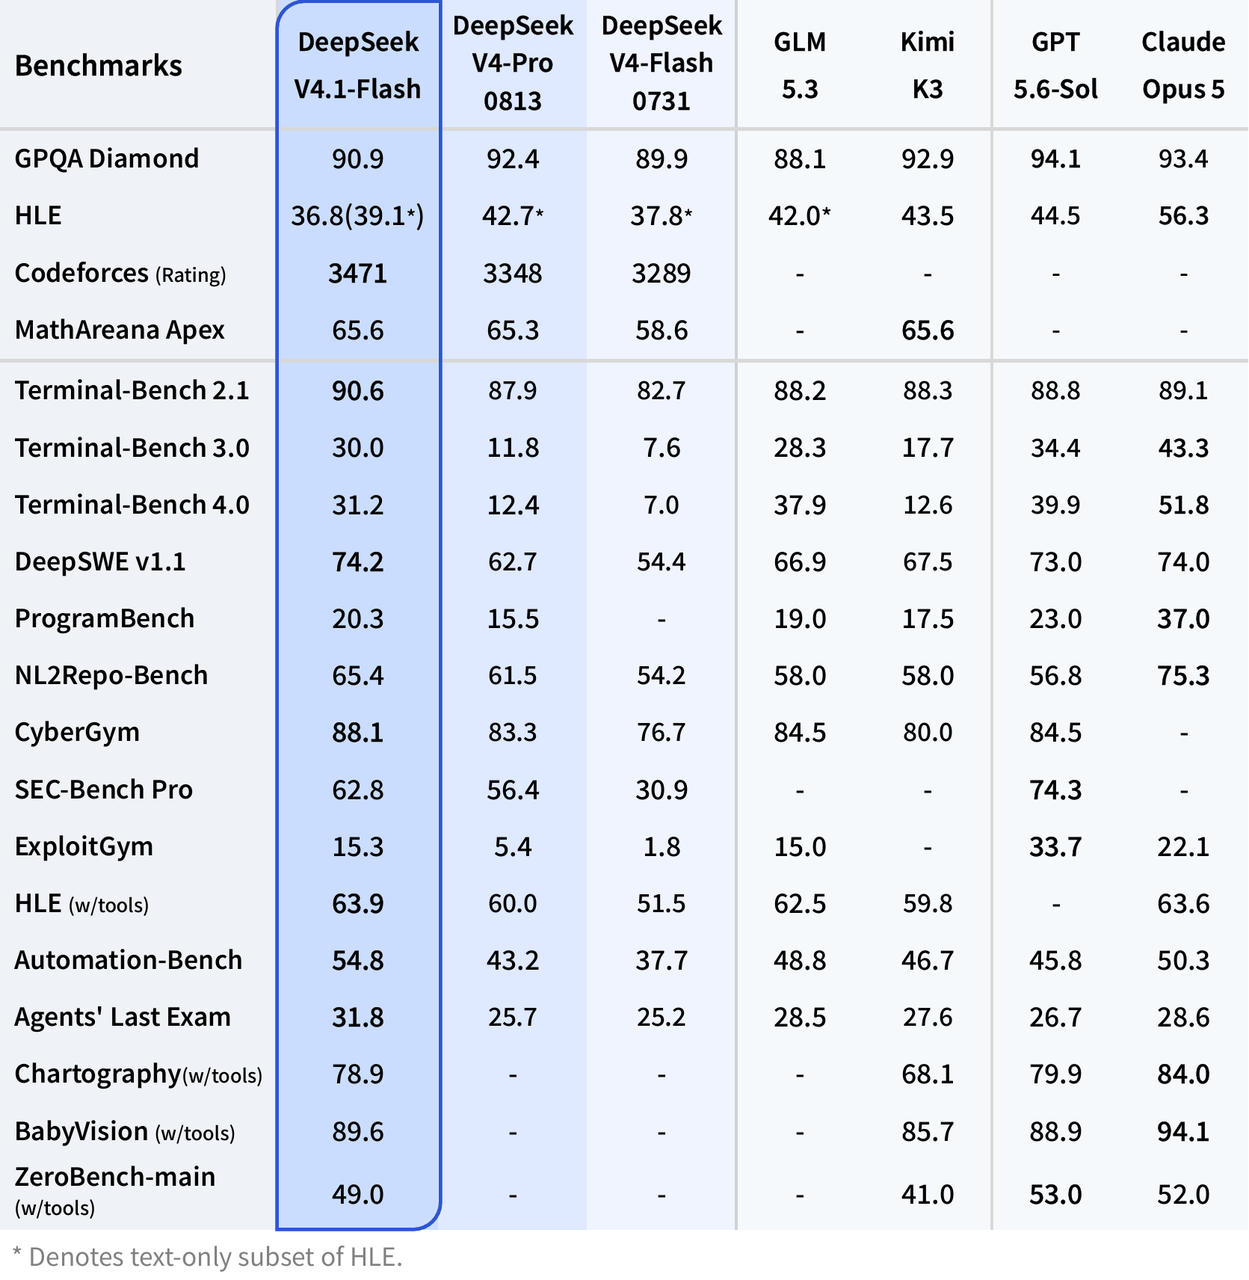
Het resultaat is multidimensionaal: V4.1 Flash is uitgesproken beter voor codeeragents, terminalbediening, automatisering, securitytaken, toolgebruik, vision, gelijktijdigheid en kosten. Het resterende voordeel van V4 Pro is geconcentreerd in geselecteerde pure-reasoningtests. Workloads moeten daarom worden beoordeeld op taakmix in plaats van op één enkele overkoepelende claim.
Waarom is DeepSeek V4.1 Flash efficiënter dan V4 Pro?
Asymmetrische rekenlast voor input en output
V4.1 Flash activeert 8B parameters tijdens het verwerken van input en 16B tijdens het genereren van output. Dit asymmetrische ontwerp richt zich op de verschillende rekenbehoeften van prefill en decodering, waardoor de kosten dalen zonder beide fasen door hetzelfde budget aan actieve parameters te dwingen.
Kleinere KV-cache-footprint
Volgens DeepSeek gebruikt V4.1 Flash een kwart van de HBM en een achtste van de SSD-capaciteit die de KV-cache van de voorgaande generatie vereiste. De gepubliceerde grafiek plaatst de globale KV-cache op 890 bytes per token, vergeleken met 3,514 bytes voor V4 Flash.
Native multimodale input en hogere gelijktijdigheid
V4.1 Flash kan afbeeldingen native interpreteren en hanteert een gedocumenteerde gelijktijdigheidslimiet van 2,500, vijf keer het huidige V4 Pro-cijfer van 500. Die veranderingen zijn belangrijk voor screenshot-gebaseerde agents, documentextractie, visuele probleemoplossing en productiequeues met hoog volume.
Wat kost DeepSeek V4.1 Flash vergeleken met V4 Pro?
Het huidige officiële API-tariefschema prijst de twee routes afzonderlijk. Per 1M tokens kost V4.1 Flash $0.003/$0.006 voor cache-hit-input, $0.15/$0.30 voor cache-miss-input en $0.60/$1.20 voor output (off-peak/peak). V4 Pro kost respectievelijk $0.022/$0.044, $0.66/$1.32 en $1.98/$3.96. Prijzen kunnen wijzigen, dus productiebudgetten moeten naar de live prijspagina verwijzen.
Hoe migreer je van DeepSeek V4 Pro of V4 Flash naar V4.1 Flash?
Gebruik de expliciete productie-model-ID
Gebruik deepseek-flash wanneer je V4.1 Flash wilt. De oudere namen deepseek-v4-flash en deepseek-v4-flash-vision-exp verwijzen nog steeds naar V4.1 Flash, maar expliciete naamgeving maakt monitoring en toekomstige rollbacks eenvoudiger te auditen. Gebruik deepseek-v4-pro wanneer je bewust de momenteel vermelde V4‑Pro‑0813‑backend wilt.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Test gedrag opnieuw, niet alleen endpoint-compatibiliteit
- Voer representatieve prompts uit in zowel thinking- als non-thinking-modus; vergelijk taaksucces, tokenaantallen en latentie.
- Test toolschema’s, JSON-output, Responses API-gedrag, prefixaanvulling en FIM opnieuw waar gebruikt.
- Voeg beeldinvoertests toe als het product de nieuwe native visuele mogelijkheid gaat gebruiken.
- Herijk budgetten met peak- en off-peak-tarieven in plaats van aannames uit V4 Pro door te trekken.
- Houd de prompt-cache hit rate bij, omdat die op schaal de inputkosten kan domineren.
Kies de beoogde backend expliciet
De huidige deepseek-v4-pro-route selecteert V4‑Pro‑0813. Teams moeten de uiteindelijke modelversie, evaluatiedatum, promptset en prijsvenster vastleggen zodat vergelijkingen reproduceerbaar blijven als de routing opnieuw verandert.
Welke workloads passen het best bij DeepSeek V4.1 Flash?
| Workload | Aanbevolen keuze | Reden |
|---|---|---|
| Codeeragents en repository-onderhoud | V4.1 Flash | Hogere DeepSWE-, ProgramBench-, NL2Repo- en terminalscores |
| Toolgedreven automatisering | V4.1 Flash | Hogere Automation-Bench-, HLE-met-tools- en agentscores |
| Assistenten met beeldbegrip | V4.1 Flash | Native beeldbegrip |
| Serving met hoge throughput of kostengevoeligheid | V4.1 Flash | Hogere gelijktijdigheid en veel lagere tokenprijzen |
| Historische V4 Pro-reproductie / Huidige V4 Pro-toegang en evaluatie | V4 Pro | De officiële route identificeert momenteel V4‑Pro‑0813 |
| Puur gesloten-boekredeneren | Valideer op domeinspecifieke data | V4 Pro blijft hoger op GPQA Diamond en HLE zonder tools |
DeepSeek V4.1 Flash vs V4 Pro FAQ
Is DeepSeek V4.1 Flash beter dan V4 Pro?
Voor de meeste productiedimensies—codeeragents, terminaltaken, automatisering, toolgebruik, vision, throughput en prijs—ja. V4 Pro heeft nog steeds sterkere gepubliceerde scores op GPQA Diamond en HLE zonder tools, dus pure-reasoningworkloads moeten met domeinspecifieke prompts worden getest.
Kan ik deepseek-v4-pro nog steeds aanroepen?
Ja. De huidige officiële API-pagina vermeldt deepseek-v4-pro als V4‑Pro‑0813, met eigen prijzen en gelijktijdigheidslimiet.
Welke model-ID moet een nieuwe integratie gebruiken?
Gebruik deepseek-flash voor V4.1 Flash, of deepseek-v4-pro voor V4‑Pro‑0813. Behandel de twee ID’s niet als aliassen.
Werken oude V4 Flash-model-ID’s nog steeds?
DeepSeek stelt dat verzoeken naar deepseek-v4-flash en deepseek-v4-flash-vision-exp automatisch naar V4.1 Flash worden gerouteerd en tegen de nieuwe Flash-prijs worden gefactureerd. Het bijwerken van de geconfigureerde model-ID blijft aanbevolen voor duidelijkheid.
Ondersteunt DeepSeek V4.1 Flash afbeeldingen?
Ja. Native beeldbegrip maakt deel uit van V4.1 Flash; de historische V4 Pro API bood deze mogelijkheid niet.
Is DeepSeek V4.1 Flash goedkoper dan de huidige V4 Pro?
Ja. Het huidige officiële schema vermeldt lagere prijzen voor cache-hit-input, cache-miss-input en output voor V4.1 Flash dan voor V4 Pro.
Moet ik identieke outputs verwachten na migratie?
Nee. Endpoint-compatibiliteit garandeert geen identieke redeneerpaden, toolselectie, tokengebruik of opmaak. Voer productie-evaluaties opnieuw uit voordat je op eerdere drempels vertrouwt.