
TL;DR: Kies DeepSeek-V4-Flash voor snelle, low-latency tekstautomatisering; kies GLM-5.3-Flash voor multimodale mogelijkheden, superieure agent-benchmarking en zeer efficiënte long-context hosting op privéservers. Beide modellen bieden open gewichten onder de MIT License**** en zijn uitgebracht onder de permissieve MIT License.
DeepSeek-V4-Flash**** is een betere keuze als je een ultrasnelle, high-throughput tekst-only API wilt voor traditionele coderingslussen en massale batchverwerking. Het scoort 50 op de Artificial Analysis Intelligence Index, genereert tot 122+ tokens/sec met zijn geïntegreerde DSpark speculative decoding-engine en biedt off-peak API-tarieven vanaf $0.22/$0.66 per miljoen input/output tokens.
GLM-5.3-Flash is de veelzijdigere keuze wanneer native multimodaliteit, visual-in-the-loop programmeren en zeer efficiënte zelfbeheerbare schaalbaarheid vereist zijn. Het scoort 57 op de Artificial Analysis Intelligence Index, maakt gebruik van een hybride lineaire-en-sparse attention-mechanisme (KDA + NoPE Sparse MLA) om KV Cache-geheugen 4.44× te verminderen bij 1M context, en beschikt over native visuele redenering. De API is scherp geprijsd op $0.15/$0.50 per miljoen input/output tokens (promotietarieven dalen naar $0.075/$0.25).
Key Takeaways
- DeepSeek-V4-Flash ging van zijn eerste preview op de DeepSeek API News Announcement naar de officiële release op Hugging Face, met Token-wise Compression, DeepSeek Sparse Attention (DSA) en DSpark speculative decoding om de generatiesnelheid te verhogen.
- GLM-5.3-Flash werd uitgebracht op August 26, 2026, na brede populariteit tijdens de anonieme testfase op OpenRouter onder de codenaam “Ox Alpha.”
- GLM-5.3-Flash leidt op de algemene Artificial Analysis Intelligence Index met 57 punten vergeleken met 50 punten voor DeepSeek-V4-Flash-0731, wat een sterkere algehele capaciteit voor complexe redenering en agent-taken weerspiegelt.
- Beide architecturen zijn Mixture-of-Experts (MoE) modellen met zeer slanke compute-footprints tijdens inferentie: DeepSeek activeert 13B van 284B totale parameters per token, terwijl GLM 18B van 320B activeert.
- Beide modellen hebben volledig open gewichten en worden gedistribueerd onder de MIT License, wat maximale vrijheid biedt voor enterprise-commercialisatie, aangepaste fine-tuning en on-premise deployment.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Quick Comparison
| Specification | DeepSeek-V4-Flash-0731 | GLM-5.3-Flash |
|---|---|---|
| Developer | DeepSeek-ai | Z.ai (Zhipu AI) |
| Release date | July 31, 2026 | August 26, 2026 |
| Model ID | deepseek-v4-flash | glm-5.3-flash |
| Hugging Face Repository | deepseek-ai/DeepSeek-V4-Flash | zai-org/GLM-5.3-Flash |
| Architecture | MoE; DSA + Token-wise Compression | MoE; KDA + NoPE Sparse MLA + mHC |
| Total parameters | 284B (304B with DSpark module) | 320B |
| Active parameters | 13B per token | 18B per token |
| Context window | 1,000,000 tokens | 1,048,576 / about 1M tokens |
| Input / output | Tekst → Tekst | Tekst + Afbeelding + Video + Bestand → Tekst |
| Reasoning | Configureerbaar (Thinking / Non-Thinking) | Drie niveaus (Low / High / Max) |
| Function / tool use | JSON Schema / Tool Calls | ToolCalls, constraints, dynamic tool loading |
| Open weights | Yes (MIT License) | Yes (MIT License) |
| AA Intelligence Index | 50 | 57 |
| Official Price (1M Tokens) | Piek: $0.44 / $1.32 <br> Daluren: $0.22 / $0.66 | Standaard: $0.15 / $0.50 <br> Promo: $0.075 / $0.25 |
| Best fit | Agenten met hoge doorvoer, snelle tekstgeneratie | Visuele programmering, aangepaste on-prem deployments |
What Is DeepSeek-V4-Flash?
DeepSeek-V4-Flash is een lichtgewicht, hyper-snel MoE-model, ontworpen om autonome developer-agents en massieve tekstverwerkingspijplijnen te ondersteunen. Oorspronkelijk gepreviewd op de DeepSeek API News Announcement, kreeg het model een grote post-training upgrade in de officiële release als DeepSeek-V4-Flash-0731 op Hugging Face.
Het model is geoptimaliseerd voor pure tekstdoorvoer, gestructureerde API-calls en snelle uitvoering van programmacode. Het minimaliseert zowel latency als token-voor-token inferentiekosten en richt zich op multi-turn softwareontwikkelingslussen waar snelheid en uitvoeringskosten cruciaal zijn.
What Changed From the Preview?
De officiële 0731-versie bevat een optioneel co-getraind speculative drafting-model dat het totale lokale parameteraantal naar 304B brengt. Bij hosting werkt dit speculative decoding-framework (DSpark) naast het actieve 13B-pad om generatiesnelheden te versnellen tot 122.7 tokens per seconde.
Daarnaast is het alignment-proces uitgebreid hergetraind met reinforcement learning (RL) in gesandboxte uitvoeringsomgevingen, wat veel hogere betrouwbaarheid oplevert bij multi-step terminalwerk, shell-scripting en gestructureerd toolgebruik.
DeepSeek-V4-Flash Specifications
| Property | DeepSeek-V4-Flash-0731 |
|---|---|
| Context | 1,000,000 tokens |
| Modalities | Tekstinvoer; tekstuitvoer (standaardmodel) |
| Reasoning | Ondersteunt Non-thinking en Thinking-modi |
| Native API capabilities | JSON Output, Tool Calls, Responses API |
| Knowledge cutoff | Undisclosed |
| Standard Pricing (per MTok) | Piek: $0.44 Input / $0.014 Cached / $1.32 Output <br> Daluren: $0.22 Input / $0.007 Cached / $0.66 Output |
What Is GLM-5.3-Flash?
GLM-5.3-Flash is Z.ai’s vlaggenschip open-weights multimodaal MoE-model. Officieel geïntroduceerd op de Z.ai Blog op August 26, 2026, is het model ontworpen voor zeer complexe agent-executie, geautomatiseerde webnavigatie en visuele documentredenering tegen standaard “Flash”-kosten. De gewichten zijn publiek toegankelijk op Hugging Face.
Het model is voorgetraind op een massieve multimodale dataset van 30 biljoen tokens, waardoor visuele input een native modaliteit is in plaats van een toevoeging achteraf. Het richt zich op software-engineering, robotic process automation en multimodale databasequery’s.
Hybrid Attention, mHC and Sparse MoE Scaling
GLM-5.3-Flash onderscheidt zich door drie architectuurpijlers:
- Hybrid Attention: Zoals beschreven op de Z.ai Blog combineert het model Kimi Delta Attention (KDA) met NoPE Sparse MLA (Multi-head Latent Attention zonder Positional Encoding). Deze hybride attention-laag comprimeert de projectiegroottes van keys en values, waardoor KV Cache-opslag 4.44× wordt verminderd en attention-berekeningen 3.01× afnemen tijdens evaluaties met 1M context.
- Stable LatentMoE: Met 896 experts in totaal en precies 16 geactiveerd per token, voorkomt het model instorting van expert-routering en blijft het stabiel tijdens lange, multi-step inferentietrajecten.
- Manifold-Constrained Hyper-Connections (mHC): Deze techniek stabiliseert diepe gradiënten over de 45-laags structuur, en optimaliseert hardwareprestaties op gedistribueerde GPU-clusters of lokale AI-chips.
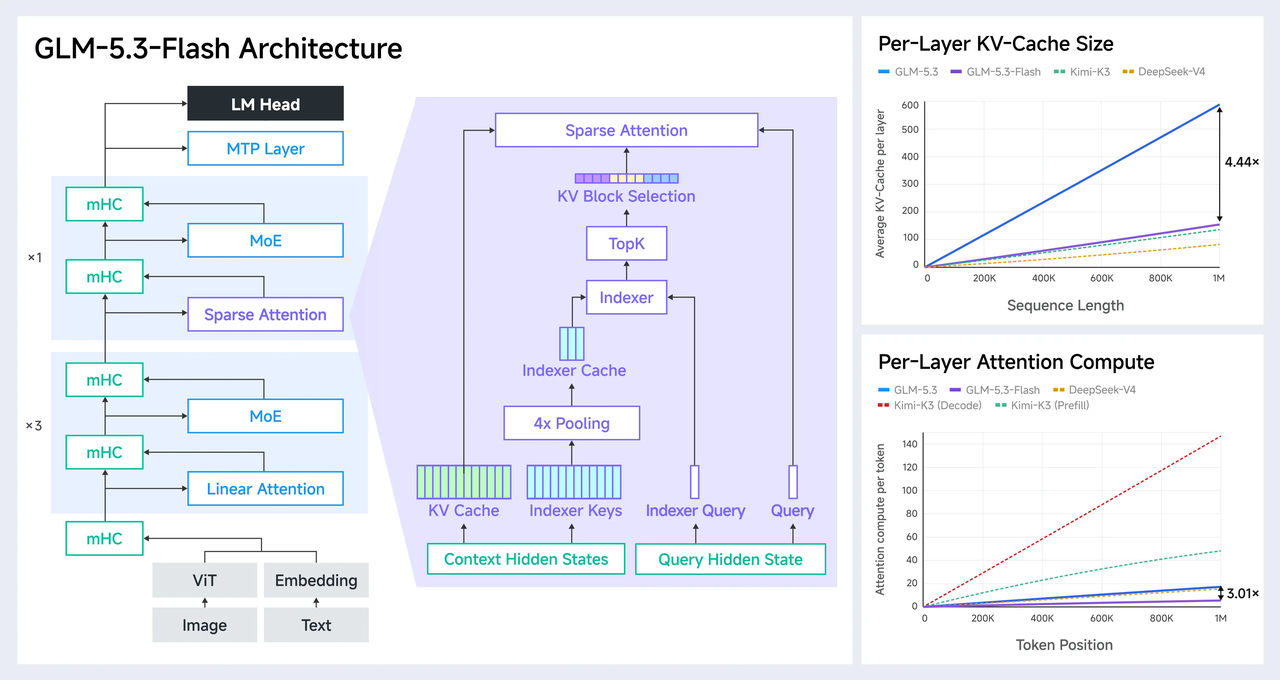
GLM-5.3-Flash: Architectuur voor extreme efficiëntie Bron: z.ai
GLM-5.3-Flash Specifications
| Property | GLM-5.3-Flash |
|---|---|
| Total / active parameters | 320B / 18B |
| Architecture | MoE met hybride sparse & lineaire attention |
| Experts | 896 totaal; 16 geactiveerd per token |
| Context | 1,048,576 tokens (~1M) |
| Vision | Native multimodaal (Tekst, Afbeelding, Video, Doc-bestand) |
| Reasoning | Ondersteunt Low-, High- en Max-thinking modi |
| Tools | ToolCalls, constraints, dynamic tool loading |
| Open weights | Beschikbaar op Hugging Face (MIT License) |
| Official Pricing (per MTok) | Standaard: $0.15 Input / $0.03 Cached / $0.50 Output <br> Promo (eindigt 9 sep): $0.075 Input / $0.015 Cached / $0.25 Output |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Feature Comparison
Architecture and Parameter Efficiency
DeepSeek-V4-Flash werkt met een architectuur van 284B totale parameters (13B actief) en een co-getraind speculative drafting-model (waardoor lokale deployments 304B worden). GLM-5.3-Flash gebruikt 320B totale parameters (18B actief) in een sterk sparse 45-laags lay-out. Beide modellen activeren zeer weinig parameters per token, waardoor ze presteren met de snelheid van veel kleinere modellen, terwijl ze toch de rijke kennisrepresentatie van een massief model behouden.
Attention Mechanism and Memory Optimization
DeepSeek-V4-Flash gebruikt DeepSeek Sparse Attention (DSA) en Token-wise Compression. Het analyseert sequenties dynamisch en comprimeert redundante tokens (bijv. boilerplate-codestructuren of repetitieve systeemheaders) tijdens verwerking van lange prompts.
GLM-5.3-Flash combineert lineaire KDA met latente projectie (NoPE Sparse MLA). Dit verwijdert expliciete positional encodings uit het key/value-compressieblok, waardoor de fysieke KV-cache footprint wordt teruggebracht tot slechts 22.5% van traditionele lay-outs. Hierdoor kunnen geheugenbeperkte clusters aanzienlijk hogere gelijktijdigheid ondersteunen voor long-context workloads.
Modality and Multimodal Depth
DeepSeek-V4-Flash-0731 is een tekst-only model. Het blinkt uit in het parsen van technische bestanden, JSON-schema’s en structurele markdown. Voor visuele parsing-taken moeten ontwikkelaars een apart multimodaal experimenteel model gebruiken (deepseek-v4-flash-vision-exp).
GLM-5.3-Flash is native multimodaal. Het accepteert high-res afbeeldingen, video’s en complexe Office-documentbestanden (PDF’s, PPTX’en, spreadsheets) direct. Deze native multimodaliteit ondersteunt “visual-in-the-loop” softwareontwikkeling, waarbij het model een gerenderde UI-layout kan inspecteren, uitlijningsproblemen kan spotten en zijn eigen code iteratief kan corrigeren zonder handmatige tussenkomst.
Licensing and Openness
Beide modellen zijn uitgebracht onder de zeer permissieve MIT License. Dit geeft enterprise-ontwikkelaars volledige vrijheid om de modelgewichten lokaal te wijzigen, te distribueren, in sublicentie te geven en commercieel te deployen, binnen een private VPC of in air-gapped on-premise cloudinfrastructuren.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Benchmark Comparison
Bij evaluatie op dezelfde datasets onder identieke testharnassen presteren beide modellen competitief op software-engineering en agentautomatisering.
Coding & Agentic Performance
| Benchmark | GLM-5.3-Flash (Z.ai) | DeepSeek-V4-Flash-0731 |
|---|---|---|
| Artificial Analysis Index v4.1.1 | 57 | 50 |
| Terminal Bench 2.1 (Acc) | 84.3 | 82.7 |
| DeepSWE v1.1 (GitHub Issues) | 63.4 | 54.4 |
| Toolathlon (Verified / Pass@1) | 78.4 | 70.3 |
| NL2Repo (Acc) | 56.3 | 54.2 |
| Automation Bench (Acc) | 48.8 | 25.1 |
| GDPval-AA v2 (Agent Elo) | 1773 | 1554 |
GLM-5.3-Flash behoudt een voorsprong op de meeste agent- en software-engineeringbenchmarks, met 63.4% op DeepSWE v1.1 en 84.3 op Terminal Bench 2.1. De 18B actieve parameterroute en multi-turn post-training alignment helpen bij het afhandelen van complexe repository-tracking en OS-interacties.
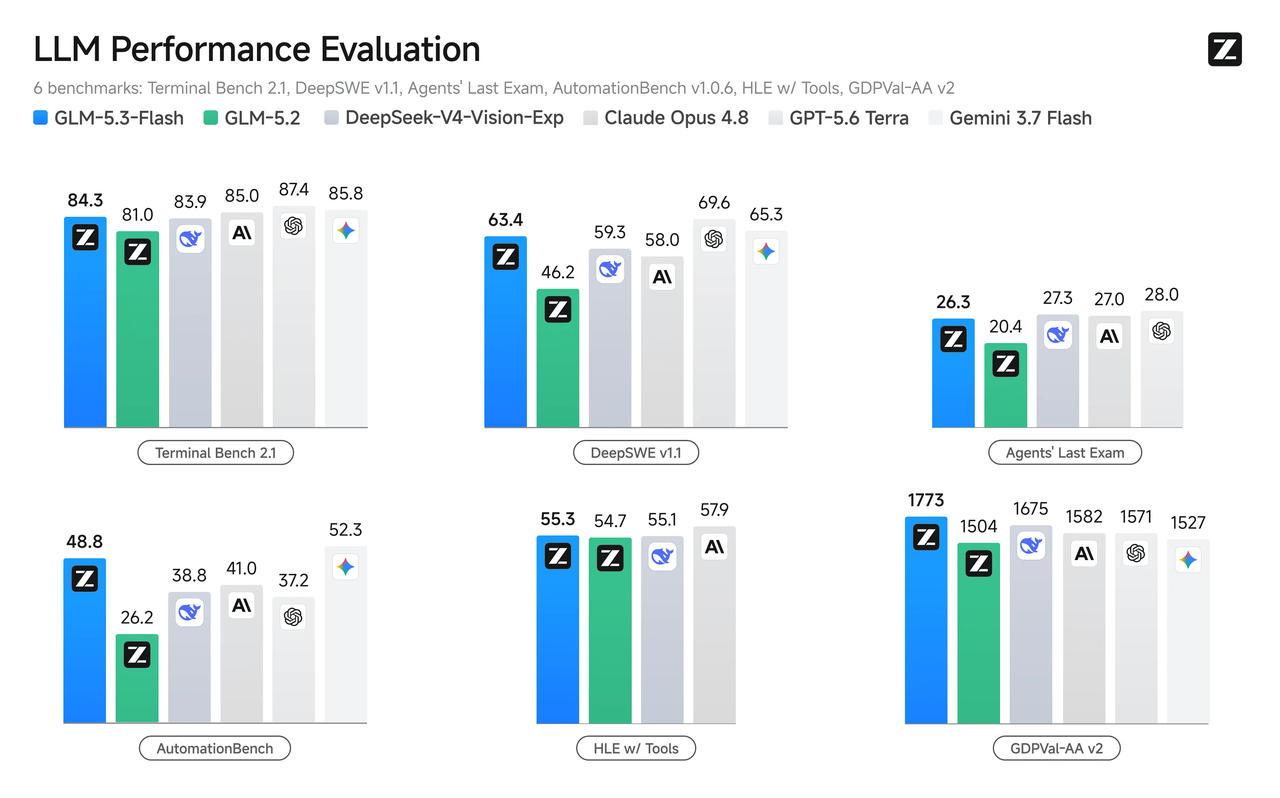
GLM-5.3-Flash Benchmark: score 84.3 op Terminal Bench 2.1 Bron: z.ai
DeepSeek-V4-Flash-0731 is ook zeer capabel, met 82.7 op Terminal Bench 2.1 en 70.3 op Toolathlon. Het levert betrouwbare prestaties op deterministische API-structuren en strikt function-calling.
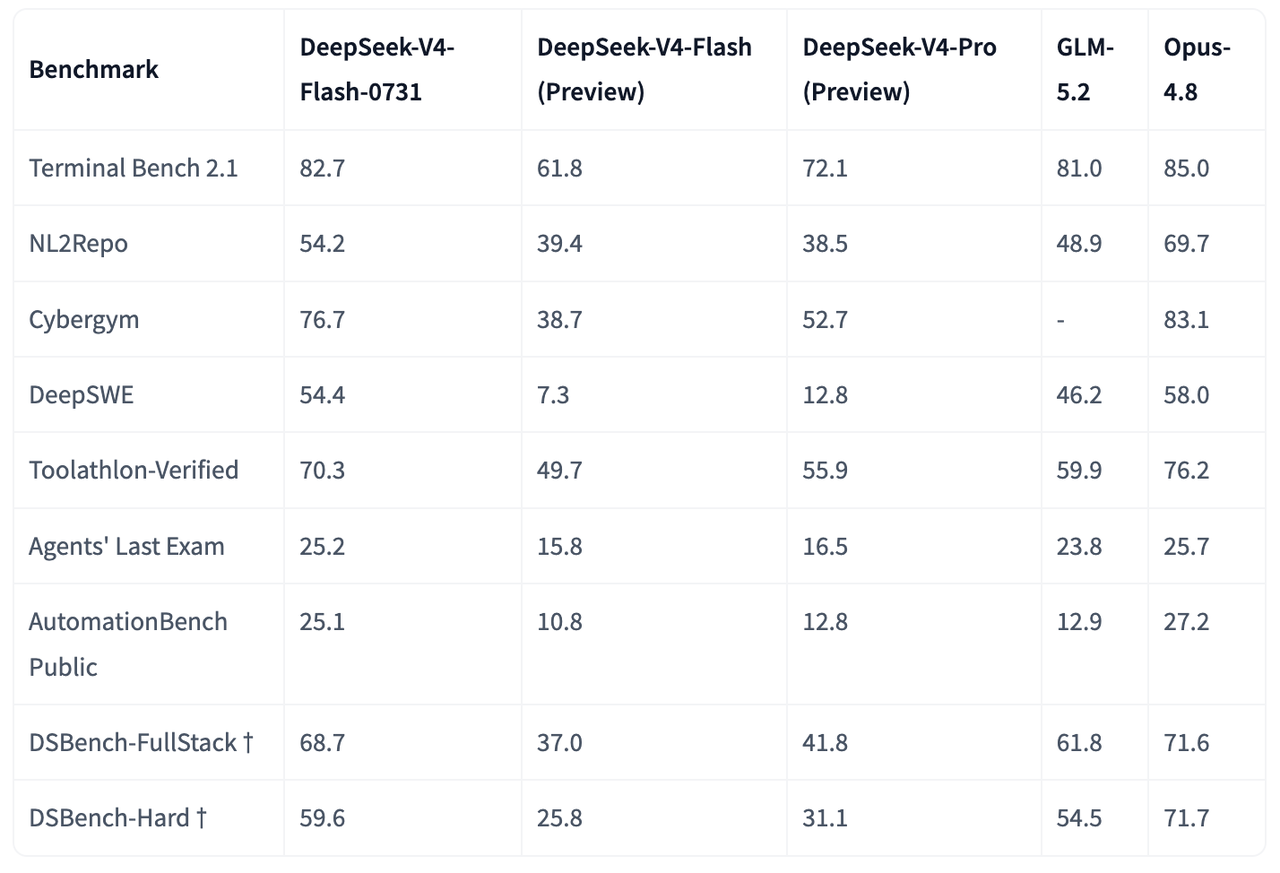
DeepSeek-V4-Flash Benchmark 0731: score 82.7 op Terminal Bench 2.1 Bron: Hugging Face
Multimodal and Visual Reasoning
De native multimodale training van GLM-5.3-Flash geeft een duidelijk voordeel bij visuele redeneringstaken:
- OfficeQA Pro: 62.4 (GLM-5.3-Flash) vs 57.9 (DeepSeek-V4-Vision experimentele branch). GLM toont superieur native parsen van ingesloten afbeeldingen, gestructureerde PDF-tabellen en slide decks.
- Chartography with Tools: 78.0 (GLM-5.3-Flash). Het model laat uitstekende capaciteit zien om systeemschema’s, wireframe-diagrammen en factuurscans in te lezen en deze direct te vertalen naar uitvoerbare systeemlogica.
Speed and Latency
- Generation Speed: DeepSeek-V4-Flash-0731 is sneller, met een gemiddelde uitvoersnelheid van 122.7 tokens/sec op standaard enterprise-cloudendpoints, ondersteund door het speculative decoding-framework.
- Time to First Token (TTFT): GLM-5.3-Flash heeft een lagere TTFT van 1.21 seconden, vergeleken met meer dan 3.0 seconden voor DeepSeek-V4-Flash, waardoor het responsiever aanvoelt in realtime chat-applicaties voor eindgebruikers.
DeepSeek-V4-Flash vs GLM-5.3-Flash: API Pricing
Beide modellen bieden zeer kosteneffectieve prijsmodellen en zijn daardoor zeer competitief ten opzichte van traditionele dense architecturen.
Official API List Prices (per 1 Million Tokens)
| Price Layer | DeepSeek-V4-Flash-0731 (Piek) | DeepSeek-V4-Flash-0731 (Daluren) | GLM-5.3-Flash (Standaard) | GLM-5.3-Flash (Promo - tot 9 sep) |
|---|---|---|---|---|
| Input Price (Cache Miss) | $0.44 | $0.22 | $0.15 | $0.075 |
| Input Price (Cache Hit) | $0.014 | $0.007 | $0.03 | $0.015 |
| Output Price | $1.32 | $0.66 | $0.50 | $0.25 |
Tijdens daluren is DeepSeek-V4-Flash-0731 zeer economisch, met inputkosten van $0.22/MTok en output van $0.66/MTok, en een cached input-kost van $0.007/MTok.
GLM-5.3-Flash biedt concurrerende standaard vlakke tarieven ($0.15 input / $0.50 output) zonder piektoeslagen. Het promotietarief (beschikbaar t/m 9 september 2026) verlaagt de input- en outputkosten naar respectievelijk $0.075 en $0.25, wat het een uitstekende optie maakt voor grootschalige migraties en bulkverwerking.
Strengths and Weaknesses
DeepSeek-V4-Flash-0731
- Strengths:
- Uitzonderlijke generatiesnelheid: Genereert tot 122.7 tokens per seconde met het co-getrainde speculative drafting-model (DSpark).
- Daluren-economie: Biedt een uitzonderlijk goedkope dalureninstapprijs van $0.22 input en $0.66 output per miljoen tokens.
- Sterke CPU-quantization-ondersteuning: Beschikt over een volwassen GGUF-integratiepad, wat het sterk optimaliseert voor CPU-gebaseerde lokale runtimes en persoonlijke systeemsgeheugenbeperkingen.
- Trade-offs:
- Piekuur-tariefvolatiliteit: API-prijzen verdubbelen tijdens piekuren (0.44/1.32 per MTok).
- Text-only kerngewichten: Standaardgewichten ondersteunen geen native visuele redenering, afbeeldingen of video.
- TTFT-overhead: Toont een langere gemeten Time to First Token (TTFT) dan GLM.
GLM-5.3-Flash
- Strengths:
- Top-tier intelligence: Behaalt een zeer competitieve 57 punten op de Artificial Analysis Index.
- Native Vision-in-the-Loop: Integreert beeld- en videohandling direct in de post-training alignment, wat visuele evaluatie van front-end webcode mogelijk maakt.
- Uitzonderlijke cache-reductie: Hybride lineaire KDA en NoPE MLA-lagen verminderen geheugenverbruik 4.44× en ontgrendelen hogere lokale gelijktijdigheid.
- Vlakke long-context tarieven: Standaardtarieven blijven vlak tot 1M tokens met een industrie-lage cache-hit rate ($0.03 standaard, $0.015 promo).
- Trade-offs:
- Langzamere token-output: Rauwe generatiesnelheden zijn lager dan DeepSeeks toegewijde speculative decoding-engine.
- Hardwarevereisten: Hosting van de volledige 320B parameter-MoE-structuur lokaal vereist een multi-node GPU-omgeving ondanks de hoge sparsity.
| Model | Strengths | Trade-offs |
|---|---|---|
| DeepSeek-V4-Flash | Snelle generatie (122.7 tok/s in Artificial Analysis”); zeer goedkope dalurentarieven; volwassen tekst-quantization-ecosysteem; sterk geoptimaliseerd voor CPU-gebaseerde lokale GGUF. | Piekuur-tariefvariatie; text-only basismodel (geen native vision); langzamere TTFT. |
| GLM-5.3-Flash | 57 punten op AA Intelligence; native multimodaal parsen; 4.44× KV-cachecompressie; vlakke prijzen; snelle TTFT (1.21s); MIT license. | Iets langzamere ruwe tokengeneratiesnelheid dan DeepSeek; lokale multi-node deployments zijn hardware-intensief. |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Which Should You Choose?
| Use case | Recommended | Why |
|---|---|---|
| Default frontier API | GLM-5.3-Flash | Scoort hoger op de intelligence index (57) en domineert multi-step agent-benchmarks. |
| Long-running text agent | DeepSeek-V4-Flash | Razendsnelle generatiesnelheid (122+ tok/s) maakt het zeer efficiënt voor massale tekst-/codegeneratie. |
| Visual coding / UI workflows | GLM-5.3-Flash | Native multimodale ontwerp ondersteunt visual-in-the-loop debugging en UI-renderinganalyse. |
| Private/self-managed VPC | GLM-5.3-Flash | MIT-licentie met KDA + NoPE MLA-compressie, die hardware-VRAM 4.44× vermindert. |
| Local CPU-only run | DeepSeek-V4-Flash | Sterkere lokale GGUF-quant-ondersteuning (92GB Unified Memory voor extreme 1-bit of 3-bit runs). |
| Lower peak output cost | GLM-5.3-Flash | Standaard output van $0.50/MTok blijft vlak en is goedkoper dan DeepSeek’s $1.32 piek-outputtarief. |
| Heavy Prompt Caching | DeepSeek-V4-Flash | Daluren cache-hits kosten uitzonderlijk laag $0.007 per miljoen tokens. |
Why Use Cometapi to Access DeepSeek-V4-Flash and GLM-5.3-Flash
Beide modellen zijn volledig geïntegreerd in CometAPI. Ontwikkelaars kunnen toegang krijgen tot DeepSeek-V4-Flash, en ondersteuning voor Chat Completions / Responses-stijl toegang en de GLM-5.3-Flash model page biedt GLM-5.3-Flash via het uniforme CometAPI-endpoint. Dat maakt A/B-testen makkelijker, omdat je model-ID’s kunt wisselen terwijl authenticatie en de meeste applicatieplumbing gelijk blijven.
Conclusion
De introductie van DeepSeek-V4-Flash-0731 en GLM-5.3-Flash heeft de economie van long-context, sparse MoE-modeldeployments getransformeerd. Beide architecturen leveren hoge intelligentie tegen extreem lage prijsniveaus.
DeepSeek-V4-Flash-0731 is een sterk geoptimaliseerde tekst- en code-engine die excelleert in ruwe generatiedoorvoer, speculative decoding en lokale CPU-gebaseerde quantization. GLM-5.3-Flash vertegenwoordigt een grote stap vooruit voor multimodale en agentgebaseerde workflows, met low-latency visuele redenering en een hybride attention-mechanisme dat on-premise hosting zeer efficiënt maakt.
FAQs
What was GLM-5.3-Flash's anonymous test name?
Voor de officiële lancering werd GLM-5.3-Flash anoniem getest op OpenRouter en OpenCode onder de codenaam “Ox Alpha,” waar het snel populair werd bij ontwikkelaars.
Can I run these models locally on a standard personal computer?
Ja, beide modellen hebben open gewichten en zijn beschikbaar op Hugging Face. Door hun parametergrootte vereist lokale hosting echter aanzienlijk geünificeerd geheugen:
- DeepSeek-V4-Flash-0731: Extreme 1-bit quantization vereist ~92GB RAM; een 3-bit run wordt sterk aanbevolen en vereist tussen 110–135GB RAM.
- GLM-5.3-Flash: Extreme 1-bit quantization vereist ~100GB RAM, terwijl 3-bit runs het beste presteren met 128GB–150GB geünificeerd systeemgeheugen.
Does DeepSeek-V4-Flash support visual or video processing?
Nee, de standaard DeepSeek-V4-Flash-0731 is een tekst-only model. Voor visuele taken moet je hun aparte multimodale experimentele model gebruiken (deepseek-v4-flash-vision-exp).
How does "visual-in-the-loop" programming work on GLM-5.3-Flash?
Omdat het model native visuele en beeldbegrip heeft, kan het frontendcode schrijven, de gerenderde visuele output beoordelen, layout- of stylingfouten signaleren en de code herschrijven om die bugs te verhelpen zonder dat een mens de layoutproblemen in tekst hoeft te beschrijven.
How does Prompt Caching save money with these models?
Als je dezelfde grote context (zoals een codebase of documentencollectie) in meerdere API-calls verstuurt, kunnen beide modellen deze prompt cachen. Bij volgende calls rekenen ze alleen het “cache-hit” tarief, dat daalt tot $0.007/MTok voor DeepSeek-V4-Flash (daluren) en $0.015/MTok voor GLM-5.3-Flash (promo), waardoor API-kosten aanzienlijk worden verlaagd.