
TL;DR
GLM-5.3 Flash is de betere standaardkeuze voor de meeste productie-workloads: het voegt native visuele input en een contextvenster van 1M tokens toe, terwijl de standaardlijstprijs drastisch lager is. GLM-5.3 blijft de sterkere keuze wanneer maximale codeerdiepte, moeilijke redenering over lange horizon of cybersecurity-prestaties belangrijker zijn dan stukprijs.
Dit is geen verhaal klein-model-versus-groot-model. Flash is een 320B totaal/18B actief MoE, getraind vanaf een nieuwe multimodale basis met hybride sparse- en lineaire attention. Het vlaggenschip is een 744B totaal/40B actief MoE waarvan GLM-5.3-winst komt uit opgeschaalde post-training op de GLM-5.2-basis.
Belangrijkste punten
- Kies Flash voor multimodaal coderen, documentbegrip, browser- of GUI-agents, grootschalige automatisering en kostengevoelige toepassingen.
- Kies het vlaggenschip voor de moeilijkste repository-schaal engineeringtaken, diepere tool-ondersteunde redenering en defensieve securityonderzoek.
- Beide modellen ondersteunen 1M-token context, altijd ingeschakelde redenering, function calling, streaming en deployment met open gewichten.
- Op gematchte door Z.ai gerapporteerde benchmarks leidt het vlaggenschip DeepSWE, NL2Repo, HLE with tools en Agents’ Last Exam; Flash leidt AutomationBench, Toolathlon en GDPval-AA v2.
- Onafhankelijke tests geven het vlaggenschip een hogere Intelligence Index en snellere output, terwijl Flash iets betere time-to-first-token heeft en een veel lagere gemengde kost.
GLM-5.3 Flash vs GLM-5.3 in één oogopslag
| Dimensie | GLM-5.3 Flash | GLM-5.3 | Praktisch resultaat |
|---|---|---|---|
| Positionering | Efficiënt native-multimodaal codeer- en agentmodel | Vlaggenschip voor tekstredenering, coderen, lang-horizon agents, cybersecurity | Afhankelijk van workload |
| Modelgrootte | 320B totaal / 18B actief | 744B totaal / 40B actief | Flash activeert 55% minder parameters |
| Basismodel | Nieuw getrainde 30T-token multimodale basis | Zelfde basis als GLM-5.2; winst uit post-training | Verschillende ontwikkelpaden |
| Input / output | Tekst + visuele input / tekstoutput | Tekstinput / tekstoutput | Flash voor visuele workflows |
| Context / maximale output | 1M / 128K | 1M / 128K | Gelijk |
| Redeneringsinspanning | laag, hoog, maximaal; redenering altijd ingeschakeld | laag, hoog, maximaal; redenering altijd ingeschakeld | Gelijk |
| Onafhankelijke Intelligence Index | 57 | 60 bij maximale inspanning | GLM-5.3 |
| Onafhankelijke uitvoersnelheid | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 in geteste API |
| Officiële lijstprijs input/output | $0.15 / $0.50 per 1M tokens | $1.40 / $4.40 per 1M tokens | Flash |
| Beste toepassing | Standaardroutering, multimodale agents, schaal | Complexe tekst- en securitytaken met hoogste inzet | Gebruik selectieve routering |
Bronnen: Z.ai modeldocumentatie en Artificial Analysis-vergelijking.
Wat is GLM-5.3 Flash?
Z.ai positioneert Flash als het eerste native multimodale model in de GLM-5-serie. Het heeft 320B totale parameters en 18B actieve parameters, maar “Flash” moet niet gelezen worden als “klein”. De volledige checkpoint blijft een zeer groot model; de efficiëntie komt van het activeren van een kleinere expert-subset en het herontwerpen van de attention-stack.
Het basismodel is getraind op een multimodaal corpus van 30 biljoen tokens. Native visie is geïntegreerd in de codeerloop, waardoor het model screenshots, gerenderde interfaces, grafieken, paginalay-outs en andere visuele feedback kan inspecteren voordat het de volgende actie verfijnt.
GLM-5.3 Flash-specificaties
| Specificatie | GLM-5.3 Flash |
|---|---|
| Ontwikkelaar | Z.ai / Zhipu AI |
| Model-ID | glm-5.3-flash |
| Modeltype | Native multimodale Mixture-of-Experts |
| Totale / actieve parameters | 320B / 18B |
| Lagen | 45 |
| Architectuur | Hybride sparse attention + lineaire attention; mHC; MTP |
| Trainingscorpus | 30T-token multimodaal pre-trainingscorpus |
| Inputmodaliteiten | Tekst en visuele input, inclusief afbeeldingen en ondersteunde video-/bestandsworkflows |
| Outputmodaliteit | Tekst |
| Context / maximale output | 1M / 128K tokens |
| Redenering | Altijd ingeschakeld; lage, hoge, maximale inspanning |
| Tools | Function calling, streaming toolaanroepen, gestructureerde workflows |
| Gewichten / licentie | Open gewichten; Apache-2.0 in de officiële repository |
Bronnen: Z.ai Flash-documentatie en de officiële GLM-5-repository.
Wat is GLM-5.3?
Het vlaggenschipmodel is geoptimaliseerd voor complexe software-engineering, lang-horizon agents en cybersecurity. Z.ai zegt dat het hetzelfde basismodel gebruikt als GLM-5.2; de upgrade komt van opgeschaalde post-training en niet van een nieuwe pre-trainingsrun.
De officiële repository vermeldt de checkpoint op 744B totale parameters met 40B actief. Vergeleken met Flash activeert het meer dan tweemaal zoveel parameters per token en biedt het meer capaciteit voor moeilijke meerstapsredenering.
GLM-5.3-specificaties
| Specificatie | GLM-5.3 |
|---|---|
| Ontwikkelaar | Z.ai / Zhipu AI |
| Model-ID | glm-5.3 |
| Modeltype | Vlaggenschiptekst Mixture-of-Experts-model |
| Totale / actieve parameters | 744B / 40B |
| Basismodel | GLM-5.2-basis; alle GLM-5.3-verbeteringen uit post-training |
| Input / output | Tekst / tekst |
| Context / maximale output | 1M / 128K tokens |
| Redenering | Altijd ingeschakeld; lage, hoge, maximale inspanning |
| Tools | Function calling, streaming toolaanroepen, contextcaching, gestructureerde output |
| Primaire focus | Complex coderen, lang-horizon agents, engineering, cybersecurity |
| Gewichten / licentie | Open gewichten onder de aparte GLM-5.3-licentie; ondersteunende repositorycode onder Apache-2.0. |
Bronnen: Z.ai vlaggenschipdocumentatie en de officiële GLM-5-repository.
Architectuur: waarom Flash goedkoper is zonder klein te zijn
Flash wisselt lineaire-attentionblokken af met sparse-attentionblokken en gebruikt mHC rond attention- en MoE-componenten. Het IndexPool-mechanisme comprimeert vier indexer-keyvectoren tot één. Z.ai meldt 3,01× lagere attention-berekening per laag en een 4,44× kleinere KV-cache per laag dan het vlaggenschip bij een sequentielengte van 1M tokens.
Dit zijn vergelijkingen op architectuurniveau, geen gegarandeerde end-to-end latentiemultipliers. Werkelijke API-snelheid hangt ook af van hardware, kwantisatie, batching, redeneringslengte, servingsoftware en providerbelasting.
GLM-5.3-Flash hybride attention-architectuur en vergelijking van compute/cache bij lange context.
Bron: Z.ai officiële architectuurdocumentatie
Benchmarkprestaties: waar elk model wint
De schoonste vergelijking scheidt door de leverancier gerapporteerde taakbenchmarks van onafhankelijke API-metingen. Zelfs wanneer benchmarknamen overeenkomen, kunnen harnessversies, toolconfiguraties, contextbeheer en redeneringsinspanning verschillen. De onderstaande tabel gebruikt de dichtst gematchte waarden in de vlaggenschipevaluatie en Flash-evaluatie, waarbij kleine gaten als richtinggevend in plaats van definitief worden behandeld.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Hogere score | Wat het test |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Terminal- en agentic coderen |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Software-engineering |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Repositorygeneratie |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Toolgebruik |
| AutomationBench | 48.8 | 48.2 | Bijna gelijk / Flash | Automatisering van computergebruik |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Lang-horizon agentredenering |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Moeilijke tool-ondersteunde redenering |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Bijna gelijk / Flash | Professioneel kenniswerk |
Bronnen: vlaggenschip-evaluatie en Flash-evaluatie. Vergelijk richtinggevend omdat evaluatie-instellingen kunnen verschillen.
Coderen en repository-engineering
Het vlaggenschip heeft het hogere prestatieniveau. Het ligt 3,5 punten voor op DeepSWE en 1,7 punten op NL2Repo. Op Z.ai Code Bench v1.0, met beide modellen geëvalueerd met Claude Code 2.1.207, bereikt het vlaggenschip 34,5% bij maximale inspanning, terwijl Flash 29,0% haalt — een voordeel van 5,5 punten.
Flash blijft competitief genoeg om als eerste model te testen voor routineonderhoud van repositories, testgeneratie, debugging, refactoring en high-volume codeeragents. Escaleer alleen de moeilijkste taken of mislukte trajecten naar het vlaggenschip.
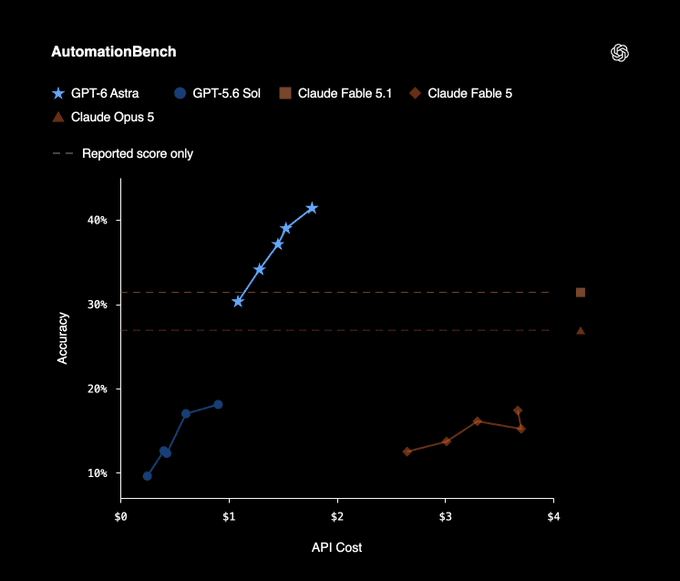
Z.ai’s zes-benchmark-evaluatie van GLM-5.3-Flash en andere codeer-/agentmodellen.
Bron: Z.ai officiële Flash-documentatie
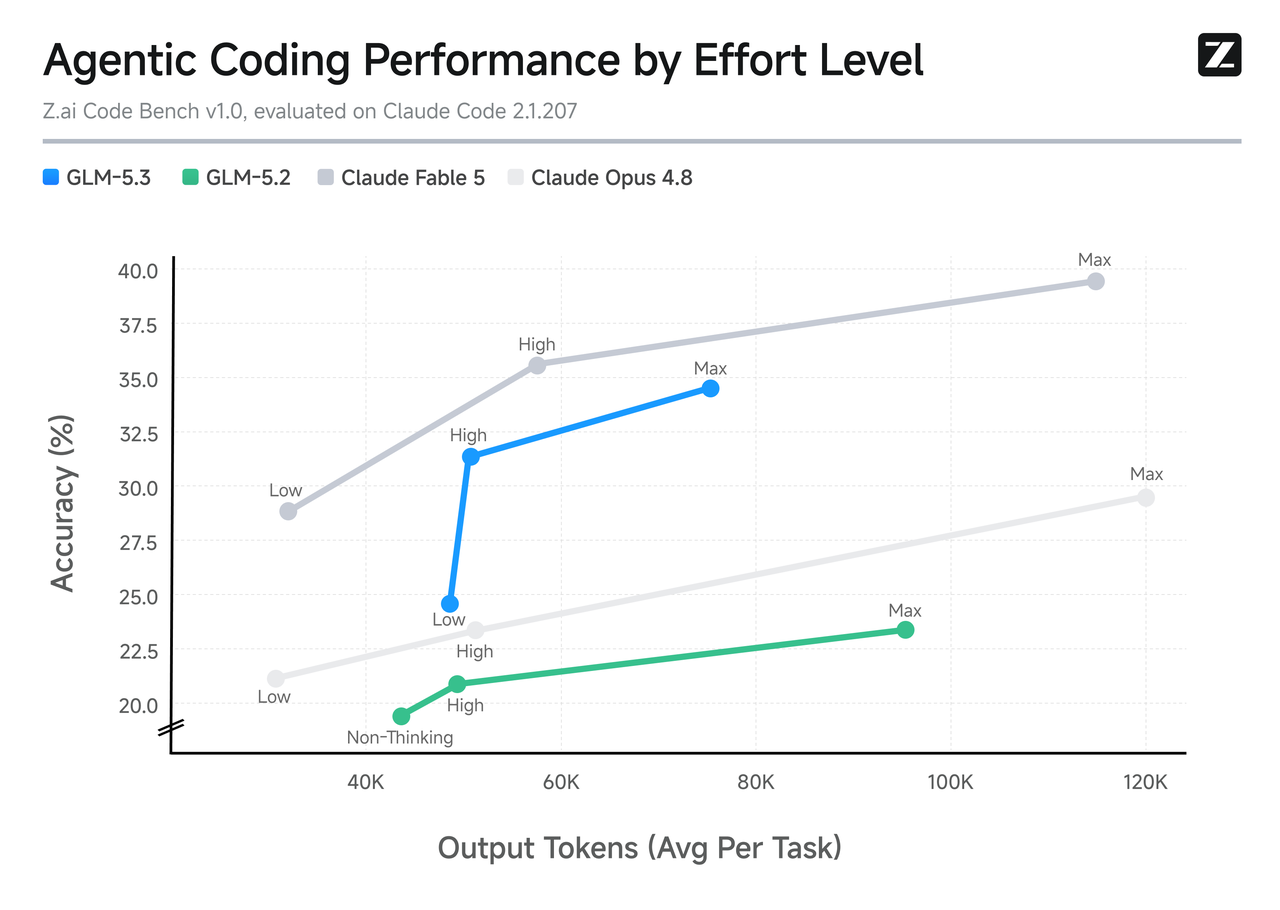
Nauwkeurigheid van GLM-5.3 agentic coderen en gebruik van outputtokens over redeneringsniveaus.
Bron: Z.ai officiële vlaggenschipdocumentatie
Toolgebruik, automatisering en kenniswerk
Flash is niet uniform zwakker. Het scoort 78,4 op Toolathlon Verified tegenover 73,0 voor het vlaggenschip, en wint AutomationBench met 48,8 tegen 48,2. Het is in wezen gelijk op GDPval-AA v2. Dit maakt Flash bijzonder aantrekkelijk wanneer de taak minder gaat om één extreem moeilijke redeneerketen en meer om het betrouwbaar coördineren van tools over veel goedkope aanvragen.
Onafhankelijke intelligentie, snelheid en latency
| Onafhankelijke meting | GLM-5.3 Flash | GLM-5.3 (max) | Resultaat |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Uitvoersnelheid | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 |
| Tijd tot eerste token | 1.49 s | 1.61 s | Flash |
| Contextvenster | 1M | 1M | Gelijk |
| Gemengde prijs in AA-vergelijking | $0.10 / 1M tokens | $0.90 / 1M tokens | Flash |
Bron: Artificial Analysis gematchte API-vergelijking.
Het onafhankelijke resultaat voegt een belangrijke correctie toe aan de aanname “Flash betekent sneller”. Flash reageert iets eerder, maar het geteste vlaggenschipendpoint genereert tokens sneller zodra de output begint. Behandel deze metingen als providerspecifieke momentopnames, niet als onveranderlijke modeleigenschappen.
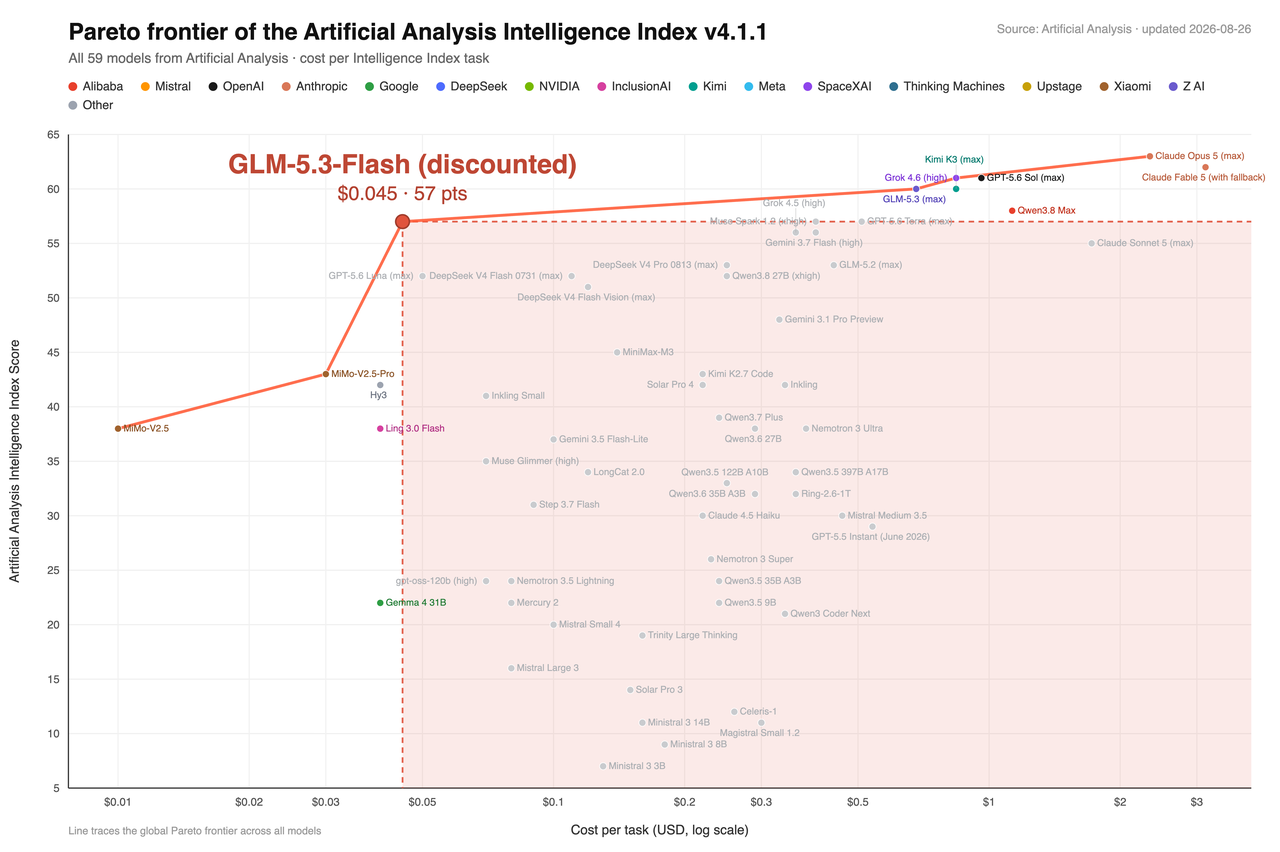
Kost–intelligentie-frontier van Artificial Analysis, gereproduceerd in Z.ai’s officiële Flash-documentatie.
Bron: Z.ai officiële Flash-documentatie
Multimodaliteit: Flash heeft het duidelijke voordeel
Flash accepteert visuele input en integreert die in agentische workflows. Het kan screenshots, pagina-afbeeldingen, grafieken, interfacestaten, schermopnames en ondersteunde bestanden inspecteren, en vervolgens het visuele bewijs gebruiken tijdens het coderen of het bedienen van tools. Het vlaggenschip ondersteunt momenteel alleen tekstinvoer.
- Frontend en design-to-code: Flash kan een referentiescreenshot inspecteren en de gerenderde implementatie valideren.
- Document- en Office-workflows: Flash kan redeneren over paginstructuur, grafieken, lay-out en plaatsing van afbeeldingen.
- Browser- en computergebruik: Flash kan visuele staat combineren met toolaanroepen en iteratieve correcties.
- Tekst-only repositorywerk: het vlaggenschip blijft de voorkeur hebben wanneer de input code en tekst is en de taak maximale redeneringsdiepte vereist.
Lange context en redeneringsinstellingen
GLM-5.3 Flash ondersteunt een contextvenster van 1M tokens en tot 128K outputtokens; GLM-5.3 biedt dezelfde limieten. Beide houden redenering ingeschakeld en accepteren lage, hoge en maximale inspanningsniveaus. Z.ai beveelt maximaal aan voor moeilijke codeeropgaven en het reproduceren van benchmarks.
Contextcapaciteit is daarom niet de primaire differentiator. Het verschil is hoe economisch elk model lange sequenties bedient en hoeveel redeneercapaciteit het kan inzetten bij de moeilijkste taken. Flash is architectonisch goedkoper bij lange context; het vlaggenschip heeft het sterkere kwaliteitsplafond.
Cybersecurity: GLM-5.3 is de specialist
Cybersecurity is de meest onderscheidende capaciteit van het vlaggenschip. Z.ai meldt 84,5 op CyberGym en 54,4 op ExploitBench. Onder genormaliseerde budgetten van twee en zes uur voltooide het respectievelijk 105 en 130 ExploitGym-taken.
Flash heeft geen gelijkwaardige lanceringsemphasis of gematchte publieke cybersuite. Gebruik het vlaggenschip als primair model voor code-review, secure development en geautoriseerde kwetsbaarheidsdetectie, en behoud menselijke goedkeuring, geïsoleerde tooling, auditlogs en disclosure-controles in de workflow.
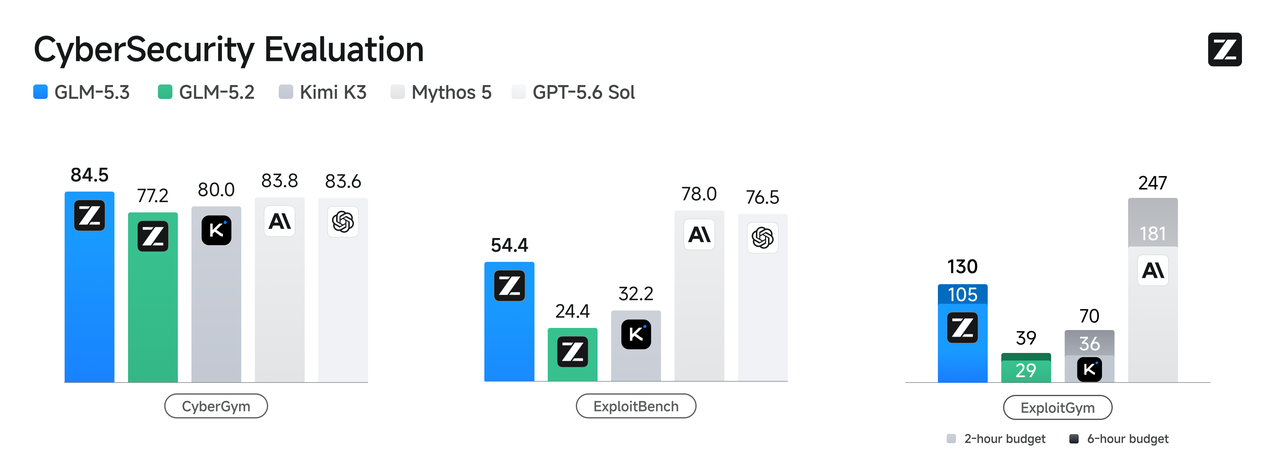
GLM-5.3-prestaties over benchmarks voor kwetsbaarheidsdetectie en exploitatieketens.
Bron: Z.ai officiële cybersecuritydocumentatie
Kosten en implementatie
API-prijzen
Z.ai prijst Flash op $0.15 per miljoen inputtokens en $0.50 per miljoen outputtokens vóór promoties, vergeleken met $1.40 en $4.40 voor het vlaggenschip.
| Toegangsroute | Flash input | Flash cached | Flash output | 5.3 input | 5.3 cached | 5.3 output |
|---|---|---|---|---|---|---|
| Z.ai standaardlijst | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Z.ai promotioneel Flash-tarief | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| CometAPI-route | $0.06 | Check live route | $0.20 | $1.12 | Check live route | $3.528 |
Prijzen zijn USD per 1M tokens. Bronnen: Z.ai-prijzen, Flash-route en GLM-5.3-route. Promoties kunnen veranderen.
Voorbeeld van maandelijkse kosten
Voor een workload met 100M inputtokens en 20M outputtokens leveren de huidige CometAPI-tarieven een geschatte $10.00 op voor Flash versus $182.56 voor het vlaggenschip, vóór cache-effecten of toolkosten. Flash verlaagt de tokenrekening in dit voorbeeld met circa 94,5%.
| Kostcomponent | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Invoerkosten | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Uitvoerkosten | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Totaal | $10.00 | $182.56 |
Open gewichten en zelf-hosting
Beide modellen hebben downloadbare FP8- en BF16-checkpoints. GLM-5.3 Flash-gewichten zijn uitgebracht onder de MIT-licentie. GLM-5.3 gebruikt de aparte GLM-5.3-licentie, die een securityreview vereist vóór commercieel gebruik door Model-as-a-Service-operators met een totale omzet van meer dan US$10 miljard over enige opeenvolgende 12 maanden. De ondersteunende GLM-5 GitHub-repository is gelicentieerd onder Apache-2.0.
Flash is eenvoudiger te serven dan het vlaggenschip, maar het is geen consumenten-GPU-model. De 320B-checkpoint, multimodale componenten, KV-cache en 1M-context vereisen nog steeds serieuze infrastructuur. Zelf-hosting is het aantrekkelijkst wanneer datacontrole, aangepaste serving of aanhoudend hoge benutting de operationele kosten rechtvaardigt.
Welk model moet je kiezen?
Kies GLM-5.3 Flash als?
- Je afbeeldingen, screenshots, grafieken, documenten, browser- of GUI-invoer moet begrijpen.
- Je high-volume codeeragents, onderzoeksworkflows of bedrijfsautomatisering draait.
- Je sterk toolgebruik en kenniswerkprestaties wilt tegen de laagste tokenkosten.
- Je een 1M-contextvenster nodig hebt maar niet de vlaggenschip-economie op elke aanvraag wilt.
- Je van plan bent zelf te hosten en 320B/18B praktischer is dan 744B/40B.
Kies GLM-5.3 als?
- Je de moeilijkste repository-schaal codeer- of lang-horizon engineeringtaken oplost.
- Je evaluatie diepere redenering beloont meer dan lage stukprijs.
- Je het sterkere resultaat nodig hebt op DeepSWE, HLE with tools of Agents’ Last Exam.
- Je geautoriseerde defensieve security- of kwetsbaarheidsdetectieworkflows bouwt.
- Een hogere succeskans een ongeveer orde-grootte tokenpremie kan compenseren.
Beslismatrix per use case
| Workload | Aanbevolen startmodel | Waarom |
|---|---|---|
| High-volume chat en automatisering | GLM-5.3 Flash | Veel lagere kosten; sterk toolgebruik |
| Visueel coderen en UI-debugging | GLM-5.3 Flash | Native visuele input |
| Document-, grafiek- en Office-analyse | GLM-5.3 Flash | Multimodale professionele workflows |
| Routineonderhoud van repositories | Start met Flash | Escaleer mislukte of uitzonderlijk moeilijke taken |
| Moeilijke engineering op repositorieschaal | GLM-5.3 | Hoger coderingsplafond |
| Lang-horizon onderzoek met tools | GLM-5.3 | Sterker HLE-with-tools-resultaat |
| Defensieve security en kwetsbaarheidsdetectie | GLM-5.3 | Toegewijde cybertraining en benchmarks |
| Kostengevoelige zelf-hosting | GLM-5.3 Flash | Kleinere actieve en totale footprint |
| Onzekere gemengde workload | Hybride routering | Flash standaard; vlaggenschip-escalatie |
Een betere productiestrategie: routeren, niet vervangen
Voor de meeste teams is de sterkste aanpak geen exclusieve keuze. Gebruik Flash als de standaardroute en escaleer alleen taken met hoge complexiteit, mislukte validatie, securitygevoeligheid of een verwachte economische waarde die de vlaggenschippremie rechtvaardigt.
- Stuur visuele, routinematige en high-volume taken naar Flash.
- Meet acceptatiegraad, tokens, latency, toolfouten en menselijke interventie.
- Escaleer mislukte of risicovolle teksttaken naar het vlaggenschip.
- Leid securitygevoelig werk via extra autorisatie- en sandboxcontroles.
- Optimaliseer op kosten per geaccepteerd resultaat in plaats van alleen benchmarkrang of prijs.
Hoe test je beide modellen via CometAPI
CometAPI biedt de GLM-5.3 Flash-route en GLM-5.3-route achter dezelfde OpenAI-compatibele basis-URL. Maak een API-sleutel en voer vervolgens dezelfde teksttaak uit via beide model-ID’s. Voor een eerlijke test houd je prompt, redeneringsinspanning, tooldefinities, maximale output en acceptatierubriek vast.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Voor multimodale evaluatie gebruik je de live Flash-route documentatie om het ondersteunde schema voor afbeeldingscontent te verifiëren. De vlaggenschipvergelijking moet een tekst-only equivalent gebruiken omdat die geen visuele input accepteert.
Beperkingen van deze vergelijking
- Verschillende codeer- en agentscores zijn door de leverancier gerapporteerd. Onafhankelijke reproductie kan andere tools, prompts en inference-instellingen gebruiken.
- Gematchte benchmarknamen garanderen niet altijd identieke harnessversies of contextbeheerstrategieën.
- Reducties in attention-berekening en KV-cache op architectuurniveau voorspellen API-latency niet direct.
- Prijzen, promoties, modelbeschikbaarheid, snelheidslimieten en routecapaciteiten kunnen wijzigen; verifieer live modelpagina’s vóór deployment.
- Open gewichten maken geen van beide checkpoints goedkoop om zelf te hosten bij volledige context.
- Cybersecuritycapaciteit is dual-use en vereist autorisatie, sandboxing, logging, expertreview en responsible disclosure.
Conclusie
GLM-5.3 Flash is de praktische standaard. Het behoudt lange context, voegt native visie toe, presteert sterk op toolgebruik en professioneel werk, en verandert de economie voldoende om veel bredere deployment te ondersteunen. GLM-5.3 is het specialistische escalatiemodel: duurder, alleen tekst, maar sterker op de moeilijkste codeer-, redeneer- en cybersecuritytaken.
Het eindoordeel is daarom workload-gebaseerd: begin met Flash, meet de werkelijke acceptatiegraad en routeer naar het vlaggenschip alleen wanneer de extra redeneercapaciteit genoeg extra succesvolle uitkomsten oplevert om de premie te rechtvaardigen.
Veelgestelde vragen
Is GLM-5.3 Flash beter dan GLM-5.3?
Niet universeel. Flash is beter qua prijs, multimodaliteit en diverse tool-/automatiseringsbenchmarks. Het vlaggenschip is sterker op de moeilijkste codeer-, tool-ondersteunde redenerings- en cybersecurityworkloads.
Is GLM-5.3 Flash een klein model?
Nee. Het heeft 320B totale parameters en activeert 18B per token. Het is efficiënter dan het 744B/40B vlaggenschip, maar vereist nog steeds substantiële hardware voor zelf-hosting.
Welk model is goedkoper?
Flash is drastisch goedkoper. De standaardlijstprijs van Z.ai is ongeveer een tiende van die van het vlaggenschip, en de huidige CometAPI-routes tonen een nog grotere kloof terwijl promotionele prijzen actief zijn.
Welk model is sneller?
Het hangt af van de metric en provider. Artificial Analysis mat een iets lagere time-to-first-token voor Flash maar een hogere uitvoersnelheid voor het vlaggenschip.
Welk model ondersteunt afbeeldingen?
Flash ondersteunt native visuele input. Het vlaggenschip ondersteunt momenteel alleen tekstinput.
Ondersteunen beide modellen een context van 1M tokens?
Ja. Flash ondersteunt 1M context en tot 128K output; het vlaggenschip biedt dezelfde limieten.
Welk model is beter voor coderen?
Gebruik Flash voor routine- en high-volume codeeragents. Gebruik het vlaggenschip voor de moeilijkste repository-schaal engineeringtaken of wanneer falen meer kost dan het prijsverschil.
Welk model is beter voor cybersecurity?
Het vlaggenschip. Z.ai trainde en evalueerde het specifiek voor kwetsbaarheidsdetectie en exploitatieketenredenering. Gebruik het alleen in geautoriseerde, gecontroleerde omgevingen.
Kunnen beide modellen zelf gehost worden?
Ja. De repository van Z.ai vermeldt downloadbare checkpoints en ondersteunde servingframeworks, maar beide blijven grote infrastructuurprojecten.
Wat is de beste implementatiestrategie?
Gebruik Flash als standaardroute en escaleer moeilijke, mislukte of securitygevoelige teksttaken naar het vlaggenschip. Meet kosten per geaccepteerd resultaat.