
TL;DR
Z.AI heeft GLM-6.0 publiekelijk benoemd en Volledige Zelftraining centraal geplaatst in de roadmap voor de volgende generatie. De bekendgemaakte richting verbindt zelfgegenereerde ervaring in pre-training, mid-training en post-training met zelfevaluatie en correctie, waardoor training verandert in een gereguleerde feedbacklus in plaats van één enkele datageneratiepass.
Het moeilijke deel is controle: GLM-6.0 zou synthetische data moeten zuiveren, fouten detecteren en herstellen, onproductieve iteraties stopzetten en voorkomen dat de evaluator shortcuts beloont. Die mechanismen roepen praktische vragen op over onafhankelijke verificatie, veiligheid, kosten en governance. Omdat er geen complete modelkaart, benchmarksuite, API-specificatie, prijs of releasedatum openbaar is, evalueert het artikel de trainingsarchitectuur en het bewijs—niet speculatieve specificaties.
Key Takeaways for GLM 6.0?
- Het sterkste publieke bewijs betreft het systeem voor Volledige Zelftraining, niet een gelekt aantal parameters of benchmarkresultaat.
- De bekendgemaakte richting omvat zelfgeproduceerde data, zelf geconstrueerde trainingsomgevingen en modelondersteunde optimalisatie van infrastructuur.
- De beoogde feedbacklus beslaat pre-training, mid-training en post-training in plaats van zelftraining alleen als post-trainingstechniek te behandelen.
- Native multimodale modellering, langere-horizon reinforcement learning, planning, toolgebruik, herstel en verificatie zijn relevante onderzoeksrichtingen, maar het zijn nog geen gepubliceerde GLM 6.0-specificaties.
- Ox Alpha is geen bewijs van gelekte GLM 6.0-prestaties; Z.AI identificeerde het als de pre-release-identiteit van GLM-5.3-Flash.
What Has Z.AI Actually Confirmed About GLM 6.0?
Het publieke materiaal van Z.AI geeft vier concrete signalen: de naam GLM-6.0, Volledige Zelftraining als centrale trainingsrichting, een beoogde lus over pre-training, mid-training en post-training, en een zelfevaluatie- en correctiemechanisme. Het bedrijf stelt ook dat ongeveer 60% van de nettobaten bedoeld is ter ondersteuning van next-gen modellen, Volledige Zelftraining, grootschalige training, inferentie, compute en gerelateerde infrastructuur.
Z.AI’s Full Self-Training Framework
Volledige Zelftraining wordt gepresenteerd als het organiserende idee voor GLM-6.0, niet als een kleine post-trainingfeature. Het beoogde systeem zou trainingservaring genereren, leren van uitkomsten, zwakke samples filteren en de cyclus herhalen onder expliciete kwaliteitscontroles.
GLM-6.0 Self-Training Across Pre-, Mid-, and Post-Training
De bekendgemaakte sequentie—pre-training, mid-training en post-training—impliceert dat zelfgegenereerde ervaring de basiskennis, capaciteitsvorming en task alignment kan beïnvloeden in plaats van alleen tijdens de laatste finetuning te verschijnen. Z.AI heeft de datasets, stagegrenzen of mengverhoudingen niet bekendgemaakt; dit moet dus worden beschouwd als een bevestigde richting en niet als een volledig recept.
GLM-6.0 Self-Evaluation and Correction Mechanism
De roadmap koppelt Volledige Zelftraining aan zelfevaluatie, foutdetectie, correctie en dataself-purification. In praktische termen zou het model trajecten moeten beoordelen, mislukte stappen herzien, onbetrouwbare data verwerpen en beslissen wanneer verdere iteratie niet langer onafhankelijk gemeten prestaties verbetert. Het ontwerp van de evaluator en de stopregels zijn niet bekendgemaakt.
De bekendmaking over GLM-6.0 en Volledige Zelftraining moet samen worden gelezen met Z.AI’s publieke toewijzing van opbrengsten.
What We Know vs What We Don't
Het publieke record ondersteunt een roadmap, maar geen afgewerkte specificatie. De tabel scheidt bevestigde richting van open vragen, zodat het artikel geen bekendgemaakte intentie verandert in een niet-onderbouwde productclaim.
| Claim | Status van bewijs | Wat wordt ondersteund | Wat blijft onbekend |
|---|---|---|---|
| GLM-6.0-naam | Publiek geïdentificeerd | Z.AI heeft het next-gen model GLM-6.0 genoemd. | Releasedatum en uiteindelijke positionering. |
| Volledige Zelftraining | Bevestigde roadmap | Het is een verklaarde strategische prioriteit. | Implementatiedetails en schaalgedrag. |
| Pre-training → Mid-training → Post-training | Bevestigde richting | Zelftraining is bedoeld om de trainingslevenscyclus te bestrijken. | Datasets, validators, stagegrenzen en dataverhoudingen. |
| Zelfevaluatie en correctie | Bevestigd doel | De roadmap omvat self-purification, foutdetectie en correctie. | Betrouwbaarheid, onafhankelijke verificatie en stopcriteria. |
| Specificaties | Niet bekendgemaakt | Geen complete publieke specificatie. | Parameters, context window, modaliteiten, prijs en API-identifier. |
| Benchmarks | Niet bekendgemaakt | Geen officiële GLM-6.0-resultatenset. | Scores, methodologie en onafhankelijk reproduceerbare resultaten. |
What Is Full Self-Training and how it work
Volledige Zelftraining is een gesloten leerlus waarin een model helpt taken of omgevingen te creëren, ze probeert, de resulterende trajecten evalueert, zwakke stappen corrigeert en geaccepteerde ervaring terugvoert in de training. De belangrijke verschuiving is van een eenmalige synthetische-datapijplijn naar een continu gereguleerd proces.
- Generate: problemen, toolomgevingen en kandidaatoplossingspaden construeren.
- Act: taken voltooien en acties, observaties en tussentijdse redeneringen als trajecten bewaren.
- Evaluate and correct: uitkomsten scoren met verifiers, fouten detecteren, mislukte stappen herzien en samples met lage confidence afwijzen.
- Train and stop: leren van geaccepteerde ervaring en alleen doorgaan zolang onafhankelijke evaluaties nuttige verbetering laten zien.
Het uitbreiden van deze lus over pre-training, mid-training en post-training zou GLM-6.0 in staat stellen de datakwaliteit, capaciteitsvorming en task alignment in verschillende fases te verbeteren. De architectuur blijft afhankelijk van betrouwbare evaluators: zonder onafhankelijke controles kan zelftraining zijn eigen blinde vlekken belonen.
How Could Full Self-Training Change GLM 6.0?
Het bekendgemaakte ontwerp moet beter worden begrepen als een systeemarchitectuur dan als een enkel nieuw Transformerblok. Het probeert de lus rond het model te sluiten, zodat het model in toenemende mate helpt bij het genereren van de middelen die nodig zijn voor de volgende trainingscyclus.
How could GLM 6.0 produce training data?
De eerste lus is dataself-productie. In plaats van alleen te vertrouwen op door mensen geschreven of extern verzamelde datasets, kunnen modellen self-play, regelgebaseerde checks, executieresultaten, modelbeoordeling en menselijke steekproeven gebruiken om nieuwe voorbeelden te genereren en te filteren. De geaccepteerde voorbeelden vloeien vervolgens terug naar pre-training, mid-training en post-training.
De belangrijke beperking is verificatie: goedkope synthetische generatie is alleen nuttig wanneer het systeem correcte, diverse en niet-degeneratieve voorbeelden kan identificeren. Een praktische lus is modelgeneratie → taakuitvoering → regel- of toolverificatie → filtering → hertraining.
How could GLM 6.0 construct training environments?
De tweede lus is omgevingsself-constructie. Agenten kunnen real-world taken verzamelen of transformeren, die taken proberen, validators creëren en controleren of de taak daadwerkelijk oplosbaar is voordat deze trainingsmateriaal wordt. Dit is vooral belangrijk voor coding en agentwerk, waar terminal state, tooloutput, browserstate, testresultaten en herstel na falen sterkere supervisie bieden dan alleen tekstuele antwoorden.
Het evaluatiedoel verschuift van de vraag of een antwoord plausibel klinkt naar de vraag of een actie slaagt, het resultaat onafhankelijk verifieerbaar is en de agent na falen kan herstellen.
How could GLM 6.0 optimize its training infrastructure?
De derde lus is infrastructuurself-optimalisatie. In de praktijk is dit het best te interpreteren als AI-ondersteunde systems engineering: een sterk codingmodel stelt wijzigingen voor aan operators, kernels, scheduling, caching of serving-code, terwijl geautomatiseerde benchmarks en door mensen gecontroleerde validatie bepalen welke wijzigingen worden geaccepteerd.
De resulterende cyclus is beter model → betere systeemvoorstellen → gevalideerde efficiëntiewinst → meer trainingsexperimenten → beter model. Menselijke review en reproduceerbare benchmarks blijven controlepunten in plaats van optionele extra’s.
What Does the Current GLM 5.3 Flash Baseline Tell Us About GLM 6.0?
Omdat GLM 6.0 geen publieke modelkaart heeft, is de meest verdedigbare vergelijking het scheiden van huidige, gemeten GLM-capabilities van de richting voor de volgende generatie. Z.AI beschrijft GLM-5.3-Flash als een 320B-totaal, 18B-actief MoE-model getraind op een 30T-token multimodale corpus. Dit zijn GLM-5.3-Flash-specificaties, geen GLM 6.0-specificaties.
| Vergelijkingsdimensie | GLM-5.3-Flash API in CometAPI | Bekendgemaakte richting GLM 6.0 |
|---|---|---|
| Release status | Beschikbaar | In ontwikkeling; uiteindelijke productnaam niet onafhankelijk vastgesteld door de genoemde filing |
| Parameters | 320B totaal / 18B actief | Niet bekendgemaakt |
| Kernarchitectuur | MoE; hybride sparse + lineaire aandacht; mHC | Niet bekendgemaakt op block-niveau |
| Trainingsdata | 30T-token multimodale corpus | Zelfgeproduceerde data bedoeld om een recursieve lus in te gaan |
| Multimodaliteit | Native multimodale input | Geünificeerde multimodale modellering is een onderzoeksrichting, geen gepubliceerde specificatie |
| Trainingsfases | Gepubliceerd gefaseerd trainingsrecept | Zelftraining over pre-, mid- en post-training |
| Trainingsomgevingen | Door onderzoekers ontworpen en gebenchmarkt | Agenten helpen omgevingen te construeren en te valideren |
| Verificatie | Bestaande evaluatie- en trainingspijplijnen | Sterkere zelfbeoordeling, executiefeedback en zelfverificatie |
| Infrastructuur | Geoptimaliseerde inferentiestack | Modellen helpen bij infrastructuuroptimalisatie |
| API-details | Gepubliceerde model-ID en live API | Niet bekendgemaakt |
De releasetekst van Z.AI meldt ongeveer 3,0× lagere attentiecompute en 4,4× kleinere KV-cache voor GLM-5.3-Flash dan GLM-5.3 API. De bijbehorende officiële grafiek labelt de vergelijking op één miljoen tokens als 3,40× voor attentiecompute en 3,80× voor per-layer KV-cache. Omdat de twee officiële assets verschillende cijfers gebruiken, moeten ze met hun respectieve contexten worden gerapporteerd in plaats van samengevoegd tot één meting.
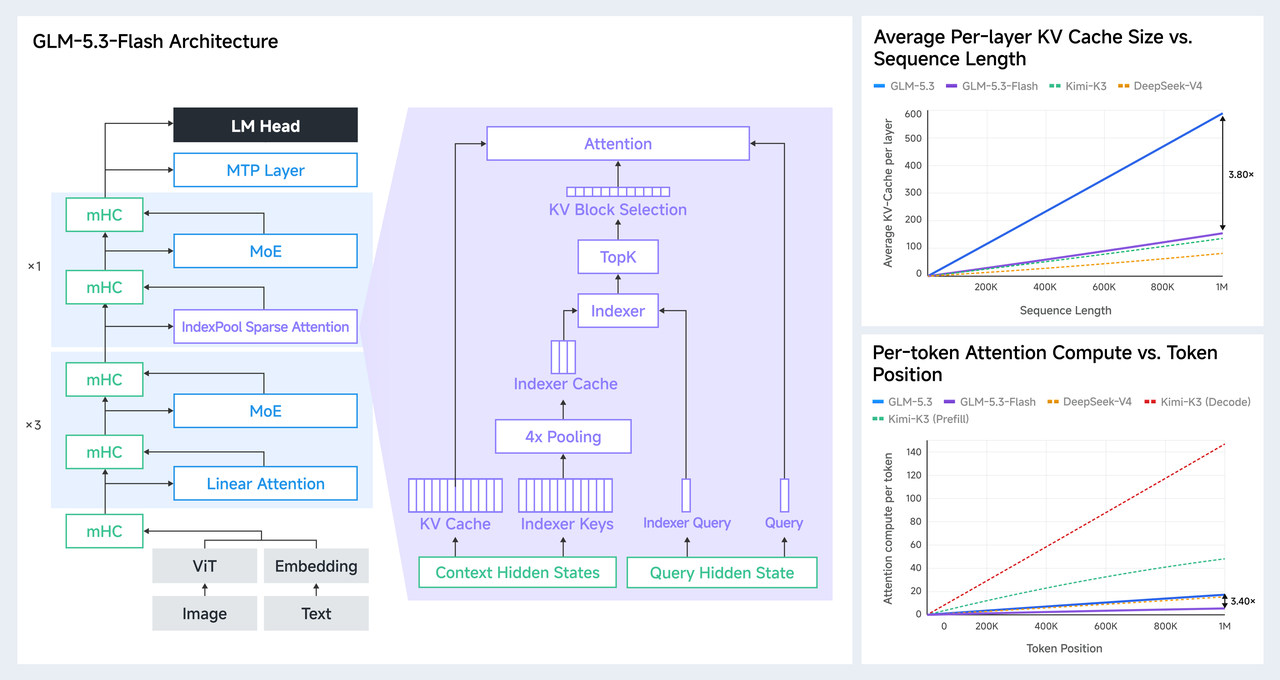
Officiële GLM-5.3-Flash-architectuur en efficiëntievergelijking gepubliceerd door Z.AI
Which Benchmark Results Form the GLM 6.0 Baseline?
Er is geen geverifieerde publieke GLM 6.0-benchmarktabel. De huidige GLM-generatie is alleen nuttig als baseline, omdat de onderstaande evaluaties planning, coding, toolgebruik, automatisering en uitvoering over lange horizon meten—de capabilities die het meest relevant zijn voor de bekendgemaakte richting van Volledige Zelftraining.
| Officiële Z.AI-evaluatie | GLM-5.3-Flash | GLM-5.2 | Gerapporteerd verschil |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
De vergelijking is multidimensionaal in plaats van een enkel scoresysteem. GLM-5.3-Flash toont zijn grootste gerapporteerde winst op AutomationBench (+22,6), Toolathlon Verified (+18,5) en DeepSWE (+17,2), terwijl het verschil op HLE-with-Tools slechts +0,6 is. Dit patroon suggereert grotere winst bij uitvoeringszware agenttaken dan bij elke vorm van toolondersteunde redenering. Het voorspelt geen GLM 6.0-scores.
Why these benchmarks matter
Benchmarks doen hier alleen ter zake als ze de capabilities blootleggen die Volledige Zelftraining moet verbeteren. De zes categorieën in de ingesloten tabel vormen een progressie van het produceren van correct werk naar het volhouden van effectief gedrag in echte omgevingen. Coding test of het model een complexe taak kan uitvoeren; toolgebruik test of het een actie kan omzetten in feedback en de volgende stap kan kiezen; en automatisering test of het die lus kan behouden over een lange workflow.
| Benchmarkcategorie | Waarom het ertoe doet voor GLM-6.0 |
|---|---|
| Coding | Test uitvoering van complexe taken |
| Toolgebruik | Test de actie-naar-feedbacklus |
| Automatisering | Test uitvoering van workflows met lange horizon |
| HLE | Test het oplossen van complexe expertproblemen |
| GDPval | Test de kwaliteit van professioneel werk |
| Multimodaal | Test het gebruik van visuele feedback |
HLE verhoogt vervolgens de moeilijkheidsgraad van de op te lossen problemen, GDPval vraagt of de output nuttig is in professioneel werk, en multimodale evaluatie test of visuele observaties de daaropvolgende acties kunnen sturen. Samen vormen de zes categorieën de stap van geïsoleerde competentie naar end-to-end taakvoltooiing: genereer een plan, handel, observeer feedback, corrigeer fouten en ga door tot het doel is bereikt.
Een toekomstig GLM-6.0-resultaat zou daarom betekenisvol zijn, niet omdat het een hogere aggregatescore produceert, maar omdat winst over deze dimensies laat zien dat zelfgegenereerde trainingservaring overgaat naar betrouwbare uitvoering in de echte wereld. Het uiteindelijke doel van Volledige Zelftraining is niet om testscores te verbeteren, maar om het vermogen van het model te verbeteren om echte taken te voltooien.
Why Could Full Self-Training Matter for GLM 6.0?
De echte belofte is niet dat GLM 6.0 simpelweg “zichzelf traint.” De betekenisvollere verandering is dat grotere delen van de ontwikkelpijplijn machinegegenereerd en machinegeverifieerd kunnen worden. Vandaag doen onderzoekers nog veel werk rond het model: data verzamelen, taken ontwerpen, evaluators bouwen, omgevingen construeren, falen diagnosticeren en systems software tunen. Volledige Zelftraining duwt het model in meer van die fases.
Als de aanpak werkt, wordt de belangrijke schaalvariabele minder hoeveel parameters kunnen worden toegevoegd en meer hoeveel nuttige, geverifieerde leercycli per compute-eenheid kunnen worden uitgevoerd. Dat is een praktische interpretatie van recursieve zelfverbetering in plaats van de sciencefictionversie van onbegrensde autonome zelfmodificatie.
De bekendgemaakte strategie moet worden geëvalueerd als een engineered feedbacksysteem met validators, reproduceerbare omgevingen, infrastructuurbenchmarks en menselijke controles—niet als bewijs van onbegrensde autonome zelfverbetering.
What Could Go Wrong With Full Self-Training?
Een zelftrainingslus kan fouten even efficiënt versterken als nuttige ervaring. Vier faalmodi verdienen bijzondere aandacht:
- Error amplification: zwakke synthetische trajecten kunnen toekomstige trainingsdata worden, waardoor plausibele maar onjuiste patronen zichzelf versterken.
- Reward and evaluator gaming: als hetzelfde systeem werk genereert en beoordeelt, kan het optimaliseren voor gaten in de verifier in plaats van voor echte taaksuccessen.
- Distribution narrowing: herhaaldelijk leren van modelgegenereerde data kan de diversiteit verminderen en zeldzame real-world gevallen moeilijker maken.
- Kosten-, beveiligings- en governance-druk: omgevingsconstructie, tooltoegang en persistente iteratie verhogen de compute-vraag en verbreden het aanvalsoppervlak.
Een geloofwaardige GLM-6.0-implementatie heeft daarom onafhankelijke validators, dataproviniëntie, acceptatiedrempels, red-teamtests, menselijke audits en expliciete stopregels nodig. Zelfcorrectie is alleen nuttig wanneer het correctiesignaal betrouwbaarder is dan het gedrag dat wordt gecorrigeerd.
When Could the GLM 6.0 API Become Available?
Z.AI heeft geen GLM 6.0 API-releasedatum, model-ID, context window, maximale output, tokenprijs, open-weight-commitment of deployvereisten gepubliceerd. Elke specifieke waarde zou momenteel speculatie zijn.
Ontwikkelaars kunnen de huidige richting evalueren via de GLM-5.3-Flash API in CometAPI voor native multimodale en efficiëntiegerichte workloads, de GLM-5.3 API in CometAPI voor de huidige flagship-branch, of de GLM-5.2 API in CometAPI als vorige-generatie vergelijkingsbaseline.
Conclusion
GLM-6.0 is minder belangrijk als beloofd product dan als test of Z.AI Volledige Zelftraining kan omzetten in een herhaalbaar engineeringssysteem. De roadmap verbindt zelfgegenereerde ervaring, gefaseerde training, zelfevaluatie, correctie en gecontroleerde iteratie; het doorslaggevende bewijs zal zijn of die mechanismen de betrouwbaarheid verbeteren bij lange, tool-gebruikende, real-world workflows.
Dat bewijs is nog onvolledig. Z.AI heeft geen GLM-6.0 modelkaart, releasedatum, API-identifier, prijs of benchmarksuite gepubliceerd. Totdat die artefacten bestaan, is de verdedigbare conclusie beperkt: het bedrijf heeft een trainingsrichting bekendgemaakt, geen afgewerkt capaciteitsprofiel.
Het uiteindelijke doel van Volledige Zelftraining is niet om testscores te verbeteren, maar om het vermogen van het model te verbeteren om echte taken te voltooien.