
TL;DR
GPT-6.1 Sol is geen vervanger met grotere context of hogere kosten voor GPT-6 Sol. Het behoudt dezelfde contextvenster van 1,05 miljoen tokens, maximale output van 128K en $2/$10 standaard API-prijzen, terwijl het coderen, computergebruik, professionele workflows, feitelijke betrouwbaarheid en agentgedrag verbetert. De duidelijkste prijswijziging is promptcaching: cached input daalt van $0,20 naar $0,10 per miljoen tokens.
Het praktische resultaat is dat GPT-6.1 Sol minder gaat over het veranderen van de vorm van de API en meer over het uitvoeren van aanzienlijk nuttiger werk binnen ruwweg hetzelfde tokenbudget.
Key Takeaways
- GPT-6.1 Sol is een capaciteitsupgrade van GPT-6 Sol, met hetzelfde contextvenster van 1.050.000 tokens en outputplafond van 128.000 tokens.
- Standaard API-prijzen voor input en output blijven $2/M en $10/M; cached input daalt van $0,20/M naar $0,10/M.
- Officiële evaluaties tonen sterkere prestaties in coderen, computergebruik, bedrijfsautomatisering en wetenschappelijke workflows; resultaten hangen af van benchmark en reasoning-instelling.
- Migratie vereist controle van zowel reasoning-inspanning als API-endpointcompatibiliteit: GPT-6.1 Sol verwijdert niets en vereist Responses API voor tool-calling.
- Valideer taak- en workflowsucces, latency, daadwerkelijke cache-hits en end-to-endkosten voordat je een stabiele GPT-6 Sol-deployment vervangt.
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI introduceerde GPT-6 Sol op 22 september 2026. Een week later kondigde de systeemkaart-addendum van 29 september GPT-6.1 Sol aan. OpenAI presenteert de nieuwe release als een upgrade van GPT-6 Sol en niet als een aparte prijstier.
Het korte release-interval is relevant omdat GPT-6.1 Sol niet gepositioneerd is als een nieuwe producttier. OpenAI behield de Sol-prijstier en richtte de update op capaciteiten voor moeilijke taken, kostenefficiëntie en agentbetrouwbaarheid.
OpenAI positioneert GPT-6.1 Sol rond agentisch coderen, computergebruik en professioneel werk. De belangrijke vergelijking is taalsucces tegen een gegeven kost, in plaats van de modelnaam op zich. De officiële benchmark-samenvatting hieronder scheidt capaciteitswinst van ongewijzigde API-specificaties.
Dat maakt de vergelijking ongebruikelijk eenvoudig: GPT-6.1 Sol is primair een upgrade in capaciteit en efficiëntie, niet een upgrade in contextvenster of basisprijs.
GPT-6.1 Sol vs. GPT-6 Sol: What Stays the Same?
Beide modellen behouden dezelfde headline-capaciteit, ondersteunde input/outputmodaliteiten en standaardprijzen voor input/output. De tabel noteert ook verschillen in cutoffdata, reasoning-opties, tool-calling en cached-inputtarieven; die verschillen moeten niet worden verward met gedeelde specificaties.
Shared Specifications and Compatibility Differences
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
De twee officiële modelkolommen hierboven documenteren dezelfde context- en outputlimieten. Deze aantallen beschrijven capaciteit; ze vestigen geen gelijke retrievalnauwkeurigheid of latency voor elke long-context workload.
De knowledge cutoff verschuift licht, van 20 april naar 30 april 2026. Belangrijker: GPT-6.1 Sol ondersteunt niet langer reasoning.effort="none"; de beschikbare reasoning-instellingen beginnen bij low.
Voor ontwikkelaars die afhankelijk zijn van gedrag met minimale latency, is dit compatibiliteitsdetail het testen waard, omdat GPT-6 Sol reasoning effort none nog steeds ondersteunt.
Architecture: What Remains Undisclosed
Geen van beide modelpagina’s die voor deze vergelijking zijn gebruikt, biedt een parameteraantal of een gedetailleerde architectuuruitsplitsing. Het officiële system-card addendum zegt dat GPT-6.1 Sol dezelfde typen data en training gebruikt als Astra; die uitspraak bewijst niet dat Sol en Astra identieke architecturen hebben. Verschillen in architectuur en parameterschaal blijven daarom niet openbaar in het geciteerde materiaal.
Base Pricing Is Unchanged; Cached Reads Are Cheaper
Voor gewone, niet-gecachete tokens: nee. Standaardtarieven voor input en output zijn ongewijzigd. De belangrijkste prijsverbetering is cached input.
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol verlaagt cached input naar $0,10 per miljoen tokens, of 5% van het ongecachete inputtarief.
Bijvoorbeeld: hergebruik van 100 miljoen gecachete inputtokens kost ongeveer $10 op GPT-6.1 Sol versus $20 op GPT-6 Sol. Dat verschil is bescheiden voor eenmalige prompts, maar betekenisvoller voor high-volume agents met stabiele promptprefixen.
De officiële prijsvoorwaarden in de modeldocumentatie gelden ook: requests boven 272K inputtokens gebruiken 2x input- en cachetarieven en 1,5x outputprijs voor de volledige request. GPT-6.1 Sol Fast mode is 2x Standard; Batch en Flex zitten 50% onder Standard. Regionale verwerking voegt een premie van 10% toe waar beschikbaar, en Fast mode is niet beschikbaar met EU data residency. Afzonderlijke toolkosten kunnen van toepassing zijn. Budgetteer op basis van de geselecteerde verwerkingsmodus, regio en daadwerkelijke cache-hits.
What Has Improved in GPT-6.1 Sol?
De upgrade kan het best worden beoordeeld over coderen, agentworkflows, professionele documenten, wetenschap, factualiteit en foutherstel. De secties hieronder groeperen die verbeteringen met behoud van de oorspronkelijke benchmarkcondities en beperkingen.
Benchmark Overview: Reported Gains and Evaluation Conditions
Het sterkste argument voor GPT-6.1 Sol komt voort uit prestaties op taakniveau in plaats van ruwe specificaties. OpenAI meldt verbeteringen in software engineering, bedrijfsautomatisering, computerinteractie, wetenschappelijke workflows, factualiteit en agentalignment.
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | What the Change Means |
|---|---|---|
| DeepSWE v1.1 | +6,4 procentpunten boven GPT-6 Sol’s beste resultaat, bij lagere reasoning-inspanning en taakkosten; dit is geen vergelijking met gelijke inspanning | Sterkere software engineering over lange horizon |
| AutomationBench 1.0.6 | +4,8 procentpunten bij medium effort voor beide Sol-modellen; +2,2 punten boven Opus 5.5 bij medium effort | Betere uitvoering door business-agents over meerdere stappen |
| OSWorld 2.0 offline | +7 procentpunten bij max effort; gedeeltelijke beloning op de offline set, release v2026.08.08; minder dan de helft van de taakkosten | Betere workflows voor computergebruik |
| Terminal-Bench Science 0.1 | Meer dan 2x de score van GPT-6 Sol bij max effort, met minder dan de helft van de kosten per taak | Grote winst in wetenschappelijke agentworkflows |
| Difficult factuality evaluation | Bij low effort daalt het aandeel antwoorden met fouten van 11,4% naar 7,7%; dit is een geselecteerde evaluatie van moeilijke prompts | Minder feitelijke fouten bij moeilijke prompts |
| Broken-search alignment test | Bij maximum effort daalt het niet-melden van kapotte zoekfunctie van 4,9% naar 2,1%; doelbewust adversariële taken | Betere herkenning van toolstoringen |
Dit zijn door OpenAI gerapporteerde resultaten, geen onafhankelijke CometAPI-metingen. OpenAI evalueerde zijn modellen in zijn onderzoeksomgeving of via zijn API; productiegedrag kan verschillen met systemprompts en beschikbare tools. Cijfers van concurrenten komen uit publieke rapporten. Taakkosten weerspiegelen de geteste configuratie en zijn niet hetzelfde als tokenprijs. Niet-gerapporteerde details zoals per-run budgetten of scaffolds moeten niet worden afgeleid.
Het officiële resultaat in de benchmarktabel vergelijkt GPT-6.1 Sol bij lagere reasoning-inspanning met de beste score van GPT-6 Sol. Het mag niet worden beschreven als een gecontroleerde, vergelijking met gelijke inspanning en snelheid. DeepSWE v1.1 evalueert originele software-engineeringtaken in echte codebases.
Ter context: de oorspronkelijke GPT-6 Sol-lancering rapporteerde 68,8% bij maximum effort op DeepSWE v1.1.
Coding: Stronger Long-Horizon Software Engineering
Coderen is arguably de duidelijkste upgrade. DeepSWE v1.1 evalueert agents op originele software-engineeringtaken in echte codebases die langdurig, meerstaps werk vereisen.
De hierboven samengevatte DeepSWE-verbetering is relevant wanneer een agent een repository moet inspecteren, wijzigingen moet plannen, tools moet gebruiken en storingen over vele stappen moet repareren. Ontwikkelaars kunnen deze upgrade vergelijken met de GPT-6 Astra API in CometAPI wanneer ze beslissen of de moeilijkste taken een model met hogere kost rechtvaardigen.
Dit is belangrijker dan een korte codebenchmark, omdat langlopende codeagents kosten opstapelen door herhaalde reasoning, tool-calls, bestandslezingen, patches en hergebruik van context. GPT-6.1 Sol verbetert zowel taakafronding als economie van herhaalde context zonder de standaard $2/$10 tokenprijs te verhogen.
De GPT-6 Sol API in CometAPI blijft nuttig voor bestaande deployments en biedt een OpenAI-compatibele route voor codeer- en agentische workloads.
AI Agents and Business Workflows: Automation and Computer Use
Ja, en de verbetering gaat verder dan coderen. AutomationBench evalueert of een agent end-to-end workflows kan voltooien met veel tools over sales, marketing, operations, support, finance en HR.
Het resultaat voor de matched-medium AutomationBench in de benchmarksamenvatting is relevant voor toolzware bedrijfsworkflows. Het blijft een benchmarkresultaat en geen garantie van succes in de eigen toolstack van een bedrijf. De vergelijking omvat ook de Claude Opus 5.5 API in CometAPI; evalueer alle kandidaten met dezelfde tools en succescriteria voordat je er één selecteert.
Voor computergebruik gebruikt het OSWorld-resultaat hierboven de offline set en gedeeltelijke beloning. Een hogere score voor gedeeltelijke beloning betekent niet noodzakelijk dat elke taak end-to-end is voltooid. Browserstatus, permissies, herstelgedrag en de kwaliteit van de toolintegratie beïnvloeden nog steeds de uitkomsten in deployment.
Professional Documents and Science: Broader Complex-Task Capability
GPT-6.1 Sol drijft de Sol-tier ook verder naar professioneel kenniswerk. OpenAI evalueert complexe documentbegrip met GDP.pdf, waar modellen realistische vragen beantwoorden op basis van PDF’s met tabellen, grafieken, diagrammen, dichte opmaak en kleine lettertjes, over velden zoals finance, healthcare en law.
GDP.pdf levert bewijs voor professionele PDF-analyse voorbij gewone tekst-only vraagbeantwoording. Zie het resultaat in de lanceringsaankondiging als een evaluatie van documentbegrip, niet als een garantie dat elke grafiek, voetnoot of gescande pagina correct wordt geïnterpreteerd.
Het Terminal-Bench Science-resultaat in de officiële benchmarksamenvatting bestrijkt workflows zoals data-analyse, simulatie en stellingbewijzen. Een nuttige lokale evaluatie moet de correctheid en reproduceerbaarheid van de uiteindelijke output scoren, terwijl totale tool- en modelkosten worden gemeten.
Dit betekent niet dat GPT-6.1 Sol Astra universeel vervangt. OpenAI positioneert Astra nog steeds als zijn model met de hoogste capaciteit voor het moeilijkste end-to-end werk. De belangrijke verandering is dat de prestatiekloof tussen Sol en Astra kleiner wordt, terwijl hun tokenprijskloof groot blijft.
Factuality and Agent Reliability: Fewer Errors and Better Failure Handling
De data van OpenAI wijzen in die richting, al moet de evaluatie niet worden geïnterpreteerd als een universele hallucinatiesnelheid.
De officiële aankondiging rapporteert direct een factualiteitsverbetering bij lage inspanning: antwoorden met fouten dalen van 11,4% met GPT-6 Sol naar 7,7% met GPT-6.1 Sol, een daling van 3,7 procentpunt, of ongeveer 32% relatieve reductie. Deze geselecteerde conversaties veroorzaakten eerder fouten; de cijfers zijn geen universele hallucinatiesnelheid.
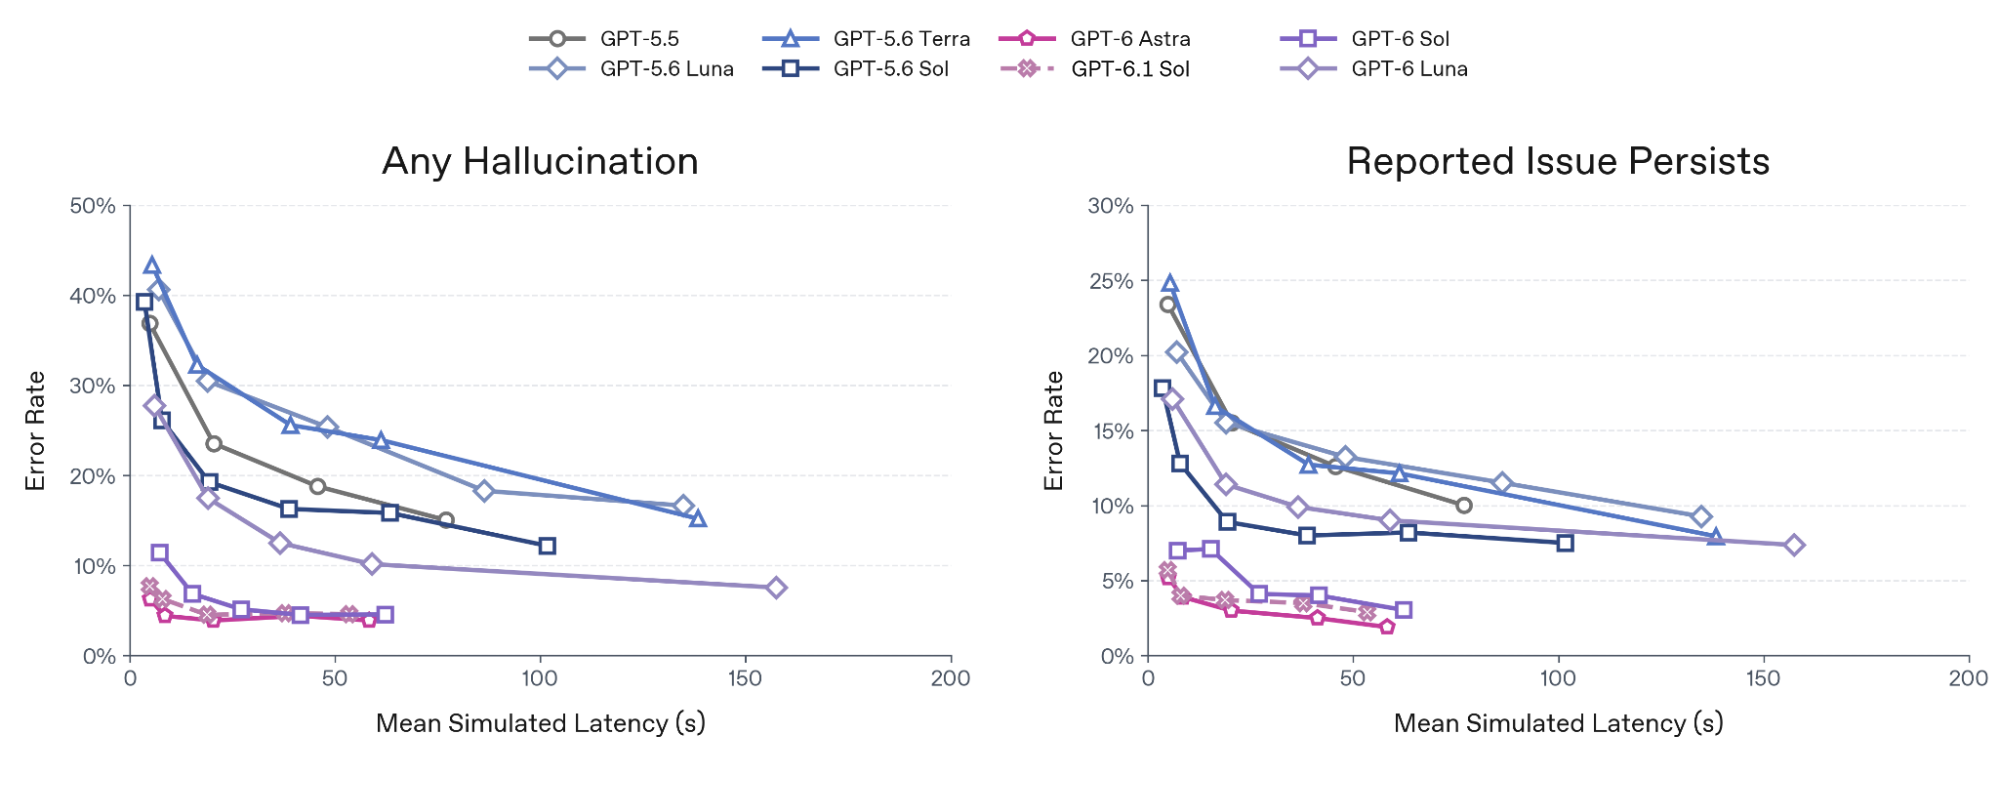
De originele grafiek hierboven is direct uit de OpenAI system-card PDF gehaald zonder hertekenen. Hij toont geselecteerde evaluaties van moeilijke conversaties tegen gesimuleerde latency; de twee panelen meten elke hallucinatie en de persistentie van het gerapporteerde probleem. Het mag niet worden gelezen als een productiewijde foutschatting.
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
De GPT-6 Luna API in CometAPI is een andere kosten-georiënteerde optie, maar het broken-search-resultaat hier illustreert waarom een agent moet worden getest op foutafhandeling én succesvolle toolexecutie.
Dit zijn doelbewust adversariële evaluaties en geen representatieve productiestoringspercentages. Ze zijn nuttig als bewijs dat GPT-6.1 Sol beter herkent wanneer tools niet beschikbaar of kapot zijn, in plaats van zelfverzekerd door te gaan met niet-ondersteunde claims.
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
Voor een nieuwe complexe workflow is GPT-6.1 Sol een sterke kandidaat voor evaluatie. Voor een stabiele GPT-6 Sol-deployment: upgrade alleen wanneer gemeten verbeteringen de migratie rechtvaardigen. De gedeelde contextlimiet en basis-tokenprijzen maken een eerlijke vergelijking mogelijk, maar publieke benchmarks kunnen niet beslissen of je eigen applicatie sneller, betrouwbaarder of goedkoper wordt.
When Upgrading Is Worth Testing
Geef prioriteit aan een proef wanneer repository-schaal coderen, meerstaps bedrijfsautomatisering, computergebruik of moeilijke documentanalyse een substantieel deel van je workload vormen. De gerapporteerde verbeteringen in de voorgaande sectie zijn relevant voor deze use-cases. Zie ze als redenen om te testen, niet als een garantie dat je productiesucces met hetzelfde bedrag stijgt.
Toepassingen met herhaalde context zijn een andere nuttige test. Het lagere cached-readtarief kan het inputdeel van de rekening verminderen wanneer requests daadwerkelijk een stabiele prefix hergebruiken. Als de meeste uitgaven komen van gegenereerde tokens, tools of mislukte pogingen, kan een cachedkorting op zich weinig effect hebben. Vergelijk totale kosten per geaccepteerd resultaat, inclusief retries en beoordelingstijd.
When Keeping GPT-6 Sol Is Reasonable
Behoud GPT-6 Sol wanneer het al voldoet aan je doelen voor kwaliteit, latency en budget en het nieuwere model geen materieel voordeel oplevert in een representatieve evaluatie. Een werkende integratie heeft ook waarde: vervang geen stabiele route uitsluitend omdat de modelnaam nieuwer is.
Compatibiliteit kan doorslaggevend zijn. GPT-6 Sol ondersteunt reasoning none; GPT-6.1 Sol begint bij low. Een applicatie die Sol Chat Completions function calling bij none gebruikt, moet zijn toolloop naar Responses verplaatsen om 6.1 Sol te gebruiken. Audit ook samplingparameters en responsparsing. Dit zijn migratiewijzigingen, geen swap alleen op model-ID. Zie OpenAI migration guidance.
How to Make the Upgrade Decision
Maak een vaste evaluatieset met routinetaken, moeilijke gevallen en toolstoringen uit je beoogde workflow. Houd taakdefinities, toolpermissies en acceptatiecriteria consistent. Vergelijk een gevalideerde Sol-baseline met een geldige 6.1 Sol-configuratie; registreer reasoning-instellingen expliciet in plaats van te doen alsof none en low equivalent zijn.
- Quality: meet geaccepteerde completions, feitelijke correcties, ongeldige tool-calls en menselijke beoordelingsinspanning.
- Speed: vergelijk p50/p95 end-to-end latency, inclusief retries en toowachten.
- Cost: registreer ongecachete input, cached reads, cache writes, output-/reasoningtokens, toolkosten en engineeringinspanning.
- Rollout: begin met een kleine traffic-slice, behoud een Sol-fallback, en breid pas uit wanneer vooraf gedefinieerde drempels zijn gehaald.
Praktische aanbeveling: kies GPT-6.1 Sol wanneer de proef betere economie per geaccepteerde taak oplevert of een benodigde capaciteitswinst zonder onaanvaardbare regressies. Houd GPT-6 Sol voor routes waar compatibiliteit en bewezen resultaten zwaarder wegen dan de gemeten winst. Een gemengde deployment is redelijk wanneer slechts sommige taakklassen verbeteren. Dit zijn workloadgebaseerde aanbevelingen, geen claim dat één model universeel wint.
How Do You Migrate From GPT-6 Sol to GPT-6.1 Sol?
Op het eenvoudigste niveau verandert de modelidentifier van gpt-6-sol naar gpt-6.1-sol.
Een Responses API-request kan er zo uitzien:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyseer deze repository en identificeer de oorzaak van de falende tests."
)

print(response.output_text)
Het wijzigen van de modelidentifier is slechts de eerste stap. GPT-6.1 Sol ondersteunt low, medium, high, xhigh en max, terwijl GPT-6 Sol daarnaast none ondersteunt. Verwijder elke expliciete none-instelling en kies een toegestane inspanning. Applicaties die tools gebruiken hebben ook Responses API nodig: GPT-6.1 Sol Chat Completions ondersteunt geen tool-calling, terwijl GPT-6 Sol Chat Completions function calling alleen ondersteunt met none. De officiële modelkolommen in de specificatietabel documenteren deze endpointbeperkingen.
Teams moeten workflows die gevoelig zijn voor latency, tool-calling, promptcaching, gedrag bij lange context en logica die expliciet reasoning.effort="none" verzendt, opnieuw testen.
Dit voorbeeld richt zich direct op OpenAI met gebruik van OPENAI_API_KEY; het is geen geverifieerd CometAPI-endpointvoorbeeld. Houd je GPT-6 Sol-route beschikbaar tijdens een gefaseerde uitrol, registreer taalsucces en p95-latency, en rol terug als de acceptatiecriteria van je applicatie niet worden gehaald.
Which GPT-6.1 Sol Workloads Benefit Most From the Upgrade?
| Workload | GPT-6.1 Sol Advantage |
|---|---|
| Coding agents | Hogere DeepSWE-prestaties |
| Repository-scale debugging | Betere software engineering over lange horizon |
| Browser/computer agents | +7 punten op OSWorld 2.0 |
| Enterprise automation | Hogere AutomationBench-prestaties |
| Repeated-context agents | 50% goedkoper cached input |
| Complex PDF analysis | Near-Astra prestaties voor professionele documenten |
| Scientific workflows | Meer dan 2x GPT-6 Sol-score in OpenAI’s Terminal-Bench Science-evaluatie |
| Fact-sensitive workflows | Lager factualiteitsfoutpercentage op moeilijke prompts |
| Tool-heavy agents | Beter gedrag wanneer tools falen |
GPT-6 Sol blijft nuttig waar bestaande integraties al stabiel zijn of waar ontwikkelaars specifiek de none reasoning-instelling nodig hebben. Voor nieuwe deployments die draaien om agents, coderen, computergebruik of workflows met herhaalde context verandert GPT-6.1 Sol de kosten-prestatieverhouding zonder de normale input/output-tokenprijs te wijzigen.
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
Voor ontwikkelaars die al gebruikmaken van de GPT-6 Sol API in CometAPI, kan upgraden naar GPT-6.1 Sol worden afgehandeld als een relatief kleine migratie in plaats van een volledige herschrijving van de integratie.
GPT-6.1 Sol is nu beschikbaar via CometAPI met de modelidentifier gpt-6.1-sol. CometAPI toont momenteel een startprijs voor short-context input van $1,60 per miljoen tokens, vergeleken met OpenAI’s officiële $2,00-tarief, terwijl outputpricing begint bij $8,00 per miljoen tokens. Dit houdt het nieuwere Sol-model in dezelfde kortingsstructuur als GPT-6 Sol en geeft ontwikkelaars toegang tot zijn sterkere prestaties in coderen, agents en computergebruik.
Omdat CometAPI een OpenAI-compatibele interface biedt, kunnen bestaande GPT-6 Sol-applicaties doorgaans dezelfde SDK-structuur en requestflow behouden terwijl ze de model-ID wisselen naar gpt-6.1-sol. CometAPI biedt ook tools om modellen te vergelijken, prompts te testen, workloadkosten te schatten en migratiegedrag te inspecteren vóór productie-uitrol.
Een veiliger upgradeproces is om eerst dezelfde representatieve prompts uit te voeren tegen GPT-6 Sol en GPT-6.1 Sol, en vervolgens outputkwaliteit, latency, toolgedrag en totale kosten te vergelijken. Dit is vooral belangrijk voor applicaties die afhankelijk zijn van reasoning-instellingen, gestructureerde outputs, tool-calls of langlopende agents, omdat modelcompatibiliteit geen identiek gedrag op elke workload garandeert.
Voor teams met workloads met herhaalde context of agentzware workloads kan de nieuwere route ook de economie verbeteren. CometAPI prijst GPT-6.1 Sol short-context cache reads momenteel op $0,08 per miljoen tokens, tegenover OpenAI’s officiële $0,10-tarief, terwijl short-context input- en outputtarieven 20% onder de officiële prijzen liggen.
In de praktijk kan CometAPI de GPT-6 Sol → GPT-6.1 Sol-transitie tot een driestappenproces maken:
- Vervang
gpt-6-soldoorgpt-6.1-sol. - Benchmark dezelfde productieprompts en agentworkflows vóór het overschakelen van verkeer.
- Verplaats workloads geleidelijk zodra outputkwaliteit, toolgedrag, latency en kosten aan je eisen voldoen.
Deze aanpak stelt ontwikkelaars in staat GPT-6.1 Sol te adopteren zonder hun applicatie rond een nieuwe API-stack te herbouwen, terwijl ze nog steeds de gedragsverschillen valideren die door het nieuwere model worden geïntroduceerd.
Conclusion
GPT-6 Sol is niet technisch verouderd. Het behoudt hetzelfde contextvenster van 1,05M, outputplafond van 128K, gestructureerde outputs, image input en $2/$10 Standard-prijzen. De none reasoning-optie kan ook belangrijk zijn voor bestaande integraties. De upgradebeslissing moet draaien om gemeten taakuitkomsten en compatibiliteit, niet om de versie alleen.
De documentatie van OpenAI voor GPT-6 Sol wijst ontwikkelaars echter nu op GPT-6.1 Sol als het nieuwere Sol-model.
Voor de meeste complexe workloads is de kernvraag dus niet of GPT-6.1 Sol een groter contextvenster of een hogere tokenprijs heeft—dat is niet zo. De vraag is of hogere taalsuccessen, goedkopere cache-reads, verbeterde factualiteit en sterker agentgedrag het wijzigen van de modelidentifier en het hertesten van de workload rechtvaardigen.
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?
Nee. Audit eerst het endpoint en de requestvelden, verplaats vervolgens de toolloop naar Responses API en test het parsen van tool-calls, argumentvalidatie, retries en foutafhandeling. Voer een canary uit op representatieve taken voordat je het verkeer verhoogt; een succesvolle text-only request verifieert geen werkende toolloop.
Is GPT-6.1 Sol cheaper in real workloads?
Log cached en ongecachete inputtokens, cache writes, reasoning- en outputtokens, verwerkingsmodus en toolkosten. Vergelijk kosten per geaccepteerde taak in plaats van alleen de prijs van cached tokens. Stabiele prefixen helpen alleen wanneer requests daadwerkelijk de cache raken, en langere toollussen of mislukte pogingen kunnen cachebesparingen tenietdoen.
How should you test GPT-6.1 Sol before switching from GPT-6 Sol?
Gebruik een vaste set productielijke taken en registreer succesvolle afronding, feitelijke correcties, ongeldige tool-calls, p50/p95 latency en totale kosten. Definieer acceptabele drempels vóór het testen. Houd een modelrouterings-rollbackpad paraat en breid verkeer pas uit nadat de nieuwe configuratie aan die drempels voldoet.
How do you test GPT-6.1 Sol with PDFs?
Bouw een kleine corpus met dichte tabellen, voetnoten, grafieken en gescande pagina’s die representatief zijn voor de beoogde workflow. Stel vragen met verifieerbare antwoorden en vereis pagina- of tabelbewijs. Scoor berekeningsnauwkeurigheid, ontbrekende kanttekeningen en niet-ondersteunde antwoorden afzonderlijk; behoud menselijke review voor outputs waarvan fouten materiële gevolgen hebben.