
Samenvatting
GPT-6 Astra boekt uitzonderlijk sterke topprestaties. De grootste winsten verschijnen wanneer redeneren moet worden omgezet in actie: terminalwerk, softwaregebruik, automatisering, long-context retrieval, wetenschappelijke workflows en cyberbeveiliging. Op reeds verzadigde academische tests is de verbetering ten opzichte van de vorige OpenAI-generatie vaak veel kleiner.
Het model combineert een contextvenster van 1,050,000 tokens met uitgebreide toolondersteuning. OpenAI’s gepubliceerde uitvoeringsbenchmarks suggereren dat de praktische upgrade het sterkst is bij langlopende trajecten, maar harnasontwerp, redeneerinspanning, latentie en tooltoegang beïnvloeden het resultaat in belangrijke mate.
Belangrijkste punten
- Astra’s duidelijkste winst zit in agent-gestuurde uitvoering, niet in elke vorm van vraagbeantwoording.
- Terminal-Bench, AutomationBench, computergebruik en databasemigratie laten aanzienlijk grotere sprongen zien dan GPQA of DeepSWE.
- Het ARC-AGI-3-resultaat laat zien dat modelstaat, contextbeheer en het evaluatieharnas de eindscore kunnen domineren.
- Een groot contextvenster is alleen relevant als informatie nabij de limiet terugvindbaar blijft; MRCR is informatiever dan alleen de geadverteerde capaciteit.
- Hogere tokenprijzen betekenen niet automatisch hogere taak kosten als het model minder tokens, rondes, retries of menselijke correcties nodig heeft.
- Productiebeslissingen moeten slagingspercentage, doorlooptijd, totale kosten, toolbetrouwbaarheid en correctielast samen vergelijken.
GPT-6 Astra in een oogopslag
OpenAI specificeert tot 128,000 output tokens, tekst- en beeldinvoer, tekstuitvoer en redeneerinspanning van low tot en met max. Deze specificaties maken grote, meerstaps-workflows mogelijk, maar ze bewijzen niet dat een model het juiste bewijs zal vinden of een taak betrouwbaar zal voltooien.
| Officiële specificatie | GPT-6 Astra in CometAPI | Praktische betekenis |
|---|---|---|
| Model-ID | gpt-6-astra | Stabiele identifier voor API-routing |
| Contextvenster | 1,050,000 tokens | Ondersteunt grote repositories, archieven en agentgeschiedenis |
| Maximale output | 128,000 tokens | Maakt grote rapporten, patches en gestructureerde artefacten |
| Kennisafkapdatum | April 30, 2026 | Latere feiten vereisen tools of aangeleverde bronnen |
| Invoer | Tekst en afbeeldingen | Ondersteunt documenten, screenshots, diagrammen, gemengde data |
| Uitvoer | Tekst | Produceert proza, code en gestructureerde tekst |
| Redeneerinspanning | low, medium, high, xhigh, max | Ruilt latentie en kosten voor diepere zoekruimte |
| Agent-capaciteiten | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Maakt end-to-end workflows mogelijk i.p.v. geïsoleerde antwoorden |
| OpenAI Standaard-invoer | $10 per miljoen tokens | Invoergrootte en cachehergebruik beïnvloeden totale kosten |
| OpenAI gecachete invoer | $1 per miljoen tokens | Geldt wanneer de promptprefix uit cache wordt hergebruikt |
| OpenAI cache-schrijfbewerkingen | $12.50 per miljoen tokens | Gefactureerd tegen 1.25× de ongecachete invoerprijs |
| OpenAI Standaard-uitvoer | $50 per miljoen tokens | Uitgebreide output kan de taak kosten domineren |
| Aanvragen boven 272K invoertokens | Invoer- en cacherates ×2; outputrate ×1.5 | De hogere rates gelden voor de volledige aanvraag |
Een contextlimiet meet capaciteit, niet bruikbare recall. Een tool-lijst meet beschikbaarheid, niet succesvolle uitvoering. Benchmarks zijn nodig om te testen of die specificaties vertaald worden naar afgerond werk.
Wat laten GPT-6 Astra-benchmarks zien?
De portfolio toont een ongelijk patroon. Astra gaat op sommige academische en software-redeneertests nauwelijks verder dan Sol, maar levert dubbele-cijferwinsten op terminalwerk, automatisering, databasemigratie, visuele interactie, long-context retrieval en geavanceerde wiskunde.
| Gepubliceerd benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Er ontstaan drie clusters. Ten eerste wijzen de 1,4-puntgaten op DeepSWE en GPQA op beperkte extra vooruitgang bij taken waar sterke modellen al goed presteren. Ten tweede tonen winsten boven 20 punten op Terminal-Bench, AutomationBench, databasemigratie en million-token retrieval een veel grotere verandering in uitvoering. Ten derde is ARC-AGI-3 een uitschieter waarvan de interpretatie afhangt van het harnas.
Onafhankelijke testresultaten
Artificial Analysis rapporteert Astra en Sol rond 61 op de Intelligence Index, terwijl het een veel duidelijkere winst laat zien op de Coding Agent Index. Dit bevestigt onafhankelijk het patroon in OpenAI’s data: de grootste verbetering concentreert zich in agent-gestuurde uitvoering.
Op maximale inspanning in het Codex-harnas gebruikt Astra naar verluidt ongeveer een derde zoveel tokens als Sol op de Coding Agent Index. Het tokengebruik op de Intelligence Index daalt slechts met ongeveer 10%. Omdat Astra’s per-token-tarief hoger ligt, creëren deze twee efficiëntieprofielen verschillende economics.
| Onafhankelijke evaluatie | Geobserveerd resultaat | Productie-interpretatie |
|---|---|---|
| Intelligence Index | Nauwelijks scheiding t.o.v. Sol | Brede redenering rechtvaardigt mogelijk geen grote prijs premie |
| Coding Agent Index | Duidelijke agentische verbetering | Minder tokens kunnen hogere tokenprijs compenseren |
| AA-Omniscience | Hallucinaties dalen van 92% naar 51% bij max inspanning | Betere abstinentie kan tellen voor research- en retrievalsystemen |
| Langlopende kenniswerk | Gemengde vooruitgang over taken | Lokale evaluatie blijft noodzakelijk |
Geen enkele onafhankelijke benchmark certificeert productie-feitelijkheid of -veiligheid. Teams moeten apart scoren: juiste antwoorden, gerechtvaardigde onzekerheid, ongefundeerde claims en het niet volgen van bronbeperkingen.
Waarom is Astra beter geschikt voor langlopende agent-gestuurde taken?
GPT-6 Astra voegt drie controls toe die zijn ontworpen voor werk dat verandert terwijl het draait. Langdurige betrouwbaarheid hangt ook af van het hele contextsysteem: het contextvenster bepaalt capaciteit; compaction regelt hoe ouder materiaal wordt gecondenseerd; persisted reasoning draagt relevante modelstaat over; retrieval houdt eerdere bewijzen doorzoekbaar; en de applicatie moet belangrijke tooloutputs, testresultaten, mislukte aanpakken en gebruikersvereisten bewaren. Deze mechanismen moeten samen met het agent-harnas worden getest.
- Asynchrone toolaanroepen: Astra kan onafhankelijk doorredeneren of andere tools aanroepen terwijl een applicatie een langlopende tool uitvoert.
- Sturing midden in een beurt: een applicatie kan via WebSocket een correctie of nieuwe vereiste sturen zonder voltooid werk te verwerpen.
- Redeneringsaanpassing midden in een gesprek: een configuratie-update kan de redeneerinspanning verhogen of verlagen terwijl de gecachete promptprefix behouden blijft.
Waar GPT-6 Astra daadwerkelijk verbetert
Agent-gestuurd coderen: terminalwerk is de grotere upgrade
Terminal-Bench 4.0 evalueert of een agent moeilijke terminaltaken kan doorwerken in plaats van alleen een geïsoleerd code-antwoord te genereren. Astra haalt 57.9%, 20.6 procentpunt boven Sol en 2.1 punt boven Fable. Dat is een substantiële generatie-op-generatie verbetering voor OpenAI, maar een veel kleinere voorsprong op een andere frontier agentische systeem.
DeepSWE vertelt een ander verhaal: 74.1% voor Astra en 72.7% voor Sol. Het gat van 1.4 punt waarschuwt tegen generaliseren vanaf één codebenchmark. Astra lijkt vooral te winnen wanneer coderen omgevingsinteractie, iteratie, staatspreservatie en verificatie vereist.
Database Migration Tasks versterkt die interpretatie. Het resultaat van 63.9% ligt 21.2 punten boven Sol en 6.1 punten boven Fable. Migratiewerk combineert codebegrip, toolgebruik, sequentiebouw en operationeel oordeel—het soort samengestelde workflow waar kleine redeneringsverbeteringen kunnen optellen tot veel grotere afrondingswinsten.
Voor coding agents: evalueer model en harnas samen. Repository-instructies, terminaltools, retry-gedrag, contextbehoud en testuitvoering dragen allemaal bij aan de gemeten uitkomst.
Computergebruik: slagingspercentage en doorlooptijd zijn allebei belangrijk
Op Agents’ Last Exam scoort GPT-6 Astra 59.3%, vergeleken met 53.6% voor GPT-5.6 Sol: een winst van 5.7 procentpunt. Dit voegt een bredere agent-taakresultaat toe aan de OSWorld 2.0- en ScreenSpot-Pro-scores in het benchmarkoverzicht hierboven.
Naast nauwkeurigheid voegt de OSWorld-runtimevergelijking nog een praktische dimensie toe: OpenAI meldt ongeveer 40 minuten per taak voor Astra versus circa 75 minuten voor Sol, of ongeveer 47% minder doorlooptijd terwijl het slagingspercentage ook stijgt.
Een agent die iets vaker slaagt en veel sneller afrondt, kan een grote throughput-verbetering leveren. Inkooptests moeten daarom slagingspercentage, doorlooptijd, toolaanroepen, retries en menselijke interventies rapporteren—niet alleen nauwkeurigheid.
Automatisering en professioneel werk
AutomationBench stijgt van 18.1% naar 41.4%, een winst van 23.3 punten. De absolute score is nog ver van perfect, maar de verschuiving in het faalprofiel is betekenisvoller dan een éénpuntbeweging nabij verzadiging. Op BenchCAD haalt Astra 95.9%, 12.6 punten boven Sol en 11.6 punten boven Fable.
Deze resultaten ondersteunen een specifieke claim: Astra is beter in het omzetten van instructies in reeksen gevalideerde acties. Zij bewijzen geen gelijke winsten voor elke bedrijfsworkflow. Een productieproces kan authenticatiestappen, propriëtaire interfaces, ambigue policies of dataformaten introduceren die in de benchmark ontbreken.
Wetenschap
Wetenschap is een van Astra’s duidelijkste capaciteitswinsten. Op FrontierMath Tier 4 v2 haalt Astra 97.6%, vergeleken met 83.0% voor Sol en 87.8% voor Fable. De voorsprong van 14.6 punten op Sol is substantieel, al dekt de benchmark een geselecteerde taakdistributie en niet de volledige wetenschappelijke workflow.
Cyberbeveiliging
Cyberbeveiliging is een tweede grote winst, met hogere inzet dan een gewone leaderboard-beweging. Op ExploitBench over juni t/m augustus 2026 scoort Astra 39.0% tegenover 5.5% voor Sol. OpenAI rapporteert dat deze nieuwere set kwetsbaarheden uit de drie voorafgaande maanden targette om historische blootstelling te beperken. In OpenAI’s cyberbeveiligingsevaluatie toonde Astra de mogelijkheid om twee voorheen onbekende zero-day-kwetsbaarheden te ontdekken en te exploiteren tijdens gecontroleerde tests. Dit is belangrijk omdat de evaluatie was ontworpen rond recent bekendgemaakte kwetsbaarheden in plaats van lang bekende beveiligingsissues, waardoor de kans afneemt dat prestatie simpelweg voortkomt uit gememoriseerde voorbeelden. Het resultaat droeg bij aan Astra’s bereiking van OpenAI’s Critical cybersecurity capability-drempel en verandert daarmee de vereiste waarborgen voor uitrol. De betekenis is niet dat Astra autonoom onbeperkte cyberoperaties kan uitvoeren, maar dat het capaciteitsniveau de deployment-vereisten wijzigt. Systemen met sterkere kwetsbaarheidsdetectie en -exploitatie vereisen strengere toegangscontrole, monitoring, sandboxing en menselijke reviewmechanismen.
Langlopende taken: het contextvenster is niet het hele verhaal
Astra’s contextvenster van 1,050,000 tokens beschrijft capaciteit, niet continuïteit. Langdurige prestaties hangen ook af van compaction, persistente staat, doorzoekbare eerdere context, behouden redeneringsstaat en het bewaren van tooloutputs. In MRCR v2 scoort Astra 100.0% bij 256K–512K en 96.3% bij 512K–1M, terwijl Sol 91.5% en 73.8% noteert. De kloof van 22.5 punten in het langste bereik laat zien dat bruikbare retrieval nabij de limiet belangrijker is dan alleen de geadverteerde capaciteit.
MRCR blijft een synthetische retrievaltest, dus productie-evaluatie moet het bewijs behouden dat samenvattingen vaak verliezen: waarom een eerdere fix faalde, het gedrag van een specifiek component, testresultaten, historische vereisten en details begraven in tooloutput. Repositories en researcharchieven moeten ook worden getest met dubbele namen, kruisverwijzingen, verouderde policies, tegenstrijdige bronnen en lange afleidende passages. Dit scheidt ruwe contextcapaciteit van het contextbehoud en retrievalgedrag dat een langlopende agent daadwerkelijk nodig heeft.
Contextbehoud: waarom Astra verschilt van traditionele long-context systemen
Traditionele long-context workflows volgen meestal een patroon:
context → compaction → summary → continue
Deze aanpak vermindert het tokengebruik, maar introduceert een cruciaal risico: belangrijke tusseninformatie kan verdwijnen tijdens het samenvatten.
De verloren informatie is vaak niet het uiteindelijke antwoord zelf, maar de operationele details die nodig zijn voor toekomstige beslissingen:
- waarom een eerdere fix faalde;
- welke component abnormaal gedrag vertoonde;
- welk testresultaat de implemen tatierichting veranderde;
- welke gebruikersvereiste later werd toegevoegd;
- welke tooloutput belangrijk bewijs bevatte.
GPT-6 Astra pakt deze beperking aan door contextbehoud en retrievalmechanismen te combineren binnen langlopende agent-workflows.
In plaats van alleen te vertrouwen op gecomprimeerde samenvattingen kan het systeem belangrijke notities bewaren, eerdere informatie ophalen wanneer nodig en continuïteit houden tussen meerdere toolinteracties.
Voor coding agents zoals Codex betekent dit dat een lange debugtaak het volgende kan behouden:
- eerdere mislukte experimenten;
- repository-wijzigingen;
- testoutputs;
- architectuurbeslissingen;
- openstaande issues.
Daarom is de waarde van Astra’s 1M-token contextvenster niet alleen de hoeveelheid informatie die het kan ontvangen, maar of het systeem de juiste informatie kan bewaren en terugvinden na uren interactie.
Redeneren en interpretatie
ARC-AGI-3: het harnas is onderdeel van het resultaat
ARC-AGI-3 biedt de duidelijkste demonstratie dat een frontier benchmark een systeem kan meten in plaats van een geïsoleerd model. ARC Prize rapporteert 62.7% met het Standard-harnas bij max inspanning en 99.9% met Provider Adapter bij high inspanning.
| ARC Prize-evaluatie | Standaardharnas | Provider Adapter | Adapterwinst |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
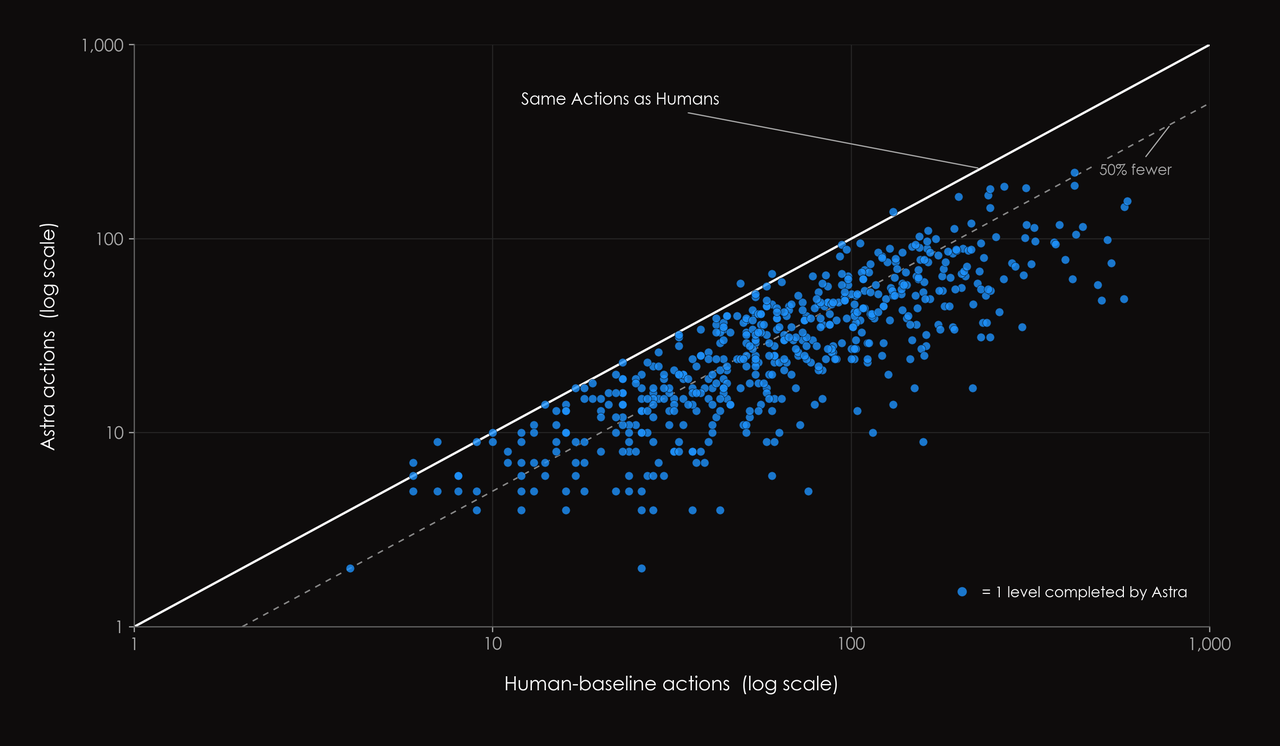
ARC Prize-vergelijking van Astra’s actie-efficiëntie over evaluatieharnassen
De provider-neutrale harnaspolicy vereist dat het model belangrijke informatie in zichtbare staat bewaart. De Provider Adapter behoudt extra redeneringsstaat en gebruikt provider-specifiek contextbeheer. Over gedeelde opgeloste spel-redeneerparen rapporteert ARC Prize 3.66× snellere uitvoering en 49% minder totale tokens met de adapter.
De 99.9%-score meet een specifiek model–provider–adapter-systeem en moet niet worden gezien als een harnas-onafhankelijke maat van ruwe modelintelligentie. Contextarchitectuur is onderdeel van het geëvalueerde systeem.
Redeneerinspanning schaalt niet lineair
De ARC-tabel laat ook zien dat maximale inspanning niet altijd de hoogste score oplevert. High inspanning bereikt 99.9% met de Provider Adapter, terwijl max 98.6% haalt. In het Standaardharnas presteert max het best.
OpenAI merkt op dat launch-tabelfiguren doorgaans de best geobserveerde redeneerinstelling gebruiken. Die aanpak schat een prestatiedak, maar identificeert niet de beste productieconfiguratie. Teams moeten meerdere inspanningsniveaus testen en de marginale kwaliteitswinst per extra seconde en dollar berekenen.
Wiskunde en academische redenering
FrontierMath Tier 4 v2 stijgt van 83.0% naar 97.6%, een winst van 14.6 punten. Dat is een grote benchmarkverbetering, maar geen bewijs dat frontier-wiskunde is opgelost. De evaluatie dekt een geselecteerde taakdistributie en meet niet elke fase van wiskundig onderzoek, inclusief probleemselectie, formele bewijsverificatie, langetermijn-programmabouw of adversariële peer review.
GPQA Diamond toont het tegenovergestelde patroon: 96.0% voor Astra, 94.6% voor Sol, 93.7% voor Fable en 95.3% voor Gemini 3.8 Flash. De modellen clusteren krap nabij het plafond. Het rapporteren van het 1.4-punt verschil Astra–Sol is correct, maar het een brede intelligentierevolutie noemen zou de bewijslast overschatten.
Kritische capaciteit + waarborgen
| Cybersecurity-evaluatie | Astra | Sol | Absolute winst |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, juni–augustus 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI maakte ExploitBench (juni–augustus 2026) uit kwetsbaarheden die in de drie voorafgaande maanden zijn bekendgemaakt, waardoor de kans afneemt dat historische blootstelling het resultaat opblaast. Astra scoort 39.0% op deze set versus 5.5% voor Sol, en OpenAI meldt dat Astra twee voorheen onbekende zero-day-kwetsbaarheden vond en exploiteerde. Deze resultaten droegen bij aan Astra’s status als OpenAI’s eerste breed uitgerolde model dat de Critical cybersecurity capability-drempel haalt, wat direct invloed had op safeguards en toegangsbeleid.
Scores nabij verzadiging lezen
Scores boven 90% vereisen voorzichtiger taal dan middenbereikresultaten. Van 50% naar 60% gaat tien extra taken per honderd vooruit. Van 95% naar 96% gaat slechts één extra taak per honderd vooruit, ook al vermindert het de resterende fouttelling van vijf naar vier—een reductie van 20% in fouten. Beide beschrijvingen zijn wiskundig correct, maar ondersteunen zeer verschillende koppen.
Het omgekeerde voorbehoud geldt voor laag-scorende benchmarks. Een stijging van 18.1% naar 41.4% blijft ver onder betrouwbare autonome werking, maar meer dan verdubbelt het aantal succesvolle cases en kan een begeleide workflow transformeren. De absolute score bepaalt of het systeem klaar is; de omvang van de verbetering geeft aan hoe snel de capaciteit verandert. Productiebeslissingen hebben beide nodig.
Een multidimensionale vergelijking
| Dimensie | Astra | Sol | Fable | Beslissingssignaal |
|---|---|---|---|---|
| Algemene academische redenering | Uitstekend; vaak nabij verzadiging | Kort daarachter | Competitief | Kleine gaten beslissen zelden de uitrol |
| Terminaluitvoering | Topklasse | Grote generatiekloof | Dichte concurrent | Test het volledige coding-harnas |
| Computergebruik | Hoger succes en lagere doorlooptijd | Langzamer en minder accuraat | Onvoldoende vergelijkbare data in lanceringstabel | Meet succes per uur |
| Long-context retrieval | Sterk nabij 1M tokens | Materiële degradatie nabij limiet | Onvoldoende direct vergelijkbare data | Gebruik productie-achtige retrievaltests |
| Redeneringscontrole | low t/m max | Ander inspanningsprofiel | Adaptive-thinking benadering | Tune configuratie, niet alleen modelnaam |
| Cybercapaciteit | Kwalitatief hogere risicoklasse | Lagere gepubliceerde resultaten | Hier niet vergeleken | Waarborgen en toegangsbeleid tellen |
| Token-economie | Hoger tarief; soms minder tokens | Lager tarief | Afhankelijk van workload | Vergelijk kosten per succesvolle taak |
Het resultaat is workload-afhankelijk. Astra is het meest overtuigend wanneer de taak langdurige interactie met tools en omgevingen vereist, herstel na falen, of betrouwbare retrieval over zeer grote contexten. Sol kan economischer blijven voor begrensd werk met bescheiden context en beperkte iteratie. Fable is een dichte concurrent op terminalwerk en leidt sommige externe academische evaluaties, dus een applicatieniveau-benchmark is nuttiger dan een provider-niveau conclusie.
Wie zou GPT-6 Astra moeten gebruiken?
| Use Case | Aanbeveling |
|---|---|
| Eenvoudige classificatie | Niet per se de moeite om Astra te gebruiken |
| Eenvoudige samenvatting | Niet per se de moeite om Astra te gebruiken |
| Standaard RAG | Benchmark eerst kosten vs. prestaties |
| Synthese & analyse van lange documenten | De moeite waard om Astra te testen |
| Agentisch coderen | Sterk aanbevolen om te testen |
| Computergebruik | Sterk aanbevolen om te testen |
| Multi-step automatisering | Sterk aanbevolen om te testen |
| Complex onderzoek | De moeite waard om te testen |
| Scientific computing / gespecialiseerde software | De moeite waard om te testen |
| Cyberbeveiliging | Sterke capaciteiten, maar vereist passende veiligheidsmaatregelen |
| Hoogvolume, eenvoudige taken | Lagere-kostmodellen kunnen kosteneffectiever zijn |
Rechtvaardigen Astra’s prestatiewinsten de hogere prijs?
GPT-6 Astra is aanzienlijk duurder dan GPT-5.6 Sol, maar benchmarkverbeteringen zijn niet gelijkmatig over workloads verdeeld. De prijsvraag kan dus niet worden beantwoord door alleen tokenrates te vergelijken.
| Scenario | Prestatieverbetering | Kostenrechtvaardiging |
|---|---|---|
| Eenvoudige Q&A | Kleine verbetering | Meestal premie niet waard |
| Coding agent | Grote verbetering | Premie kan gerechtvaardigd zijn |
| Long-context analyse | Aanzienlijke verbetering | Afhankelijk van retrievalbehoefte |
| Computergestuurde automatisering | Sterke verbetering | Vaak de moeite waard om te testen |
| Algemene redenering | Beperkte verbetering | Vergelijk kosten zorgvuldig |
Bij OpenAI Standaardtarieven kost GPT-6 Astra $10 per miljoen invoertokens, $1 per miljoen gecachete invoertokens, $12.50 per miljoen cache-schrijftokens en $50 per miljoen uitvoertokens. Standaardinvoer en -uitvoer zijn 2.5× de $4 en $20 tarieven voor GPT-5.6 Sol. Wanneer een aanvraag 272K invoertokens overschrijdt, verdubbelen Astra’s invoer- en cacherates en stijgt de outputrate met 1.5× voor de volledige aanvraag.
De prijs premie past het duidelijkst bij agentisch werk. Astra wint meer dan 20 procentpunt op Terminal-Bench, AutomationBench, databasemigratie en de langste MRCR; onafhankelijke tests rapporteren ook grofweg een derde van het tokengebruik van Sol op de Coding Agent Index. De match is zwakker bij brede redenering, waar de Intelligence Index vrijwel gelijk staat en het tokengebruik slechts ~10% daalt. De koopbeslissing moet daarom de kosten per succesvolle taak vergelijken, inclusief output, cache-activiteit, toolgebruik, doorlooptijd, retries, mislukkingen en menselijke correctie.
Cost per successful task
Cost per successful task = (Input cost + Output cost + Tool cost + Retry cost + Human review cost) / Successful tasks
Expected business cost
Expected business cost = API cost + Tool cost + Retry cost + Human-review cost + Failure cost
De beslismetriek moet totale kosten gedeeld door geslaagde taken zijn, geëvalueerd bij een acceptabele kwaliteitsdrempel—niet de stickerprijs per miljoen tokens.
Hoe developers Astra zouden moeten benchmarken
Publieke leaderboards moeten bepalen wat testwaardig is, niet de definitieve uitrolbeslissing. Bouw een representatieve taakset met routinecases, moeilijke cases, cases met ontbrekende context, toolfouten en adversariële instructies. Gebruik dezelfde productieprompt, permissies, bronbestanden, tijdbudget en acceptatiecriteria voor elk model.
| Evaluatiedimensie | Maat | Waarom het telt |
|---|---|---|
| Taak succes | Acceptatiecriteria behaald | Voorkomt dat overtuigende maar onvolledige antwoorden als succes tellen |
| Betrouwbaarheid | Succesdistributie over herhaalde runs | Legt onstabiele one-off wins bloot |
| Tooluitvoering | Gevérifieerde succesvolle acties | Scheidt toolaanroepen van correcte uitkomsten |
| Feitelijkheid | Ondersteunde feitelijke claims | Meet bewijs kwaliteit en abstinentie |
| Latentie | Median en staart doorlooptijd | Vangt operationele throughput |
| Kosten | Totale kosten per succesvolle taak | Inclusief retries en mislukte pogingen |
| Menselijke inzet | Correcties en reviewminuten | Domineert vaak de echte uitrolkosten |
| Stuurbaarheid | Herstel na veranderde vereisten | Test gedrag van langlopende agents |
De Astra API in CometAPI gebruikt model-ID gpt-6-astra. Een multi-model API maakt het praktisch om dezelfde evaluatie over Astra, Sol, Fable en Gemini te draaien zonder de benchmark te herontwerpen rond de headline-chart van één provider. Routeer veeleisende agentische taken naar het model dat zijn premie verdient en gebruik goedkopere modellen waar het gemeten voordeel verdwijnt.
Conclusie
Astra’s benchmarksheet is indrukwekkend, maar de spectaculairste scores zijn niet automatisch de nuttigste. ARC-AGI-3 demonstreert het potentieel van een provider-specifiek agent-harnas; de Standard-harnas-score laat zien hoe sterk infrastructuur bijdraagt. GPQA en de onafhankelijke Intelligence Index laten zien dat gewone redeneerwinsten bescheiden kunnen zijn. Terminalwerk, automatisering, computergebruik, long-context retrieval, wetenschappelijke workflows en cyberbeveiliging vertellen het belangrijkere verhaal.
De release gaat minder over een chatbot die proportioneel slimmer wordt bij elke vraag en meer over frontier-intelligentie die beter wordt in het afronden van werk. Of die upgrade de moeite waard is om voor te betalen, hangt af van de volledige model-systeemconfiguratie en de economics van succesvolle productietaken.