
TL;DR
Grok 4.7 en Xiaomi MiMo‑V2.6 verschenen met slechts één dag verschil, maar ze vertegenwoordigen twee verschillende benaderingen van frontier‑AI. Grok 4.7 legt de nadruk op een proprietaire, strak geïntegreerde agentstack voor coderen en professioneel kenniswerk, terwijl MiMo‑V2.6‑Pro open gewichten, een groter contextvenster, native multimodaal begrip en agressieve API‑prijzen combineert.
SpaceXAI positioneert Grok 4.7 als zijn frontiermodel voor coderen, agenttaken en kenniswerk met een contextvenster van 500K tokens en configureerbare redeneerinspanning.
Xiaomi positioneert MiMo‑V2.6‑Pro als een 1M‑context multimodale vlaggenschip met open gewichten en ondersteuning voor tekst-, beeld-, audio‑ en videobegrip.
Kort gezegd: Grok 4.7 is het meer verticaal geïntegreerde beheerde‑agentproduct; MiMo‑V2.6‑Pro geeft ontwikkelaars meer controle over de uitrol en veel lagere ruwe tokenprijzen. De beste keuze hangt af van de werkbelasting, niet van één benchmarkscore.
Belangrijkste punten
- Grok 4.7 is gebouwd voor langdurig coderen en professionele agents. In de door SpaceXAI gepubliceerde evaluatie scoort het 46,3% op CursorBench 4.0, 71,0% op DeepSWE v1.1 bij hoge inspanning en 1.657 op AA Briefcase v1.1.
- MiMo‑V2.6‑Pro is uitzonderlijk competitief voor een open model. Xiaomi publiceert de modelgewichten en rapporteert resultaten die in de buurt komen van proprietaire frontier‑systemen op verschillende codeer‑ en agentbenchmarks, maar leverancier‑overstijgende scores zijn niet direct uitwisselbaar.
- MiMo heeft het context‑ en multimodale voordeel. MiMo‑V2.6‑Pro ondersteunt een contextvenster van 1M tokens en begrip van tekst, beeld, audio en video, versus Grok 4.7’s 500K context met tekst‑ en beeldinvoer.
- MiMo is aanzienlijk goedkoper op ruwe API‑tokens. Officiële standaardprijzen zijn $0,435/$0,87 per miljoen niet‑gecachete input/outputtokens voor MiMo‑V2.6‑Pro versus $2/$6 voor Grok 4.7.
- De uitrolarchitectuur is de doorslaggevende trade‑off. Grok biedt de sterkere first‑party gehoste toolstack; MiMo’s open gewichten maken private deployment, aangepaste serving en diepere infrastructuurcontrole mogelijk.
Grok 4.7 vs MiMo‑V2.6‑Pro in één oogopslag
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | September 21, 2026 | September 22, 2026 |
| Access and control | Proprietary API and managed agent ecosystem | Open weights, self-hosting option, and API access |
| Performance evidence | Provider-reported strength in coding and long-running agent tasks; validate on the same task harness | Provider-reported strength across reasoning, coding, and multimodal tasks; validate on the same task harness |
| Distinctive strengths | First-party tools, managed workflows, and web/X-connected agents | Deployment control, 1M-token context, and text/image/audio/video understanding |
| Context window | 500K tokens | 1M tokens |
| Input modalities | Text and image | Text, image, audio, and video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Low to xHigh | Deep reasoning |
| Open weights | No | No |
| Best fit | Managed coding and agent workflows | Private deployment, multimodal input, and lower raw token cost |
Wat is Grok 4.7?
SpaceXAI bracht Grok 4.7 officieel uit op 21 september 2026 als zijn meest capabele model voor coderen en kenniswerk. De lancering is belangrijk omdat pre‑release‑rapportage bevestigde feiten vermengde met gelekte architectuurclaims. De definitieve lanceringsdocumentatie publiceert geen totaal of actief aantal parameters, dus pre‑release‑schattingen van parameters mogen niet als officiële specificaties worden beschouwd.
Volgens de officiële lancering gebruikt Grok 4.7 een nieuwe, grotere basismodel dan Grok 4.6 en werd het getraind met een langere reinforcement‑learningrun die zwaarder weegt naar problemen die vele uren duren om te voltooien.
De modellen optimaliseren verschillende lagen van de stack. Grok 4.7 biedt een rijkere beheerde omgeving rond het model; MiMo‑V2.6‑Pro stelt meer van het model en de uitrollaag bloot aan ontwikkelaars.
Voor prompts boven 200K tokens hanteert SpaceXAI hogere contextprijzen. De gepubliceerde tier is $4 per miljoen inputtokens, $1 per miljoen gecachete inputtokens en $12 per miljoen outputtokens.
Wijzigingen in Grok 4.7
De meest betekenisvolle verandering is het trainingsdoel, niet slechts een hogere benchmarkscore. SpaceXAI zegt dat zijn reinforcement‑learningmix verschoof naar langere taken van meerdere uren, terwijl het model werd getraind om zijn eigen werk zorgvuldiger te verifiëren en om het Grok Bot‑harnas native te begrijpen. Die combinatie richt zich op echte agentuitvoering: status behouden, tools gebruiken, tussentijds werk controleren en coherent blijven tijdens lange taaktrajecten.
Prestaties van Grok 4.7
| Door SpaceXAI gepubliceerde benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
SpaceXAI markeert Grok 4.7 DeepSWE als hoge inspanning. Dit zijn door de leverancier gepubliceerde evaluaties en moeten worden geïnterpreteerd binnen de gedocumenteerde harnas‑ en redeneerinstellingen.
SpaceXAI presenteert de lanceringsgrafieken als web‑native content op de officiële aankondigingspagina; de bovenstaande tabel behoudt de bekendgemaakte benchmarkwaarden zonder een opnieuw getekende grafiek te substitueren.
Wat is Xiaomi MiMo‑V2.6?
Xiaomi bracht MiMo‑V2.6 op 22 september 2026 officieel uit en als open‑source. De familie omvat MiMo‑V2.6‑Pro en MiMo‑V2.6‑Flash, met een Pro‑UltraSpeed‑servingoptie voor latency‑gevoelige workloads. Voor een directe vergelijking met Grok 4.7 is MiMo‑V2.6‑Pro de juiste vlaggenschip‑tegenhanger.
De officiële materialen van Xiaomi documenteren afzonderlijk open gewichten, native multimodale invoer en API‑prijzen. Deze combinatie maakt MiMo‑V2.6 relevant voorbij benchmarkranglijsten.
MiMo‑V2.6 vs MiMo‑V2.5: wat is verbeterd?
Het architecturale kopstuk is niet simpelweg een groter checkpoint. Xiaomi’s publieke release legt sterke nadruk op post‑training en Live RL. Volgens de officiële releasenotes voltooiden Pro en Flash elk 30 reinforcement‑learningstappen en genereerden samen ongeveer 750.000 trajecten; de bekendgemaakte RL‑fasekosten waren ongeveer $2,62 miljoen voor Pro en $850.000 voor Flash.
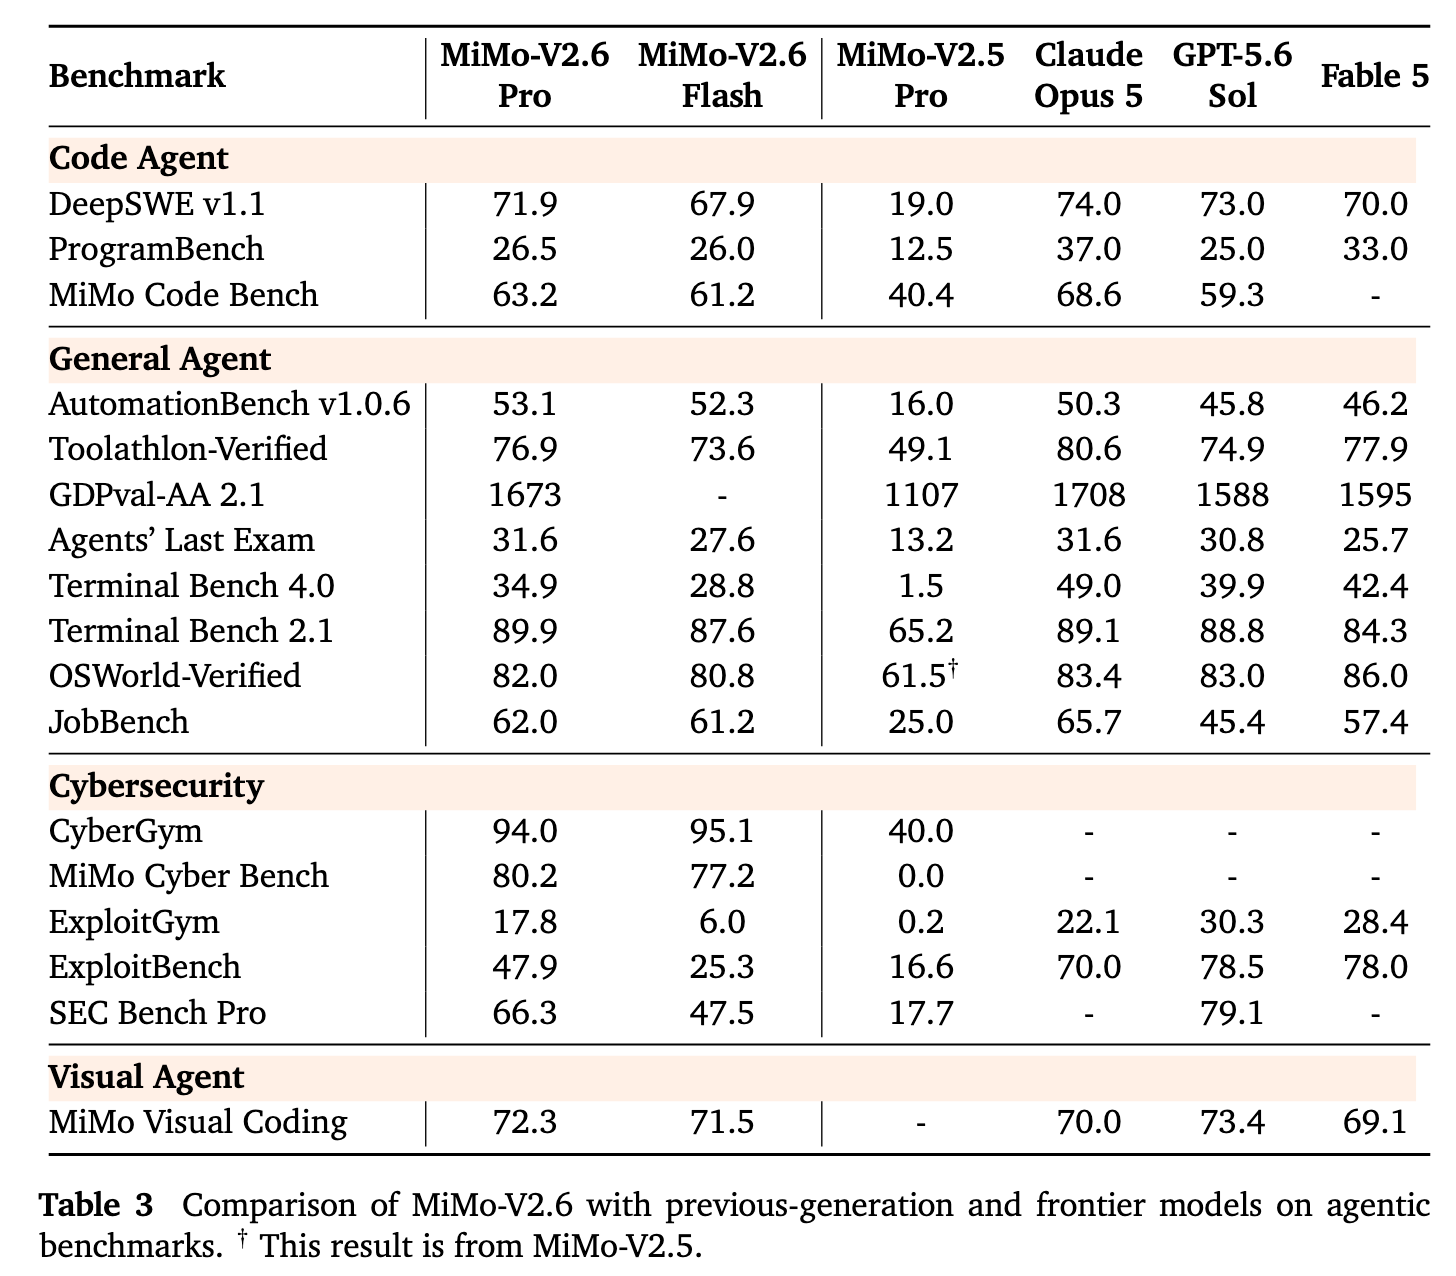
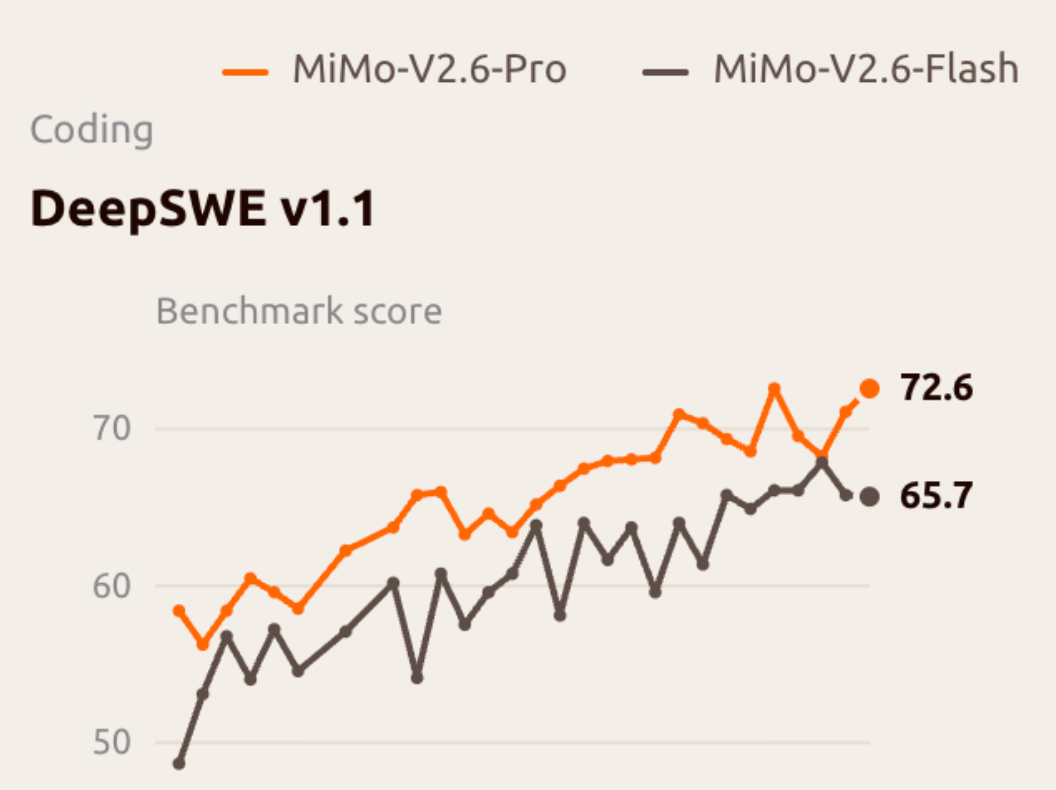
Eén benchmarkdetail verdient zorgvuldige behandeling: Xiaomi’s Live RL‑curve toont MiMo‑V2.6‑Pro rond 72,6 op DeepSWE v1.1 tijdens de trainingsrun, terwijl de definitieve vergelijkende tabel 71,9 rapporteert. Deze cijfers verwijzen naar verschillende gerapporteerde evaluatiecontexten en moeten niet stilzwijgend worden samengevoegd.
Grok 4.7 vs MiMo‑V2.6‑Pro: benchmarkvergelijking
Directe benchmarkvergelijkingen vereisen voorzichtigheid. Leveranciers gebruiken niet altijd identieke harnassen, redeneerbudgetten, checkpoints of toolconfiguraties. Zelfs wanneer benchmarknamen overeenkomen, kunnen kleine scoreverschillen minder betekenisvol zijn dan ze lijken. De veiligste vergelijking is het scheiden van echt uitgelijnde metingen van directioneel bewijs.
Artificial Analysis Intelligence Index
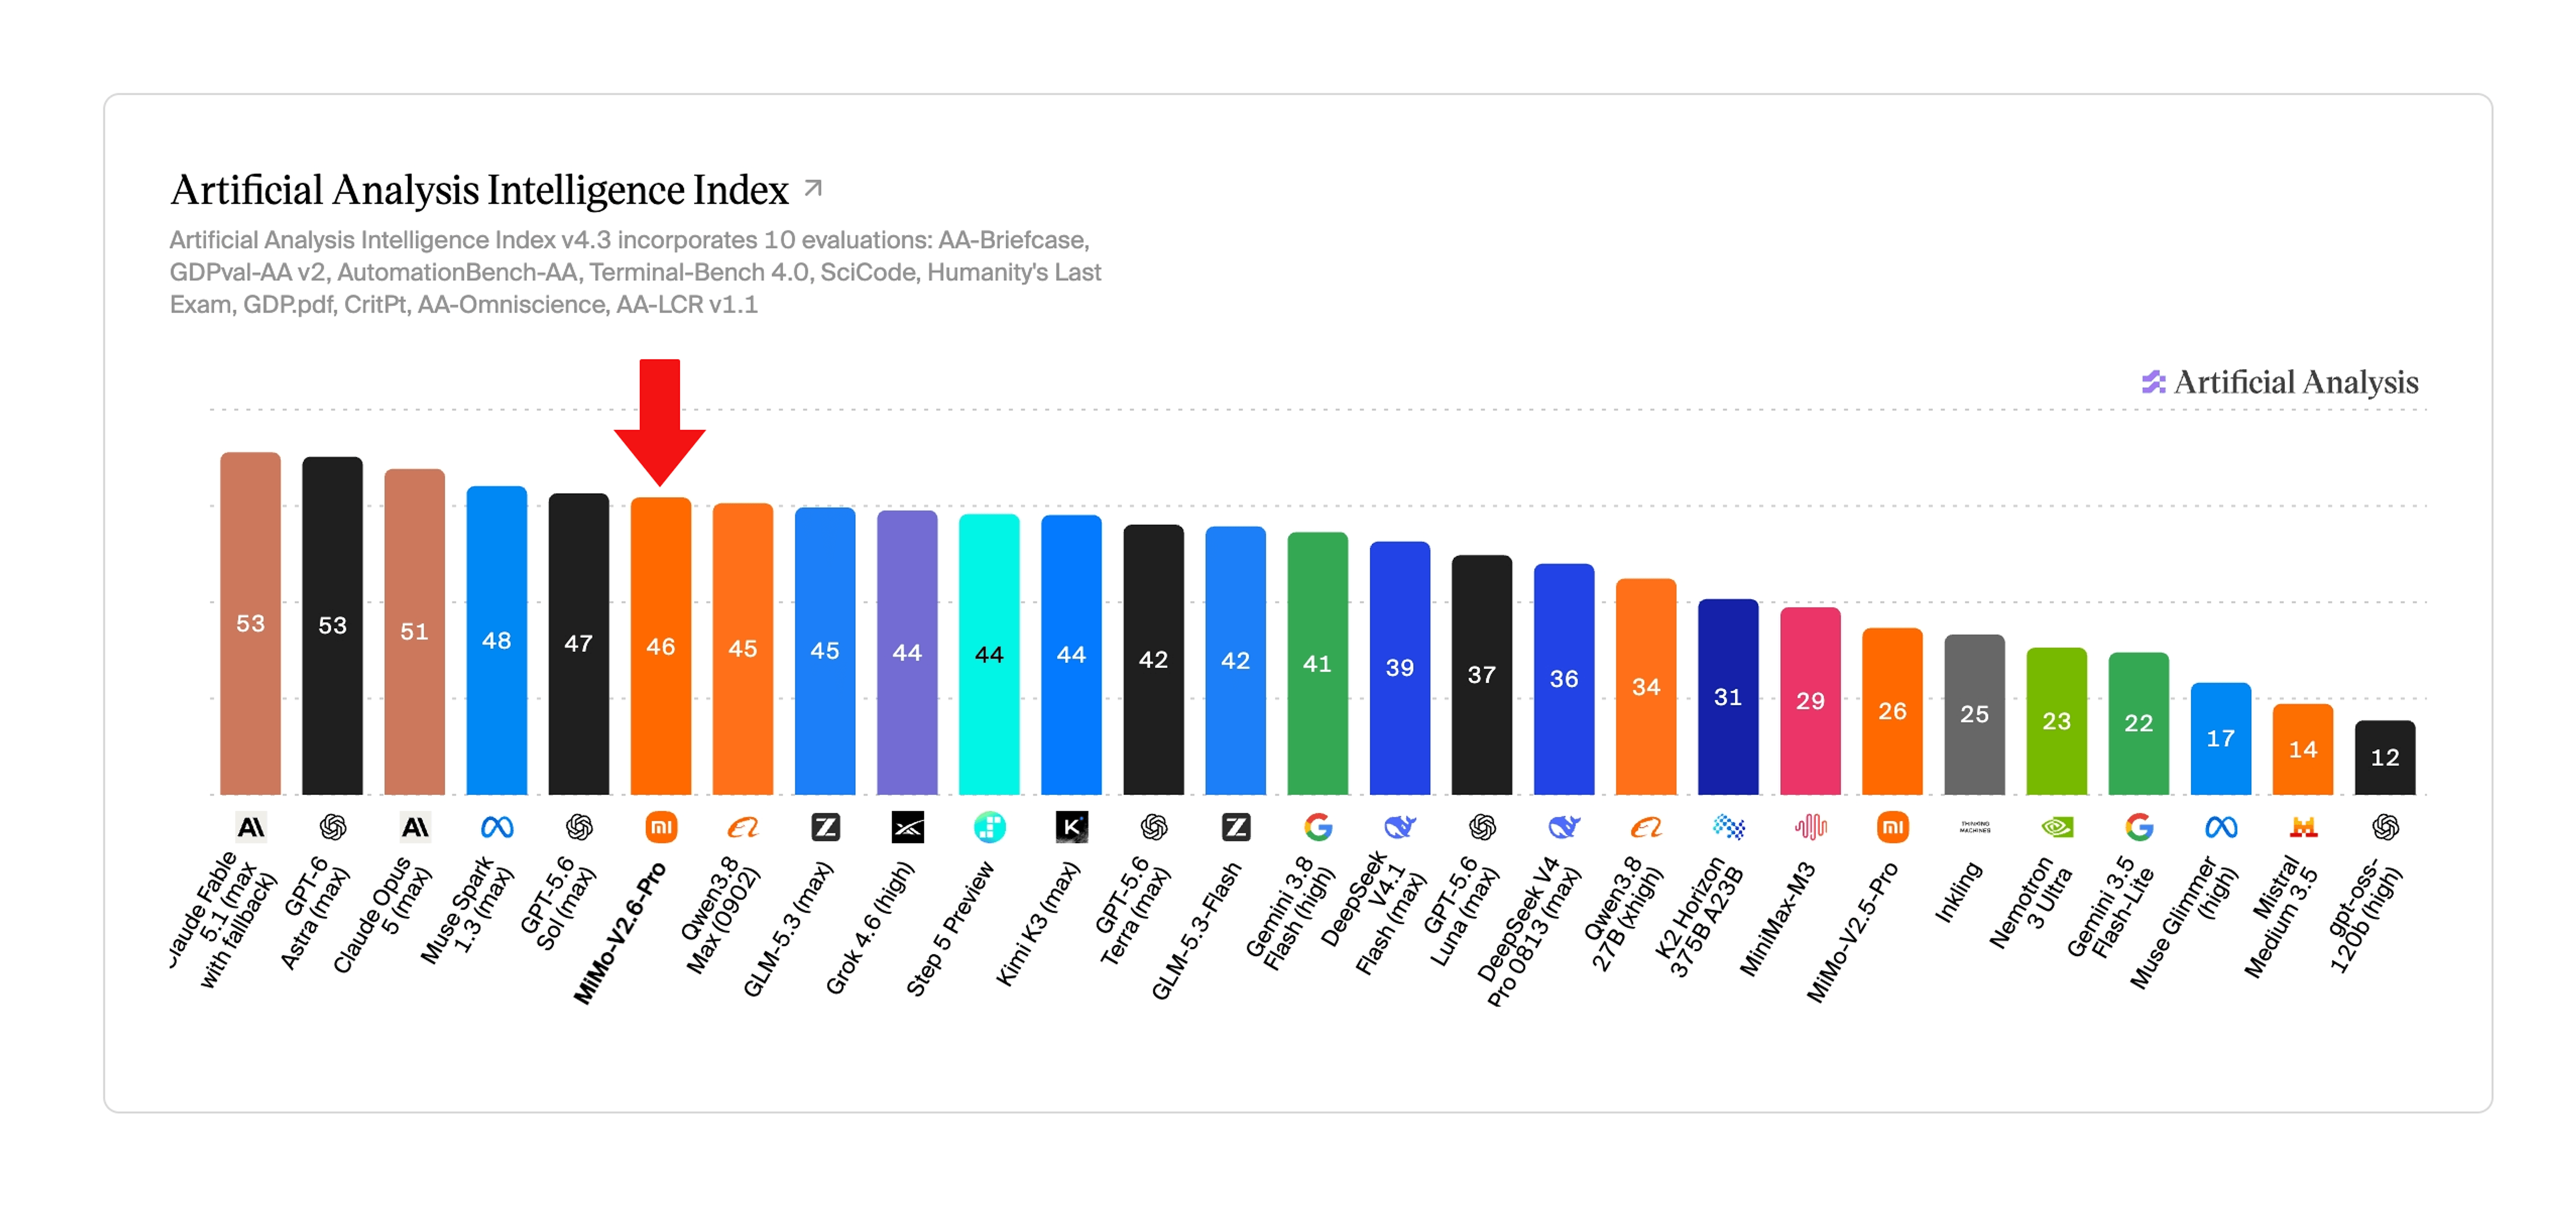
Xiaomi rapporteert 46,32 voor MiMo‑V2.6‑Pro op de Artificial Analysis‑composite‑index. Elke Grok‑vergelijking moet worden gekoppeld aan exact dezelfde Artificial Analysis‑snapshot en modelconfiguratie; een afgeronde gelijkheidsclaim mag niet zonder die bron worden gepresenteerd.
Codeer‑ en agentprestaties
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretatie |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Cijfermatig dicht bij elkaar; runs en instellingen verschillen |
| GDPval-AA | Zie SpaceXAI‑grafiek | 1,673 | Alleen directioneel tenzij harnassen zijn uitgelijnd |
| AA Briefcase | 1,657 | Zie Xiaomi‑grafiek | Gebruik leverancier‑rapporten met broncontext |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Vergelijkbare richting; harnas doet ertoe |
| Context window | 500K | 1M | MiMo ondersteunt meer werkcontext |
*SpaceXAI rapporteert Grok 4.7 DeepSWE bij hoge inspanning. *Xiaomi’s definitieve vergelijkende tabel rapporteert 71,9; de Live RL‑trainingscurve bereikt ongeveer 72,6. Deze cijfers komen uit verschillende evaluatiecontexten.
Passendheid voor codeerworkflows
Voor coderen hangt het onderscheid af van of “coderen” rauw repository‑probleemoplossen betekent of een complete beheerde coding‑agentervaring. Op DeepSWE v1.1 liggen de gepubliceerde cijfers dicht genoeg bij elkaar dat een kloof van minder dan één punt op zich geen productiekeuze zou moeten bepalen.
Het voordeel van Grok 4.7 is hoger in de stack. Het is geïntegreerd met Grok Build, beschikbaar in Cursor, ontworpen om het Grok Bot‑harnas te begrijpen en gekoppeld aan first‑party code‑uitvoering en zoektaken.
Het voordeel van MiMo‑V2.6‑Pro is lager in de stack. Open gewichten maken het praktisch om een private coding‑assistent te bouwen, serving aan te passen, data‑residentie‑controles af te dwingen of te experimenteren met een proprietair agent‑harnas.
Voor teams die tussen hen kiezen, zal een productie‑A/B‑test op representatieve repositories informatiever zijn dan één publieke codeerbenchmark.
Grok 4.7 vs MiMo‑V2.6‑Pro: verschillen in multimodale capaciteiten
Dit is een van de duidelijkste verschillen. Grok 4.7 accepteert tekst‑ en beeldinvoer en produceert tekst. Het bredere Grok‑platform biedt afzonderlijke mediaproducten, maar die mogen niet worden verward met het modaliteitsoppervlak van het model grok‑4.7 zelf.
MiMo‑V2.6‑Pro ondersteunt begrip van tekst, beeld, audio en video. Gecombineerd met een contextvenster van 1M tokens vergroot dit het bereik aan workflows die in één modelcontext kunnen worden afgehandeld.
- Screenshot‑ en codeanalyse in dezelfde taak
- Videobegrip met begeleidende instructies
- Langdurige audiobewerking
- Computer‑use‑agents met visuele feedback
- Multimodale onderzoeksassistenten
- Grootschalige multimodale extractie en QA
Grok 4.7 vs MiMo‑V2.6‑Pro: vergelijking van API‑prijzen
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | Yes, above 200K prompt tokens | No comparable standard tier published |
| Open-weight/self-host option | No | Yes |
Tegen stickerprijs is MiMo‑V2.6‑Pro meerdere keren goedkoper op zowel normale input als gegenereerde output, met een bijzonder groot verschil voor gecachete context. Dat kan de economie beïnvloeden van agents die herhaaldelijk repositories, lange documenten of persistente context verwerken.
Belangrijke prijsopmerking: het contextvenster van 500K van Grok 4.7 betekent niet dat de volledige context tegen het standaardtarief wordt gefactureerd. Aanvragen boven 200K prompttokens worden in rekening gebracht tegen het long‑context‑tarief.
Per 24 september 2026 vermeldt CometAPI Grok 4.7 op $1,60 input en $4,80 output per 1M tokens, tegenover de officiële $2,00 en $6,00. Het vermeldt MiMo‑V2.6‑Pro op $0,348 input en $0,696 output, tegenover de officiële $0,435 en $0,87. Die vermelde standaardtarieven liggen 20% onder de overeenkomstige officiële tarieven. Prijzen en geschiktheid kunnen veranderen; bevestig de live modelpagina’s voordat u budgetteert.
Tokenprijs is niet identiek aan kosten per voltooide taak. Redeneermodellen kunnen verschillende tokenvolumes verbruiken, verschillende aantallen toolcalls gebruiken en verschillende retry‑percentages vereisen. Productie‑evaluatie moet daarom voltooide‑taakkosten, latency en succescijfer samen volgen.
Grok 4.7 vs MiMo‑V2.6‑Pro: toegang en beschikbaarheid
Het toegangsverschil is eenvoudig: Grok 4.7 is beschikbaar via de API en beheerde Grok‑workflows, terwijl de modelgewichten niet worden aangeboden voor self‑hosting. MiMo‑V2.6‑Pro is beschikbaar via de API en als open gewichten, waardoor teams een extra self‑hosted route krijgen.
Beschikbaarheid staat los van licentie of uitrolflexibiliteit. Per 24 september 2026 hebben beide modellen ook live cataloguspagina’s op CometAPI. Teams moeten de endpoint, regio, snelheidslimieten en accountgeschiktheid bevestigen vóór productieroll‑out; een vermeld model garandeert niet identieke beschikbaarheid of serviceniveaus voor elk account.
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Available through xAI | Available through Xiaomi MiMo |
| CometAPI catalog | Listed as available | Listed as available |
| Self-hosted weights | Not available | Open-weight option |
| Operational check | Confirm account access, region, rate limits, and tool availability | Confirm account access, endpoint readiness, and self-hosting requirements |
Open gewichten en proprietaire toegang
Dat MiMo‑V2.6‑Pro open gewichten heeft verandert de vergelijking meer dan een verschil van één punt op een benchmark. Het creëert opties voor private uitrol, afstemming van inference‑engines, aangepaste post‑training, data‑residentie‑controles en diepere infrastructuurintegratie.
Grok 4.7 maakt de tegengestelde afweging: minder controle over de interne modelonderdelen in ruil voor een beheerde, continu geëxploiteerde service en een strak geïntegreerd first‑party ecosysteem. Voor veel organisaties zullen governance‑ en infrastructuureisen de shortlist bepalen voordat benchmarkprestaties dat doen.
Hoe Grok 4.7 en MiMo V2.6 API’s te gebruiken in CometAPI
Ontwikkelaars kunnen toegang krijgen tot de Grok 4.7 API in CometAPI via een uniforme API‑workflow, waardoor de noodzaak om afzonderlijke provider‑specifieke integraties te onderhouden afneemt.
Voor teams die meerdere frontiermodellen benchmarken, is een uniforme API‑laag vooral nuttig omdat dezelfde productieprompts, testharnassen, tokenboekhouding en applicatiecode kunnen worden afgespeeld over modellen met minder integratievariabelen.
CometAPI vermeldt nu MiMo‑V2.6‑Pro als beschikbaar, met API‑beschikbaarheid bevestigd op 22 september 2026. Controleer de live catalogus en accounttoegang vóór productgebruik.
Nu beide modelpagina’s als beschikbaar zijn vermeld, kan een A/B‑test op applicatieniveau prompts, tools, redeneerinstellingen en succescriteria zo consistent mogelijk houden, en vervolgens taakvoltooiing, latency, tokengebruik en faalmodi vergelijken.
Grok 4.7 vs MiMo‑V2.6‑Pro: modelmatch per usecase
| Requirement | Model fit / evaluation guidance |
|---|---|
| First-party web and X search | Grok 4.7 |
| Managed long-running agents | Grok 4.7 |
| Grok Build / Cursor workflows | Grok 4.7 |
| 1M-token context | MiMo-V2.6-Pro |
| Native audio/video understanding | MiMo-V2.6-Pro |
| Open weights, self-hosting, and model control | MiMo-V2.6-Pro |
| Lowest raw API token cost | MiMo-V2.6-Pro |
| Repository coding | Benchmark both on representative repositories |
| Professional knowledge agents | Benchmark both on production tasks |
De beslissing moet daarom worden ingekaderd rond de workloadarchitectuur. Grok 4.7 is ontworpen om een beheerde agentstack capabeler te maken; MiMo‑V2.6‑Pro is ontworpen om high‑end intelligentie goedkoper, meer multimodaal en beter beheersbaar te maken.
Welke moet je kiezen?
Kies Grok 4.7 als je een beheerde agentervaring wilt met first‑party web‑ en X‑search, native code‑uitvoering en minder te beheren infrastructuur. Het is de praktischere optie voor teams die waarde hechten aan een geïntegreerde toolstack en langdurige professionele of codeerworkflows.
Kies MiMo‑V2.6‑Pro als je open gewichten, private uitrol, een contextvenster van 1M tokens, native audio‑ en videobegip of substantieel lagere ruwe API‑prijzen nodig hebt. Het is de sterkere optie wanneer uitrolcontrole, multimodale dekking en kostenefficiëntie de primaire randvoorwaarden zijn.
Als de keuze nog onduidelijk is, laat beide modellen draaien op dezelfde representatieve taken met identieke prompts, tools, redeneerbudgetten, time‑outs en retry‑beleid. Kies het model dat de beste combinatie levert van voltooiingspercentage, latency, totale kosten per succesvolle taak en benodigde menselijke review‑inspanning.
Conclusie
Grok 4.7 versus MiMo V2.6 is verhelderend omdat rauwe intelligentie niet langer de enige betekenisvolle onderscheidende factor is. Beide modellen bevinden zich in een vergelijkbare band van hoge capaciteit in huidige publieke evaluaties, maar hun productstrategieën lopen sterk uiteen.
Grok 4.7 combineert een contextvenster van 500K, configureerbare redenering, sterke training voor langetermijn‑agents en een volwassen first‑party zoek‑ en uitvoeringsstack. MiMo‑V2.6‑Pro combineert een contextvenster van 1M, native multimodale input, open gewichten en API‑prijzen ver onder veel proprietaire frontier‑systemen.
Voor ontwikkelaars is de praktische vraag daarom minder “welke benchmarkscore is hoger?” en meer “waar moet de intelligentie wonen?” Een beheerd agenteecosysteem en een open, aanpasbare modelstack lossen verschillende operationele problemen op. De juiste keuze is die welke het beste aansluit op de productie‑werkbelasting, infrastructuurbeperkingen en het kostenmodel.
Veelgestelde vragen
Is Grok 4.7 een model met 2,1 biljoen parameters?
Een cijfer van ongeveer 2,1T circuleerde vóór de release, maar de definitieve SpaceXAI‑documentatie voor Grok 4.7 publiceert geen totale of actieve parameteraantallen. De bevestigde verklaring is dat Grok 4.7 een groter basismodel gebruikt dan Grok 4.6.
Is MiMo‑V2.6 open source?
Xiaomi bracht MiMo‑V2.6 uit als een open modelfamilie met downloadbare gewichten en bijbehorende onderzoeksresources. In productieplanning moeten teams nog steeds de exacte modellicentie en herdistributievoorwaarden voor het beoogde gebruik beoordelen.
Wat kost Grok 4.7 vs MiMo‑V2.6‑Pro per voltooide agenttaak?
Normaliseer de taakset, prompts, tooltoestemmingen, retry‑beleid en succescriteria. Volg totale input, gecachete input, redenerings‑ en outputtokens, toolcalls, latency, retries en tijd voor menselijke review. Ruwe tokenprijs is slechts één component van de kosten per voltooide taak.
Hoe betrouwbaar zijn benchmarkvergelijkingen tussen Grok 4.7 en MiMo‑V2.6‑Pro?
Gebruik dezelfde repository of taakset, agent‑harnas, tools, redeneerbudget, time‑out, retry‑beleid en beoordelingsrubriek. Rapporteer betrouwbaarheidsintervallen of variatie over herhaalde runs, en houd door de leverancier gepubliceerde cijfers gescheiden van interne resultaten.
Rekent Grok 4.7 meer voor long‑context prompts?
SpaceXAI documenteert hogere tarieven zodra prompttokens 200K overschrijden. Omdat het hogere tier op de aanvraag van toepassing is, moeten teams die grote repositories of persistente agentcontext gebruiken de drempel expliciet modelleren.