
TLDR Gelekte benchmarks en stealthtests op Arena.ai medio september 2026 positioneren Google’s onuitgebrachte Gemini 4 Pro als de nieuwe frontier-koploper, boven GPT-6 Astra en Claude Fable 5.1 op software-engineering, agentische taken, kenniswerk, redeneren en multimodale benchmarks.
Belangrijkste punten
- Gemini 4 Pro leidt gelekte evaluaties op DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) en meerdere andere agentische/redeneersuites.
- Het onderbiedt GPT-6 Astra ($12/$60) en Claude Fable 5.1 ($10/$50) qua lijstprijzen, terwijl het hun 1M-klasse contextvensters evenaart of overtreft.
- Stealthtests op Arena.ai onder plaatshouder-namen (bijv. gemini-3.8-flash) leverden opvallende SVG-, Three.js- en agentische programmeerdemonstraties op.
- RSI (recursieve zelfverbetering) geruchten doen de ronde, maar er is geen publiek bewijs voor closed-loop autonome modelverbetering van Gemini 4 zelf.
- Google heeft zware investeringen in een groter Gemini 4-basismodel bevestigd; de timing van de publieke lancering blijft onofficieel.
- Platforms zoals CometAPI aggregeren al Gemini, GPT-6 Astra, Claude Fable/Opus en honderden andere modellen achter één OpenAI-compatibele endpoint tegen concurrerende tarieven—ideaal voor benchmarking van de nieuwe frontier zodra het wordt gelanceerd.
Wat weten we over Gemini 4? (lekken, bronnen en geverifieerde context)
Per 20 september 2026 heeft Gemini 4 Pro geen officiële aankondiging, modelkaart of publieke API-endpoint van Google ontvangen. Alles buiten Google’s eerdere uitspraken over investeringen in een “groter Gemini 4-basismodel” (winstbericht juli 2026) komt uit communitylekken, blinde tests op Arena.ai en circulerende benchmarktabellen.
Belangrijkste bronnen en claims zijn onder meer:
- Leaker Pankaj Kumar en latere posts (begin tot midden september) verwezen naar een interne Pro-checkpoint met een verwachte publieke release in oktober en mogelijk eerder een Flash-Lite-variant.
- Meerdere ontwikkelaars meldden dat ze een hoog-capaciteitsmodel konden aanroepen met het label “gemini-3.8-flash” (of vergelijkbare plaatshouders) op Arena.ai. Outputs omvatten complexe SVG-generatie (bijv. pelikaan op een fiets, mechanische vlinders in Three.js), lange niet-repetitieve JSON-generatie en sterke agentisch gedrag. Sommige gebruikers claimden backend-details zoals context van meerdere miljoenen tokens, outputplafond van 256k, cross-sessie-geheugen, en native tool-/internetmogelijkheden.
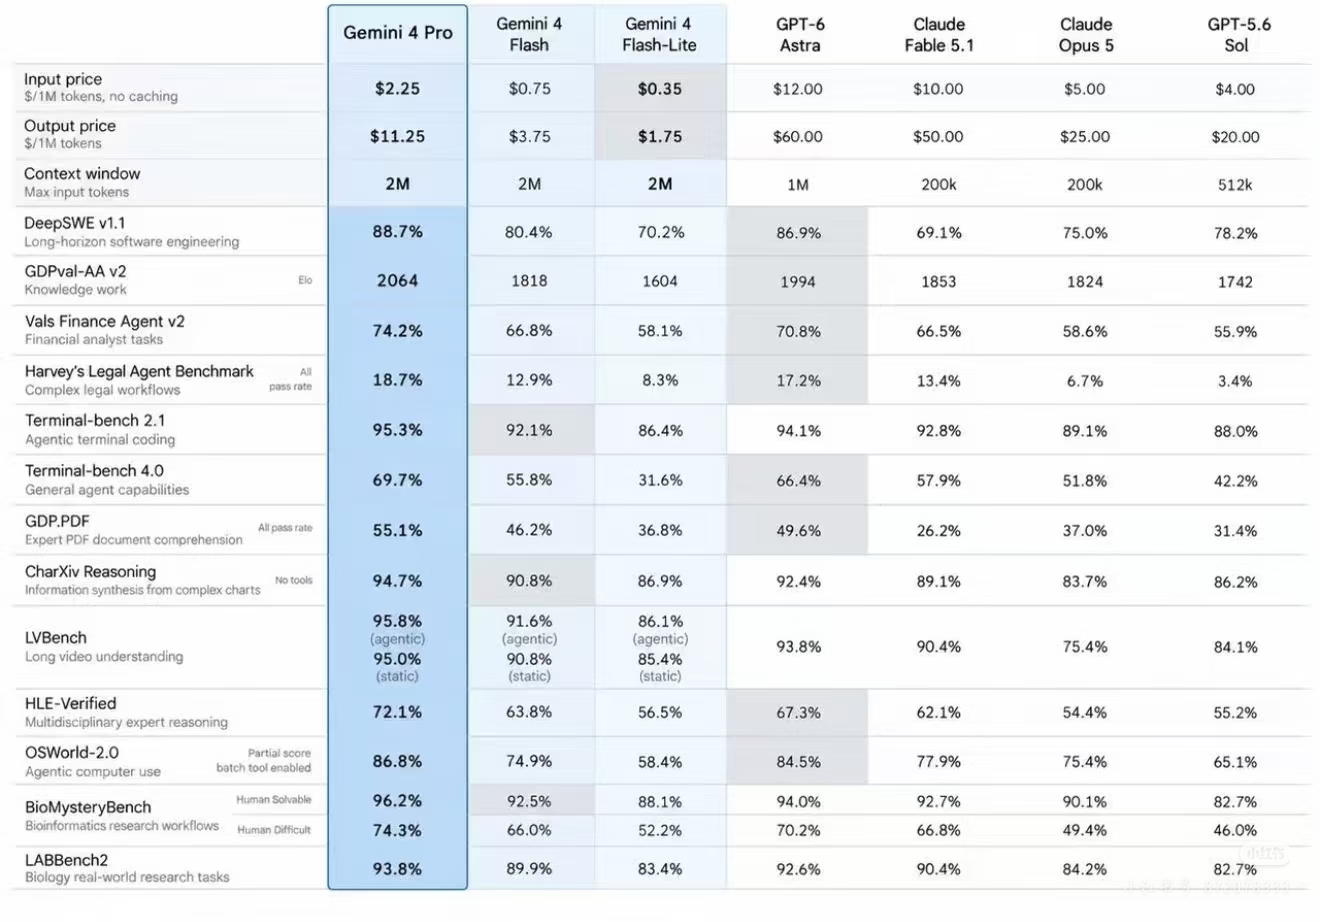
- Een veel gedeelde vergelijkende tabel zet Gemini 4 Pro naast Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 en GPT-5.6 Sol.
- Google heeft de Arena-tests of de tabel niet bevestigd. Historisch patroon laat zien dat het bedrijf vaak stealthevaluaties uitvoert op publieke platforms weken vóór formele lanceringen.
Contextvenster
De gelekte tabel toont 2M maximale invoertokens voor de Gemini 4-familie—dubbel de 1M van GPT-6 Astra en ver boven de 200k van de Claude Fable/Opus 5-lijn (sommige Claude-varianten boden grotere effectieve vensters via andere mechanismen). Afzonderlijke ghost-routing-claims noemden plafonds van 10M; deze blijven niet geverifieerd.
Prijs van Gemini 4 (gelekte cijfers)
De circulerende tabel vermeldt:
- Gemini 4 Pro: $2.25 input / $11.25 output per 1M tokens (geen caching).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
Deze cijfers zijn aanzienlijk lager dan de gerapporteerde $12/$60 van GPT-6 Astra en de $10/$50-lijstrates van Claude Fable 5.1 (Fable 5.1 biedt agressieve cache-read-kortingen die de effectieve kosten voor agentische workloads kunnen verlagen). De huidige officiële Gemini 3.x Pro-prijzen liggen in de $2–$4 input / $12–$18 output range afhankelijk van contextlengte, dus de gelekte Pro-cijfers zijn plausibel als een aanpassing voor de volgende generatie.
De werkelijke publieke prijsstelling zal pas bij lancering bekend worden. Google heeft historisch concurrerende tokenprijzen en gratis tiers gebruikt om adoptie te stimuleren.
Prestaties van Gemini 4 Pro: diepgaande analyse van gelekte benchmarks
De circulerende tabel plaatst Gemini 4 Pro bovenaan in vrijwel elke categorie. Deze cijfers zijn onofficieel en niet geverifieerd door Google of onafhankelijke derden ten tijde van schrijven. Ze moeten worden gezien als directionele signalen, niet als definitieve ranglijsten.
Software-engineering en agentische programmering
- DeepSWE v1.1 (langetermijn software-engineering): 88.7% (vs. GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (agentische terminalprogrammering): 95.3% (vs. Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (algemene agent-capaciteiten): 69.7% (grootste relatieve kloof ten opzichte van Flash en concurrenten).
Kenniswerk en professionele taken
- GDPval-AA v2 (Elo, kenniswerk): 2064 (enige model boven 2000; Astra 1994, Fable 1853).
- Vals Finance Agent v2: 74.2%.
- Harvey’s Legal Agent Benchmark (complexe juridische workflows, all-pass rate): 18.7%.
Redeneren, multimodaal en gespecialiseerd
- CharXiv Reasoning (informatiesynthese uit complexe grafieken, zonder tools): 94.7%.
- LVBench (langdurig videobegrip): 95.8% agentisch / 95.0% statisch.
- HLE-Verified (multidisciplinair expertredeneren): 72.1%.
- OSWorld-2.0 (agentisch computergebruik, gedeeltelijke score, batchtool ingeschakeld): 86.8%.
- BioMysteryBench & LABBench2 (bio-informatica en biologisch onderzoeksworkflows): leidende scores op zowel door mensen oplosbare als moeilijke subsets.
Deze resultaten, als ze directioneel kloppen, tonen bijzondere sterkte op langetermijn-, meerstaps-, tool-gebruikende agentische workloads—precies het gebied waar GPT-6 Astra en Claude Fable 5.1 als leiders gepositioneerd werden na hun releases begin september.
Arena-kwalitatieve tests versterken dit beeld: complexe SVG- en Three.js-generaties van het stealthmodel zijn in community side-by-side vergelijkingen superieur of zeer competitief beoordeeld ten opzichte van Astra.
Hoe zal Gemini 4 werken?
Gemini 4 (Pro) is nog niet uitgebracht, dus elke beschrijving van “hoe het zal werken” is noodzakelijkerwijs gebaseerd op officiële uitspraken van Google, de beperkte gelekte details over een vroege interne checkpoint, de trajecten van de Gemini 3.x-serie en redelijke technische aannames. Niets hieronder moet worden gezien als bevestigde specificaties.
Kerntraining en schaalbenadering
Google heeft Gemini 4 beschreven als zijn “meest ambitieuze pre-training run tot nu toe”, gebouwd op een aanzienlijk groter basismodel dan eerdere generaties. Het expliciete doel is competitief blijven aan de frontier, vooral in programmeren en autonome agents.
Dit impliceert:
- Een groter aantal parameters of effectievere capaciteit (via mixture-of-experts, betere sparsity, of dichtere schaalvergroting).
- Zwaardere compute-investering tijdens pre-training.
- Voortgezette nadruk op multimodale trainingsdata (tekst, beeld, video, audio, code, tool-gebruiks-trajecten).
Het model zal naar verwachting dienen als een nieuwe high-capability baseline waaruit later snellere Flash-stijl varianten kunnen worden afgeleid.
Inferentie en redeneerstijl
Gelekte beschrijvingen van een vroege “argon”-checkpoint noemen een High thinking-effort-modus die ongeveer 2.4 minuten nam voor één generatie en een aanzienlijk hoger outputlimiet ondersteunde (gerapporteerd op 256k tokens tegenover eerder ~64k).
Dit wijst op:
- Optionele, compute-intensieve redeneerpaden (in de geest van extended-thinking of “max effort”-modi in concurrerende modellen).
- Het vermogen om meer interne berekening te besteden aan moeilijke problemen vóór het produceren van een antwoord.
- Betere ondersteuning voor lange, coherente outputs zoals complete codebases, meerstapsplannen of uitgebreide rapporten.
Gebruikers zullen waarschijnlijk de afweging tussen snelheid/kosten en diepte van redeneren kunnen sturen, net zoals bij huidige Gemini Flash-modellen die lage / middelhoge / hoge denklevels aanbieden.
Belangrijkste focusgebieden voor capaciteiten
Gebaseerd op publieke opmerkingen van Sundar Pichai en de ontwikkeltrajecten:
- Programmeren en software-engineering Sterker langetermijnprestaties: refactors over meerdere bestanden, debuggen over repositories, zelfcorrectielussen, en hogere voltooiingspercentages op realistische softwaretaken.
- Autonoom / agentisch gedrag Verbeterd vermogen om te plannen, tools te gebruiken, tussentijdse resultaten te observeren, te herstellen van fouten en over vele stappen naar een doel door te gaan. Dit bouwt direct voort op computergebruik- en agentische features die al aanwezig zijn in Gemini 3.5/3.8 Flash.
- Betrouwbaarheid bij lange context Communityrapporten noemen doelen in het 1.5-million-token bereik (of hoger). Het praktische doel is niet alleen grotere vensters, maar betere ophaalbetrouwbaarheid en minder degradatie bij zeer lange documenten, codebases of meeruur-agenttraces.
- Multimodaal begrip en generatie Native afhandeling van tekst + beeld + video + audio, met verwachte verbeteringen in ruimtelijke redenering, videobegrip en real-time voice/agent-interacties (voortbouwend op de Gemini 3.8 Live-modellen van september 2026).
- Toolgebruik en gestructureerde outputs Robuustere function calling, code-executie, search grounding, en gestructureerde JSON/XML-stijl outputs voor betrouwbare integratie in applicaties en agents.
Hoe het verschilt van Gemini 3.x
- Schaal: Expliciet groter basismodel in plaats van incrementele verfijning.
- Outputcapaciteit: Gelekte hogere tokenlimieten maken langere single-pass generaties mogelijk.
- Redeneerdiepte: Meer uitgesproken high-effort-modi voor moeilijke problemen.
- Agentische focus: Meer nadruk op duurzame, meerstaps autonome werkzaamheden in plaats van single-turn of kortetermijn taken.
- Positionering: Bedoeld als het nieuwe frontier Pro-tier model, terwijl de Flash-lijn snel blijft itereren voor snelheid en kostenefficiëntie.
Relatie tot recursieve zelfverbetering (RSI)
Leidinggevenden van Google hebben publiekelijk de grote AI-kapitaalsinvesteringen gelinkt aan het langetermijndoel van recursieve zelfverbetering—systemen die zichzelf of de processen die de volgende generatie produceren, betekenisvol kunnen verbeteren. Verwant onderzoek (zoals de Dream-RSI-paper) toont agents die hun eigen verkenningsstrategieën verbeteren zonder modelgewichten te veranderen.
Zal Gemini 4 Pro beter presteren dan GPT-6 en Claude Fable 5.1?
| Categorie | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Opmerkingen |
|---|---|---|---|---|
| Prijs input / output | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× goedkoper dan Astra |
| Contextvenster | 2M | 1M | 200k | Significant voordeel voor Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Sterke voorsprong in programmeren |
| GDPval-AA v2 (Elo) | 2064 | 1994 | 1853 | Kenniswerk-leider |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Algemene agent-capaciteiten |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Computergebruik |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Expertredeneren |
| LVBench (video) | 95.8% / 95.0% | 93.8% | 90.4% | Multimodale sterkte |
| Bio / LAB research | Hoogste scores | Sterk | Competitief | Wetenschappelijke workflows |
Gemini 4 Pro staat bovenaan elke grote rij in de tabel, vaak met een betekenisvolle marge, terwijl de geclaimde prijsstelling veel agressiever is dan die van zowel GPT-6 Astra als Claude Fable 5.1.
Belangrijke kanttekeningen
- Deze tabel is geen officiële Google-publicatie. Per 20 september 2026 heeft Google nog geen modelkaart, API-endpoint, prijsstelling of bevestigde benchmarks voor Gemini 4 Pro gepubliceerd. De cijfers zijn afkomstig uit communitybronnen / Arena-waarnemingen / interne checkpointlekken (codenaam “argon”).
- Sommige eerder circulerende sheets bleken later voorspellingen of gedeeltelijke kopieën te zijn. Behandel elk specifiek percentage en de prijsstelling als niet geverifieerd totdat Google ze bevestigt.
- Het contextvenster van Claude Fable 5.1 staat hier als 200k vermeld, wat lager is dan de 1M die vaak wordt gerapporteerd in officiële documentatie van Anthropic. Dit kan een specifieke evaluatie-instelling weerspiegelen of een fout in de gelekte sheet zijn.
- GPT-6 Astra en Claude Fable 5.1 blijven momenteel de enige volledig publieke, onafhankelijk geëvalueerde frontier-modellen. Artificial Analysis en andere third-party trackers tonen ze nog steeds als nauw matched overall (met verschillende sterktes).
Huidige praktische realiteit (20 september 2026)
| Model | Status | Beste voor | Prijsniveau |
|---|---|---|---|
| Gemini 4 Pro | Niet uitgebracht (beweerd sterk) | Lange context, programmeren, agents, multimodaliteit, kosten | Zeer agressief (beweerd) |
| GPT-6 Astra | Uitgebracht | Wiskunde, computergebruik, terminal, automatisering, cyber | Premium |
| Claude Fable 5.1 | Uitgebracht | Langetermijn-agents, redeneren, codekwaliteit, cache-efficiëntie | Premium |
| Gemini 4 Flash / Flash-Lite | Beweerde varianten | Snelheid + kostengevoelige workloads | Uiterst laag |
Korte kernpunten
- Dominant over de hele linie: Gemini 4 Pro staat #1 in elke categorie, vaak met een duidelijke marge.
- Bijzondere sterktes: Langetermijn programmeren/agents (DeepSWE, Terminal-bench), kenniswerk, multimodaal (video + grafieken), en gespecialiseerde domeinen (financiën, juridisch, biologie, computergebruik).
- Prijspositionering: Ongeveer 1/5 van de prijs van GPT-6 Astra en Claude Fable 5.1 voor zowel input als output, terwijl hogere scores worden geleverd.
Astra legt nadruk op computergebruik, cybersecurity-drempels en wetenschappelijke ontdekking; Fable 5.1 benadrukt langlopend kenniswerk en programmeren met verfijnde safeguards en lagere cache-read-kosten. Het gelekte profiel van Gemini 4 Pro lijkt het sterkst op brede agentische software-engineering en multimodale redenering.
Hoe ontwikkelaars zich kunnen voorbereiden: aanbevelingen van CometAPI
Terwijl men wacht op officiële toegang tot Gemini 4 Pro, profiteren teams van een unified gateway die de huidige frontier al ondersteunt (Gemini 3.x-serie, GPT-6 Astra, Claude Fable 5.1 / Opus 5, en 500+ andere modellen). CometAPI biedt precies dat: één OpenAI-compatibele endpoint, één API-sleutel, pay-as-you-go facturering doorgaans 20–40% onder directe leverancierstarieven, en de mogelijkheid om met één parameterwijziging van model te wisselen.
Praktische workflow:
- Prototypiseer agentische pipelines op huidige Gemini Flash/Pro, GPT-6 Astra en Claude Fable 5.1 via CometAPI.
- Benchmark dezelfde prompts over modellen om baselines vast te leggen.
- Wanneer Gemini 4 Pro (en zijn Flash-varianten) in de CometAPI-catalogus verschijnen—historisch voegt het platform nieuwe Google-modellen snel toe—wissel de model-ID en voer evaluaties opnieuw uit met minimale codewijzigingen.
- Gebruik het kostendashboard om tokenuitgaven over providers te volgen en routeer hoog-volume of latentiegevoelige traffic naar het meest economische capabele model.
Deze aanpak elimineert multi-key management, vermindert vendor lock-in risico, en positioneert teams om Gemini 4 Pro op dag één van publieke beschikbaarheid te adopteren.
Gemini 4 Pro, als de lekken directioneel correct blijken, vertegenwoordigt Google’s sterkste poging tot nu toe om de frontier te herwinnen op agentische software-engineering en lang-context multimodale redenering. De combinatie van geclaimde prestaties, grote context en agressieve prijsstelling zou het tot een default overweging maken voor veel productie-workloads. Totdat de officiële lancering en onafhankelijke evaluaties arriveren, is het verstandige pad voortdurende benchmarking over de bestaande frontier-modellen—eenvoudig te doen via platforms die toegang al unificeren. Blijf wachten op de formele aankondiging; de komende weken zullen waarschijnlijk duidelijk maken hoeveel van de hype vertaald wordt naar productie-realiteit.
Veelgestelde vragen
Is Gemini 4 Pro uitgebracht?
Nee. Volgens de nieuwste catalogus en Google-uitspraken (midden tot late september 2026) is het nog niet publiekelijk uitgebracht of vermeld met een officiële model-ID.
Wanneer is de verwachte releasedatum van Gemini 4 Pro?
Lekkers wijzen op oktober 2026 (met enige late-september speculatie). Google heeft geen officiële datum gegeven. Behandel dit als een tijdvenster in afwachting van bevestiging via API-catalogus of blogpost.
Heeft Google RSI bereikt met Gemini 4 Pro?
Publiek bewijs toont geavanceerd gebruik van agentische lussen voor modelverfijning en onderzoek naar strategie-niveau recursieve verbetering (bijv. Dream-RSI). Claims van volledige RSI die het model produceert, worden niet ondersteund door onafhankelijke verificatie.
Hoe verhoudt het zich tot GPT-6 Astra en Claude Fable 5.1 op benchmarks?
Gelekte communitygrafieken claimen voorsprongen op verschillende agent-/programmeer-suites. Officiële onafhankelijke scores voor een uitgebrachte Gemini 4 Pro bestaan nog niet. Huidige publieke data geeft de voorkeur aan het evalueren van de live modellen (Astra en Fable 5.1) op uw taken.
Moet ik wachten op Gemini 4 Pro voordat ik bouw?
Nee. Lever met de vandaag sterkst beschikbare modellen (toegankelijk via CometAPI of directe API’s), houd evaluatiesets gereed, en adopteer het nieuwe model als en wanneer onafhankelijke en interne tests de switch rechtvaardigen.
Waar kan ik eenvoudig toegang krijgen tot huidige frontier-modellen?
Unified providers zoals CometAPI bieden OpenAI-compatibele toegang tot GPT-6 Astra-klasse, Claude Fable 5.1, huidige Gemini-modellen en andere met vereenvoudigde facturering en overschakeling. Bekijk de live modellijst en documentatie voor de nieuwste ID’s en prijsstelling.