
TL;DR
Kimi K3 is open-gewichten maar niet op werkstationniveau: het uitserveren van het native model vereist GPU’s van datacenterklasse en gedistribueerd geheugen. Gebruik vLLM voor het meest directe pad naar productie, of SGLang wanneer topologie, expert-parallelisme en cachecontrole belangrijk zijn. Community-GGUF-builds verlagen de hardwaredrempel, maar vereisen nog steeds grofweg 500 GB tot ruim boven 1 TB aan adresseerbaar geheugen en ruilen snelheid of kwaliteit in voor haalbaarheid. Voor gewone pc’s en Macs: test eerst via een gehoste API en self-host alleen wanneer privacy, langdurige benutting of controle over de infrastructuur de kosten rechtvaardigt.
What Is Kimi K3?
Kimi K3 is Moonshot AI’s open-gewichten, native multimodale vlaggenschipmodel voor langetermijn-coderen, agentisch kenniswerk, redeneren en visueel begrip.
Moonshot beschrijft het als ’s werelds eerste open 3T-klasse model. De architectuur combineert Kimi Delta Attention and Attention Residuals met een sparse MoE-ontwerp dat slechts een subset van experts per token selecteert.
De schaal is ongebruikelijk, zelfs naar frontier-modelmaatstaven. In plaats van alle 2,8T parameters bij elk token te activeren, selecteert K3 16 van 896 gerouteerde experts, plus gedeelde experts. Dit vermindert de per-tokenberekening aanzienlijk, hoewel alle modelgewichten nog steeds ergens in het inferentiesysteem beschikbaar moeten zijn.
| Specificatie | Kimi K3 — officiële modelspecificaties |
|---|---|
| Architectuur | Mixture-of-Experts |
| Totaal aantal parameters | 2.8T |
| Geactiveerde parameters | 104B |
| Experts | 896 |
| Geselecteerde experts per token | 16 |
| Contextlengte | 1,048,576 tokens |
| Vision-encoder | MoonViT-V2 |
| Native kwantisatie | MXFP4-gewichten / MXFP8-activaties |
| Formele modaliteiten volgens modelkaart | Tekst + afbeelding |
K3 past ook kwantisatie-bewuste training toe vanaf de SFT-fase, in plaats van low-precision serving louter als een post-traincompressiestap te behandelen.
De architectuur is dus geoptimaliseerd voor serving op zeer grote schaal—maar “sparse compute” moet niet worden verward met een “klein geheugengebruik”. Slechts een deel van het netwerk rekent per token, maar de volledige expertpool moet toegankelijk blijven.
How Does Kimi K3 Perform?
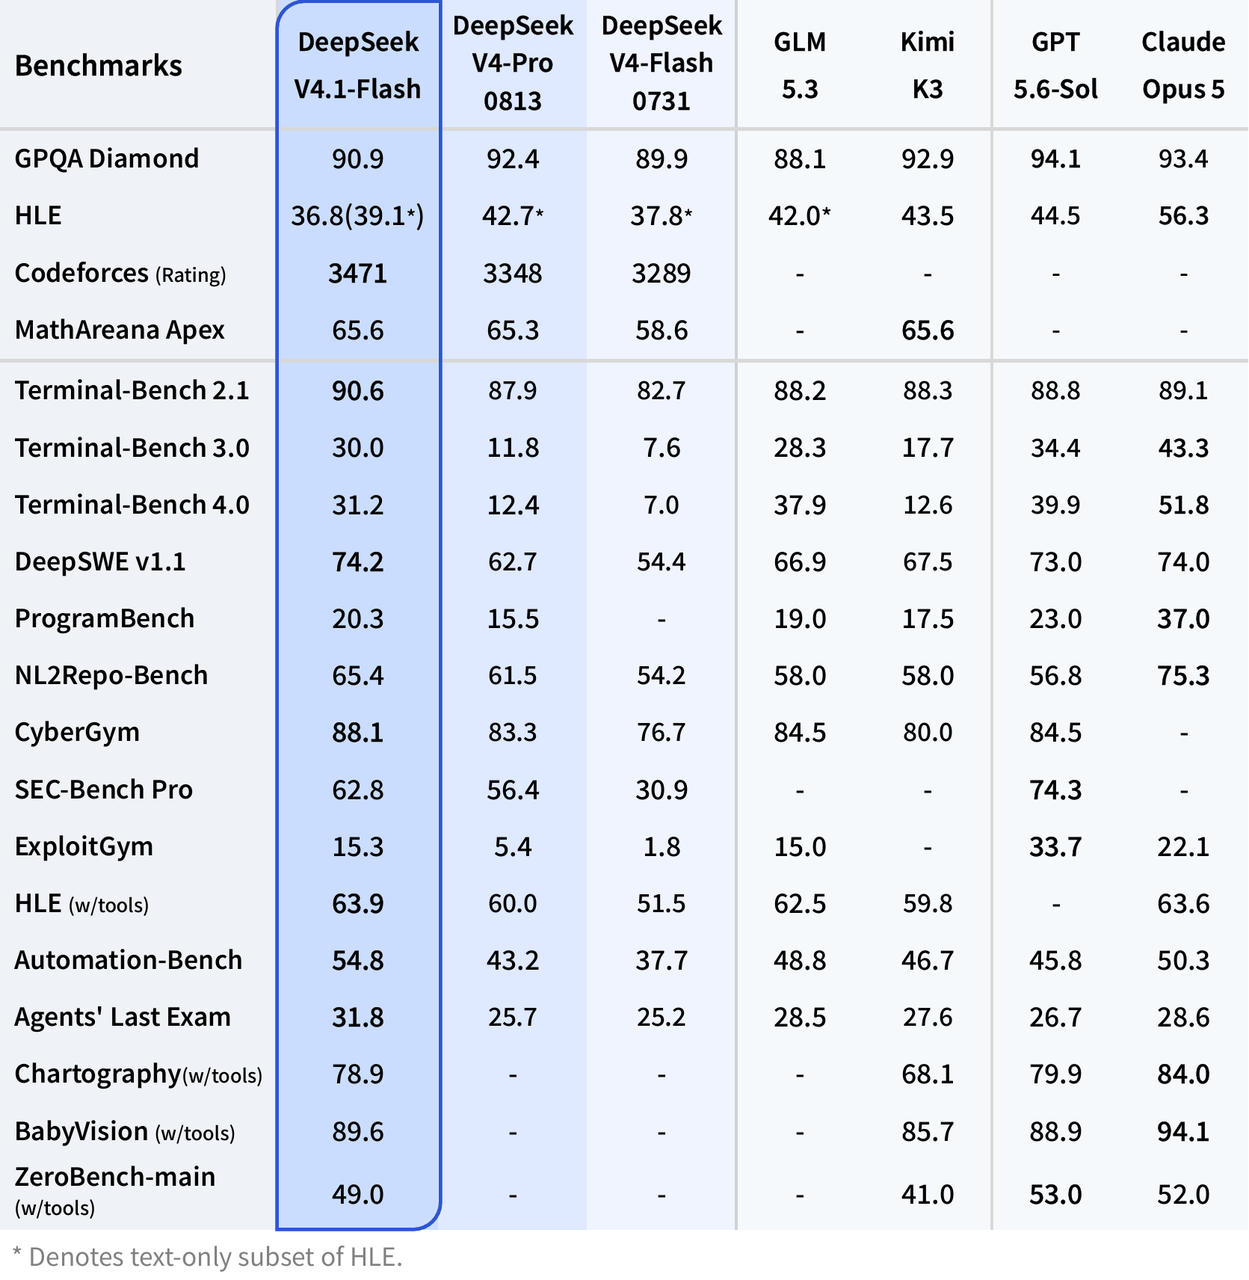
Moonshots officiële Kimi K3-benchmarksuite plaatst het model dicht bij de leidende propriëtaire frontiermodellen, met name bij langetermijn software-engineering en agentische workloads.
De onderstaande selectie omvat redeneren, coderen, agents en visie. Hoger is beter voor alle getoonde scores.
| Benchmark — officiële resultaten van Moonshot | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| OmniDocBench | 91.1 | 85.8 | 89.8 | 87.9 |
| PerceptionBench | 58.5 | 59.7 | 57.2 | 47.2 |
De officiële scores plaatsen Kimi K3 in de buurt van GPT-5.6 Sol, Claude Fable 5 en Claude Opus 4.8 op taken voor redeneren, coderen, agents en visie. Behandel deze door de provider gerapporteerde resultaten als context voor capaciteiten in plaats van als een universele ranking; de gedetailleerde benchmarkanalyse wordt apart behandeld. Voor deze gids is het operationele punt dat self-hosting frontiercapaciteit en controle over de infrastructuur biedt, maar geen goedkope desktopshortcut.
Can You Actually Run Kimi K3 Locally?
Ja, maar er zijn twee heel verschillende definities van “lokaal”.
Lokale server / privé-datacenter: realistisch.
Normale desktop of laptop: technisch experimenteerbaar met agressief gekwantiseerde community-builds, maar over het algemeen onpraktisch voor interactief gebruik.
Het huidige vLLM Kimi K3-recept legt de lat zeer hoog:
- NVIDIA: minimaal 8× GB300
- AMD ROCm: minimaal 8× MI355X of MI350X
- NVIDIA-driver: R580+ voor het huidige CUDA 13 K3-image
- Multi-node-infrastructuur aanbevolen voor echte productiebelasting
De oorspronkelijke vLLM dag-0 gids demonstreerde ook een 8-GPU B300- of 8-GPU MI355X-quickstartpad. Voor een nieuwe productiedeploy volg je het nieuwere recept, omdat dit de servingstack na optimalisaties rond de lancering weerspiegelt.
Dit is het kernpunt: K3 is open-gewichten, maar het is geen open model op consumentenschaal.
Official Weights vs Community GGUF Quantizations
Er is nog een manier om de hardwaredrempel te verlagen: communitykwantisatie.
De huidige Unsloth K3-repository biedt verschillende GGUF-varianten die via llama.cpp-compatibele software kunnen draaien.
Geconsolideerde vergelijking. Adresseerbaar-geheugencijfers zijn planningsschattingen (downloads + circa 10–15% runtime-overhead), geen garanties; context, cache, visie en offload-instellingen kunnen meer vereisen.
| Variant | Download | Aanbevolen adresseerbaar geheugen | Vision-ondersteuning | Gedocumenteerde runtime | Doel / kwaliteitsbewijs |
|---|---|---|---|---|---|
| UD-Q1_0 | 466 GB | ≥520 GB | Repository vermeldt vision-ondersteuning; verifieer het juiste runtimepad. | Unsloth llama.cpp-PR-fork; Ollama-route gedocumenteerd, versie niet gepind. | Proof-of-concept; geen onafhankelijk variant-specifiek kwaliteitstest vermeld. |
| UD-TQ1_0 | 509 GB | ≥570 GB | Zelfde repository-brede vision-caveat. | Zelfde gedocumenteerde runtimepad. | Agressief 1-bit-klasse-experiment; geen onafhankelijk variant-specifieke test. |
| UD-IQ1_S | 594 GB | ≥665 GB | Zelfde repository-brede vision-caveat. | Zelfde gedocumenteerde runtimepad. | Extreme lokale proef; geen onafhankelijk variant-specifiek kwaliteitstest. |
| UD-IQ1_M | 649 GB | ≥730 GB | Zelfde repository-brede vision-caveat. | Zelfde gedocumenteerde runtimepad. | Betere 1-bit-compromis; geen onafhankelijk variant-specifieke test. |
| UD-IQ2_XXS | 711 GB | ≥800 GB | Zelfde repository-brede vision-caveat. | Zelfde gedocumenteerde runtimepad. | 2-bit-klasse-experiment; geen onafhankelijk variant-specifieke test. |
| UD-Q2_K_XL | 861 GB | ≥970 GB | Zelfde repository-brede vision-caveat. | Zelfde gedocumenteerde runtimepad. | Grote CPU/GPU-server; geen onafhankelijke benchmark voor K3-kwantisatie. |
| UD-Q4_K_XL | 1.51 TB | ≥1.7 TB | Zelfde repository-brede vision-caveat. | Directe voorbeelden voor llama.cpp en Ollama zijn gedocumenteerd. | Kwaliteitsgerichte GGUF-serving; geen onafhankelijke benchmark voor K3-quant. |
| UD-Q8_K_XL | 1.56 TB | ≥1.75 TB | Zelfde repository-brede vision-caveat. | Zelfde gedocumenteerde runtimepad. | Bijna verliesloos community-build; weinig opslagvoordeel t.o.v. Q4. |
Dit onderscheid verklaart ook waarom sommige vroege artikelen over lokale deployment 594 GB noemen: 594 GB correspondeert nu met de community UD-IQ1_S GGUF-build, niet met een bruikbare beschrijving van de complete huidige native checkpoint.
Een model van 466–649 GB is dramatisch kleiner dan de oorspronkelijke uitrolfootprint, maar nog steeds enorm naar werkstationnormen. Reserveer ook geheugen voor runtimestatus, context, caches, de vision-projector, OS-processen en andere overhead.
Schijfcapaciteit is niet hetzelfde als inferentiegeheugen. Een 1 TB SSD hebben betekent niet dat een 600 GB-model snel zal draaien op een machine met 64 GB RAM. SSD-offloading kan extreme experimenten mogelijk maken, maar tokenproductie kan pijnlijk traag worden.
How to Deploy Kimi K3 with vLLM
Voor serieuze self-hosting is vLLM het meest rechtstreekse startpunt.
Moonshot noemt momenteel vLLM als een van de aanbevolen K3-inferentie-engines, en vLLM biedt modelspecifieke ondersteuning voor KDA, MXFP4 MoE, reasoning-parsing, tool-calling, prefix-caching en gedistribueerde deployment.
Check the prerequisites
Voor NVIDIA-productiedeploy gebruikt het huidige geteste recept de container vllm/vllm-openai:kimi-k3.
Controleer de GPU’s:
nvidia-smi
Bevestig Docker:
docker --version
Bevestig dat NVIDIA Container Toolkit de accelerators ziet:
docker run --rm --gpus all nvidia/cuda:13.0.0-base-ubuntu24.04 nvidia-smi
Als het laatste commando niet alle GPU’s ziet, los dan de host/container GPU-runtime op voordat je een multi-terabyte model downloadt.
Set your Hugging Face token
Als authenticatie voor de modelrepository vereist is, sla het token op in een omgevingsvariabele in plaats van het in scripts hardcoden.
export HF_TOKEN="YOUR_HUGGING_FACE_TOKEN"
Pull the K3 vLLM container
docker pull vllm/vllm-openai:kimi-k3
Het huidige recept specificeert een CUDA 13-build en een NVIDIA-driver van R580 of nieuwer.
Launch Kimi K3
Huidig Blackwell TP8-startsjabloon (vLLM-recept bijgewerkt 2026-09-10): gebruik dit als basis en regenereer of benchmark het profiel voor jouw exacte hardware en verkeer.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  vllm/vllm-openai:kimi-k3 \
  --model moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --attention-backend TOKENSPEED_MLA \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --prefix-match-unit 128 \
  --enable-prefix-caching \
  --max-model-len 131072 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Het huidige recept vereist het K3 CUDA 13-image en een NVIDIA-driver van R580 of nieuwer. Een FP8 KV-cache moet gekoppeld worden aan een compatibele MLA prefill/decode-backend; benchmark alternatieven voordat je de attention-configuratie wijzigt.
Bron: vLLM Kimi K3-recept. Dit vervangt het eerdere dag-0-commando en is het huidige productierecept.
Voor een eerste validatierun kun je overwegen de maximale modellijntelengte te beperken in plaats van direct de volledige 1,048,576-token-capaciteit toe te wijzen. Het huidige vLLM-recept raadt expliciet aan om max-model-len af te stemmen op de werklast.
Bijvoorbeeld:
--max-model-len 131072
Dit verandert de architecturale contextlimiet van K3 niet. Het geeft de serving-engine een beter beheersbare werkruimte voor je eerste tests.
Test the local endpoint
vLLM stelt een OpenAI-compatibele API beschikbaar op poort 8000.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [
      {
        "role": "user",
        "content": "Explain the difference between tensor parallelism and expert parallelism."
      }
    ],
    "max_tokens": 512
  }'
Of gebruik de OpenAI Python SDK:
python
from openai import OpenAI

 client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
    timeout=3600,
 )

response = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=[
        {
            "role": "user",
            "content": "Write a Python function that validates a JSON schema.",
        }
    ],
    max_tokens=1024,
 )

print(response.choices[0].message.content)
Het officiële vLLM-recept gebruikt hetzelfde OpenAI-compatibele localhostpatroon, waardoor het relatief eenvoudig is om een applicatie te schakelen tussen lokale en gehoste inferentie.
How to Deploy Kimi K3 with SGLang
SGLang is de andere belangrijke deployroute die officieel door Moonshot wordt aanbevolen.
Het is met name relevant wanneer je diepere controle wilt over gedistribueerde serving, expert-parallelisme, hardwarespecifieke kernels of complexe productietopologie.
Gebruik het speciale SGLang Kimi K3 Cookbook en kies een hardwarespecifieke topologie. Hieronder staat het geverifieerde single-node 8×B300 Unified/Balanced-profiel uit het kookboek; het is gemeten met SGLang v0.5.18 op commit 71de97b2.
Installeer een K3-capabele build:
pip install --upgrade pip
pip install uv
uv pip install --prerelease=allow sglang
Start het geverifieerde B300 TP8/DCP8-profiel:
sglang serve \
  --trust-remote-code \
  --model-path moonshotai/Kimi-K3 \
  --tp-size 8 \
  --dcp-size 8 \
  --mem-fraction-static 0.85 \
  --mamba-full-memory-ratio <value-from-official-calculator> \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000
--mamba-full-memory-ratio is werklastafhankelijk: bereken deze op basis van gemiddelde invoer-plus-uitvoer-lengte in het officiële kookboek. Kopieer deze B300-topologie niet naar H100/H200, GB200/GB300, AMD of multi-node-deploys; die profielen gebruiken andere TP/PP/DCP/EP-indelingen.
Test de server:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [{"role": "user", "content": "Give me a five-step debugging plan for a distributed Python application."}]
  }'
Voor een echte deployment: valideer capaciteit, outputkwaliteit en foutafhandeling op exact de SGLang-versie, topologie, contextlengte en verkeersmix die je wilt draaien.
vLLM vs SGLang vs llama.cpp
De keuze van de inferentie-engine hangt primair af van je hardware en het doel van de deployment.
| Deploymethode | Hardwareklasse | Officiële native gewichten | OpenAI-compatibele API | Gedistribueerde productie | Installatiegemak | Beste toepassing |
|---|---|---|---|---|---|---|
| vLLM | GPU-cluster van datacenterklasse | Ja | Ja | Uitstekend | Medium | Standaardkeuze voor productie |
| SGLang | GPU-cluster van datacenterklasse | Ja | Ja | Uitstekend | Medium–Hoog | Geavanceerde gedistribueerde serving |
| llama.cpp + GGUF | Werkstation/server met enorm geheugen | Community-kwant | Ja | Beperkt vergeleken met vLLM/SGLang | Laag–Medium | Lokale experimenten |
| Ollama + GGUF | Werkstation/server met enorm geheugen | Community-kwant | Ja | Niet de hoofdfocus | Makkelijk | Gemaksgerichte tests |
| CometAPI | Geen lokale GPU vereist | Gehost | Ja | Beheerd | Zeer makkelijk | Developers zonder K3-klasse hardware |
Als je een 8-GPU Blackwell/MI35x-klasse server bezit, begin dan met vLLM.
Als je een gespecialiseerde gedistribueerde inferentiecluster ontwerpt en meer laagdrempelige servingcontrole wilt, evalueer dan ook SGLang.assistant_message
Als je doel simpelweg is “ik wil bewijzen dat K3 op hardware die ik bezit kan draaien”, dan is GGUF plus llama.cpp veel toegankelijker—mits je machine werkelijk uitzonderlijk veel geheugen heeft.
How to Run a Quantized Kimi K3 with llama.cpp or Ollama
De community Kimi K3 GGUF-repository biedt nu llama.cpp-compatibele varianten.
Dit pad verlaagt de instapdrempel aanzienlijk vergeleken met een native-gewichtendeployment in het datacenter, maar “aanzienlijk” is relatief: zelfs de kleinere builds zijn honderden gigabytes.
Install llama.cpp on macOS or Linux
De huidige GGUF-modelkaart biedt:
curl -LsSf https://llama.app/install.sh | sh
Op Windows:
winget install llama.cpp
Start an OpenAI-compatible server
De repository documenteert momenteel UD-Q4_K_XL als voorbeeld:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Je kunt ook de CLI direct draaien:
llama cli \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Deze commando’s komen rechtstreeks uit de huidige Kimi K3 GGUF-modelkaart.
UD-Q4_K_XL is echter circa 1.51 TB, dus dit is niet de variant waarmee de meeste werkstationgebruikers beginnen. Als je prioriteit het verlagen van geheugeneisen is in plaats van het maximaal behouden van kwaliteit, onderzoek dan eerst de kleinere 1-bit- en 2-bit-varianten.
Bijvoorbeeld:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-IQ1_M
De huidige UD-IQ1_M-directory is ongeveer 649 GB.
Een model van 649 GB is nog steeds geen normaal laptopmodel. Idealiter bevindt de vaak benaderde modelstaat zich in snel geheugen. Zware SSD-offloading kan een extreem experiment technisch mogelijk maken zonder het bruikbaar te maken voor interactief werk.
Run the Same GGUF Build with Ollama
Ollama is een gemakslaag voor hetzelfde GGUF-deploypad, geen vierde onafhankelijke self-hostingmethode.
De K3 GGUF-repository biedt ook een Ollama-route.
Bijvoorbeeld:
bash
ollama run hf.co/unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Ollama vereenvoudigt modelbeheer en de API-ervaring, maar het verandert de geheugenvereisten van K3 niet.
Het wijzigen van de launcher van llama.cpp naar Ollama kan een kwantisatie van enkele honderden gigabytes niet veranderen in een 24 GB GPU-model. De onderliggende modeldata moeten nog steeds worden opgeslagen en benaderd.
Daarom is het het beste om Ollama te zien als een handige runtime-wrapper, niet als een hardwareworkaround.
Which Kimi K3 Quantization Should You Choose?
Voor experimenten is de keuze vooral een afweging tussen modelgrootte en fideliteit.
| GGUF-kwantisatiekeuzes | Grootte | Relatieve geheugendruk | Kwaliteitsverwachting | Aanbevolen gebruik |
|---|---|---|---|---|
| UD-Q1_0 | 466 GB | Laagst | Grootste risico op degradatie | Proof-of-concept |
| UD-IQ1_S | 594 GB | Zeer hoog | Agressief | Extreme lokale experimenten |
| UD-IQ1_M | 649 GB | Zeer hoog | Beter 1-bit-compromis | Experimentele server met veel geheugen |
| UD-Q2_K_XL | 861 GB | Extreem | Betere fideliteit | Grote CPU/GPU-server |
| UD-Q4_K_XL | 1.51 TB | Datacenterklasse | Hogere fideliteit | Kwaliteitsgerichte self-hosting |
| Native K3 serving | Datacenterklasse | Datacenterklasse | Bedoeld modelgedrag | Productie |
Important Kimi K3 Serving Behavior
Er is één K3-specifiek implementatiedetail dat gemakkelijk over het hoofd wordt gezien.
K3 gebruikt bewaarde denkgeschiedenis. Moonshot zegt dat meerstapsgesprekken en tool-callworkflows het volledige vorige assistentbericht terug naar het model moeten sturen, inclusief reasoning_content en tool_calls, in plaats van alleen de zichtbare content te behouden.
Een vereenvoudigd applicatiepatroon ziet er zo uit:
messages = [
    {
        "role": "user",
        "content": "Inspect this project and propose a migration plan.",
    }
 ]

first = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )

assistant_message = first.choices[0].message

 # Preserve the whole message object, not just assistant_message.content.
 messages.append(
    assistant_message.model_dump(exclude_none=True)
 )

messages.append(
    {
        "role": "user",
        "content": "Now identify the riskiest part of that plan.",
    }
 )

second = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )
Dit wordt vooral belangrijk voor codeeragents, toollussen en langlopende autonome sessies.
K3 houdt ook reasoning ingeschakeld en ondersteunt low, high en max reasoning effort. Wanneer jouw servinglaag deze parameters blootlegt, behandel reasoning effort dan als een extra regelaar voor latentie/kwaliteit, in plaats van het altijd te maximaliseren voor elk verzoek.
How to Optimize a Local Kimi K3 Deployment
Reserveer niet meteen de volledige 1M-context
K3 ondersteunt 1,048,576 tokens, maar maximale modelcapaciteit en een verstandige serverconfiguratie zijn verschillende zaken.
Begin voor ontwikkeling met iets als:
--max-model-len 131072
Verhoog daarna de context pas na het meten van beschikbaar geheugen, time-to-first-token, doorvoer en verwachte gelijktijdigheid.
Schakel prefix-caching in
Codeeragents hergebruiken vaak repository-instructies, toolschema’s, systeemprompts en lange prefixen.
Met vLLM:
--enable-prefix-caching
K3’s hybride attentie-architectuur vereiste speciale behandeling voor prefix-caching, en vLLM heeft modelspecifieke ondersteuning geïmplementeerd.
Gebruik de K3-parsers
Voor agentworkloads, include:
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3
Dit houdt tool-calls en reasoning-output in lijn met K3’s servingformaat.
Houd opslag snel
Een model op deze schaal legt ongebruikelijke druk op lokale opslag tijdens eerste download, checkpointladen, updates en herstel.
NVMe-opslag verdient de voorkeur boven langzaam netwerkschijven. Als meerdere machines modelbestanden delen, worden modelcache-topologie en netwerkbandbreedte onderdeel van de inferentiearchitectuur in plaats van louter deploydetails.
Monitor meer dan GPU-benutting
Houd bij:
- HBM/VRAM-gebruik
- CPU-RAM
- cache-hitratio
- tijd tot eerste token
- gedecodeerde tokens per seconde
- wachtrijdiepte van verzoeken
- inter-GPU-communicatie
- inter-node-bandbreedte
- mislukte tool-callparsing
- laadtijd van het model
Op K3-schaal vertelt een ogenschijnlijk gezond GPU-benuttingscijfer je niet of de servingtopologie efficiënt is.
Local Kimi K3 vs Hosted Kimi K3
Self-hosting geeft teams maximale controle over datapad, runtime en modelgewichten, maar maakt hen ook verantwoordelijk voor GPU-capaciteit, schaling, upgrades, monitoring en herstel. Gehoste toegang verwijdert het meeste infrastructuurwerk en is doorgaans de snelste route voor evaluatie of variabele vraag.
Voor de volledige hardware- en break-evenanalyse, lees Kimi K3 Self-Hosting vs API. Voor tokenprijzen, caching en K2.7-vergelijkingen gebruik je de Kimi K3-prijsgids. Dit artikel houdt de vergelijking daarom beknopt en concentreert zich op deploymentcommando’s, configuratie en troubleshooting.
Common Kimi K3 Local Deployment Problems
Het model past niet in GPU-geheugen
Dit is de meest voorspelbare fout.
Bereken geheugen niet vanuit de 104B geactiveerde parameters. Dat cijfer beschrijft per-tokenberekening, niet de hoeveelheid expertgewichten die het servingsysteem beschikbaar moet hebben.
Gebruik een ondersteunde gedistribueerde topologie, een kleinere GGUF-kwantisatie of een gehoste dienst.
CUDA- of NVIDIA-driverfouten
Het huidige vLLM K3-image is gebaseerd op CUDA 13 en vereist een hostdriver van R580+.
Als de host nog op een R575/CUDA 12.9-stack draait, update deze dan of volg het build-from-source-pad dat door vLLM is beschreven, in plaats van aan te nemen dat de container host-driverincompatibiliteit oplost.
Het eerste verzoek is extreem traag
Controleer of de checkpoint nog wordt geladen, kernels worden gecompileerd, caches worden opgewarmd of bestanden worden opgehaald.
Bij assets van multi-terabyteklasse zijn “serverproces gestart” en “model is klaar voor productieverkeer” geen equivalente toestanden.
Tool-calls falen af en toe
Het huidige vLLM-recept vermeldt dat K3 soms een tool-callvorm kan produceren die de parser niet verwacht. Productiesystemen moeten daarom tool-call-schema’s valideren en retries implementeren, in plaats van elke gegenereerde call blind te vertrouwen.
Lange gesprekken worden minder stabiel
Zorg ervoor dat je het volledige assistentbericht—met inbegrip van reasoning- en tolinformatie—naar volgende K3-beurten terugstuurt.
Het weggooien van verborgen reasoning-state-velden kan het patroon met bewaarde denkgeschiedenis doorbreken waarop K3 is getraind.
So, What Is the Best Way to Deploy Kimi K3 Locally?
Voor de meeste organisaties met geschikte hardware is vLLM het beste eerste deploypad. Het heeft toegewijde K3-ondersteuning, een OpenAI-compatibele API, modelspecifieke parsers, prefix-caching, ondersteuning voor speculatieve decodering en actuele hardwarerecepten.
Kies SGLang wanneer gedistribueerde inferentie-engineering en fijnmazige servingcontrole belangrijker zijn dan de kortste setuppath.
Kies llama.cpp plus een community-GGUF-kwantisatie alleen wanneer je doel werkstation-/serverexperimenten zijn en je begrijpt dat zelfs de 1-bitversies honderden gigabytes blijven.
Voor een conventioneel ontwikkelwerkstation is de meest praktische conclusie anders: koop geen honderden gigabytes RAM uitsluitend om K3 op een desktop te forceren. Test Kimi K3 via CometAPI eerst, kwantificeer de meerwaarde op je eigen taken en ga pas naar self-hosting wanneer privacy, langdurige benutting of controle over infrastructuur de economie rechtvaardigt.
FAQ
Kan Kimi K3 op één consument-GPU draaien?
Niet realistisch. Het model ligt ver voorbij de VRAM-capaciteit van consument-GPU’s. Community low-bit GGUF-kwantisaties verkleinen de footprint aanzienlijk, maar de kleinste huidige varianten zijn nog steeds honderden gigabytes.
Kan ik Kimi K3 op een Mac draaien?
Experimentele CPU/Apple-Silicon-executie met GGUF en opslagoffloading is in principe mogelijk, maar interactieve prestaties en geheugencapaciteit zijn de beperkende factoren. Een typische MacBook moet niet worden gezien als een praktisch K3-serveerplatform.
Ondersteunt Kimi K3 Ollama?
Community-GGUF-builds kunnen via Ollama worden gestart. De runtime vereenvoudigt de setup, maar verandert de onderliggende geheugenvereiste niet.
Is vLLM of SGLang beter voor Kimi K3?
vLLM is de gemakkelijkere standaard voor een nieuwe productiedeploy. SGLang is aantrekkelijk voor teams die verfijnde gedistribueerde servingtopologieën bouwen. Beide behoren tot Moonshots aanbevolen K3-inferentie-engines.
Hoeveel context ondersteunt Kimi K3?
De officiële modelspecificatie ondersteunt 1,048,576 tokens. Een lokale server hoeft het volledige contextvenster niet bloot te leggen; een lagere max-model-len kan praktischer zijn voor vroege deploy en hogere gelijktijdigheid.
Is Kimi K3 open source?
Een preciezere omschrijving is open-gewichten. Moonshot heeft de modelgewichten vrijgegeven onder de Kimi K3 License. Lees die licentie rechtstreeks voordat je commercieel herdistribueert of ander gebruik waarbij licentievoorwaarden van belang zijn.
Wat is de eenvoudigste manier om Kimi K3 te gebruiken zonder lokale GPU’s?
Een gehoste API is de eenvoudigste route. Kimi K3 is beschikbaar via CometAPI met een OpenAI-compatibele chat-completionsinterface, zodat de applicatiecode dicht bij wat je tegen een lokale vLLM- of SGLang-server zou gebruiken kan blijven.