
Running Qwen3.8-Max lokaal is nu mogelijk, maar de uitdrukking “Qwen 3.8 Max lokaal” vereist een belangrijke verduidelijking. Alibaba’s gehoste Max-product en de downloadbare checkpoint zijn nauw verwant, maar het zijn niet dezelfde producten.
Qwen lanceerde de gehoste Max-service begin augustus 2026 en bracht Qwen3.8-2.4T-A95B als open gewichten uit op 12 augustus 2026. Die checkpoint is het model dat je daadwerkelijk op je eigen infrastructuur implementeert.
Dit is geen normale Ollama-op-een-gaming-pc-handleiding. De ongekwantiseerde checkpoint is een Mixture-of-Experts-model met 2,4 biljoen parameters, en het huidige vLLM-recept bepaalt de BF16-gewichten op 4,45 TiB. Zelfs productiegerichte 4-bit drijvend-ekomma-varianten beslaan nog steeds ongeveer 1,3–1,5 TiB aan gewichten.
Kort antwoord: volledige zelfhosting van Qwen 3.8 Max-klasse is een datacenterimplementatie. Een praktische productie-startconfiguratie is een FP4-checkpoint op 8× B300 of 8× MI355X GPU’s; H200-implementaties hebben meer GPU’s nodig. Voor een normaal werkstation gebruik je in plaats daarvan Qwen3.8-27B.
Qwen 3.8 Max versus het open model dat je daadwerkelijk implementeert
De downloadbare Qwen3.8-2.4T-A95B-checkpoint wordt officieel beschreven als een causale taalmodel-checkpoint met 2,4T parameters en ongeveer 95B parameters die per token actief zijn. De gehoste Max-service voegt productlaag-capabilities toe die niet aanwezig zijn in de huidige open checkpoint.
| Specificatie | Qwen3.8-Max gehoste service | Qwen3.8-2.4T-A95B open checkpoint |
|---|---|---|
| Totale parameters | 2.4T | 2.4T |
| Actieve parameters | ~95B | ~95B |
| Architectuur | Sparse MoE | Sparse MoE |
| Invoer | Tekst, beeld, video | Tekst |
| Context | 1M beheerd context | 262.144 native; uitbreidbaar tot ~1,01M |
| Thinking-gedrag | Beheerde 'thinking'-/ 'non-thinking'-opties | Thinking vereist; redeneringsinspanning instelbaar |
| Ingebouwde tools | Beschikbaar op beheerde service | Applicatie moet tools leveren |
| Zelfhosting | Geen gewichtsbeheer vereist | Ja; open checkpoint |
Het gehoste product biedt tekst-, beeld- en videoinvoer met een context van 1.000.000 tokens. De open checkpoint daarentegen is alleen tekst en heeft een native context van 262.144 tokens. Dit verschil is belangrijk als je applicatie afhankelijk is van multimodale invoer of beheerde ingebouwde tools.
Qwen 3.8-architectuur en specificaties
CometAPI behandelt de modelachtergrond al in What is Qwen3.8 Max, dus deze implementatiegids richt de architectuurbespreking op details die invloed hebben op geheugen, parallelisme en serving.
| Implementatierelevante specificatie | Qwen3.8-2.4T-A95B |
|---|---|
| Totaal / actieve parameters | 2.4T / ~95B per token |
| Laagopbouw | 92 lagen: 69 Gated DeltaNet + 23 full attention |
| MoE-routing | 512 gerouteerde experts; 10 gerouteerd + 1 gedeeld actief |
| Full-attention heads | 64 query- / 4 key-value-heads |
| Native context | 262.144 tokens |
| Uitgebreide context | Tot ongeveer 1.010.000 tokens |
| Multi-Token Prediction | Ondersteund |
| Modality open checkpoint | Alleen tekst |
Officiële hybride Qwen-modelarchitectuur gebruikt in de SGLang Qwen3.8 deployment guide.
Interpreteer “95B actieve parameters” niet als een geheugenvoetafdruk van een 95B-model. Sparse activatie vermindert compute per token, maar het serving-systeem moet nog steeds toegang hebben tot de volledige set expertgewichten.
Qwen 3.8 Max benchmarkmomentopname
Omdat CometAPI’s bestaande Qwen3.8 Max-overzicht benchmarks al uitgebreid bespreekt, gebruikt dit artikel slechts een implementatierelevante subset uit de officiële Qwen model-card-benchmarktabel.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
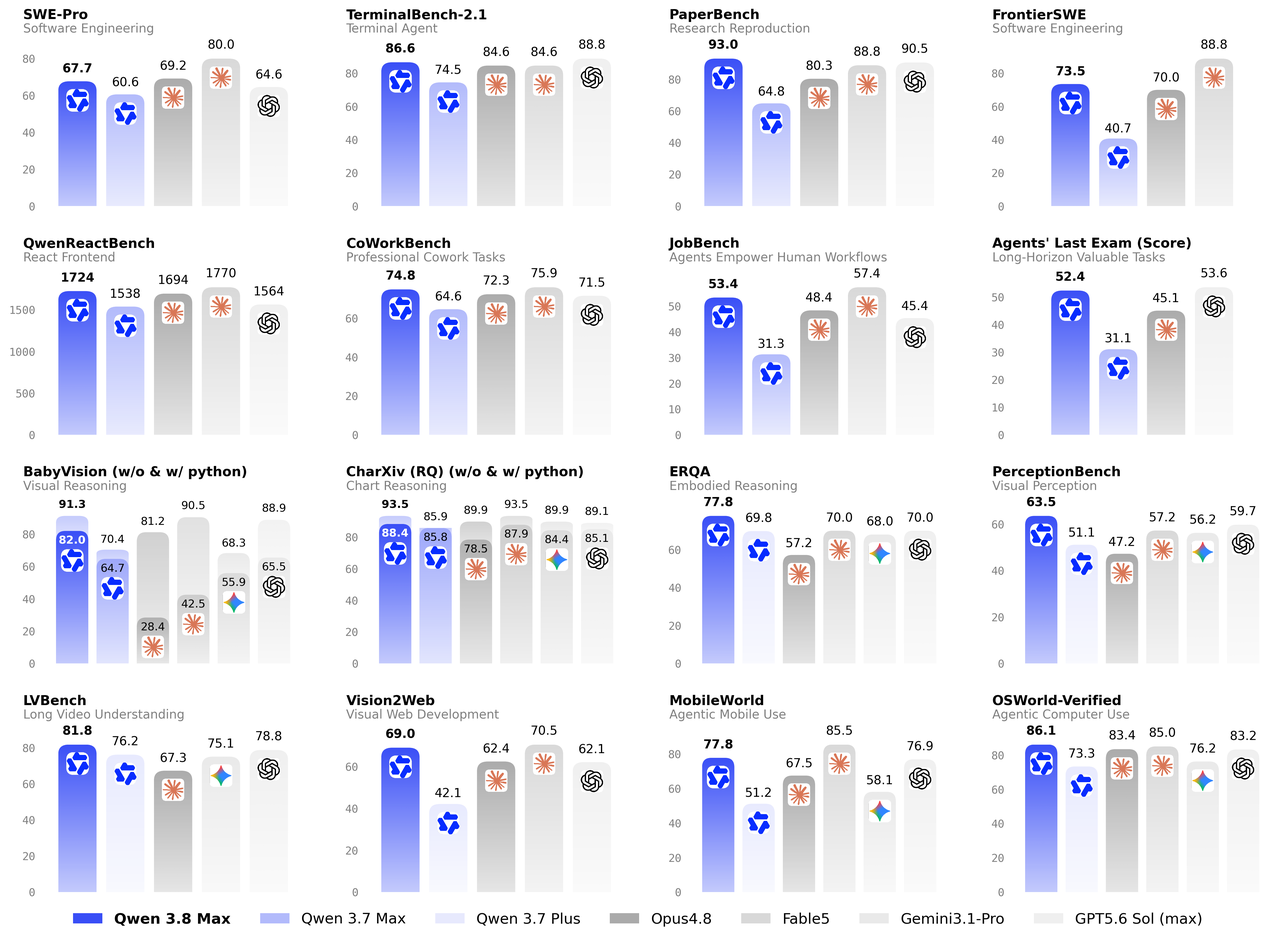
Officiële Qwen3.8-prestatiegrafiek gepubliceerd door het Qwen-team.
De grootste gerapporteerde verbeteringen ten opzichte van Qwen3.7-Max in deze subset zijn PaperBench en FrontierSWE. Qwen3.8-Max overtreft ook GPT-5.6 Sol op SWE-bench Pro en PaperBench, terwijl GPT-5.6 Sol voorloopt op Terminal Bench 2.1. Voor implementatiebeslissingen moet je dit zien als capaciteitscontext; de geheugen- en serving-doorvoermetingen hieronder zijn operationeel relevanter.
Benchmarktabellen zijn geen universele ranglijsten. Harnesses, time-outs, contextlimieten, tooltoegang en kwantisatie kunnen resultaten veranderen. Benchmark precies de checkpoint, precisie, serving-engine en promptverdeling die je van plan bent te gebruiken.
Welke hardware heeft Qwen3.8 nodig voor lokale implementatie?
GPU-vereisten voor Qwen3.8-2.4T-A95B
Dit is de sleutelvraag voor implementatie. Het huidige vLLM Qwen3.8-recept publiceert checkpoint-voetafdrukken en realistische GPU-aantallen met runtime-speling, wat nuttiger is dan VRAM schatten op basis van alleen het aantal parameters.
| Precisie | Gewicht-voetafdruk | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Beste toepassing |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPU’s | 24 GPU’s | 48 GPU’s | Maximale fideliteit / research |
| FP8 | 2.27 TiB | 16 GPU’s | 16 GPU’s | 32 GPU’s | Hoge-fideliteitsproductie |
| MXFP4 | 1.45 TiB | — | 8 GPU’s | 16 GPU’s | Praktische AMD-implementatie |
| NVFP4 W4A4 | 1.32 TiB | 8 GPU’s | — | 16 GPU’s | Praktische NVIDIA-implementatie |
Voor de meeste organisaties die daadwerkelijk zelfgehoste Qwen3.8 nodig hebben, is FP4 het praktische startpunt. De opvallende NVIDIA-configuratie is NVFP4 W4A4 op 8× B300; de overeenkomstige AMD-route is MXFP4 op 8× MI355X.
Een server met 8× H200 is niet genoeg voor deze aanbevolen volledige modelimplementaties. Het officiële recept bepaalt H200 op 16 GPU’s voor FP4, 32 voor FP8 en 48 voor BF16.
VRAM-vereisten voor Qwen3.8-27B
Qwen3.8-27B is het praktische alternatief voor de werkstationklasse. Ruw geheugen voor gewichten is ongeveer 54 GB in BF16, 27 GB in FP8 en 13,5 GB bij 4-bit-precisie. Runtime-overhead en KV-cache verhogen de werkelijke vereiste, vooral bij lange contextlengtes.
| Precisie | Geschat gewichtgeheugen | Praktische implementatierichtlijn |
|---|---|---|
| BF16 | ~54 GB | Gebruik een GPU van 64–80 GB, afhankelijk van context en serving-overhead. |
| FP8 / INT8 | ~27 GB | Een GPU van 40–48 GB biedt praktischer runtime-speling. |
| 4-bit | ~13,5 GB | Een consumenten-GPU van 20–24 GB kan haalbaar zijn bij matige contextlengtes. |
Deze cijfers zijn planningsschattingen afgeleid van het aantal parameters. Bevestig de exacte checkpoint, kwantisatieformat, serving-engine, contextlengte en KV-cache-instellingen voordat je productiehardware dimensioneert.
Kan Qwen3.8 draaien op consument-GPU’s?
Het volledige Qwen3.8-2.4T-A95B-model is niet praktisch op gewone consument-GPU’s, zelfs niet bij agressieve kwantisatie. Een communityproject heeft een agressief gecomprimeerde 397 GB UD-Q1_0-build aangetoond over vier DGX Spark-systemen, maar die route is een experimentele extreme kwantisatie in plaats van de baseline voor kwaliteitsgevoelige serving.
Voor een werkstation of home-lab is het meer geschikte model Qwen3.8-27B, waarvan de open gewichten op 14 augustus 2026 zijn uitgebracht. Het model is ordes van grootte eenvoudiger te hosten en is de juiste optie als “lokaal” één werkstation betekent in plaats van een GPU-cluster.
Voor je Qwen 3.8 Max installeert
Plan de infrastructuur voordat je een install-commando uitvoert. Je hebt Linux nodig, een compatibele acceleratorstack, voldoende lokale of gedeelde opslag voor de checkpoint, high-bandwidth GPU-interconnects en—bij node-overschrijding—een netwerk dat is ontworpen voor gedistribueerde inferentie. Het vLLM-recept beveelt momenteel vLLM nightly en Transformers 5.4.0 of nieuwer aan.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Hoe Qwen 3.8 FP8 implementeren met vLLM
FP8 is een verstandige keuze wanneer je een door Qwen geleverde checkpoint wilt en multi-node-infrastructuur kunt veroorloven. De officiële checkpoint is Qwen/Qwen3.8-2.4T-A95B-FP8.
Voor een twee-node, 16-GPU B300-klasse-implementatie voer je de head-node uit met:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Kopieer het 16-GPU-voorbeeld niet naar H200-servers zonder de topologie te herschalen. Dezelfde FP8-variant is in het vLLM-recept momenteel bepaald op 32× H200.
Hoe Qwen 3.8 op één 8× B300-server draaien
Voor NVIDIA Blackwell is de meest praktische volledige modelconfiguratie NVFP4. vLLM valideert momenteel NVFP4 W4A4 met tensorparallellisme over acht B300 GPU’s.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
De Inferact NVFP4-build is een gekwantiseerde checkpoint in plaats van het oorspronkelijke BF16 Qwen-artifact. Valideer de modelkwaliteit op je eigen acceptatieset voordat je het als drop-invervanging voor BF16 of FP8 behandelt.
Hoe Qwen 3.8 implementeren met SGLang
SGLang voegde Dag-0-ondersteuning voor Qwen3.8 toe op 12 augustus en is vooral aantrekkelijk voor high-throughput serving, prefixcaching, expertparallellisme, speculatieve decodering en prefill/decode-disaggregatie.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang rapporteert 346 outputtokens/s bij batchgrootte 1 op TP8 B300 met MTP, en aanzienlijk hogere totale doorvoer in gedisaggregeerde servinglayouts. Behandel die cijfers als metingen van de serving-stack, niet als modelkwaliteitsbenchmarks.
Test het lokale OpenAI-compatibele endpoint
Zowel vLLM als SGLang bieden OpenAI-compatibele API’s, wat applicatie-integratie eenvoudig maakt.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
De officiële modelkaart beveelt temperature=1.0, top_p=0.95 en top_k=20 aan als baseline-samplingparameters. Laat voor agentisch werk voldoende outputbudget over voor redenering in plaats van max_tokens alleen te dimensioneren voor het uiteindelijke zichtbare antwoord.
Schakel het 1M-contextvenster in
De open checkpoint Qwen3.8-2.4T-A95B heeft een native context van 262.144 tokens en kan worden uitgebreid tot ongeveer 1,01M. Het vLLM-recept documenteert het volgende patroon:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Maak 1M niet de standaard alleen omdat het wordt ondersteund. Grotere maximale contexten reserveren meer cachecapaciteit en kunnen de gelijktijdigheid sterk verminderen. Stel --max-model-len af op de echte workload.
Hoe de inferentieprestaties van Qwen3.8 verbeteren?
Gebruik MTP-3 om latency voor één gebruiker te verlagen
Qwen3.8 omvat Multi-Token Prediction. In vLLM’s gepubliceerde metingen verplaatst MTP-3 per-gebruiker-output van 130 naar 307 tok/s voor FP8 TP16 en van 133 naar 304 tok/s voor NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Gebruik fastsafetensors voor snellere opstart
Voor modellen op terabyteschaal is opstarttijd belangrijk. In één vLLM-meting daalde het laden van gewichten van 545 s naar 306 s met fastsafetensors en lazy loading.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Gebruik expertparallellisme om gelijktijdige doorvoer te vergroten
Voor hoge gelijktijdigheid profiteert Qwen3.8 van expert-parallel-layouts, omdat het 512 gerouteerde experts heeft. vLLM rapporteert tot 3.200 totale tok/s/GPU voor FP8 EP en tot 4.300 totale tok/s/GPU voor een geoptimaliseerde NVFP4 DEP16-configuratie.
Stel --max-model-len in om VRAM en gelijktijdigheid in balans te brengen
Stel --max-model-len in op de langste reeks die de workload echt vereist. Een grotere waarde reserveert meer KV-cachecapaciteit, verhoogt de geheugenbelasting en kan het aantal gelijktijdige verzoeken verminderen, zelfs wanneer de modelgewichten al passen.
Begin met een representatief productpercentiel in plaats van de maximale geadverteerde context van het model. Voer een loadtest uit met dezelfde precisie, batchpatroon en serving-engine die in productie worden gebruikt, en verhoog deze alleen wanneer echte verzoeken meer context nodig hebben.
Qwen 3.8 Max lokale implementatie versus API
Open gewichten maken lokale inferentie niet automatisch economisch. De juiste beslissing hangt af van benutting, gegevensresidentie, personeelsbezetting, beschikbaarheidseisen en of je de multimodale functies van het beheerde model daadwerkelijk nodig hebt.
| Dimensie | Zelfgehoste Qwen3.8-2.4T-A95B | Qwen3.8-Max via CometAPI |
|---|---|---|
| Infrastructuur | Multi-GPU-server of -cluster | Geen GPU-infrastructuur |
| Invoermodaliteit | Tekst | Tekst, beeld, video |
| Context | 262K native; ~1,01M uitgebreid | Beheerde 1M |
| Datacontrole | Maximum | Cloud-API |
| Operaties | Jij beheert monitoring, upgrades en HA | Door provider beheerd |
| Beste toepassing | Gegevensresidentie, constante benutting, infra-team | Meeste applicatieteams en variabele workloads |
Als je al over geschikte accelerators beschikt en consequent hoge benutting hebt, kan zelfhosting gerechtvaardigd zijn. Als je een cluster alleen voor dit model zou aanschaffen, is Qwen3.8-Max op CometAPI doorgaans het pad met de minste weerstand. De bestaande API-gids behandelt gehoste integratie, terwijl de prijsgids kostmodellen behandelt; dit artikel blijft daarom gericht op lokale implementatie.
Veelvoorkomende problemen bij lokale Qwen 3.8-implementatie
De server raakt tijdens opstarten zonder GPU-geheugen
Verlaag eerst --max-model-len als de cache het probleem is. Als de gewichten zelf niet passen, lost contextreductie de kern van het probleem niet op; ga over op een gevalideerde checkpoint met lagere precisie of voeg GPU’s toe.
Tensorparallellisme faalt met een ongeldige grootte
Qwen3.8 heeft 64 attention-heads in zijn full-attention-lagen, dus vLLM vereist dat TP 64 deelt. Eenvoudige TP-groottes zijn 1, 2, 4, 8, 16 en 32. Ruwe geaggregeerde VRAM is dus niet voldoende om een topologie te kiezen.
De server start langzaam op
Het laden van één tot meerdere terabytes aan gewichten plus kernel-JIT kan minuten duren. Verhoog VLLM_ENGINE_READY_TIMEOUT_S en peil een echte inferentie-endpoint in plaats van uit te gaan van een korte opstarttijd.
Het lokale model kan geen afbeelding verwerken
Dat is te verwachten. De open checkpoint Qwen3.8-2.4T-A95B is alleen tekst. Deze beperking is specifiek voor Qwen3.8-2.4T-A95B. Qwen3.8-27B ondersteunt visuele invoer wanneer zijn afzonderlijke vision-projection-bestanden worden geladen.
1M-context verlaagt de doorvoer drastisch
Verlaag --max-model-len naar de langste reeks die je workload daadwerkelijk nodig heeft. Het grootste ondersteunde contextvenster is niet per se de beste productiesetting; kies een contextlimiet die workloadvereisten, KV-cachegebruik en gelijktijdigheid in balans brengt.
Kunnen Ollama of LM Studio Qwen 3.8 Max draaien?
Het ecosysteem kan zwaar gekwantiseerde Qwen3.8-gewichten verpakken voor llama.cpp-achtige inferentie, maar dat moet niet worden verward met een normale desktop-Ollama-workflow. Een gekwantiseerde build die honderden gigabytes beslaat, vereist nog steeds honderden gigabytes aan toegankelijk geheugen en brengt aanzienlijke trade-offs in kwaliteit en prestaties met zich mee.
Voor gewone lokale ontwikkeling is Qwen3.8-27B het juiste doel. Het volledige 2,4T-model moet worden behandeld als een server/cluster-model, zelfs wanneer extreme community-quants het technisch op ongebruikelijke hardware opstartbaar maken.
Welke implementatiemethode moet je kiezen?
Voor NVIDIA Blackwell is een 8× B300 NVFP4-implementatie momenteel het schoonste volledige modelstartpunt. Voor AMD is 8× MI355X met MXFP4 de overeenkomstige praktische configuratie. Gebruik FP8 wanneer je checkpoint-herkomst en -kwaliteit boven infrastructuurgrootte stelt, en BF16 alleen wanneer maximale fideliteit de geheugenvereisten op multi-rack-schaal rechtvaardigt.
Voor een werkstation gebruik je Qwen3.8-27B. Voor applicatieteams die Max-capabilities nodig hebben zonder GPU-clusteroperaties, gebruik het gehoste Qwen3.8-Max-model op CometAPI.
Conclusie
Qwen3.8-Max heeft sinds de initiële API-lancering een belangrijke grens overschreden: de Max-klasse Qwen-familie heeft nu een open 2,4T-checkpoint dat organisaties volledig op hun eigen infrastructuur kunnen bedienen.
Maar open gewichten betekenen niet automatisch consumentenhardware. De BF16-voetafdruk van 4,45 TiB, de FP8-checkpoint van 2,27 TiB en de FP4-varianten van 1,3–1,5 TiB maken Qwen3.8-2.4T-A95B tot een van de meest infrastructuurintensieve open modellen die beschikbaar zijn. Het praktische voordeel is dat vLLM en SGLang de architectuur al ondersteunen, en FP4 maakt een one-node 8× B300- of 8× MI355X-implementatie haalbaar.
Host zelf wanneer datacontrole, constante benutting en infrastructuureigendom het cluster rechtvaardigen. Gebruik anders de beheerde Max-API—of Qwen3.8-27B wanneer je in feite een sterk Qwen-model op één werkstation wilt.