
Korte samenvatting: Om de Claude Fable 5.1 API in CometAPI te gebruiken, bereid een API-sleutel voor, stel de model-ID in op claude-fable-5-1, en valideer een kleine aanvraag voordat je een langere workflow bouwt. Deze gids behandelt toegang, effort, streaming, tools, caching, migratie en productiecontroles. Behandel uitrol als meer dan alleen het wijzigen van een modelstring: bevestig route-compatibiliteit, valideer outputs en meet de kwaliteit van geaccepteerde taken, latentie en kosten voordat je het gebruik uitbreidt.
Belangrijkste punten
- Zorg dat eerst één request werkt: bevestig inloggegevens, modeltoegang, het gekozen endpoint en een bruikbaar antwoord met niet-gevoelige testgegevens.
- Kies effort bewust: begin op hoog, vergelijk daarna andere instellingen op representatieve taken in plaats van elke aanvraag op maximale effort te draaien. Claude Code is standaard Hoog. Claude Cowork / Claude.ai is standaard Medium
- Review migratiegedrag:gedwongen toolselectie wordt afgewezen; behoud verplichte workflowstappen en tool-argumentvalidatie in applicatiecode.
- Meet de volledige workflow: volg cachegebruik, tokenkosten, latentie, weigeringen, fallback-gedrag en of het eindresultaat je acceptatiechecks haalt.
Voor achtergrond, zie CometAPI’s eerdere Fable 5.1-tracker en Fable 5 API-tutorial. Dit artikel concentreert zich op de huidige integratieworkflow.
Wat is Claude Fable 5.1?
Claude Fable 5.1 is Anthropic's krachtigste algemeen beschikbare model voor ambitieus coderen, meerstaps onderzoek, computergebruik en documentintensieve professionele workflows. Anthropic raadt aan de meeste workloads te starten met Claude Opus 5 en op te schalen naar Fable 5.1 wanneer evaluaties op hoge effort met Opus nog steeds tekortschieten.
Het onderscheid is operationeel: Fable 5.1 is ontworpen om door te werken over afhankelijke stappen, te herstellen na een mislukte toolaanroep, resultaten te verifiëren en voortgang te rapporteren tijdens lange runs. Dat kan voltooiingspercentages verbeteren, maar maakt kosten, latentie en observeerbaarheid ook centraal bij uitrol.
Claude Fable 5.1 API-specificaties
| Officiële specificatie | Claude Fable 5.1 |
|---|---|
| Provider | Anthropic |
| Model-ID | claude-fable-5-1 |
| Releasedatum | 1 september 2026 |
| Contextvenster | 1.000.000 tokens |
| Maximale output | 128.000 tokens |
| Input en output | Tekst en afbeeldingen naar tekst |
| Denken | Adaptief, altijd aan |
| Standaard effort | API is hoog, Claude Code is standaard hoog, Claude Cowork / Claude.ai is standaard medium |
| Effort levels | low, medium, high, xhigh, max |
| Knowledge cutoff | juni 2026 |
| Officiële prijs | $10 input / $50 output per miljoen tokens |
| Cache read | $0.25 per miljoen tokens |
De officiële overzichtspagina bevestigt een 1M contextvenster en 128K maximale output. Adaptief denken is altijd actief; de diepte van het redeneren wordt bestuurd met effort in plaats van een traditioneel denken-tokenbudget.
Claude Fable 5.1 API: officiële benchmarkprestaties
De benchmark-samenvatting is bewust compact omdat het hoofddoel van het artikel implementatie is. De resultaten hieronder markeren waar de API-premie het meest waarschijnlijk uitmaakt.
| Anthropic-benchmark | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 | 1.853 Elo | 1.723 | 1.824 | 1.711 |
| OSWorld 2.0, gedeeltelijk | 77,9% | 72,9% | 75,4% | — |
| Humanity's Last Exam, geen tools | 60,9% | 57,8% | 56,6% | — |
| AutomationBench | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 | 73,4% | 70,5% | 70,0% | 67,2% |
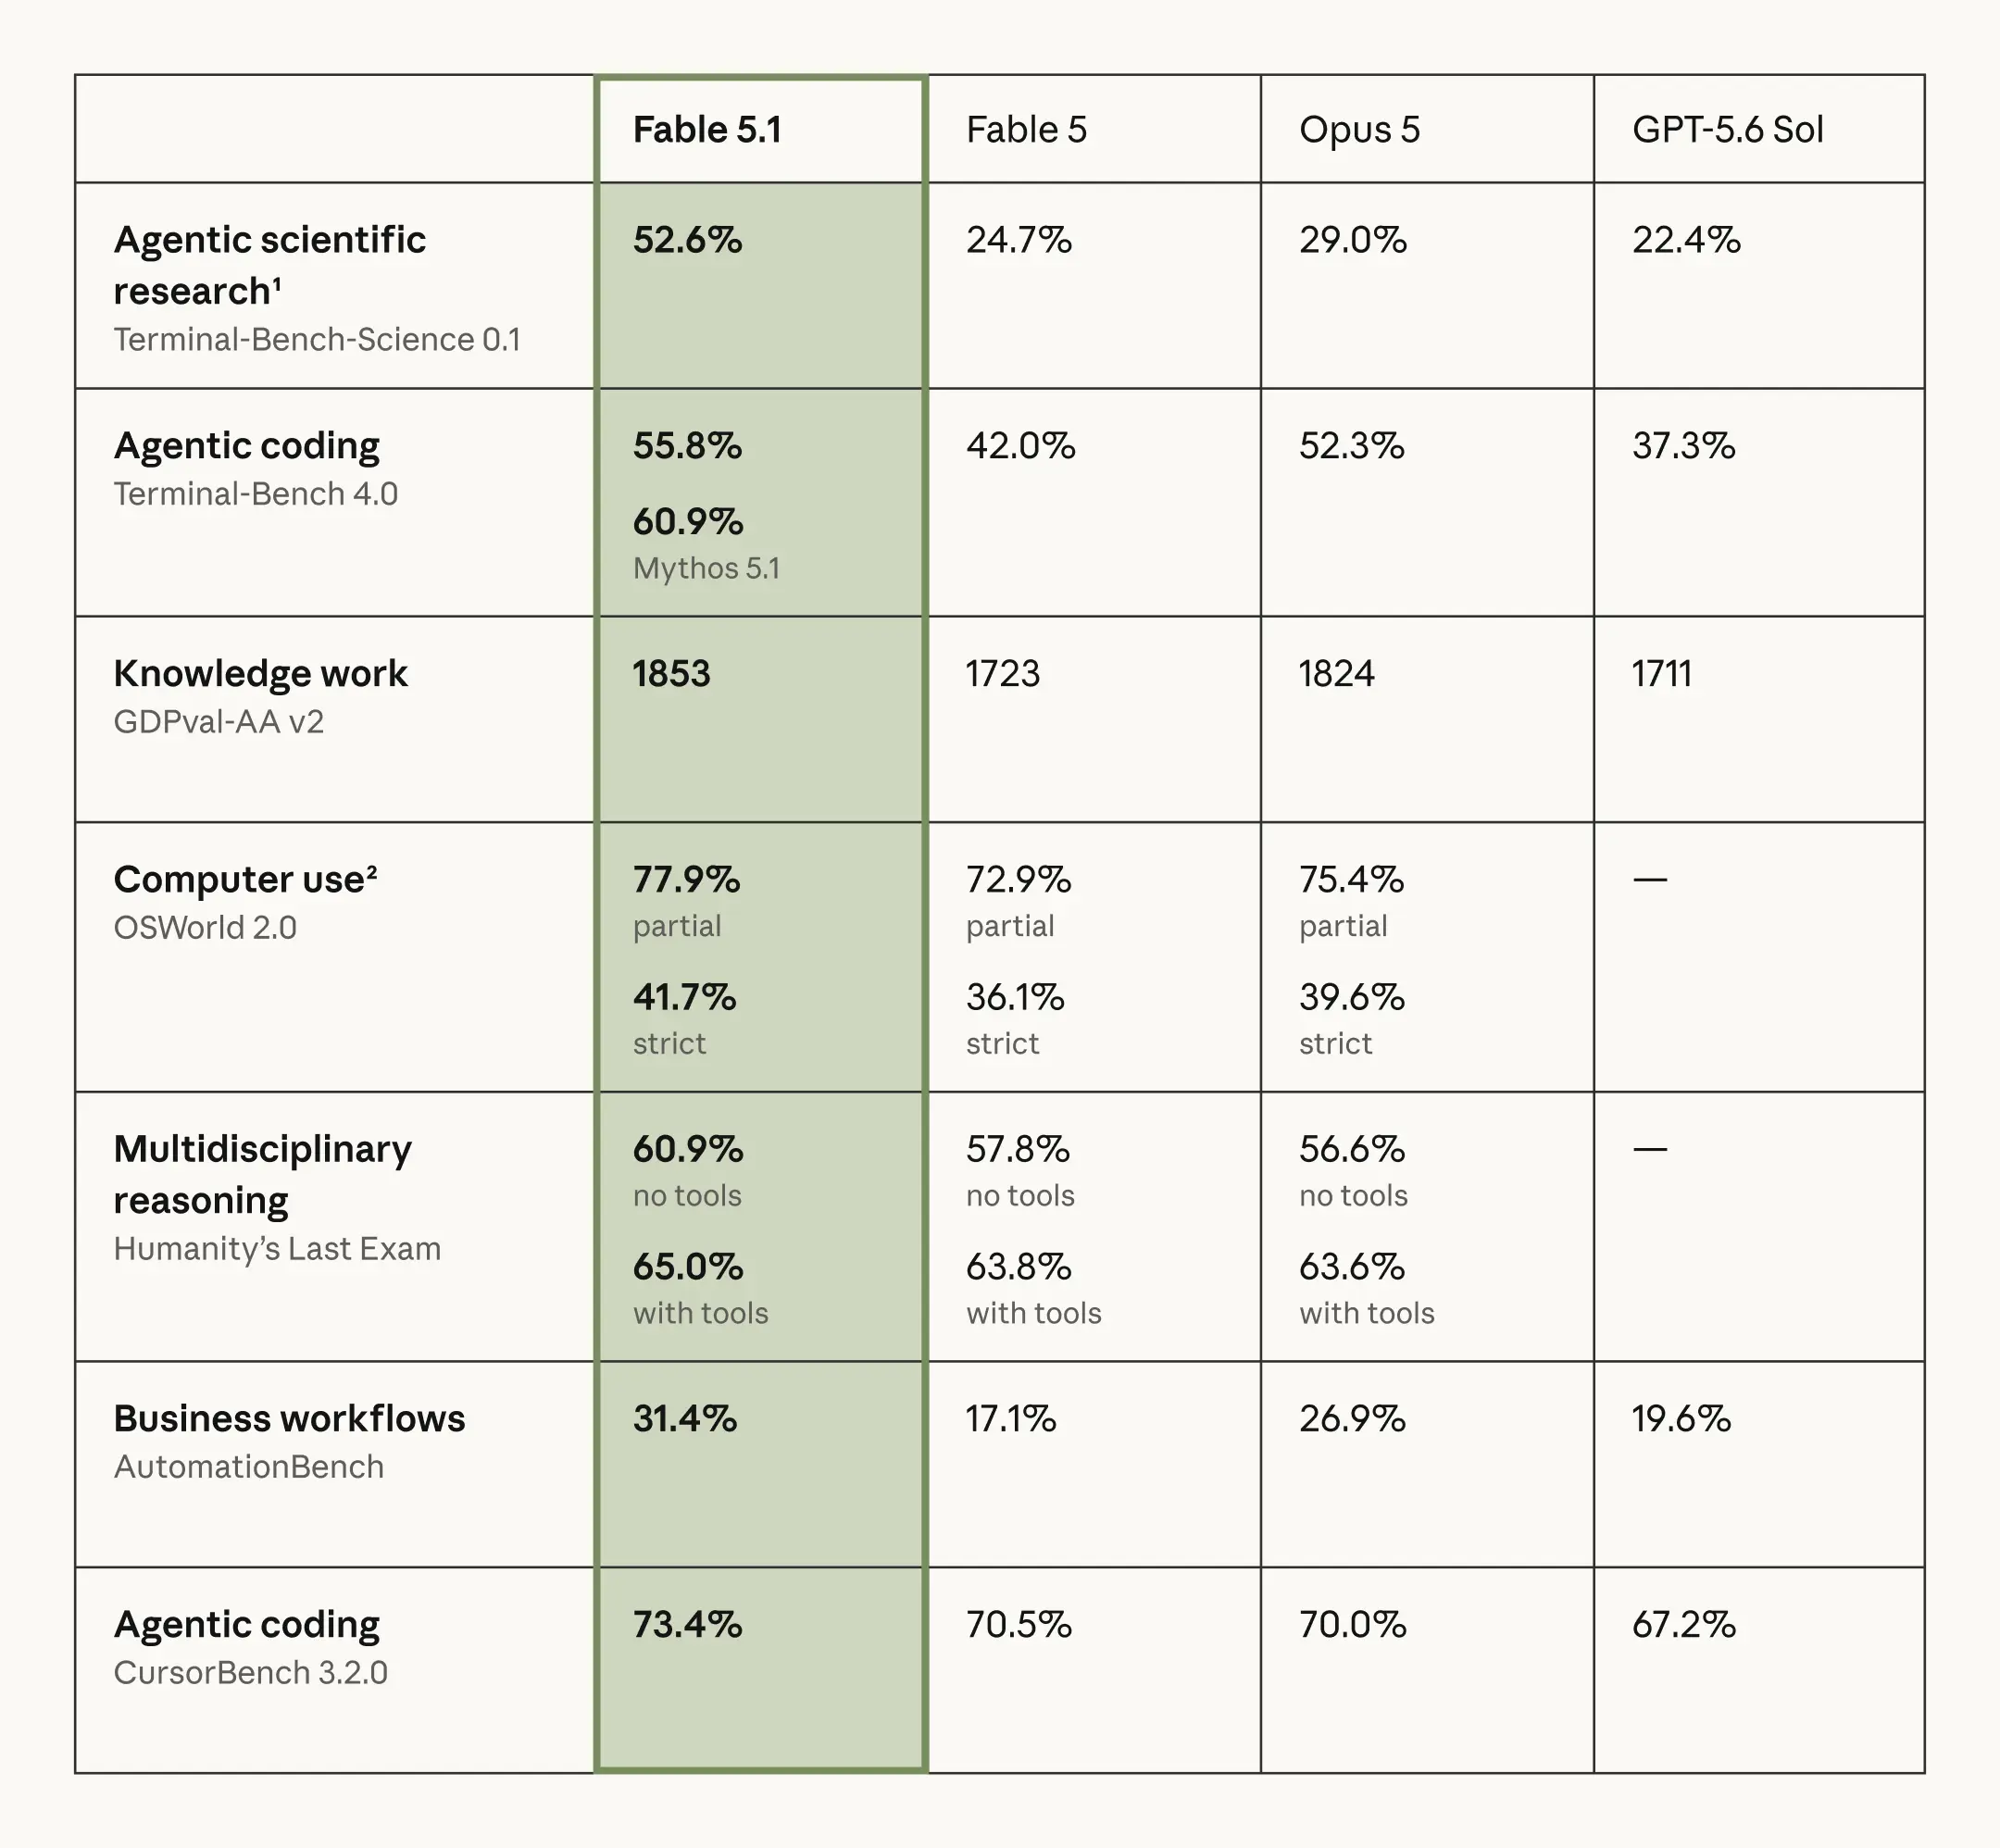
Anthropic’s officiële Claude Fable 5.1 benchmarkvergelijking
De grootste generatieverbetering in deze set is Terminal-Bench-Science: 52,6% versus 24,7%. AutomationBench stijgt van 17,1% naar 31,4%, terwijl Terminal-Bench 4.0 verbetert tot 55,8%. Het resultaat is een sterk pleidooi om Fable 5.1 te testen op onderzoeksagents, langlopende codeerwerkzaamheden en bedrijfsautomatisering—niet om elke korte aanvraag naar het duurste model te routeren.
Wat is veranderd ten opzichte van de Claude Fable 5 API?
| Dimensie | Claude Fable 5.1 | Claude Fable 5 | Migratie-impact |
|---|---|---|---|
| Kernrol | Sterkere langlopende agents en onderzoek | Oorspronkelijk publiek Mythos-klasse model | Her-evalueer de moeilijkste workflows |
| Gedwongen toolkeuze | Geeft een fout terug | Voorheen ondersteund | Verwijder elke en benoemde forcing |
| Denkgeschiedenis | Striktere compatibiliteitsregels | Eerder gedrag | Houd geschiedenissen append-only |
| Voortgangsupdates | Leesbare updates tussen toolaanroepen | Niet in deze vorm beschikbaar | Toon status van lange runs |
| Per-bericht effort | Beschikbaar in bèta | Niet in deze vorm beschikbaar | Diepte afstemmen binnen een gesprek |
| Cache read-prijs | $0.25 / MTok | $1.00 / MTok | Bereken lange-context-economie opnieuw |
| In-/outputprijs | $10 / $50 per MTok | $10 / $50 per MTok | Geen wijziging in lijsttarief |
Drie breaking changes
Gedwongen toolgebruik wordt niet langer ondersteund
Claude Fable 5.1 wijst tool_choice-waarden af die een tool afdwingen of een specifiek genoemde tool forceren, en retourneert een 400 invalid-request-fout. Houd automatische selectie aan, gebruik strikte schema’s of gestructureerde outputs voor validatie, en dwing verplichte workflowstappen af in applicatieorkestratie in plaats van via een verplichte model-toolaanroep.
Eerdere modellen kunnen Fable 5.1-denkblokken niet lezen
Compatibiliteit voor thinking is eenrichtingsverkeer: Fable 5.1 kan denkblokken consumeren die door eerdere compatibele Claude-modellen zijn gemaakt, maar eerdere modellen kunnen blokken van Fable 5.1 niet lezen. Een router of fallback die naar een eerder model overschakelt, kan die blokken voor inferentie laten vallen; integraties moeten modelswitches loggen en fallback-gedrag expliciet testen.
Bewerken van eerdere beurten maakt bewaarde denkblokken ongeldig
Het wijzigen van een eerdere systeemprompt, tooldefinitie, bericht of verwijzende bestandsbytes kan latere denkblokken ongeldig maken. Behandel de conversatieprefix als append-only, gebruik instructies midden in het gesprek in plaats van de geschiedenis te herschrijven, en monitor prefix-mismatch-transformaties tijdens migratie.
Vijf aanvullende API-mogelijkheden
Per-bericht effort
Applicaties kunnen effort tijdens een gesprek wijzigen zonder de promptcache ongeldig te maken. Deze bètafunctie laat een workflow effort verlagen voor routinematige follow-ups en verhogen voor moeilijke planning, debugging of verificatiebeurten.
Systeemberichten met beurt-scope
Een bèta-systeembericht kan voor één beurt gelden en stopt met renderen na het volgende gebruikersbericht, terwijl het ongewijzigd in de geschiedenis blijft. Dit is handig voor tijdelijke instructies in toollussen, omdat het zowel prompt-cachematching behoudt als de geldigheid van latere denkblokken.
Leesbare voortgangsupdates tussen toolaanroepen
Met de bèta-optie voor voortgangsweergave kunnen geselecteerde denkblokken korte statusupdates bevatten die een applicatie aan gebruikers kan tonen, terwijl privéredeneringen verborgen blijven. Langlopende agents moeten deze updates behandelen als operationele status, niet als definitieve antwoorden.
Lagere cache-read-prijs
Cache-reads kosten $0.25 per miljoen tokens, een kwart van het Fable 5-tarief voor cache-reads, terwijl basis in- en outputprijzen ongewijzigd blijven. Dit kan de kosten materieel verlagen voor lange sessies die herhaaldelijk een stabiele, gecachete prefix hergebruiken.
Herkomst van content
Gegenereerde tekst draagt Anthropic’s statistische watermark, terwijl ondersteunde media opgehaald via de Files API ondertekende C2PA Content Credentials kunnen bevatten. Deze provenance-mechanismen voegen geen prompttokens toe en vereisen geen wijzigingen in het requestformaat.
Wat heb je nodig voordat je de Claude Fable 5.1 API gebruikt?
- Een account en API-sleutel: log in op CometAPI en genereer een sleutel in de API-sleutelconsole. Controleer modeltoegang en dat je account klaar is voor verbruik-gebaseerde facturatie voordat je testcalls verstuurt.
- Een lokale runtime: gebruik een terminal met curl voor het eerste HTTP-voorbeeld. Bereid voor de Python-voorbeelden Python en pip in een geïsoleerde omgeving voor, en installeer de SDK die door je gekozen voorbeeld wordt gebruikt.
- Een geselecteerde route: de Claude Fable 5.1 API in CometAPI biedt Messages- en Chat Completions-formaten. Gebruik de bijpassende basis-URL en het requestformaat; mix hun payloads niet.
- Veilige configuratie: stel
COMETAPI_KEYin buiten gecommitte bronbestanden, gebruikclaude-fable-5-1als model-ID, en zorg dat je netwerkhttps://api.cometapi.com.kan bereiken. - Een veilige test en acceptatiecheck: begin met een korte, niet-gevoelige prompt. Bevestig dat de respons bruikbare content bevat, inspecteer gebruik en voltooiingsstatus, en check de data-afhandelingseisen van je organisatie voordat je echte documenten of logs indient.
Hoe krijg je toegang tot Claude Fable 5.1 via CometAPI
CometAPI stelt Claude Fable 5.1 beschikbaar via een Anthropic-compatibele Messages-route en een OpenAI-compatibele Chat Completions-route. Gebruik Messages wanneer je native effort, thinking, caching en Claude-toolsemantiek nodig hebt; gebruik Chat Completions wanneer je applicatie al is gestandaardiseerd op de OpenAI-SDK.
Stap 1: Sla de API-sleutel op
export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Stap 2: Doe de eerste Messages-aanvraag
curl https://api.cometapi.com/v1/messages \
  --header "Authorization: Bearer $COMETAPI_KEY" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "max_tokens": 2048,
    "messages": [{
      "role": "user",
      "content": "Review this deployment architecture and list the three highest-risk failure modes."
    }]
  }'
Stap 3: Gebruik de Anthropic Python SDK
pip install anthropic
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
)

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[{
        "role": "user",
        "content": "Find the root cause of this test failure and propose a verified patch.",
    }],
)

print(response.content[0].text)
Stap 4: Gebruik de OpenAI Python SDK
pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="claude-fable-5-1",
    messages=[{
        "role": "user",
        "content": "Design a migration plan for this service.",
    }],
)

print(response.choices[0].message.content)
Hoe werkt de redeneerfunctie van de Claude Fable 5.1 API?
Eerdere modellen kunnen Claude Fable 5.1-denkblokken niet lezen
Denkblokken geproduceerd door Fable 5.1 zijn niet achterwaarts compatibel met eerdere Claude-modellen. Als een workflow midden in een gesprek van model verandert, verwijder incompatibele denkblokken of start een nieuwe vertakking terwijl je alleen de voor de gebruiker zichtbare berichten en toolresultaten behoudt die nodig zijn voor de volgende aanvraag.
Het bewerken van eerdere beurten maakt bewaarde thinking ongeldig
Een bewaard denkblok is cryptografisch gebonden aan de voorafgaande conversatiestatus. Het wijzigen van een eerder systeembericht, tooldefinitie, gebruikersbericht, assistentantwoord of toolresultaat kan die binding verbreken en een fout in de denkgeschiedenis triggeren. Houd de afgespeelde prefix byte-voor-byte stabiel en voeg nieuwe beurten toe in plaats van oude te herschrijven.
Bewaarde thinking over beurten heen
Wanneer de conversatieprefix ongewijzigd blijft, kan bewaarde thinking nuttige redeneerstatus meenemen naar latere beurten. Sla denkblokken op met hun oorspronkelijke berichtvolgorde, speel ze alleen af naar een compatibel model, en behandel een bewerkingsactie in de geschiedenis als een nieuwe conversatievertakking in plaats van het bestaande transcript te muteren.
Beheers het redeneren met effort
Begin moeilijk productiewerk op hoge effort, test daarna lagere instellingen bij routinematige beurten en hogere instellingen alleen waar de kwaliteit van geaccepteerde taken voldoende verbetert om extra latentie en tokens te rechtvaardigen. Omdat effort tussen beurten kan veranderen, hoeft één gesprek niet langer één redeneerniveau te hebben.
Fable 5.1 gebruikt adaptief denken als de enige denkmodus. Begin op hoge effort, meet daarna lagere instellingen voor routinewerk en xhigh of max alleen wanneer extra capaciteit kosten en latentie rechtvaardigt.
| Effort | Aanbevolen rol | Afweging |
|---|---|---|
| low | Routinematig, goed gespecificeerd werk | Snelst en meest economisch |
| medium | Gebalanceerd productie-verkeer | Gematigde diepte |
| high | Standaard voor moeilijk werk | Beste startpunt |
| xhigh | Langlopende code en agents | Meer latentie en tokens |
| max | Moeilijkste taken met hoogste waarde | Kosten en latentie secundair |
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Audit this repository migration plan.",
    }],
)
Claude Fable 5.1 API: stream lange responses, gebruik tools en promptcaching
Configureer de volgende controles samen: redenerings-effort, streaming, toolexecutie, promptcaching en de afhandeling van safeguards en bewaarde data. Elk beïnvloedt hoe een langlopende aanvraag wordt geobserveerd, gevalideerd en bedreven.
Stream lange responses
Streaming is de veiligere standaard voor lange taken met hoge effort omdat je niet hoeft te wachten tot een grote respons is voltooid voordat de applicatie output ontvangt.
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
Gebruik tools zonder gedwongen toolkeuze
Fable 5.1 wijst gedwongen toolselectie af via tool_choice type any of een benoemde tool. Gebruik automatische selectie, strikte schema’s, valideer toolargumenten in applicatiecode, en bestuur verplichte workflow-sequencing buiten het model. Als een workflow vereist dat een specifieke tool draait, vertrouw dan niet op tool_choice om de volgorde af te dwingen. Laat de applicatie die tool aanroepen of implementeer de vereiste stap in orkestratiecode.
tools = [{
    "name": "search_incidents",
    "description": "Search recent production incidents",
    "input_schema": {
        "type": "object",
        "properties": {
            "service": {"type": "string"},
            "days": {"type": "integer"},
        },
        "required": ["service", "days"],
    },
}]

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    tools=tools,
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "Review checkout incidents from the last 30 days.",
    }],
)
Gebruik promptcaching voor lange contexten
Anthropic noemt cache-reads van $0.25 per miljoen tokens, een kwart van het Fable 5-tarief. Zet stabiele systeeminstructies, toolschema’s en grote referentiematerialen vóór dynamische gebruikerscontent, en verifieer cache-hits in gebruiksmetadata.
messages = [{
    "role": "user",
    "content": [
        {
            "type": "text",
            "text": large_reference_document,
            "cache_control": {"type": "ephemeral"},
        },
        {
            "type": "text",
            "text": "Identify obligations that changed in this revision.",
        },
    ],
}]
Ga om met safeguards en gegevensretentie
Anthropic stelt dat veel gemarkeerde cyberbeveiligings- en biologieaanvragen routeren naar minder capabele modellen. Behandel een weigering of fallback als een applicatiestatus: registreer de stopreden, toon een passend gebruikersbericht, en routeer naar een goedgekeurd alternatief waar beleid dat toestaat.
Fable vereist bovendien standaard 30 dagen gegevensretentie voor veiligheidsmonitoring. Bevestig organisatorische geschiktheid en retentie-instellingen voordat je een syntactisch geldig request debugt alsof het alleen een API-formaatprobleem is.
Fable 5.1 vs Opus 5 vs Sonnet 5
| Beslissingsdimensie | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Context / max output | 1M / 128K | 1M / 128K | 1M / 128K |
| Officiële in-/output | $10 / $50 | $5 / $25 | $2 / $10 |
| Relatieve latentie | Langzamer | Gemiddeld | Snel |
| Standaard effort | high | high | high |
| Belangrijkste kracht | Maximale langetermijncapaciteit | Premium algemeen redeneren | Snelheids-/kostbalans |
Selectieresultaat: start routinetraffic op Sonnet 5, gebruik Opus 5 voor complex algemeen werk, en schaal alleen de moeilijkste of herhaaldelijk mislukte taken op naar Fable 5.1. Dit volgt de richtlijnen van Anthropic en voorkomt dat premium redeneren de standaardkosten van elke aanvraag wordt.
Prijzen via CometAPI
| Route | Input / MTok | Output / MTok | Cache read / MTok |
|---|---|---|---|
| Anthropic lijstprijs | $10 | $50 | $0.25 |
| CometAPI vermelde prijs | $8 | $40 | Check live route |
| Nominaal verschil in-/output | 20% lager | 20% lager | Varieert per route |
De live CometAPI-modelpagina is de bron van waarheid voor huidige routebeschikbaarheid en prijzen. Voor een request met 100.000 niet-gecachete inputtokens en 10.000 outputtokens is de eenvoudige CometAPI-schatting $1,20; de werkelijke kosten kunnen veranderen door caching, redeneren, batchgedrag en routing. Prijzen kunnen wijzigen; controleer de live modelpagina voordat je productie-begrotingen maakt.
Migratiechecklist vanaf Fable 5
- Wijzig de model-ID van claude-fable-5 naar claude-fable-5-1.
- Verwijder tool_choice any en named-tool forcing; gebruik auto.
- Vervang oude aannames over thinking-budget door output_config.effort.
- Begin evaluatie op high effort, stem daarna af op echte taken.
- Houd geschiedenissen append-only wanneer ze bewaarde denkblokken bevatten.
- Verhoog max_tokens voor lange runs met hoge effort.
- Verifieer cache-hits vanuit gebruiksmetadata.
- Behandel weigeringen en fallbacks als expliciete staten.
- Speel productie-traces af en vergelijk geaccepteerd-tarief, latentie en kosten.
Veiligste migratiestrategie: houd geschiedenissen append-only. Fable 5.1 kan denkblokken over beurten heen bewaren, maar afgespeelde denkblokken zijn gebonden aan de voorafgaande conversatiestatus; het wijzigen van eerdere systeemprompts, tools of berichten kan die binding ongeldig maken.
Veelvoorkomende API-fouten
400-fout na wijziging van toolaanroepen
Waarschijnlijke oorzaak: gedwongen tool_choice met any of een genoemde tool. Gebruik auto en dwing de vereiste volgorde af in applicatielogica.
claude-fable-5.1 werkt niet
De canonieke ID gebruikt koppeltekens: claude-fable-5-1.
Output stopt eerder dan verwacht
effort controls how much reasoning the model performs, while max_tokens limits the response token budget. Higher effort can require more output budget, so production applications should tune both independently. Raise max_tokens where justified and stream long responses.
Promptcache raakt nooit
Houd de gecachete prefix byte-voor-byte stabiel; timestamps, herordende tools en veranderende systeemberichten voorkomen hergebruik.
Een HTTP-succesrespons bevat geen normaal antwoord
Inspecteer stop_reason en fallback-metadata in plaats van elke weigering als een transportfout te behandelen.
Het opnieuw afspelen van geschiedenis levert een thinking-fout op
Bewerk eerdere beurten niet vóór bewaarde Fable 5.1-denkblokken. Gebruik append-only geschiedenis of huidige migratiecontroles.
Hoe moet je de Claude Fable 5.1 API in productie gebruiken?
Scheid requestrouting, modelexecutie, toolexecutie, validatie en evaluatie. Log model-ID, effort, latentie, tokengebruik, cachegebruik, stopreden, fallback-gedrag en uiteindelijke taaksucces.
Gebruik Fable 5.1 voor repository-brede migraties, moeilijke debugging, langlopende agents, diep onderzoek, synthese van grote documenten en hoge-waarde taken waar goedkopere modellen herhaaldelijk falen. Vermijd het als standaard voor samenvattingen, classificatie, extractie en korte klantenservice-antwoorden.
Voorbeeld: onderzoek een checkout-incident
Een team kan geanonimiseerde checkout-fouten, recente deployment-diffs en relevante runbooks aanleveren. De applicatie haalt bijpassende incidentrecords op en vraagt het model vervolgens om mogelijke oorzaken te rangschikken en elke hypothese te koppelen aan bewijs. Een engineer beoordeelt de voorgestelde diagnostische stappen en keurt een test goed in een sandbox met synthetische transacties. De acceptatiepoort is reproduceerbaar gedrag, herleidbaar bewijs en geslaagde regressiechecks; elke productie-remediatie vereist aparte menselijke goedkeuring.
Voorbeeld: analyseer wijzigingen in operationele vereisten
Een team kan een goedgekeurde operationele handleiding, ondersteunend beleid en een herziene conceptversie aanleveren. Houd het ongewijzigde referentiemateriaal als stabiele context, en vraag het model vervolgens om gewijzigde verplichtingen, verantwoordelijke teams, deadlines en uitzonderingen te vergelijken. Elke voorgestelde bevinding moet verwijzen naar de relevante passages in beide versies en expliciete wijzigingen onderscheiden van onzekere interpretaties. De acceptatiepoort is dat een reviewer elke gerapporteerde wijziging bevestigt aan de hand van het geciteerde bewijs voordat procedures worden bijgewerkt of betrokken teams worden geïnformeerd.
Conclusie
Claude Fable 5.1 is geen drop-in update van een modelstring. Het gedrag rond gedwongen tools, regels voor denkgeschiedenis, effort-controls, cache-economie en voortgangsfunctionaliteit voor lange runs vereisen een doordachte migratie.
De meest effectieve uitrol gebruikt Claude Sonnet 5 voor routinematig volume, Claude Opus 5 voor complex standaardverkeer, en Claude Fable 5.1 als gemeten capaciteitsescalatie. Promoveer het alleen wanneer de voltooiing van geaccepteerde taken voldoende verbetert om totale kosten en latentie te rechtvaardigen.