
De snelste manier om de GLM-5.3 Flash API te gebruiken is het model aanroepen via CometAPI’s OpenAI-compatibele chat-completions-eindpunt. De verbindingsgegevens zijn samengebracht in de API-specificatietabel hieronder; bewaar de API-sleutel op de server.
Antwoord eerst: maak een CometAPI-sleutel aan, installeer een OpenAI-compatibele SDK, stuur een POST-verzoek naar /v1/chat/completions, en voeg pas daarna streaming, vision, JSON-uitvoer of tools toe wanneer het basisverzoek slaagt.
Wat is de GLM-5.3 Flash API?
GLM-5.3 Flash is Z.ai’s efficiëntie-gerichte native multimodale model binnen de GLM-5-familie. Het biedt redeneren, lange context, visueel begrip en agent-georiënteerde mogelijkheden via een chat-API. Het model bevat 320B totale parameters maar activeert 18B per token; die architectuur is belangrijk voor kosten, maar ontwikkelaars ervaren dit vooral als een model dat actief kan blijven bij lange prompts en herhaalde tool-calls.
Deze gids houdt architectuur- en benchmarkdekking bewust kort. Het begeleidende modeloverzicht legt de hybride attentie-opzet, open gewichten, volledige benchmark-matrix bij lancering, prijsachtergrond en vergelijking binnen de modelfamilie al uit. Hier ligt de focus op integratiegedrag en productie-beslissingen.
API-specificaties die integratie beïnvloeden
| API specification | Value | Practical meaning |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Stel dit één keer in in de server-side client. |
| Endpoint | POST /v1/chat/completions | Gebruik de OpenAI-compatibele chat-completions-route. |
| Compatible SDKs | OpenAI-compatible Python and JavaScript clients | Hergebruik bekende clientpatronen met de CometAPI-basis-URL. |
| Authentication | Bearer API key | Bewaar de sleutel in een server-side omgevingsvariabele of secret manager. |
| Model code | glm-5.3-flash | Gebruik exact deze waarde in de request body. |
| Context window | 1,048,576 tokens | Geschikt voor grote repositories, documentpakketten en lange agent-histories. |
| Maximum output | Up to 131,072 tokens | Stel een lagere, toepassingsspecifieke limiet in voor kosten- en latentiebeheersing. |
| Native inputs | Text, image, video, file | Ondersteuning per gehoste route kan verschillen; valideer de exacte CometAPI-route per modaliteit. |
| Output | Text | Het model interpreteert media maar retourneert geen gegenereerde beelden of video. |
| Reasoning | low, high, max | Gebruik inspanningsniveaus om latency en tokenverbruik tegen diepgang af te wegen. |
| Thinking | Always enabled | Stuur geen parameter die proberen het denken uit te schakelen. |
| Developer features | Streaming, function calling, caching, structured output | Handig voor interactieve apps, agents en machine-leesbare pipelines. |
Modelcapaciteit en gatewaycapaciteit zijn niet identiek. Behandel de live CometAPI-modelpagina en de API-schema’s als het contract voor de route die u daadwerkelijk aanroept, vooral voor video, bestanden, strikte JSON Schema en provider-specifieke thinking-velden.
Korte prestatiecontext
Z.ai rapporteert sterke lanceringsresultaten voor taken die belangrijk zijn voor API-bouwers: terminalwerk, software engineering, toolgebruik en automatisering. Dit zijn door de leverancier gerapporteerde scores met specifieke harnesses en toolbeleid; ze helpen waarschijnlijke sterktes te identificeren in plaats van een universele rangorde vast te stellen.
| Benchmark | GLM-5.3 Flash | What it suggests for API workloads |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Sterke match voor terminal-gedreven coding-agents. |
| DeepSWE v1.1 | 63.4 | Veelbelovend voor repository-schaal software-engineering. |
| Toolathlon Verified | 78.4 | Sterk signaal voor toolselectie en toolgebruik. |
| AutomationBench | 48.8 | Verbeterde meerstapsautomatisering t.o.v. voorganger. |
De praktische implicatie is smaller dan de benchmarktabel: GLM-5.3 Flash is een sterke kandidaat wanneer de workflow lange context combineert met tools of visuele feedback. Voor een volledige modelvergelijking gebruikt u het bestaande modeloverzicht in plaats van dit hier te dupliceren.
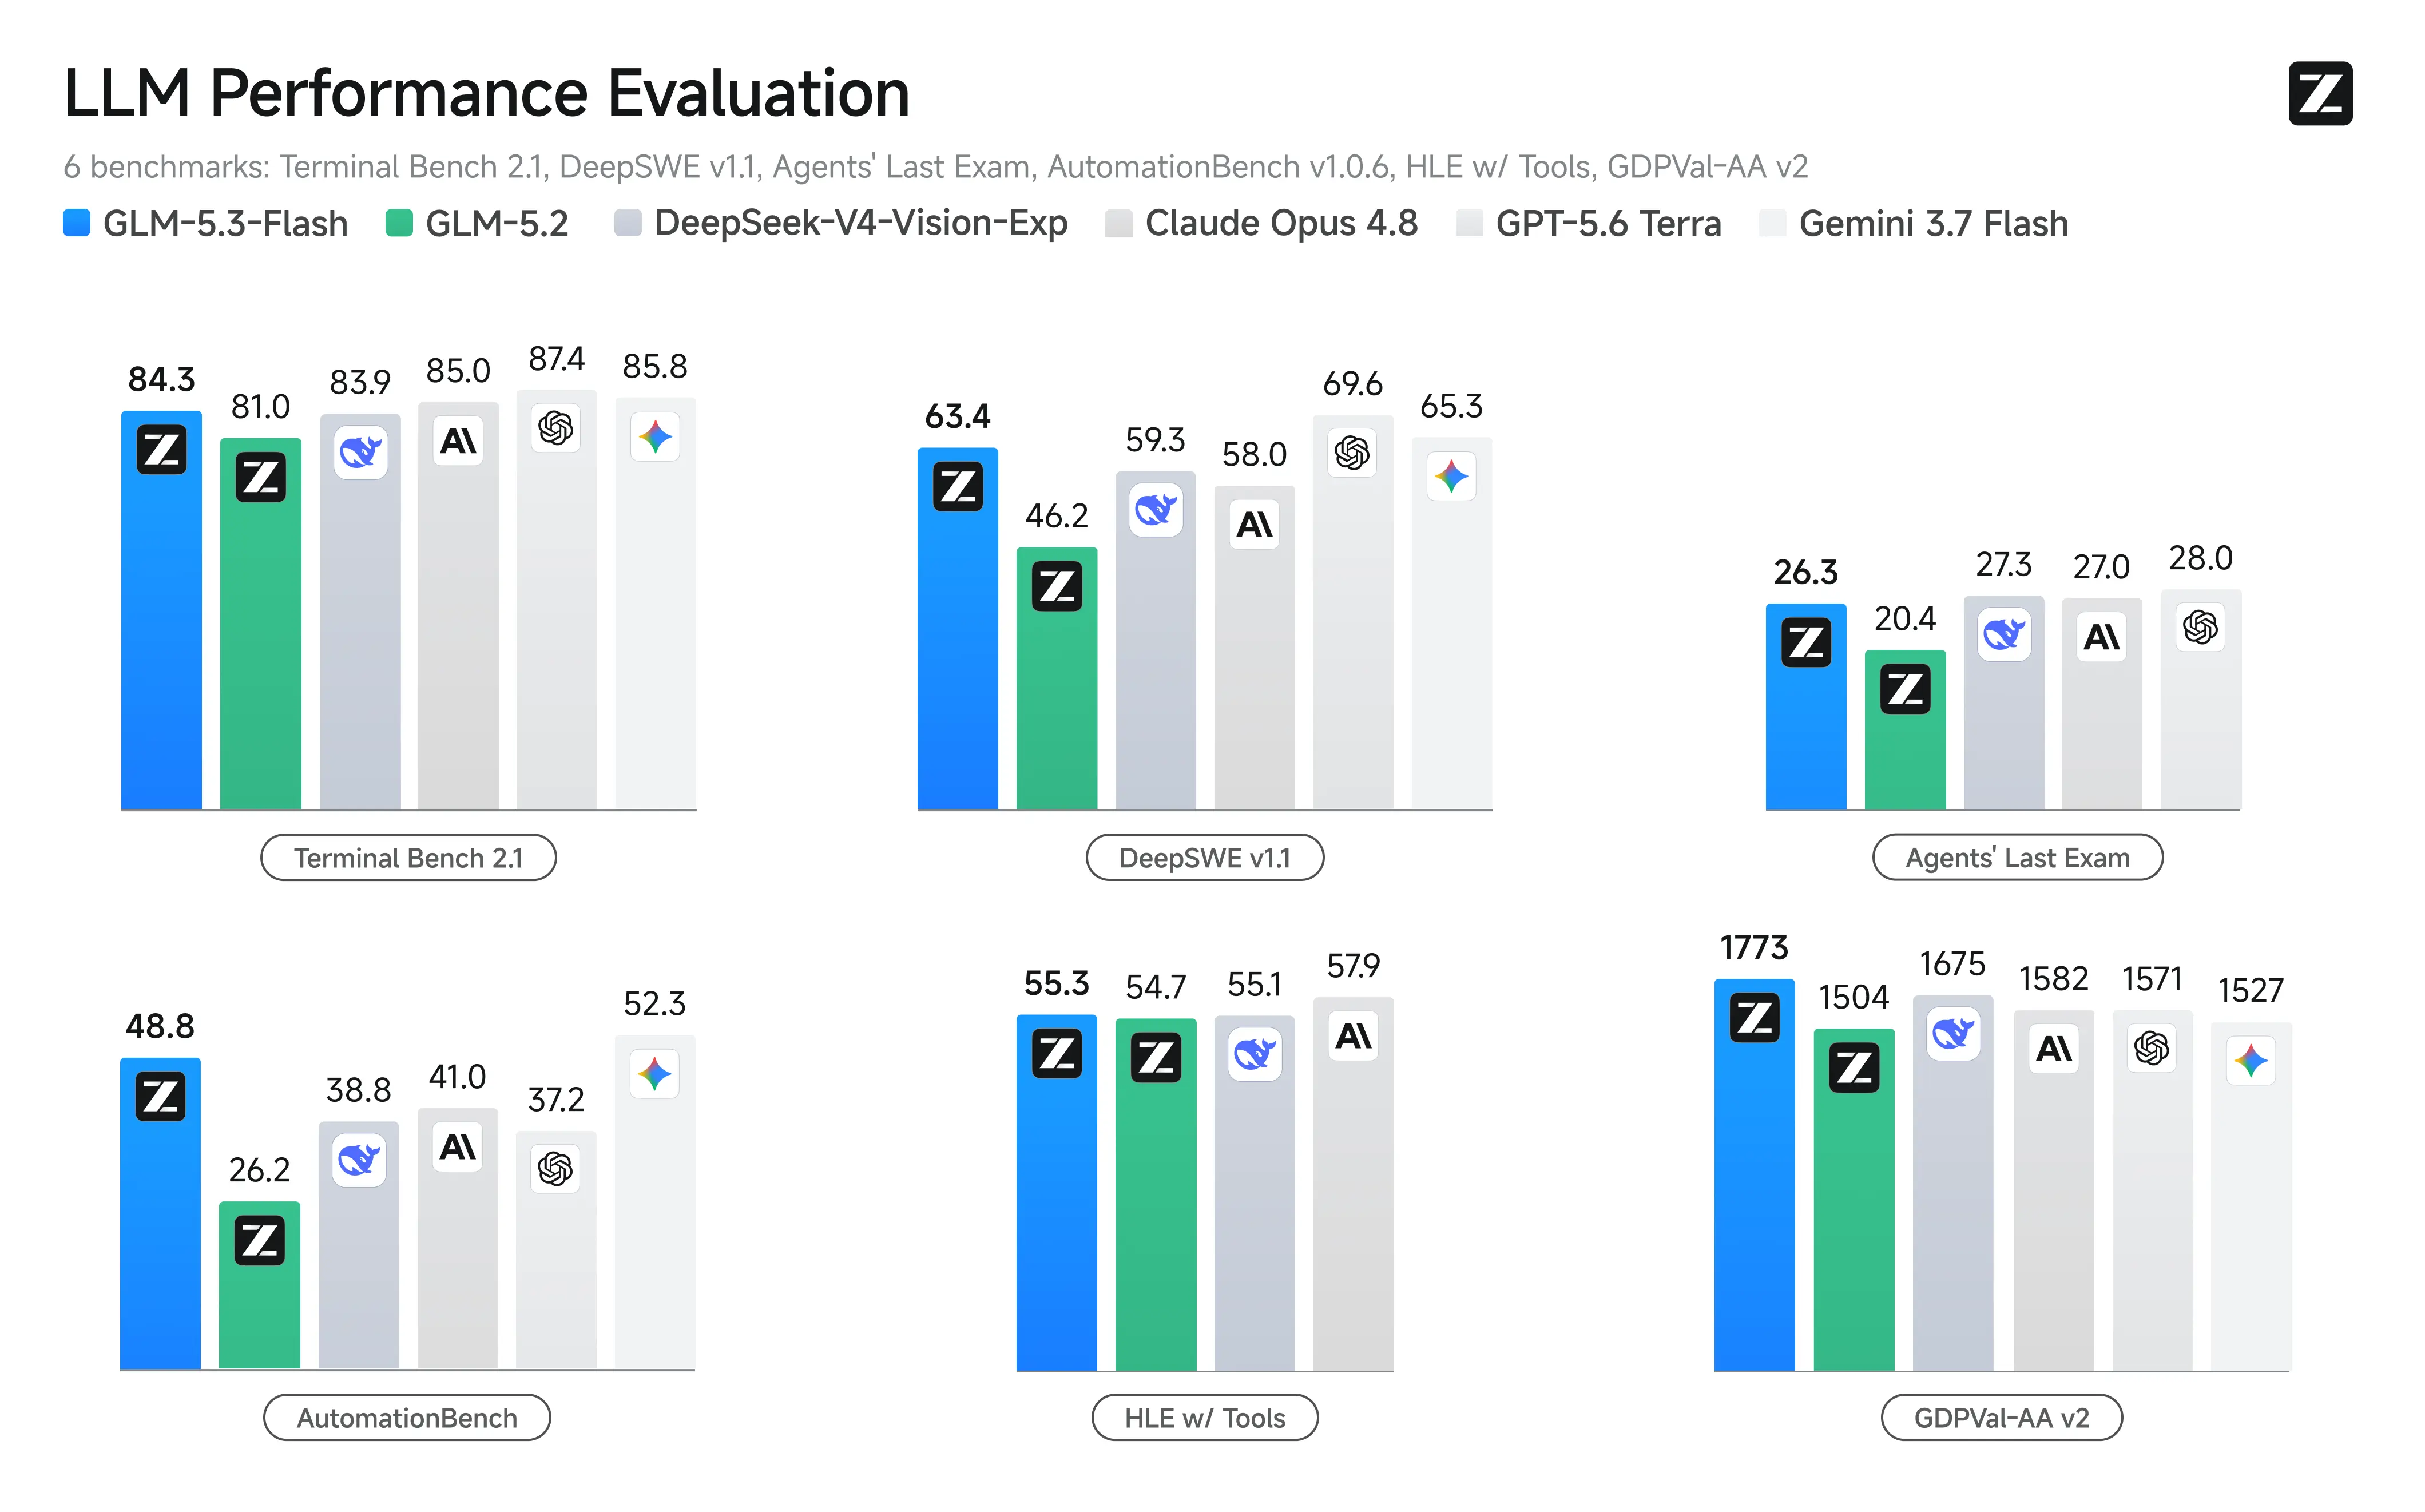
Bron: Z.ai officiële benchmarkgrafiek
De officiële benchmarkgrafiek vergelijkt GLM-5.3 Flash-prestaties over model- en inspanningsinstellingen. Voor deze API-gids biedt het beknopte context zonder de volledige matrix te herhalen. Toepassingen moeten nog steeds taakresultaat, end-to-end-latency en totaal tokenverbruik meten op hun eigen prompts.
Waarom GLM-5.3 Flash via CometAPI gebruiken?
CometAPI biedt GLM-5.3 Flash via een OpenAI-compatibele interface. Zo kan een team bekende SDK-patronen hergebruiken, credentials en facturatie centraliseren en modellen wisselen zonder de volledige request-laag te herbouwen.
• Eén integratiepatroon. Dezelfde basisclient kan verschillende ondersteunde modellen aanroepen door de model-ID te wijzigen.
• Gecentraliseerd inzicht in gebruik. Teams kunnen gebruik en kosten bekijken zonder voor elke provider een apart dashboard te beheren.
• Snellere evaluatie. Eén request-harnas kan responskwaliteit, latency en fouten vergelijken tussen kandidaatmodellen.
• Eenvoudiger fallback-ontwerp. Toepassingen kunnen retry- en routeringslogica in één gatewaylaag houden.
• Lager vermelde routeprijs. De huidige modelpagina vermeldt $0.06 per miljoen inputtokens en $0.20 per miljoen outputtokens; verifieer de live pagina vóór budgettering.
Voordat u begint
U heeft een CometAPI-account, een API-sleutel en een van de volgende lokale omgevingen nodig:
• Python 3.9 of hoger met pip
• Node.js 18 of hoger met npm
• cURL voor een minimale command-line test
Plaats nooit een productie-CometAPI-sleutel in browser-JavaScript, een mobiele app, een openbare repository, een screenshot of client-side logs. Roep CometAPI aan vanaf een vertrouwde server en bewaar de sleutel in een omgevingsvariabele of secret manager.
GLM-5.3 Flash API gebruiken met CometAPI
Stap 1: Maak een CometAPI API-sleutel
Meld u aan bij CometAPI, open de API-sleutelconsole, maak een sleutel aan en kopieer deze één keer naar uw secret-managementworkflow. Gebruik een aparte sleutel voor ontwikkeling en productie zodat u één omgeving kunt roteren of intrekken zonder de andere te onderbreken.
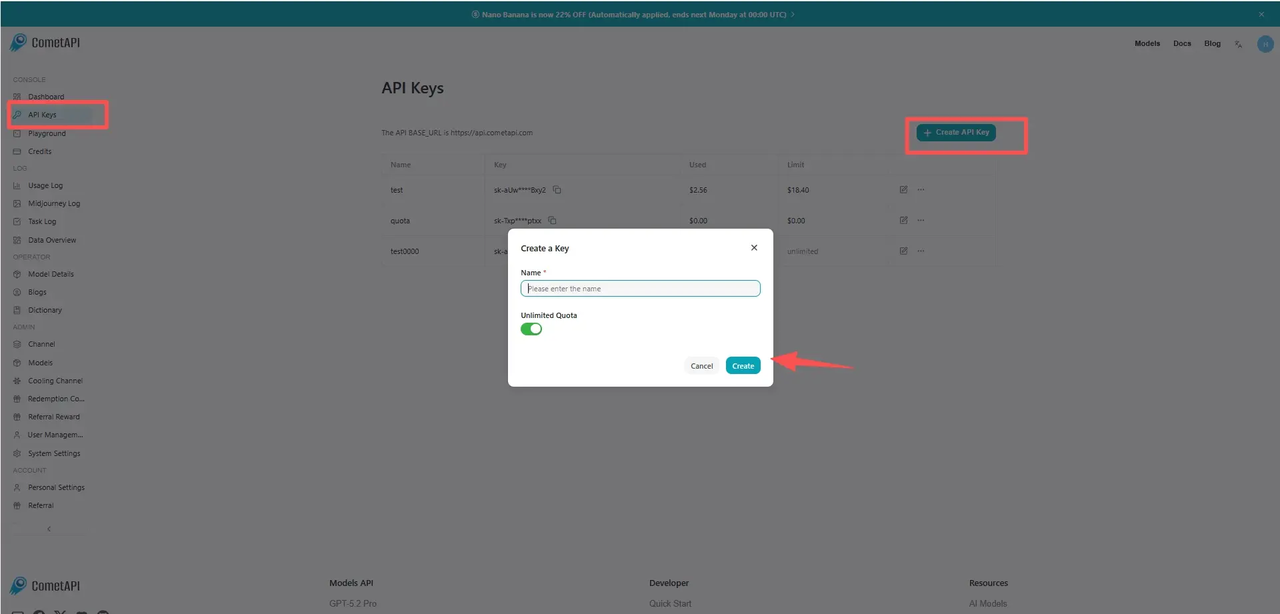
Bron: Officiële CometAPI-afbeelding van de API-sleutelgids
Stap 2: Sla de sleutel op als omgevingsvariabele
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Vervang in productie shell-geschiedenis door een deployment secret, containersecret of beheerde kluis.

### Stap 3: Installeer een OpenAI-compatibele SDK
python -m pip install --upgrade openai
npm install openai
```

### Stap 4: Doe het eerste verzoek met cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Een succesvol antwoord bevat een assistant-bericht onder choices[0].message.content plus gebruiksmetadata wanneer de route die retourneert. Begin met dit kleine verzoek voordat u optionele parameters toevoegt.

### Stap 5: Roep de API aan vanuit Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Stap 6: Roep de API aan vanuit JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Redeneerinspanning sturen

De [officiële modeldocumentatie](https://docs.z.ai/guides/vlm/glm-5.3-flash) ondersteunt [low, high en max redeneerkracht](https://docs.z.ai/guides/vlm/glm-5.3-flash). [Thinking blijft ingeschakeld](https://docs.z.ai/guides/vlm/glm-5.3-flash); de inspanningsinstelling bepaalt hoeveel redeneerbudget het model kan gebruiken.

| Effort | Good starting workloads                             | Trade-off                                            |
| ------ | --------------------------------------------------- | ---------------------------------------------------- |
| low    | Classificatie, herschrijven, korte extractie        | Lagere latency en outputtoken-gebruik; minder diepgang. |
| high   | Codereview, planning, documentanalyse               | Gebalanceerde standaard voor veel productietaken.    |
| max    | Complex debuggen, tool-agents, moeilijke redenering | Meeste diepgang; mogelijk hogere latency en kosten.  |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Als de geïnstalleerde SDK reasoning_effort als argument ondersteunt, kunt u dat direct meegeven. Als de CometAPI-route een provider-specifiek veld afwijst, verwijder het dan en gebruik de routestandaard. Probeer het denken niet uit te schakelen.

## Hoe responses te streamen

Streaming is nuttig voor chat, coding-assistants en lange analyses omdat het de interface toestaat output weer te geven zodra die binnenkomt. Het vermindert het totale aantal gegenereerde tokens niet, dus behoud dezelfde uitvoerlimieten en kostencontroles.

### Python-streaming

Python

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript-streaming

JavaScript

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Annulering afhandelen. Stop met het lezen van de stream wanneer de client verbreekt en annuleer upstream-werk waar ondersteund.

• Veilig bufferen. Ga er niet vanuit dat elke chunk een volledig woord, JSON-token of tool-call-object bevat.

• Eindgebruik registreren. Gebruik kan alleen in het laatste event of route-specifieke metadata verschijnen.

## Hoe afbeeldingen te versturen

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) accepteert visuele content via image\_url-blokken in messages\[].content\[]. De officiële documentatie raadt een bereikbare afbeeldings-URL of een Base64 Data URL aan. De CometAPI-modelpagina identificeert beeld-naar-tekst-capaciteit, maar toepassingen moeten nog steeds formaten, bestandsgrootte en routegedrag testen vóór productie.

### Analyseer een afbeeldings-URL

Python

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Verstuur een lokale afbeelding als Base64

Python

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Snijd irrelevante witruimte weg voordat u een afbeelding codeert.

• Schaal afbeeldingen omlaag die veel groter zijn dan de te inspecteren informatie.

• Stel een specifieke visuele vraag in plaats van een generieke beschrijving te vragen.

• Ga er niet vanuit dat een publieke webpagina-URL een directe afbeeldings-URL is.

• Test de volgorde bij meerdere afbeeldingen, omdat elke afbeelding in de prompt duidelijk moet worden gerefereerd.

## Gestructureerde JSON aanvragen

Gestructureerde uitvoer is waardevol wanneer de volgende component code is in plaats van een menselijke lezer. Gebruik een smal schema, valideer het resultaat en houd een fallback aan voor routes die geen strikt JSON Schema op exact dezelfde manier bieden.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

JSON-modus vervangt validatie niet. Controleer vereiste velden, types, toegestane waarden en maximumlengtes voordat u het resultaat opslaat of een ander systeem triggert.

## Function calling gebruiken

Function calling laat het model beslissen wanneer externe data nodig is, terwijl applicatiecode verantwoordelijk blijft voor autorisatie en uitvoering. Het veilige patroon is: model stelt een tool-call voor, de server valideert, de server voert de tool uit, en het model ontvangt het resultaat.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Argumenten valideren. Behandel tool-call JSON als onbetrouwbare input.

• Autorisatie afdwingen. Het model beslist niet wat de huidige gebruiker mag doen.

• Lees- en schrijfgereedschappen scheiden. Vereis bevestiging voor destructieve of extern zichtbare acties.

• Beperk de toolinventaris. Stel alleen tools bloot die relevant zijn voor de huidige workflow.

• De lus begrenzen. Stel een maximum aan toolrondes, totale tokens, verstreken tijd en kosten.

## [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) API-parameters

| Parameter               | Purpose                           | Practical guidance                                        |
| ----------------------- | --------------------------------- | --------------------------------------------------------- |
| model                   | Selecteert de modelroute          | Gebruik glm-5.3-flash.                                    |
| messages                | Conversatie en multimodale input  | Houd de rolvolgorde geldig; bewaar vereiste toolberichten.|
| max\_completion\_tokens | Beperkt gegenereerde uitvoer      | Stel per workflow in, vertrouw niet op het maximum van het model. |
| temperature             | Samplinggedrag                    | Officiële aanbeveling is 1.                               |
| top\_p                  | Nucleus sampling                  | Officiële aanbeveling is 0.95.                            |
| reasoning\_effort       | Redeneerbudget                    | Gebruik low, high of max; test routesupport.              |
| stream                  | Incrementele uitvoer              | Gebruik true voor interactieve responses.                 |
| tools                   | Functiedefinities                 | Houd schema’s smal en valideer elke call.                 |
| tool\_choice            | Stuurt toolselectie               | Begin met auto, tenzij de workflow een tool vereist.      |
| response\_format        | Vraagt machine-leesbare uitvoer   | Valideer ondersteuning en de geretourneerde JSON.         |

## Z.ai Direct API vs CometAPI

Beide routes kunnen geschikt zijn. De keuze draait vooral om eigenaarschap van integratie, modelbreedte, facturatie en hoe snel de toepassing provider-native features nodig heeft.

| Dimension       | Z.ai Direct API                               | CometAPI                                           | Practical result                                               |
| --------------- | --------------------------------------------- | -------------------------------------------------- | -------------------------------------------------------------- |
| Account and key | Z.ai-account en -sleutel                      | CometAPI-account en -sleutel                       | Sleutels zijn niet uitwisselbaar.                              |
| SDK pattern     | OpenAI-compatibel                             | OpenAI-compatibel                                  | Veel clientcode kan worden hergebruikt.                        |
| Model coverage  | Z.ai-modelfamilie                             | Meerdere providers en modelfamilies                | CometAPI is nuttig voor routering en vergelijking.             |
| Native features | Vroegste toegang tot provider-specifiek gedrag| Afhankelijk van gateway-exposure en pass-through   | Test geavanceerde velden op de gekozen route.                  |
| Billing         | Provider-specifiek                            | Gecentraliseerd over ondersteunde modellen         | Geünificeerde facturatie vereenvoudigt multi-model-operaties.  |
| Fallback design | Vereist een andere providerintegratie         | Kan binnen één gatewaylaag blijven                 | CometAPI kan switchfrictie verminderen.                        |
| Best fit        | Diepe inzet op Z.ai-native mogelijkheden      | Geünificeerde toegang, evaluatie en productierouting | Kies op basis van systeemarchitectuur, niet een generieke winnaar. |

Gebruik de directe API wanneer het nieuwste provider-native parameter- of productfeature essentieel is. Gebruik CometAPI wanneer één client, geünificeerde facturatie en de mogelijkheid om modellen te vergelijken of te vervangen belangrijker zijn. Voer voor productie dezelfde representatieve testsuite uit tegen de exacte route die u wilt uitrollen.

## Kostenraming en tokenbudgettering

De huidige [CometAPI-modelpagina](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) vermeldt [$0.06 per miljoen inputtokens](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) en [$0.20 per miljoen outputtokens](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). Tegen die tarieven is de geschatte verzoekkost:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Workload                | Input tokens | Output tokens | Estimated cost |
| ----------------------- | ------------ | ------------- | -------------- |
| Short question          | 2,000        | 400           | $0.00020       |
| Code review             | 50,000       | 4,000         | $0.00380       |
| Large document analysis | 250,000      | 10,000        | $0.01700       |
| Long agent run          | 800,000      | 30,000        | $0.05400       |

Prijzen veranderen in de tijd. Bevestig de live tarieven voor input, cached input en output voordat u publiceert of budgetteert. Redeneren en tool-lussen kunnen gefactureerde output en herhaalde input verhogen, dus schat complete workflows in plaats van één zichtbaar antwoord.

## GLM-5.3 Flash API best practices voor productie

### Kosten- en latentiebesturing

#### Uitvoerlimieten

Benchmarkinstellingen voor generatie en productie-API-limieten verschillen. De geciteerde HLE-evaluatie gebruikte een maximale generatielengte van 163.840 tokens, terwijl sommige evaluaties 64K outputs gebruikten; geen van beide bewijst dat elke gehoste API-route meer dan 100.000 tokens kan retourneren. Stel de limiet in op basis van het live routeschema en het workflowbudget. Gebruik kleine limieten voor classificatie en extractie, middelgrote voor analyse en grotere alleen voor expliciete longform- of agenttaken.

Contextbeheersing

Een venster van één miljoen tokens is capaciteit, geen doel. Haal relevante bestanden op, verwijder dubbele logs, plaats stabiele instructies nabij het begin en meet of extra context de taakperformance verbetert.

### Status en betrouwbaarheid

#### Status behouden

Sla volledige assistant-berichten op die nodig zijn voor de volgende beurt, inclusief tool-calls en route-specifieke velden die uw toepassing heeft gevalideerd. Het laten vallen van gestructureerde geschiedenis kan een meerstaps tool-lus breken, zelfs wanneer de zichtbare tekst compleet lijkt.

#### Selectief opnieuw proberen

• Probeer transiënte 429, 500, 502, 503 en netwerk-timeouts opnieuw met exponentiële backoff en jitter.

• Probeer authenticatiefouten, ongeldige parameters of te grote aanvragen niet blind opnieuw.

• Voeg een applicatie-aanvraag-ID toe zodat dubbel werk herkend kan worden.

• Gebruik idempotency-controles rond externe schrijfoperaties, zelfs als de modelaanvraag zelf opnieuw wordt geprobeerd.

### Veiligheid en validatie

#### Machine-leesbare uitvoer valideren

Schema-validatie, toegestane-waardencontroles, lengtelimieten en domeinregels moeten tussen het model en elke database, queue of externe API staan. Een syntactisch geldig JSON-object kan nog steeds incompleet of onveilig zijn.

#### Tool-calls autoriseren

Behandel door het model voorgestelde tool-calls als onbetrouwbare verzoeken: valideer argumenten, dwing gebruikersautorisatie af, scheid lees- en schrijfoperaties en vereis bevestiging voor destructieve acties.

### Observeerbaarheid en fallback

#### Workflow meten

• Taaksucces of menselijke acceptatiegraad

• Time to first token en totale latency

• Input-, cached input-, reasoning- en outputtokens

• Tool-call-aantal en toolfoutpercentage

• Retries, rate limits en providerfouten

• Kosten per voltooide taak in plaats van alleen kosten per API-call

#### Fallback ontwerpen

Kies een fallback per workload, niet per reputatie. Een tekst-only fallback kan acceptabel zijn voor documentextractie maar falen bij een taak op basis van een screenshot. Definieer welke inputs en toolschema’s overdraagbaar zijn, welke parameters moeten worden verwijderd en wanneer de gebruiker een herstelbare fout moet zien in plaats van een automatische modelwissel.

## Veelvoorkomende fouten en probleemoplossing

| Symptom                 | Likely cause                                                       | What to check                                                                |
| ----------------------- | ------------------------------------------------------------------ | ---------------------------------------------------------------------------- |
| 401 Unauthorized        | Ontbrekende, onjuiste of ingetrokken sleutel                       | Controleer de Authorization-header en de server-side omgevingsvariabele.    |
| 404 or model not found  | Verkeerde model-ID of onbeschikbare route                          | Gebruik glm-5.3-flash en bevestig beschikbaarheid op de live modelpagina.   |
| 429 Rate Limit          | Aanvraag- of tokenquota overschreden                               | Backoff, verlaag gelijktijdigheid, bekijk accountlimieten, retry met jitter.|
| Unsupported parameter   | Provider-native veld niet blootgesteld door de gateway             | Verwijder optionele velden en voeg ze één voor één terug.                   |
| Context length exceeded | Prompt plus gevraagde output overschrijdt routelimiet              | Trim, retrieve, vat samen, of verlaag max\_completion\_tokens.              |
| Invalid image           | URL onbereikbaar, formaat niet ondersteund of Base64 ongeldig      | Test een directe HTTPS-afbeeldings-URL en corrigeer de MIME-prefix.         |
| Broken streamed JSON    | Chunks als complete objecten geparsed                              | Buffer de stream en parse pas na de volledige JSON-payload.                 |
| Tool loop never ends    | Geen stapsbudget of ambiguë toolresultaten                         | Beperk rondes, verbeter toolbeschrijvingen, retourneer expliciete toolfouten.|

## Wanneer moet u de GLM-5.3 Flash API gebruiken?

### Goede toepassingen

• Repository-schaal codebegrip en review van meerdere bestanden

• Visueel coderen, screenshotanalyse en interface-QA

• Lange documentpakketten en synthese met bewijs

• Tool-gebruikende agents met herhaalde planning en verificatie

• High-volume workflows waar tokenkosten de unit economics materieel beïnvloeden

• Applicaties die profiteren van switchen of vergelijken van modellen via één gateway

### Gebruik een andere route of model wanneer

• Het product beeld- of video-uitvoer in plaats van tekstuitvoer nodig heeft.

• De taak een kleine, laagrisico-classificatie is die een kleiner model betrouwbaar kan afhandelen.

• Een provider-native feature verplicht is maar niet wordt blootgesteld op de gatewayroute.

• De workflow geen altijd-aan redeneren of het bijbehorende latencyprofiel kan tolereren.

• De toepassing het model nog niet heeft getest met eigen tools, data en faalgevallen.

## FAQ

###

### Wat moet ik verifiëren op de exacte CometAPI-route vóór lancering?

Verifieer modelbeschikbaarheid, geaccepteerde multimodale formaten, maximale uitvoer, reasoning-velden, gedrag van gestructureerde output, rate limits en actuele prijzen met representatieve verzoeken.

### Welke metrics moet een productie-evaluatie volgen?

Volg taaksucces, time to first token, totale latency, input- en outputtokens, tool-call-fouten, retrypercentage en kosten per voltooide workflow, niet alleen kosten per API-call.

### Hoe kies ik tussen Z.ai direct en CometAPI?

Gebruik Z.ai direct wanneer directe toegang tot provider-native gedrag essentieel is. Gebruik CometAPI wanneer geünificeerde authenticatie, facturatie, modelvergelijking en gateway-level fallback belangrijker zijn.

### Wat maakt een fallback veilig?

Een veilige fallback accepteert dezelfde inputmodaliteit, behoudt vereiste toolschema’s, verwijdert niet-ondersteunde parameters, blijft binnen de autorisatiegrens van de taak en faalt zichtbaar wanneer gedrag niet bewaard kan blijven.

## Conclusie

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) is via een API het meest nuttig wanneer lange context, visuele input, redeneren en toolgebruik deel uitmaken van één workflow. De basisintegratie met CometAPI is klein: één server-side sleutel, één OpenAI-compatibele client, de [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)-model-ID en het chat-completions-eindpunt. Productiekwaliteit komt van alles rondom dat verzoek: gescope prompts, uitvoerlimieten, schemavalidatie, toolautorisatie, retries, observeerbaarheid en workload-specifieke evaluatie.

Begin met een korte tekstcall, voeg één geavanceerde mogelijkheid per keer toe en test de volledige gebruikersreis vóór opschaling. Bevestig de live [GLM-5.3 Flash-modelpagina](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) voor actuele beschikbaarheid, ondersteund routegedrag en prijzen.

## SEO-metadata

Meta title: GLM-5.3 Flash API gebruiken: ontwikkelaarsgids

Meta description: Leer hoe u de GLM-5.3 Flash API gebruikt met CometAPI, inclusief voorbeelden in Python en JavaScript, vision, streaming, tools, JSON-uitvoer en best practices.

Keywords: GLM-5.3 Flash API, hoe GLM-5.3 Flash te gebruiken, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API-tutorial, multimodale API, redenerings-API, function calling

URL-slug: how-to-use-glm-5-3-flash-api