
TL;DR
GPT-6 Astra API in CometAPI is het meest geschikt voor moeilijke, tool-rijke workflows waarin de kwaliteit van de voltooiing belangrijker is dan de laagste tokenprijs. Het model ondersteunt een contextvenster van 1.050.000 tokens, 128.000 outputtokens, afbeeldingsinvoer, gestructureerde outputs, streaming, function calling en vijf redeneringsniveaus. Begin met de Responses API, medium reasoning, een smalle toolset en een evaluatie die de kosten per geaccepteerde taak meet. De huidige basistarieven per token van CometAPI liggen 20% onder de overeenkomstige OpenAI-tarieven.
Key Takeaways
- Astra is geoptimaliseerd voor zwaar end-to-end werk, inclusief coderen, computergebruik, research en professionele automatisering.
- Gebruik de Responses API voor nieuwe, tool-gedreven integraties.
- Kies de laagste redeneringsinspanning die je workload-evaluatie doorstaat;
nonewordt niet ondersteund. - Houd prompts waar mogelijk onder de 272K long-context-drempel, omdat het hogere tariefschema op de volledige aanvraag wordt toegepast.
- Publieke evaluaties tonen hogere scores en lagere geschatte API-kosten per taak in verschillende moeilijke workloads, maar productieroutering moet gebaseerd zijn op je eigen acceptatiegraad van taken.
GPT-6 Astra API Quick Start
- Maak een CometAPI-sleutel en sla deze op in een omgevingsvariabele.
- Installeer de OpenAI SDK.
- Verstuur een Responses API-aanvraag met
model="gpt-6-astra". - Voeg een strikt outputcontract toe en valideer het resultaat.
- Verbind alleen de tools die de workflow vereist.
- Test de integratie op representatieve taken voordat je naar productie gaat.
What Is the GPT-6 Astra API?
OpenAI's meest capabele model voor het zwaarste end-to-end werk is ontworpen voor complexe redenering, coderen, computergebruik, research en het maken van documenten. In een API-toepassing komt Astra’s waarde voort uit het behouden van intentie over lange workflows, het aanroepen van tools, het interpreteren van resultaten en doorgaan totdat aan de voltooiingscriteria van de toepassing is voldaan.
GPT-6 Astra API Specifications
| OpenAI specification | GPT-6 Astra |
|---|---|
| Model ID | gpt-6-astra |
| Context window | 1.050.000 tokens |
| Maximum output | 128.000 tokens |
| Knowledge cutoff | 30 april 2026 |
| Input and output | Tekst- en afbeeldingsinvoer; tekstuitvoer |
| Reasoning effort | low, medium, high, xhigh, max |
| Supported features | Streaming, function calling, structured outputs |
| Responses API tools | Web search, file search, image generation, code interpreter, hosted shell, Apply Patch, computer use, MCP, and tool search |
| Fine-tuning | Not supported |
De integratie-uitdaging is orkestratie: de juiste context bieden, aangevraagde tools uitvoeren, hun resultaten inspecteren en stoppen wanneer aan de voltooiingscriteria van de toepassing is voldaan.
GPT-6 Astra API vs GPT-5.6 Sol: What Is New?
OpenAI’s huidige modelrichtlijnen beschrijven Astra als sterker op moeilijke multistapworkflows, terwijl het vaak minder outputtokens gebruikt. Het voegt ook controles toe die belangrijk zijn voor langlopende agents: asynchrone tool-calls, mid-turn-sturing, redeneringswijzigingen tijdens een gesprek en misalignment-monitoring.
| Dimension | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Primary role | Zwaarste end-to-end werk | Complex professioneel werk tegen lagere tokenkosten |
| Context / max output | 1,05M / 128K | 1,05M / 128K |
| Knowledge cutoff | 30 april 2026 | 16 februari 2026 |
| Async tool calling | Supported | Use conventional tool-result coordination |
| Mid-turn steering | Supported through Responses WebSocket | Use a subsequent turn or application-managed restart |
| Change reasoning mid-conversation | configuration_update in compatible flows | Set effort at request level |
| none reasoning | Not supported | Supported |
| OpenAI Standard input / output | $10 / $50 per 1M | $4 / $20 per 1M |
| Best routing role | Escalatie voor zeer complexe taken | Standaard voor bredere complexe traffic |
De upgrade is geen algehele vervanging. Gebruik Sol wanneer het de taak betrouwbaar slaagt; routeer naar Astra wanneer tooldiepte, lange context, retries of menselijke correctie het goedkopere model in de praktijk duurder maken.
Why Use GPT-6 Astra Through CometAPI?
De GPT-6 Astra API in CometAPI gebruikt de OpenAI-compatibele /v1/responses-route. De tarieven van $8/M input en $40/M output voor short context liggen 20% onder de overeenkomstige OpenAI Standard-tarieven van $10/M en $50/M.
Een bestaande OpenAI SDK-integratie kan zijn clientbibliotheek behouden en alleen de key, base_url en model-ID wijzigen. Gebruik dezelfde gateway om geschikt werk naar GPT-5.6 Sol te routeren.
Step 1: Get a CometAPI API Key
Maak een sleutel in het CometAPI-dashboard en sla deze buiten de broncode op. Gebruik in productie een deployment secret manager.
export COMETAPI_KEY="your_api_key"
$env:COMETAPI_KEY = "your_api_key"
Step 2: Install the OpenAI SDK
Installeer de huidige SDK voor de taal van je toepassing.
python -m pip install -U openai
npm install openai
Step 3: Make Your First Request
Gebruik /v1/responses voor nieuwe integraties, vooral wanneer de workflow later tools of gestructureerde outputs toevoegt.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=120.0,
    max_retries=2,
)

response = client.responses.create(
    model="gpt-6-astra",
    input="Give three practical ways to reduce API latency.",
    reasoning={"effort": "medium"},
)

if response.status != "completed":
    raise RuntimeError(f"Unexpected status: {response.status}")

print(response.output_text)
Step 4: Test Before Production
Voer representatieve taken door zowel de kandidaat- als fallback-routes. Leg de acceptatiegraad, latentie, retries, input- en outputtokens, toolstoringen en tijd voor menselijke correctie vast. Promoot Astra alleen waar het resultaat de echte voltooiingseconomie van de workflow verbetert.
Behandel een geslaagde demoprompt niet als productievalidatie. Neem onduidelijke inputs, toolstoringen, ontbrekende gegevens en langlopende verzoeken op in de testset.
How to Choose Reasoning Effort
De ondersteunde redeneringsniveaus zijn low, medium, high, xhigh en max. Gebruik het laagste niveau dat consequent aan je acceptatiecriteria voldoet.
| Effort | Practical starting point |
|---|---|
| low | Classificatie, herschrijven en rechttoe-rechtaan extractie |
| medium | Algemene ontwikkeling, analyse en de meeste eerste evaluaties |
| high | Complex debuggen, architectuur en synthese uit meerdere bronnen |
| xhigh | Moeilijke research en lang, meerstaps codeerwerk |
| max | Een klein aantal van de allerzwaarste taken na evaluatie |
How to Use Image Input
Gebruik een toegankelijke afbeeldings-URL of een ondersteund geüpload bestand. Combineer de afbeelding met een specifieke inspectietaak in plaats van om een algemene beschrijving te vragen.
vision = client.responses.create(
    model="gpt-6-astra",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "Identify one UI defect and propose a fix."},
            {"type": "input_image", "image_url": os.environ["SCREENSHOT_URL"]}
        ]
    }]
)

print(vision.output_text)
How to Use Structured Outputs and Stream Responses
Gestructureerde outputs bieden een machineleesbaar contract; streaming verbetert de waargenomen responsiviteit. Ze lossen verschillende problemen op en kunnen samen worden gebruikt. Levenscyclusgebeurtenissen en tekstdelta’s moeten afzonderlijk worden afgehandeld.
stream = client.responses.create(
    model="gpt-6-astra",
    input="Create a deployment checklist.",
    stream=True,
)

completed = False
for event in stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="", flush=True)
    elif event.type == "response.completed":
        completed = True
    elif event.type in {"response.failed", "response.incomplete", "error"}:
        raise RuntimeError(event.type)

if not completed:
    raise RuntimeError("Stream closed before completion")
How to Maintain Stateful Conversations
Voor draagbare geschiedenis stuur je de gebruikersinvoer en de modeloutputitems die voor de volgende beurt nodig zijn opnieuw. Waar door de provider ondersteund, kan previous_response_id in plaats daarvan verwijzen naar een opgeslagen response.
history = [{"role": "user", "content": "Give three latency improvements."}]
history.extend(
    item.model_dump(exclude={"id"}, exclude_none=True)
    for item in response.output
)
history.append({"role": "user", "content": "Turn them into a checklist."})

follow_up = client.responses.create(
    model="gpt-6-astra",
    input=history,
)
print(follow_up.output_text)
How to Use Function Calling
Een complete functieslus kent vier onderdelen: definieer het schema, ontvang een tool call, voer deze uit in je toepassing en retourneer een function_call_output-item met de oorspronkelijke call_id. Houd toolmachtigingen minimaal en valideer elk argument vóór uitvoering.
import json

history = [{"role": "user", "content": "Check order A-1042."}]
turn = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
history.extend(item.model_dump(exclude={"id"}, exclude_none=True) for item in turn.output)

for item in turn.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        tool_result = {"order_id": args["order_id"], "status": "shipped"}
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(tool_result),
        })

final = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
print(final.output_text)
How to Use Async Tool Calling
Async tool calling stelt Astra in staat zelfstandig werk voort te zetten terwijl een langlopende functie of aangepaste tool in behandeling is. Stel async: true in in de toold definitie, bewaar de oorspronkelijke call_id en retourneer het resultaat wanneer het externe werk gereed is. Je toepassing blijft verantwoordelijk voor de jobqueue, time-outbeleid, idempotentie en herstel.
Dien dezelfde langlopende job niet opnieuw in puur omdat een pollingvenster is verlopen. Sla de job-ID op en hervat het ophalen.
How to Prompt the GPT-6 Astra API
OpenAI’s promptrichtlijnen leggen nadruk op initiatief, prioriteit van instructies, stijl, delegatie en gekalibreerde verificatie. Een nuttige productieprompt moet de taak, beschikbare middelen, voltooiingstest, grenzen, verwacht formaat en hoe om te gaan met ontbrekende informatie specificeren.
| Prompt component | What to specify |
|---|---|
| Task | The concrete outcome to produce |
| Resources | Files, tools, data, and context that may be used |
| Completion test | Conditions that make the work done |
| Boundaries | Actions allowed, prohibited, or requiring approval |
| Style and format | Length, structure, tone, and output schema |
| Uncertainty | What may be inferred and what must be clarified |
| Verification | Which checks are required and when to stop testing |
Task: Review this API design and identify the three highest-impact migration risks.
Resources: Use the attached schema and deployment notes.
Completion test: Return three risks, evidence for each, and one acceptance test per risk.
Boundaries: Do not change production systems. Infer routine implementation details.
Clarification rule: Ask only if a missing requirement would materially change the result.
Style: Use concise prose and a final three-row table.
Verification: Check that every risk has an executable acceptance test.
GPT-6 Astra Benchmarks: Higher Scores, Fewer Tokens
Publieke evaluaties zijn het nuttigst wanneer kwaliteit en taak-economie samen worden gelezen. De onderstaande benchmarkscores tonen waar Astra’s winst groot is; de gerapporteerde besparingen zijn configuratiespecifieke schattingen en geen garanties voor elke workload.
| Published evaluation | Astra | Sol | Difference |
|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | +23,3 punten |
| OSWorld 2.0 | 72,6% | 65,7% | +6,9 punten |
| Terminal-Bench 4.0 | 57,9% | 37,3% | +20,6 punten |
| MRCR v2, 512K-1M | 96,3% | 73,8% | +22,5 punten |
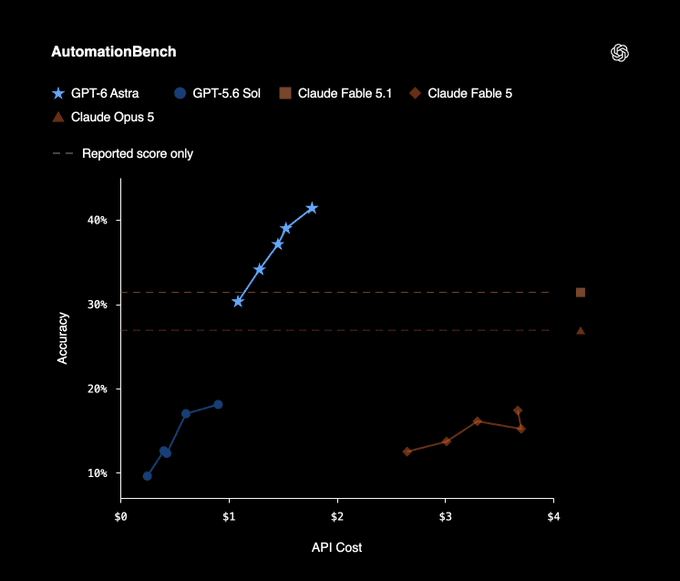
Officiële OpenAI AutomationBench-grafiek: nauwkeurigheid uitgezet tegen de geschatte API-kosten.
| Cost-per-task comparison | Quality configuration | Saving API-kosten vs Sol |
|---|---|---|
| DeepSWE v1.1 | 74,1% vs 72,7%; hoogst scorende configuraties | Ongeveer 32% |
| Database migration | 63,4% vs 42,7%; lagergeprijsde Astra-instelling | Ongeveer 38% |
| Terminal-Bench 4.0 | 57,9% vs 37,3%; gerapporteerde configuraties | Ongeveer 9% |
De link met prijsstelling is tweevoudig. Ten eerste kunnen minder outputtokens en minder mislukte pogingen de geschatte API-kosten per voltooide taak verlagen, zelfs wanneer Astra een hogere prijs per token heeft. Ten tweede liggen de momenteel vermelde tarieven van CometAPI 20% onder de overeenkomstige providertarieven. Dit zijn afzonderlijke effecten: tel de percentages niet op, en ga er niet van uit dat een benchmarkbesparing zich in productie zal herhalen.
GPT-6 Astra API Pricing
Prijsstelling wordt gemeten per miljoen tokens. Zodra de invoer 272K tokens overschrijdt, is het long-context-tarief van toepassing op de volledige aanvraag.
| Current pricing | CometAPI short context | CometAPI long context | OpenAI Standard |
|---|---|---|---|
| Input | $8 | $16 | $10 short / $20 long |
| Cache read | $0.80 | $1.60 | $1 short / $2 long |
| Cache write | $10 | $20 | $12.50 short / $25 long |
| Output | $40 | $60 | $50 short / $75 long |
Prijzen en gatewaybeleid kunnen veranderen. Verifieer de live prijsconfiguratie voordat je budgetteert of tarieven hardcodet.
How to Reduce API Costs
- Houd stabiele prefixes cache-vriendelijk. Plaats gedeelde instructies en toolschema’s vóór verzoekspecifieke content.
- Voorkom onbedoeld overschrijden van 272K. Haal alleen context op en dedupliceer wat het antwoord kan beïnvloeden.
- Gebruik de laagste redeneringsinspanning die slaagt. Schaal alleen op wanneer de acceptatiegraad verbetert.
- Routeer eenvoudig verkeer elders. Reserveer Astra voor werk dat profiteert van zijn betrouwbaarheid in voltooiing.
- Meet kosten per geaccepteerde taak. Neem retries, toolkosten en gemonetariseerde menselijke reviewinspanning mee.
How to Migrate to GPT-6 Astra
Bij migratie van GPT-5.6 Sol voer je de kleinst mogelijke compatibele wijziging door en draai je dezelfde evaluatieset opnieuw.
- Stel het model in op
gpt-6-astra. - Als de oude route
noneofminimalreasoning gebruikte, begin dan metlow. - Gebruik Responses voor tool-calling-workflows.
- Verwijder niet-ondersteunde samplingparameters:
temperature,top_pentop_logprobs; verwijder ook Chat Completionslogprobs. - Test gestructureerde output, caching, streaming, tool-loops en provider-specifiek gedrag opnieuw.
- Vergelijk acceptatiegraad, latentie, retries, tokens en menselijke correctie vóór je de standaardroute aanpast.
prompt = "Review this API design and identify migration risks."

baseline = client.responses.create(
    model="gpt-5.6-sol",
    input=prompt,
)

candidate = client.responses.create(
    model="gpt-6-astra",
    input=prompt,
    reasoning={"effort": "medium"},
)
When Should You Use GPT-6 Astra?
Gebruik Astra wanneer taakfalen duur is en de workflow redenering combineert met tools, lange context of meerfasige uitvoering.
- Debuggen op repositoryschaal, migratie, en test-en-retry-loops.
- Browser- of computer-use-agents.
- Diepe research over meerdere bronnen en tools.
- Analyse van zeer lange documenten of codebases.
- Wetenschappelijke en technische workflows die code of externe software gebruiken.
- Professionele automatisering waarbij een mislukte run aanzienlijke herstelkosten veroorzaakt.
Gebruik een goedkoper pad voor eenvoudig herschrijven, korte samenvattingen, classificatie en routine-extractie wanneer dit al aan de kwaliteitsdoelstelling voldoet.
Common API Errors
401 Authentication Error
Bevestig dat het verzoek Authorization: Bearer <COMETAPI_KEY> meestuurt en dat het proces de juiste omgevingsvariabele leest.
400 Bad Request
Controleer op niet-ondersteunde samplingparameters, een ongeldig schema of een niet-ondersteunde redeneringswaarde zoals none.
404 Model or Endpoint Error
Bevestig model="gpt-6-astra" en de /v1/responses-route.
429 Rate Limit
Gebruik exponentiële backoff met jitter en een begrensd aantal retries.
1 s -> 2 s -> 4 s -> 8 s -> capped retry window
5xx Server Error
Probeer tijdelijke serverstoringen opnieuw, maar probeer onjuiste 4xx-verzoeken niet ongewijzigd opnieuw. Log request-ID’s zonder onnodig gevoelige promptinhoud op te slaan.
FAQ
What model ID should I use?
Gebruik gpt-6-astra.
Should I use Responses API or Chat Completions?
Gebruik Responses voor nieuwe integraties, vooral voor tools, gestructureerde outputs, streaming, state en agentworkflows. Behoud Chat Completions alleen waar compatibiliteitsvereisten dit rechtvaardigen.
Which reasoning effort should I start with?
Begin met medium, evalueer vervolgens low voor routinetraffic en high of hoger voor taken die aantoonbaar profiteren van diepere redenering.
Can Astra accept images?
Ja. Het accepteert tekst- en afbeeldingsinvoer en retourneert tekstuitvoer.
Is the CometAPI route always 20% cheaper per completed task?
Nee. De vermelde tokenprijzen liggen 20% onder de overeenkomstige providertarieven, maar de totale taakkosten hangen ook af van contextgrootte, outputlengte, tool-calls, retries en reviewinspanning.
Should Astra replace Sol everywhere?
Nee. Sol blijft de goedkopere keuze voor veel begrensde workloads. Gebruik Astra waar sterkere uitvoering, long-context-betrouwbaarheid of minder mislukte pogingen de totale economie verandert.
Conclusion
Astra is het waardevolst wanneer een API-call één stap is in een moeilijke workflow in plaats van het eindpunt. Het lange contextvenster, vijf redeneringsniveaus, gestructureerde outputs, streaming, function calling en nieuwe agentcontroles geven ontwikkelaars meer manieren om complex werk tot voltooiing te brengen.
Begin met Responses, medium reasoning, duidelijke voltooiingscriteria en de minimale tooltoegang die nodig is. Meet de acceptatiegraad en de kosten per geaccepteerde taak, en verhoog vervolgens de redenering of routeer meer verkeer naar Astra alleen wanneer het bewijs dit ondersteunt.