

TL;DR
MiMo-V2.5 is de sterkere standaardkeuze voor multimodaal werk, routinematige agents en kostenbewuste productie. MiMo-V2.5-Pro is de specialist voor moeilijke redenering, codering op repository-schaal en langdurig toolgebruik. Beide bieden een contextvenster van 1M tokens en tot 128K outputtokens, maar Pro gebruikt een veel grotere taal-backbone en kost ongeveer 3,1× zoveel voor gewone input- en outputtokens.
MiMo-V2.5 vs. Pro: snelle keuze
| Specificatie — officiële release | MiMo-V2.5 | MiMo-V2.5-Pro | Aanbevolen model | Reden |
|---|---|---|---|---|
| Primaire positionering | Omnimodaal model en efficiënte agents | Vlaggenschip-agent en complexe codering | Kies op werklast | Omnimodale input spreekt voor V2.5; aanhoudend moeilijk tekstwerk voor Pro. |
| Architectuur | Sparse MoE | Sparse MoE | Kies op werklast | Alleen modelgrootte bepaalt niet voor elke taak de beste keuze. |
| Totaal aantal parameters | 310B | 1.02T | Kies op werklast | Het grotere model richt zich op moeilijke redenering, maar grootte is geen uitkomstmaat. |
| Geactiveerde parameters | 15B | 42B | Kies op werklast | Beslis op basis van taakvoltooiing en kosten. |
| LLM-lagen | 48 | 70 | Kies op werklast | Het aantal lagen beschrijft de architectuur, geen universele winst. |
| Gerouteerde experts | 256 | 384 | Kies op werklast | Het verschil is alleen relevant als het de beoogde werklast verbetert. |
| Experts geactiveerd per token | 8 | 8 | Beide | Beide activeren acht experts per token. |
| Contextvenster | 1M tokens | 1M tokens | Beide | Beide adverteren een venster van 1M tokens; test effectieve retrieval. |
| Maximale output | 128K tokens | 128K tokens | Beide | Beide adverteren tot 128K outputtokens. |
| Invoermodaliteiten | Tekst, afbeelding, video en audio | Tekst | MiMo-V2.5 | Accepteert beeld-, video- en audio-input; Pro is gericht op tekstinput. |
| Toolaanroepen | Ja | Ja | Kies op werklast | Beide roepen tools aan; test slagingspercentage op de daadwerkelijke trajecten. |
| Open weights en licentie | Ja; MIT | Ja; MIT | Beide | Beide bieden open weights onder MIT; hostingkosten verschillen. |
Het beslissende verschil: multimodaal vs agent-first
V2.5 ondersteunt native tekst, afbeeldingen, video en audio. Xiaomi koppelt de taal-backbone aan een vision-encoder met 729M parameters en een audio-encoder met 261M parameters, waardoor multimodale informatie direct kan deelnemen aan dezelfde redeneringsworkflow.
- Analyseer schermafbeeldingen voordat je tools aanroept.
- Begrijp een video en het audiospoor samen.
- Haal informatie uit diagrammen en documentafbeeldingen.
- Bedien agents voor visuele interfaces en multimodale ondersteuning.
- Redeneer over lange videosequenties.
V2.5-Pro volgt een ander ontwerp. Xiaomi specificeert momenteel tekst als invoermodaliteit en legt de nadruk op diepe redenering, codeontwikkeling en langdurige toorchestratie.
Als de workflow zelf beeld-, video- of audio-input bevat, begin dan met V2.5. Test Pro wanneer het moeilijke deel het redeneren over tekst, broncode, tools of een lang agenttraject is.

Officiële Xiaomi-vergelijking van multimodale benchmarks.
Waarom V2.5-Pro beter kan zijn bij moeilijke taken
Modelomvang: 310B/15B vs. 1.02T/42B
De twee modellen gebruiken sparse Mixture-of-Experts-backbones, hybride sliding-window en globale aandacht, en drie Multi-Token Prediction-modules. Xiaomi’s V2.5-modelkaart documenteert een backbone met in totaal 310B en 15B actief; de Pro-modelkaart schaalt dit naar in totaal 1.02T parameters met 42B geactiveerd per token.
| Architectuur — officiële modelkaart | V2.5 | Pro | Verschil |
|---|---|---|---|
| Totaal aantal parameters | 310B | 1.02T | ~3,3× |
| Actieve parameters | 15B | 42B | 2,8× |
| Hidden size | 4,096 | 6,144 | 1,5× |
| LLM-lagen | 48 | 70 | 22 meer |
| Attention heads | 64 | 128 | 2× |
| Gerouteerde experts | 256 | 384 | 1,5× |
| Experts per token | 8 | 8 | Zelfde |
| MTP-lagen | 3 | 3 | Zelfde |
V2.5 gebruikt een 5:1 attentionpatroon, terwijl Pro naar een 6:1 lokaal-naar-globaal patroon gaat. Xiaomi zegt dat deze ontwerpen de KV-cachevereisten respectievelijk met bijna 6× en 7× verminderen vergeleken met volledige aandacht door het hele netwerk.
Het totaal aantal parameters vertaalt zich niet lineair in antwoordkwaliteit. De grotere backbone van Pro telt vooral wanneer moeilijkheidsgraad van redeneren of trajectlengte maakt dat kleine betrouwbaarheidsgroei per stap cumulatief wordt.
Waarom kleine betrouwbaarheidswinsten zich cumuleren
Een lange agenttaak heeft veel afhankelijke stappen. Een fout in een vroege toolaanroep kan herhalingen afdwingen of later werk ongeldig maken, dus een bescheiden winst in betrouwbaarheid per stap kan een groter effect hebben op de end-to-end voltooiing. Evalueer dat effect op representatieve taken in plaats van aan te nemen dat modelgrootte dit garandeert.
Waar verbetert V2.5-Pro daadwerkelijk?
De schoonste numerieke vergelijking is Xiaomi’s basismodelevaluatie, waar beide modellen onder dezelfde instellingen verschijnen. Dit voorkomt het combineren van resultaten uit niet-gerelateerde harnassen of post-trainingsconfiguraties.
Algemene kennis: kleine tot gematigde winst
In Xiaomi’s basismodelvergelijking wint Pro 1,2 punten op BBH, 3,1 op MMLU en 2,7 op MMLU-Pro. Dit is meetbaar, maar kleiner dan de winst op zwaardere redeneertaken.
Wiskunde en wetenschap: grotere winst
Pro wint 8,6 punten op GPQA-Diamond, 16,3 op GSM8K en 18,5 op MATH in dezelfde basismodelevaluatie. Dit is het duidelijkste bewijs om Pro te kiezen wanneer moeilijke redenering de taak bepaalt.
Codering: beter, maar niet consequent beter
De gerapporteerde winsten zijn 4,3 punten op HumanEval+, 3,2 op MBPP+, 4,1 op LiveCodeBench v6 en 4,9 op SWE-Bench AgentLess. Test taken op repository-niveau en toolgebruik afzonderlijk: deze basismodelscores meten niet elke productie-agentworkflow.
Benchmarkresultaat: Pro is niet drie keer beter omdat hij ongeveer drie keer zoveel kost. De waarde neemt progressief toe naarmate redeneringsmoeilijkheid en taakduur stijgen.
Deze rijen zijn basismodelevaluaties, geen belofte dat een productie-API exact dezelfde scores zal reproduceren. Agentresultaten hangen af van tools, prompts, herhalingen, uitvoeringsomgeving en tokenbudgetten.
Post-training en lange-horizonagents
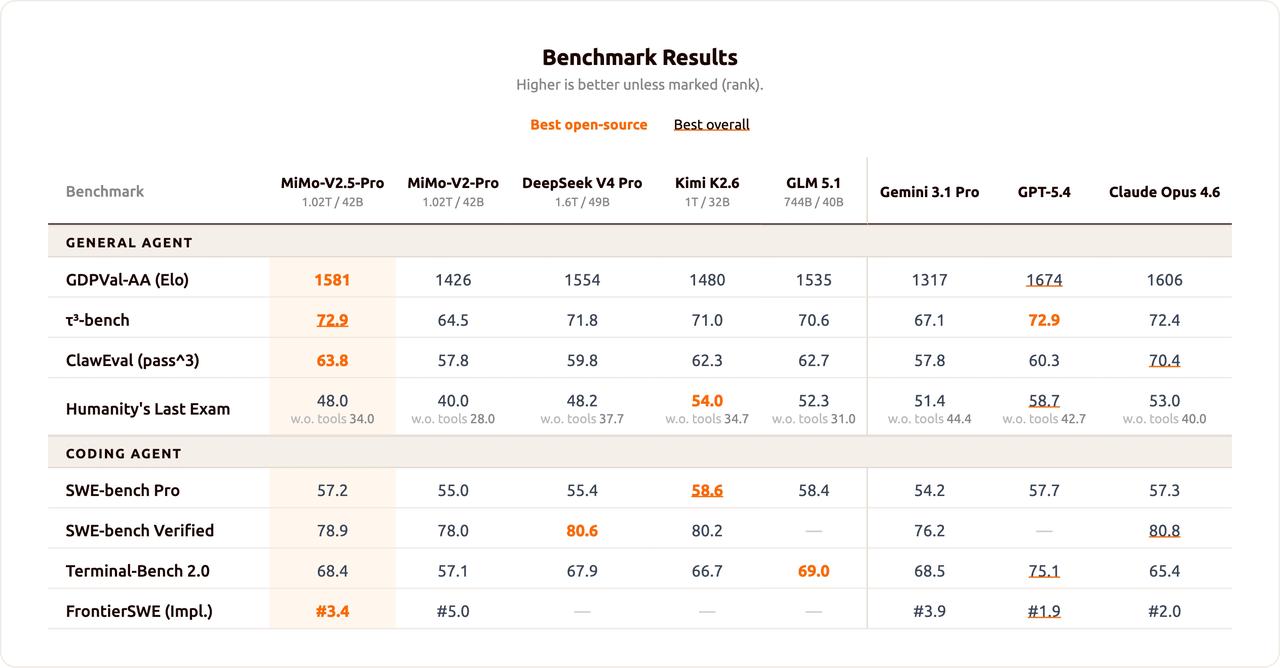
De productiemodellen voegen supervised fine-tuning, agentische reinforcement learning en Multi-Teacher On-Policy Distillation toe. Xiaomi rapporteert post-trainingscores van 56,1 op SWE-bench Pro, 65,8 op Terminal-Bench 2.0 en 62,1 Pass³ op het algemene deel van Claw-Eval voor V2.5.
Pro is explicieter geoptimaliseerd voor software-engineering met lange horizon. Xiaomi beschrijft honderden toolaanroepen in langdurige trajecten en publiceert een resultaat van 78,9% op SWE-bench Verified.
Een officiële casestudy laat zien dat Pro een SysY-compiler voltooide in 4,3 uur met 672 toolaanroepen en alle 233 tests slaagden. De les is niet dat elk codeverzoek Pro nodig heeft; wel dat kleine betrouwbaarheidsverschillen kunnen bepalen of een workflow met honderden afhankelijke acties voltooit.

Officiële Xiaomi-figuur voor codeer- en agentbenchmarks.
Lange context: dezelfde capaciteit, verschillende werklasten
Beide modellen bieden via Xiaomi’s huidige API een contextvenster van 1M tokens en tot 128K outputtokens. Ruwe contextgrootte onderscheidt ze dus niet.
V2.5 is aantrekkelijk wanneer de lange context multimodaal materiaal bevat zoals video, documentafbeeldingen of visuele agenttraces. Pro is het model om te testen wanneer de context zelf het redeneringsprobleem wordt: een grote repository, een lang contract, een onderzoeks-corpus of een agenttraject met veel sequentiële acties.
Een groot contextvenster beschrijft capaciteit, geen gegarandeerde redeneringsfideliteit. Evalueer retrieval, instructiebehoud en bewijsgebruik op de lengtes die voor de toepassing tellen.
Prijs en kostenefficiëntie
Xiaomi’s overzeese pay-as-you-go-prijzen maken de afweging duidelijk.
| Prijzen — officiële prijslijst | V2.5 | Pro | Verhouding |
|---|---|---|---|
| Niet-gecachete input per 1M tokens | $0.14 | $0.435 | 3.11× |
| Gecachete input per 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Output per 1M tokens | $0.28 | $0.87 | 3.11× |
| Contextvenster | 1M | 1M | Zelfde |
| Maximale output | 128K | 128K | Zelfde |
Een verzoek met 1M niet-gecachete inputtokens en 200K outputtokens kost naar schatting $0.196 op V2.5 en $0.609 op Pro vóór cache-hits, webzoekkosten of providerspecifieke facturatie.
Het cache-prijsverschil is kleiner: Pro is ongeveer 29% duurder voor input met cache-treffer in plaats van 211% duurder. Langdurig draaiende agents met stabiele systeemprompts, tooldefinities of repository-prefixen moeten daarom hun daadwerkelijke cache-hitratio meten.
Schat de kosten per succesvolle taak. Een Pro-agent die een moeilijke workflow in één keer voltooit, kan minder kosten dan herhaalde mislukte pogingen op een goedkoper model.
Welk model moet je gebruiken?
| Werklast — officiële richtlijn | Betere keuze | Waarom |
|---|---|---|
| Routinematige tekstchat | V2.5 | Lagere kosten; Pro vaak niet nodig |
| Generatie met hoog volume | V2.5 | Ongeveer 3,1× lagere standaardtokenprijs |
| Begrip van beeld, video of audio | V2.5 | Native multimodale input |
| Routinematige toolaanroepen | V2.5 | Sterke agentcapaciteit tegen lagere kosten |
| Moeilijke wiskunde en wetenschap | Pro | Grotere benchmarkwinsten |
| Codering op repository-schaal | Pro | Ontworpen voor complexe software-engineering |
| Honderden afhankelijke toolaanroepen | Pro | Beter geschikt voor langdurige executie |
| Kostenbewuste 1M-context | V2.5 | Zelfde nominale context tegen veel lagere prijs |
Selectieresultaat: V2.5 is de standaard voor multimodale toepassingen, routineagents en kostenbewuste werklasten. Pro is de upgrade voor moeilijke redenering, complexe software-engineering en lange autonome trajecten.
Een betere productiestrategie: routeren tussen beide
Een enkele globale modelkeuze is vaak niet nodig. Routeer multimodale en routinematige verzoeken naar V2.5 en schaal alleen moeilijke tekstredenering, complexe codering of lang-horizonexecutie op naar Pro.
| Evaluatiedimensie | Maatstaf | Waarom het telt | Routeringssignaal |
|---|---|---|---|
| Voltooiing | Succesvolle taken / pogingen | Vangt end-to-end betrouwbaarheid | Escaleer klassen met lage voltooiing |
| Kwaliteit | Menselijke of rubriekscore | Voorkomt dat tokenkosten domineren | Escaleer taken met hoge inzet |
| Toolbetrouwbaarheid | Fouten en herhalingen | Kleine fouten cumuleren in agents | Escaleer lange trajecten |
| Latentie | Tijd tot geaccepteerd resultaat | Omvat herhalings-overhead | Houd interactieve taken lichtgewicht |
| Kosten | Uitgaven per geaccepteerde taak | Reflecteert fouten en reruns | Gebruik het goedkoopste model dat slaagt |
Test beide API's in CometAPI
MiMo-V2.5 API in CometAPI en MiMo-V2.5-Pro API in CometAPI ondersteunen side-by-side evaluatie via één aggregatielaag. Stuur dezelfde prompts, systeeminstructies, tools en outputlimieten naar beide modellen en vergelijk vervolgens taaksucces en kosten.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Beoordeel dit implementatieplan.
Identificeer verborgen technische risico's en stel de drie hoogste-prioriteitsoplossingen voor.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Voer een representatieve batch uit met eenvoudige verzoeken, moeilijke redenering, codebewerking, taken met lange context en agent-toolaanroepen. Noteer voltooiingspercentage, tokens, latentie, toolfouten, herhalingen, antwoordkwaliteit en kosten per succesvolle taak.
Beperkingen
Beperkingen van V2.5
De kleinere taal-backbone laat prestaties liggen naarmate de redeneringsmoeilijkheid stijgt. De kloof is bescheiden op BBH maar veel groter op GPQA-Diamond en MATH. Een contextvenster van 1M tokens moet ook niet worden verward met gegarandeerde redeneringsfideliteit over 1M tokens.
Beperkingen van Pro
Pro’s gewone input- en outputprijzen zijn ongeveer 3,1× die van V2.5, en de tekst-only input maakt het ongeschikt als drop-in vervanging voor multimodale toepassingen. Het open-weight model met 1.02T parameters is ook een veeleisend self-hostingproject, hoewel per token 42B parameters worden geactiveerd.
Eindoordeel
Kies V2.5 voor multimodale toepassingen, routineagents en kostenbewuste productie. Kies Pro voor moeilijke redenering, complexe software-engineering en langlopende autonome agents. Voor gemengde werklasten routeer je het meeste verkeer naar V2.5 en schaal je alleen die verzoeken op naar Pro waarvan de moeilijkheid of trajectlengte de extra kosten rechtvaardigt.
FAQ
Is Pro altijd beter dan V2.5?
Nee. Pro is sterker in moeilijke tekstredenering en codering, maar V2.5 ondersteunt beeld-, video- en audio-input en is aanzienlijk goedkoper.
Ondersteunen beide modellen een contextvenster van 1M tokens?
Ja. Beide adverteren 1M tokens context en tot 128K outputtokens. Toepassingen moeten nog steeds retrieval en redenering testen op hun feitelijke bedrijfslengtes.
Welk model moet een multimodale agent gebruiken?
Begin met V2.5 omdat het native visuele en audio-input ondersteunt. Pro richt zich momenteel op workflows met tekstinput.
Wanneer is Pro de hogere prijs waard?
Vooral wanneer betere redeneringsbetrouwbaarheid invloed heeft op de voltooiing van moeilijke wiskunde, codering op repository-schaal of lange trajecten met veel afhankelijke toolaanroepen.
Moeten productiesystemen maar één model gebruiken?
Niet per se. Een routeringslaag kan routine- en multimodaal werk op V2.5 houden en alleen moeilijke tekst- en agenttaken opschalen naar Pro.