TL;DR
De tokenkosten van AI‑agenten groeien wanneer elke stap herhaaldelijk instructies, gespreksgeschiedenis, toolresultaten en tussentijdse status verwerkt.
Verlaag het tokenvolume met run‑niveau budgetten, filtering van toolresultaten, contextcompactie, retry‑limieten en gecontroleerde redenering. Gebruik promptcaching voor stabiele, herhaalde input, maar optimaliseer de agent‑loop voordat je overschakelt op een goedkoper model.
De nuttigste productiemetriek is kosten per geslaagde taak, gemeten over de volledige run—niet de prijs per request of de contextgrootte van de laatste call.
Deze gids richt zich specifiek op meerstaps AI‑agenten. Ze legt uit hoe herhaalde context zich in een run opstapelt, hoe je de grootste bron van verspilling identificeert en welke controles je als eerste implementeert.
Introduction
Een chatbot doet mogelijk één modelaanvraag per gebruikersbericht. Een AI‑agent kan 10, 20 of meer calls uitvoeren voordat één taak is voltooid.
Elke stap kan instructies, gespreksgeschiedenis, toolresultaten en tussentijdse status opnieuw versturen. Retries, redenering en subagenten voegen extra gebruik toe, dus een kort eindantwoord kan alsnog een groot aantal tokens verbruiken.
Naarmate het gebruik schaalt, worden deze kosten moeilijker te voorspellen en kunnen ze de productmarges snel verkleinen. Ze verlagen vereist optimalisatie van de volledige agent‑loop—niet simpelweg overschakelen naar een goedkoper model.
Dit artikel concentreert zich op agent‑specifieke kosten. Voor een bredere gids over promptcaching, exacte responscaching, semantische caching, modelroutering en algemeen API‑kostenbeheer, zie How to Reduce AI API Costs.
Why Do AI Agent Token Costs Compound?
In een meerstaps agent zijn de kosten van één taak de som van elke modelcall—niet alleen de uiteindelijke respons.
De belangrijkste bronnen van tokengebruik door agenten zijn:
| Kostenbron | Waardoor het ontstaat | Eerste te testen maatregel |
|---|---|---|
| Herhaalde instructies | Systeemprompts, toolschema’s, policies, voorbeelden | Stabiliseer de herbruikbare prefix |
| Groeiende geschiedenis | Eerdere beurten worden bij elke stap opnieuw verzonden | Compacteer of haal staat selectief op |
| Toolresultaten | Zoekpagina’s, bestanden, logs en databaserecords | Filter vóór toevoeging aan de context |
| Tussentijdse output | Plannen, statusberichten en uitgebreide toolbesluiten | Gebruik compacte, gestructureerde output |
| Redeneringstokens | Hoge denkinspanning bij routinestappen | Pas inspanning aan op taakcomplexiteit |
| Retries | Ongeldige output, time‑outs, toolfouten en ratelimieten | Classificeer fouten en cap retries |
| Subagenten | Werknemers dupliceren context, tools en analyse | Stuur elke worker een smalle contextslice |
Er zijn twee manieren om de rekening te verlagen:
- Minder tokens verwerken via filtering, compactie, outputlimieten en loop‑controles.
- De effectieve prijs verlagen van noodzakelijke tokens via promptcaching of modelkeuze.
Belangrijk onderscheid: Promptcaching verlaagt de kosten van herhaalde input. Contextcompactie vermindert de herhaalde input zelf.
How Can a 12-Step Agent Process 147,000 Tokens?
Neem een hypothetische support‑agent met:
- Een stabiele prefix van 4.000 tokens
- 1.500 nieuwe tokens na elke stap
- De volledige geaccumuleerde geschiedenis opnieuw verzonden bij elk verzoek
- In totaal 12 modelcalls
De input bij stap n is:
Input at step n = 4,000 + 1,500 × (n - 1)
De cumulatieve input over 12 calls is:
Total input
= 4,000 × 12 + 1,500 × (0 + 1 + ... + 11)
= 48,000 + 99,000
= 147,000 input tokens
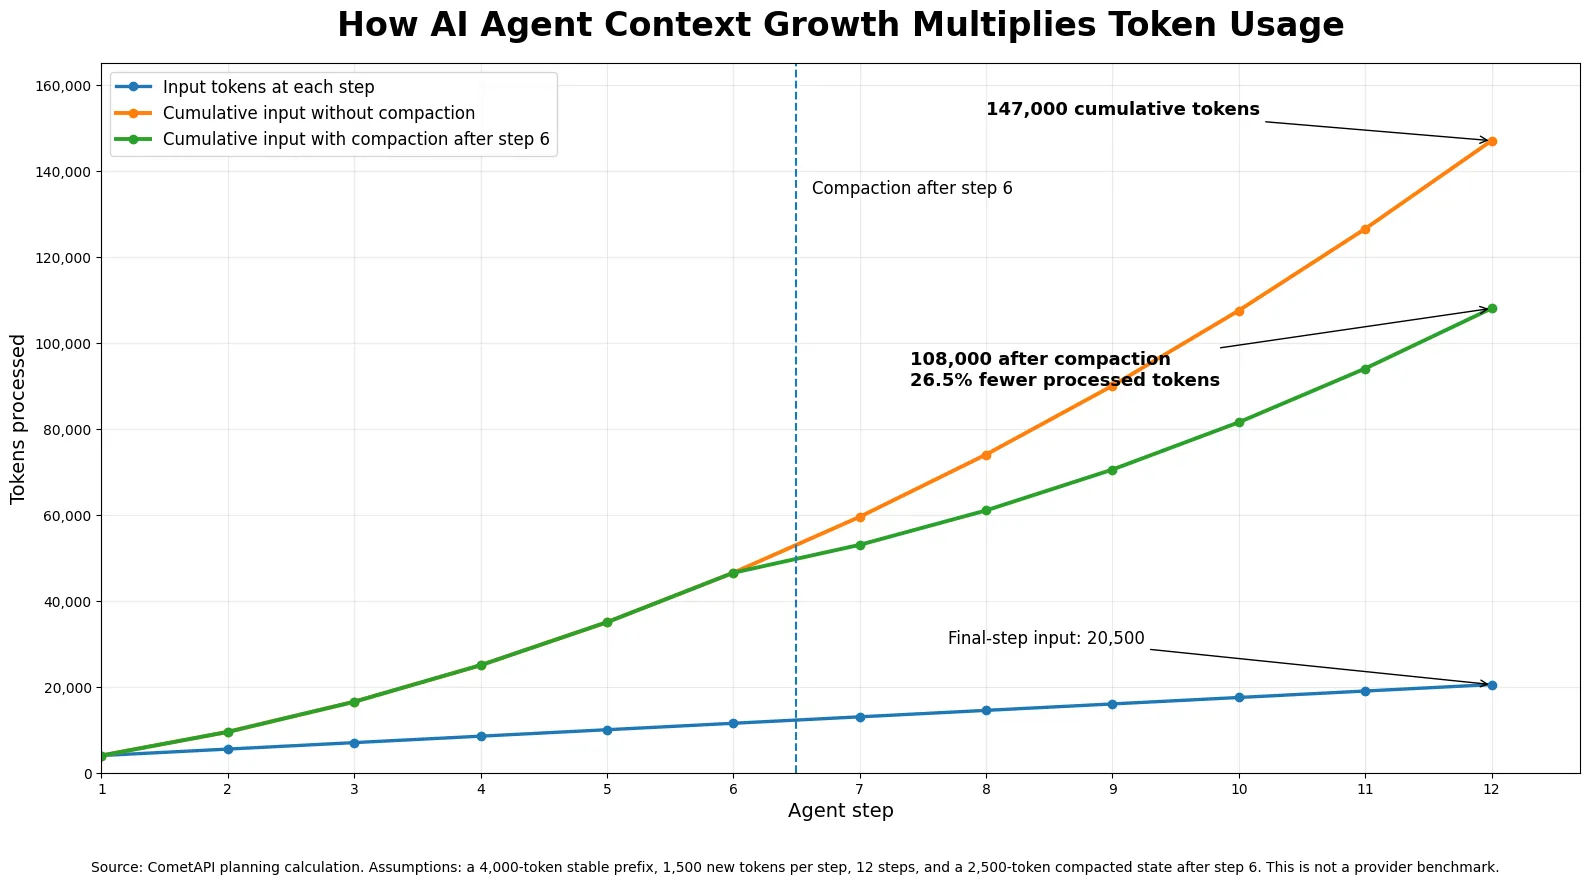
De laatste call bevat slechts 20,500 inputtokens, maar de volledige run verwerkt 147,000 cumulatieve inputtokens.
Pas nu twee maatregelen toe:
- Cache de stabiele prefix van 4.000 tokens na de eerste call.
- Compacteer na stap zes de geschiedenis tot een toestandssamenvatting van 2.500 tokens.
| Scenario | Niet-gecachete input | Gecachete input | Totaal verwerkte input | Verandering |
|---|---|---|---|---|
| Volledige geschiedenis elke stap | 147,000 | 0 | 147,000 | Baseline |
| Stabiele prefix gecachet | 103,000 | 44,000 | 147,000 | Zelfde volume, goedkopere mix |
| Cache plus compactie | 64,000 | 44,000 | 108,000 | 26.5% minder verwerkte tokens |
Dit is een planningsberekening, geen providerbenchmark.
Ze veronderstelt dat elk verzoek de volledige geaccumuleerde geschiedenis bevat. Agenten die staat selectief opbouwen, oude berichten samenvatten of alleen relevante informatie ophalen, kunnen een andere kostenkromme volgen.
Kosten‑groeiregel: Meet cumulatieve input over de volledige run. De grootte van de laatste context vertegenwoordigt niet het totale aantal verwerkte tokens.
Which Metrics Reveal Agent Token Waste?
Begin niet met het wijzigen van modellen. Identificeer eerst waar de workflow tokens besteedt zonder het resultaat te verbeteren.
Log deze velden voor elke agentstap:
| Veld | Waarom het ertoe doet |
|---|---|
run_id, step_id, parent_step_id | Reconstrueert de agent‑ en subagent‑boom |
| Rendered input tokens | Toont hoe de context groeit tussen calls |
| Gecachete en niet‑gecachete input | Scheidt hergebruik van nieuwe context |
| Output en redeneringstokens | Identificeert dure generatie‑stappen |
| Toolresultaatgrootte en behouden tokens | Toont hoeveel ruwe evidence latere prompts ingaat |
| Retry‑reden en pogingnummer | Identificeert herhaalde fouten |
| Compactietokens vóór en na | Meet daadwerkelijke contextreductie |
| Worker‑ID en geretourneerde tokens | Onthult gedupliceerd subagent‑werk |
| Geaccepteerd, afgewezen of geëscaleerd resultaat | Verbindt kosten aan taakkwaliteit |
De primaire metriek moet zijn:
cost per successful task
= total workflow cost
/ accepted tasks
Een goedkopere run is geen verbetering als die meer mislukte taken, herhaalde tools of menselijke correctie veroorzaakt.
Vier agent‑specifieke metriek helpen het probleem te lokaliseren.
Context Amplification
context amplification
= cumulative input tokens
/ final-step input tokens
Een hoge waarde duidt erop dat eerdere context herhaaldelijk is verwerkt.
Tool Retention Ratio
tool retention ratio
= tool-result tokens retained in context
/ tokens originally returned by tools
Een hoge ratio kan aangeven dat de agent te veel ruwe evidence tussen stappen meedraagt.
Retry Tax
retry tax
= retry and repair cost
/ total workflow cost
Reasoning Share
reasoning share
= reasoning-token cost
/ total model cost
Meet elke werklast afzonderlijk. Research‑, codeer‑, browser‑ en customer‑support‑agenten mogen geen globale baseline delen.
Six Ways to Reduce AI Agent Token Costs
1. Set a Budget for the Complete Run
Een outputlimiet per request beheerst geen meerstaps agent.
Stel run‑niveau limieten in voor:
- Totaal aantal modelstappen
- Cumulatieve input en output
- Toolcalls en grootte van toolresultaten
- Retries per fouttype
- Subagenten
- Totale verstreken tijd of geschatte kosten
Het volgende provider‑neutrale Python‑voorbeeld evalueert de run vóór elke modelcall:
from dataclasses import dataclass
from enum import Enum


class Action(str, Enum):
    CONTINUE = "continue"
    COMPACT = "compact"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    max_steps: int = 12
    max_input_tokens: int = 120_000
    max_output_tokens: int = 18_000
    compact_at: float = 0.80


@dataclass
class Usage:
    steps: int = 0
    input_tokens: int = 0
    output_tokens: int = 0


def evaluate_budget(usage: Usage, budget: Budget) -> Action:
    if (
        usage.steps >= budget.max_steps
        or usage.input_tokens >= budget.max_input_tokens
        or usage.output_tokens >= budget.max_output_tokens
    ):
        return Action.STOP

    input_ratio = usage.input_tokens / budget.max_input_tokens

    if input_ratio >= budget.compact_at:
        return Action.COMPACT

    return Action.CONTINUE
Voer de check uit vóór elke modelaanvraag en werk Usage bij met door de provider gerapporteerde tokendata.
Bij 80% van het inputbudget: compacteer de staat of vernauw de volgende toolquery. Bij 100%: stop met een gestructureerde reden.
Veelgemaakte fout: Elke respons limiteren terwijl je onbeperkte stappen, tools en retries toestaat.
2. Filter Tool Results Before They Enter the Transcript
Retourneer alleen de evidence die nodig is voor de volgende beslissing van de agent.
Voeg niet een hele:
- Webpagina
- Logbestand
- Repository‑boom
- Databaserespons
- Terminalsessie
- API‑payload
toe als de volgende stap slechts enkele velden nodig heeft.
Een zoektool kan retourneren:
{
  "source_id": "search_17",
  "title": "Relevant page title",
  "url": "https://example.com/page",
  "relevant_passage": "A short evidence block"
}
Sla het volledige artefact buiten de prompt op en haal later een smallere sectie op.
Tool‑filterregel: Retourneer de velden die nodig zijn voor de volgende beslissing—niet elk veld dat later nuttig zou kúnnen zijn.
Veelgemaakte fout: De eerste 1.000 tekens van een JSON‑payload afkappen. Dit kan de structuur breken of de records verwijderen die de agent daadwerkelijk nodig heeft.
Parseer eerst de payload, selecteer velden structureel, beperk arrays en serialiseer vervolgens geldige JSON.
3. Compact Operational State, Not Just Conversation Text
Compactie moet de informatie behouden die nodig is om de taak voort te zetten en geschiedenis verwijderen die de volgende actie niet langer beïnvloedt.
Een nuttig gecompacteerde staat bevat:
- Gebruikersdoel en succescriteria
- Reeds genomen beslissingen
- Geverifieerde feiten en bron‑ID’s
- Gewijzigde bestanden of records
- Mislukte benaderingen
- Openstaande vragen
- De volgende actie
- Veiligheids‑ en outputbeperkingen
Ze moet niet het volledige gesprek navertellen.
OpenAI documenteert compactie voor langlopende Responses API‑interacties. Anthropic biedt contextbeheer‑controls om oudere content te wissen of samen te vatten. Deze implementaties verschillen; verifieer daarom de huidige provider‑velden vóór integratie.
Compactieregel: Behoud beslissingen en onopgelost werk. Verwijder narratief en evidence die opnieuw kan worden opgehaald.
Veelgemaakte fout: Bron‑ID’s, gewijzigde bestandsnamen, verworpen benaderingen of onopgeloste beperkingen laten vallen.
Meet na het toevoegen van compactie of de agent zoekopdrachten of toolcalls herhaalt. Een kortere prompt is niet goedkoper als de agent verloren staat opnieuw moet opbouwen.
4. Keep the Reusable Prefix Stable
Agentprompts bevatten vaak grote herbruikbare blokken:
- Systeeminstructies
- Toolschema’s
- Veiligheidspolicies
- Outputformaten
- Gedeeld referentiemateriaal
- Repository‑ of productinstructies
Plaats deze stabiele elementen vóór request‑specifieke data:
1. System instructions
2. Policies and constraints
3. Tool definitions
4. Stable examples
5. Shared reference material
6. Request-specific data
Vermijd het plaatsen van tijdstempels, request‑ID’s, sessiedata of vaak veranderende waarden aan het begin.
Caching is het nuttigst wanneer de prefix lang, stabiel en hergebruikt is. Het kan weinig besparen bij korte sessies of vaak veranderende prompts.
Veelgemaakte fout: Optimaliseren voor cache‑hitratio zonder de kosten van cache‑writes, reads of opslag te meten.
Voor een bredere vergelijking van promptcaching, exacte responscaching en semantische caching, zie How to Reduce AI API Costs.
5. Prevent Retries From Replaying the Same Context
Een retry is een nieuwe agentstap, vaak met dezelfde grote prompt.
Herhaal een mislukte aanvraag niet zonder de oorzaak van de fout te veranderen.
| Fout | Betere reactie |
|---|---|
| Ongeldige gestructureerde output | Retourneer de validatiefout en probeer één keer opnieuw |
| Tool‑time‑out | Probeer een idempotente operatie één keer opnieuw, stop anders of gebruik een fallback |
| Contextoverflow | Compacteer de staat of haal minder evidence op |
| Herhaalde toolcall | Dedupliceer met een operatie‑hash |
| Rate‑limit | Back‑off of gebruik een geteste fallback‑route |
| Resultaat met lage zekerheid | Vraag ontbrekende informatie of schaal op |
Gebruik idempotency‑sleutels voor operaties met neveneffecten zoals betalingen, e‑mails, deployments en database‑writes.
Veelgemaakte fout: Een geratelimiteerd model meerdere keren opnieuw proberen terwijl de volledige agentcontext bij elke poging opnieuw wordt verzonden.
Houd de retry‑belasting bij per fouttype zodat het team de grootste loop als eerste kan oplossen.
6. Limit Reasoning and Subagents to Steps That Need Them
Niet elke agentstap vereist diepe redenering.
Extractie, formattering, classificatie, validatie en routinematige toolselectie kunnen vaak met lagere denkinspanning en compacte, gestructureerde output.
Reserveer hogere denkinspanning voor taken zoals:
- Complexe planning
- Moeilijke code
- Synthese over meerdere documenten
- Ambigue beslissingen
- Herstel na mislukte uitvoering
Redeneringsregel: Gebruik de laagste denkinspanning die de acceptatiegraad behoudt.
Subagenten hebben ook een duidelijke afbakening nodig. Geef elke worker:
- Een smalle taak
- Een taak‑specifieke contextslice
- Een toollijst met toestemmingen
- Een tokenbudget
- Een compact outputschema
De root‑agent heeft meestal bevindingen, evidence‑ID’s, zekerheid en onopgeloste issues nodig—niet het volledige transcript van de worker.
Subagent‑regel: Paralleliseer onafhankelijk werk, niet gedupliceerde context.
Veelgemaakte fout: De complete geschiedenis van de root‑agent naar elke worker sturen voordat je een smalle taak toewijst.
Which Optimization Should You Apply First?
Gebruik agenttelemetrie om de eerste interventie te kiezen.
Onderstaande drempels zijn onderzoekstriggers, geen universele normen.
| Waargenomen signaal | Begin hier |
|---|---|
| Hoge contextamplificatie | Compacteer geschiedenis en haal staat selectief op |
| Tooloutput domineert de prompt | Filter velden en sla volledige artefacten extern op |
| Hoge retry‑belasting | Los validatie, time‑outs en herhaalde toolcalls op |
| Hoog aandeel voor redenering | Verlaag inspanning bij routinestappen |
| Subagenten herhalen dezelfde evidence | Vernauw workerscopes en contextslices |
| Gecachete input blijft laag | Stabiliseer de herbruikbare prefix |
| Kosten blijven hoog na loop‑opschoning | Vergelijk goedkopere modelroutes |
Een veilige implementatievolgorde is:
- Meet cumulatieve input, toolretentie, retries en redenering.
- Voeg harde limieten toe voor stappen, tools, retries en totale tokens.
- Filter grote toolresultaten.
- Compacteer oudere staat bij een gemeten drempel.
- Stabiliseer de herbruikbare promptprefix.
- Vergelijk modelroutes pas nadat de agent‑loop schoon is.
Verander één grote variabele tegelijk en speel dezelfde evaluatieset opnieuw af.
Vergelijk:
- Acceptatiegraad van taken
- Kosten per geslaagde taak
- Cumulatieve input
- Aantal toolcalls
- Retry‑belasting
- Aandeel voor redenering
- p50‑ en p95‑latentie
- Tijd voor handmatige beoordeling
Draai wijzigingen terug die tokens besparen door de taakkwaliteit te verlagen of noodzakelijke evidence te verwijderen.
Test Agent Workflows With CometAPI
Gebruik vóór een multimodel‑evaluatie de CometAPI pricing page en cost estimation guide om input‑, output‑, cachetoken‑ en redeneringskosten te schatten.
Gebruik vervolgens de model catalog om in aanmerking komende routes te identificeren en de Quickstart om een OpenAI‑compatibele client te configureren.
Volg voor productie‑fallback de CometAPI model fallback guide om van route te wisselen zonder voltooide toolcalls te herhalen of gevalideerde staat te verwerpen.
Geünificeerde toegang vereenvoudigt modelvergelijking en fallbackintegratie. Tokenbudgetten, compactie, validatie, toolfiltering, retry‑limieten en acceptatiecriteria horen nog steeds op applicatieniveau.
FAQ
Waarom gebruiken AI‑agenten meer tokens dan chatbots?
Agenten doen meerdere modelcalls en kunnen bij elke stap eerdere berichten, toolresultaten, instructies en tussentijdse staat opnieuw versturen. Daardoor wordt eerdere context herhaaldelijk verwerkt.
Vermindert promptcaching het gebruik van de contextwindow?
Nee. Promptcaching kan de effectieve prijs of latentie van herhaalde input verlagen, maar gecachete tokens maken nog steeds deel uit van de verwerkte context. Gebruik compactie, filtering of selectieve retrieval om de promptgrootte te verkleinen.
Wanneer moet een AI‑agent zijn context compacteren?
Compacteer voordat contextgroei kosten, latentie of beschikbare outputruimte begint te beïnvloeden. Verifieer dat de gecompacteerde staat beslissingen, evidence‑ID’s, gewijzigde bestanden, openstaande vragen en veiligheidsbeperkingen behoudt.
Verlagen subagenten de tokenkosten?
Niet automatisch. Ze kunnen de doorlooptijd verkorten of dekking verbeteren voor onafhankelijk werk, maar gedupliceerde context en overlappende analyse verhogen vaak het totale tokengebruik.
Wat is de beste metriek voor het optimaliseren van AI‑agentkosten?
Gebruik kosten per geslaagde taak als primaire metriek. Diagnoseer deze met cumulatieve input, contextamplificatie, toolretentie, retry‑belasting, aandeel voor redenering, latentie en tijd voor handmatige beoordeling.